Bab 66 — Ekstensi dan Performa Tinggi: Kode Native dan GPU
Seri A5 — Python Tingkat Ahli
Semua skrip bab ini ada di folder kode/bab66/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Bab 44 mengajarkan: ukur dulu, lalu perbaiki algoritma dan vektorisasi. Bab ini untuk saat semua itu belum cukup, misalnya menghitung indeks vegetasi untuk jutaan piksel citra drone. Bayangkan sebuah penggilingan padi. Memutar penggilingan dengan tangan itu Python murni. Memakai mesin diesel itu kode native. Memakai pabrik dengan ribuan mesin kecil serentak itu GPU. Tetapi ongkos menyalakan mesin dan mengangkut padi ke pabrik itu nyata, dan bab ini jujur soal itu.
Aturan kerja bab ini. Waktu proses tidak dicetak di buku karena berbeda tiap komputer. Skrip hanya mencetak perbandingan kualitatif yang stabil (misalnya “lebih dari 20x lebih cepat: True”) setelah dicoba berulang kali; angka di komputer Anda berbeda. Perangkat penulis: Windows 11, GPU NVIDIA GeForce GTX 1660 SUPER (6 GB, compute capability 7.5), CUDA Toolkit 13.4, kompilator MSVC (Visual Studio) untuk kode C. Rust tidak terpasang dan RAPIDS tidak tersedia di Windows biasa, jadi keduanya ditandai tidak dijalankan.
numba: satu dekorator, kode mesin
numba adalah JIT compiler (kompilator “tepat waktu”): saat fungsi dipanggil pertama kali, ia membaca bytecode (Bab 65), memadukannya dengan tipe argumen, lalu memakai LLVM untuk membuat kode mesin. Menurut dokumentasinya, ia paling cocok untuk kode yang memakai larik NumPy dan perulangan, dan kecepatan naik “satu sampai dua tingkat besaran” bila berlaku.
01_numba_njit.py
# Bab 66 - numba: mengubah fungsi Python menjadi kode mesin dengan satu dekorator
import time

import numpy as np
from numba import njit


def ndvi_python(merah, nir):
    """Indeks vegetasi per piksel, ditulis dengan perulangan biasa."""
    tinggi, lebar = merah.shape
    hasil = np.empty_like(merah)
    for i in range(tinggi):
        for j in range(lebar):
            hasil[i, j] = (nir[i, j] - merah[i, j]) / (nir[i, j] + merah[i, j])
    return hasil


ndvi_cepat = njit(ndvi_python)       # sama persis, hanya dibungkus numba

rng = np.random.default_rng(42)
merah = rng.uniform(0.05, 0.40, (512, 512)).astype(np.float32)   # citra tiruan
nir = rng.uniform(0.20, 0.60, (512, 512)).astype(np.float32)


def terbaik(fungsi, *argumen, ulang=3):
    waktu = []
    for _ in range(ulang):
        mulai = time.perf_counter()
        fungsi(*argumen)
        waktu.append(time.perf_counter() - mulai)
    return min(waktu)


ndvi_cepat(merah, nir)               # panggilan pertama: numba MENGKOMPILASI (jangan diukur)
print("tanda tangan terkompilasi:", ndvi_cepat.signatures)

hasil_lambat = ndvi_python(merah, nir)
hasil_cepat = ndvi_cepat(merah, nir)
print("hasil sama persis        :", np.array_equal(hasil_lambat, hasil_cepat))
print("rentang NDVI tiruan      :", round(float(hasil_cepat.min()), 2), "sampai", round(float(hasil_cepat.max()), 2))

rasio = terbaik(ndvi_python, merah, nir) / terbaik(ndvi_cepat, merah, nir)
print("numba lebih dari 20x lebih cepat dari perulangan Python:", rasio > 20)
tanda tangan terkompilasi: [(Array(float32, 2, 'C', False, aligned=True), Array(float32, 2, 'C', False, aligned=True))]
hasil sama persis : True
rentang NDVI tiruan : -0.33 sampai 0.85
numba lebih dari 20x lebih cepat dari perulangan Python: Truenjit(fungsi)(sama dengan@njit) tidak mengubah isi fungsi. Panggilan pertama memakan waktu karena kompilasi; maka pemanggilan pemanasan dilakukan dulu dan tidak diukur.signaturesmemperlihatkan hasil kompilasi untuk tipefloat32dua dimensi. Bila Anda memanggil dengan tipe lain, numba mengompilasi versi baru.- Hasilnya sama persis (
array_equal) dan, di komputer penulis, jauh lebih dari 20 kali lebih cepat dibanding perulangan Python. Rentang NDVI -0,33 sampai 0,85 hanyalah akibat angka acak tiruan.
02_numba_paralel_vectorize.py
# Bab 66 - numba: prange (paralel), vectorize, dan batasnya
import numpy as np
from numba import njit, prange, vectorize
from numba.core.errors import TypingError


# 1. Paralel di semua inti: prange menggantikan range
@njit(parallel=True)
def biomassa_total(jumlah, bobot_g):
    total = 0.0
    for i in prange(len(jumlah)):             # iterasi dibagi ke beberapa thread
        total += jumlah[i] * bobot_g[i] / 1000
    return total


rng = np.random.default_rng(42)
jumlah = rng.integers(100, 1000, 100_000)
bobot = rng.uniform(300, 700, 100_000)
print("biomassa (numba paralel):", round(biomassa_total(jumlah, bobot), 2))
print("biomassa (NumPy)        :", round(float((jumlah * bobot / 1000).sum()), 2))


# 2. vectorize: fungsi skalar menjadi ufunc yang bekerja pada seluruh larik
@vectorize(["float64(float64, float64)"])
def volume_batang(diameter_cm, tinggi_m):
    radius_m = diameter_cm / 200
    return 3.14159 * radius_m * radius_m * tinggi_m * 0.6


diameter = np.array([32.5, 45.2, 28.0])
tinggi = np.array([18.0, 24.0, 15.0])
print("volume per pohon (m3)   :", volume_batang(diameter, tinggi).round(3))


# 3. numba tidak mengerti semua objek Python
@njit
def kapital(bobot):
    return bobot.upper()               # float tidak punya metode upper()


try:
    kapital(540.5)
except TypingError as e:
    print("TypingError: atribut 'upper' tidak dikenal:", "Unknown attribute 'upper'" in str(e))
biomassa (numba paralel): 27486800.86
biomassa (NumPy) : 27486800.86
volume per pohon (m3) : [0.896 2.311 0.554]
TypingError: atribut 'upper' tidak dikenal: Trueprange membagi iterasi ke beberapa thread; total += di dalam prange dikenali sebagai reduksi. @vectorize mengubah fungsi skalar menjadi ufunc NumPy. Bagian terakhir menunjukkan batas: numba hanya paham sebagian Python. Memanggil bobot.upper() pada float ditolak dengan TypingError, bukan diam-diam jalan lambat.
numba paling berguna untuk perulangan numerik di atas larik yang sulit divektorkan. Bila pekerjaan Anda sudah satu operasi NumPy besar (seperti (nir - merah) / (nir + merah)), numba hanya menghemat larik sementara dan keuntungannya kecil. Dokumentasi menegaskan: kode yang tidak dikenali numba (misalnya sebagian besar operasi pandas) tidak dipercepat.
Cython: Python dengan tipe C
Cython menerjemahkan berkas .pyx (Python dengan tambahan tipe C) menjadi kode C, lalu dikompilasi menjadi modul biner (.pyd di Windows). Berbeda dari numba, kompilasi terjadi sekali di awal, dan hasilnya bisa dibagikan sebagai paket.
03_cython.py
# Bab 66 - Cython: Python dengan tipe C, dikompilasi menjadi modul .pyd
import shutil
import sys
import time
from pathlib import Path

import numpy as np

from pembangun_native import bangun_ekstensi

kerja = Path(__file__).parent / "_tmp" / "cython"
shutil.rmtree(kerja, ignore_errors=True)
kerja.mkdir(parents=True)

(kerja / "ndvi_cy.pyx").write_text('''
# cython: boundscheck=False, wraparound=False
def ndvi(float[:, ::1] merah, float[:, ::1] nir, float[:, ::1] hasil):
    cdef int i, j
    for i in range(merah.shape[0]):
        for j in range(merah.shape[1]):
            hasil[i, j] = (nir[i, j] - merah[i, j]) / (nir[i, j] + merah[i, j])
''', encoding="utf-8")

(kerja / "setup.py").write_text('''
from setuptools import setup, Extension
from Cython.Build import cythonize
setup(ext_modules=cythonize([Extension("ndvi_cy", ["ndvi_cy.pyx"])], language_level=3))
''', encoding="utf-8")

print("kompilasi berhasil:", bangun_ekstensi(kerja))

sys.path.insert(0, str(kerja))
import ndvi_cy                       # modul biner hasil kompilasi

rng = np.random.default_rng(42)
merah = rng.uniform(0.05, 0.40, (512, 512)).astype(np.float32)
nir = rng.uniform(0.20, 0.60, (512, 512)).astype(np.float32)

hasil = np.empty_like(merah)
ndvi_cy.ndvi(merah, nir, hasil)
acuan = (nir - merah) / (nir + merah)           # versi NumPy
print("sama dengan NumPy:", np.allclose(hasil, acuan))


def ndvi_python(merah, nir, hasil):             # versi perulangan Python murni
    for i in range(merah.shape[0]):
        for j in range(merah.shape[1]):
            hasil[i, j] = (nir[i, j] - merah[i, j]) / (nir[i, j] + merah[i, j])


mulai = time.perf_counter()
ndvi_python(merah, nir, np.empty_like(merah))
lambat = time.perf_counter() - mulai
mulai = time.perf_counter()
ndvi_cy.ndvi(merah, nir, hasil)
cepat = time.perf_counter() - mulai
print("Cython lebih dari 20x lebih cepat dari Python murni:", lambat / cepat > 20)
kompilasi berhasil: True
sama dengan NumPy: True
Cython lebih dari 20x lebih cepat dari Python murni: TrueKuncinya di .pyx: float[:, ::1] adalah typed memoryview (tampilan larik 2 dimensi float32 yang berurutan di memori), dan cdef int i, j membuat penghitung bertipe C. Dua arahan boundscheck=False, wraparound=False mematikan pemeriksaan batas indeks demi kecepatan (hati-hati: indeks salah tidak lagi menimbulkan IndexError). Skrip memanggil setuptools untuk mengompilasi dengan MSVC; butuh kompilator C (di Linux: gcc; di macOS: clang).
Ekstensi C: berbicara langsung dengan C API
Cython dan numba sebenarnya menulis ekstensi untuk Anda. Menulis sendiri dengan C API CPython memberi kendali penuh, dengan ongkos kode lebih panjang dan risiko lebih besar.
04_ekstensi_c.py
# Bab 66 - Ekstensi C: menulis modul Python langsung dengan C API
import shutil
import sys
from pathlib import Path

from pembangun_native import bangun_ekstensi

kerja = Path(__file__).parent / "_tmp" / "ekstensi_c"
shutil.rmtree(kerja, ignore_errors=True)
kerja.mkdir(parents=True)

(kerja / "hutan_c.c").write_text(r'''
#include <Python.h>

static PyObject *jumlah_kuadrat(PyObject *self, PyObject *args) {
    long n;
    if (!PyArg_ParseTuple(args, "l", &n))      /* "l" = satu bilangan bulat */
        return NULL;                           /* error sudah diisi oleh Python */
    long long total = 0;
    for (long i = 0; i < n; i++)
        total += (long long)i * i;
    return PyLong_FromLongLong(total);
}

static PyMethodDef metode[] = {
    {"jumlah_kuadrat", jumlah_kuadrat, METH_VARARGS, "Jumlah i*i untuk i dari 0 sampai n-1."},
    {NULL, NULL, 0, NULL}
};

static struct PyModuleDef modul = {PyModuleDef_HEAD_INIT, "hutan_c", NULL, -1, metode};

PyMODINIT_FUNC PyInit_hutan_c(void) { return PyModule_Create(&modul); }
''', encoding="utf-8")

(kerja / "setup.py").write_text('''
from setuptools import setup, Extension
setup(ext_modules=[Extension("hutan_c", ["hutan_c.c"])])
''', encoding="utf-8")

print("kompilasi berhasil:", bangun_ekstensi(kerja))

sys.path.insert(0, str(kerja))
import hutan_c

print(hutan_c.jumlah_kuadrat.__doc__)
print("hasil C      :", hutan_c.jumlah_kuadrat(1000))
print("hasil Python :", sum(i * i for i in range(1000)))

try:
    hutan_c.jumlah_kuadrat("seribu")           # tipe salah
except TypeError as e:
    print("TypeError:", e)
kompilasi berhasil: True
Jumlah i*i untuk i dari 0 sampai n-1.
hasil C : 332833500
hasil Python : 332833500
TypeError: 'str' object cannot be interpreted as an integerPyArg_ParseTuple(args, "l", &n) mengubah argumen Python menjadi long C; bila tipenya salah, ia mengisi TypeError dan kita cukup return NULL. Itulah pesan yang tercetak di baris terakhir. PyModuleDef dan PyInit_hutan_c adalah pintu masuk modul. Panggilan hutan_c.jumlah_kuadrat(1000) menghasilkan 332833500, sama dengan sum(i * i for ...).
Di ekstensi C, Andalah yang mengelola penghitung referensi (Bab 65): lupa Py_DECREF menimbulkan kebocoran memori, kelebihan Py_DECREF menimbulkan crash. Contoh di atas aman karena hanya memakai nilai C dan satu PyLong_FromLongLong. Untuk pekerjaan serius, lebih baik pakai Cython, PyO3, atau pustaka seperti pybind11.
ctypes dan cffi: memanggil pustaka native yang sudah ada
Kadang Anda tidak perlu menulis ekstensi; Anda hanya perlu memanggil pustaka yang sudah ada (.dll di Windows, .so di Linux). Untuk latihan, kita menulis pustaka C kecil sendiri:
EKSPOR double biomassa_total(const double *bobot_g, const int *jumlah, int n) {
    double total = 0.0;
    for (int i = 0; i < n; i++)
        total += jumlah[i] * bobot_g[i] / 1000.0;
    return total;
}
(Berkas lengkap: kode/bab66/native/hutan.c; EKSPOR adalah __declspec(dllexport) di Windows.) Skrip membangunnya menjadi hutan.dll, lalu memanggilnya dengan dua cara.
05_ctypes.py
# Bab 66 - ctypes: memanggil fungsi di pustaka native (DLL) tanpa menulis kode penghubung
import ctypes
import shutil
from pathlib import Path

import numpy as np

from pembangun_native import bangun_dll

kerja = Path(__file__).parent / "_tmp" / "ctypes"
shutil.rmtree(kerja, ignore_errors=True)
kerja.mkdir(parents=True)
sumber = shutil.copy(Path(__file__).parent / "native" / "hutan.c", kerja / "hutan.c")
dll = bangun_dll(sumber, kerja / "hutan.dll")
print("DLL terbentuk:", dll.exists())

pustaka = ctypes.CDLL(str(dll))

# 1. WAJIB menjelaskan tipe argumen dan hasil; ctypes tidak bisa menebaknya dari DLL
larik_double = np.ctypeslib.ndpointer(dtype=np.float64, flags="C_CONTIGUOUS")
larik_int = np.ctypeslib.ndpointer(dtype=np.intc, flags="C_CONTIGUOUS")
pustaka.biomassa_total.argtypes = [larik_double, larik_int, ctypes.c_int]
pustaka.biomassa_total.restype = ctypes.c_double

bobot = np.array([540.5, 480.0, 612.5])
jumlah = np.array([800, 1250, 600], dtype=np.intc)
print("biomassa dari C   :", round(pustaka.biomassa_total(bobot, jumlah, len(bobot)), 3))
print("biomassa dari NumPy:", round(float((bobot * jumlah).sum() / 1000), 3))

# 2. Larik byte (bool) bisa dikirim sebagai penunjuk
pustaka.hitung_sehat.argtypes = [ctypes.c_char_p, ctypes.c_int]
pustaka.hitung_sehat.restype = ctypes.c_int
sehat = bytes([1, 1, 0, 1, 0, 1, 1])
print("pohon sehat       :", pustaka.hitung_sehat(sehat, len(sehat)))

# 3. ndpointer menolak larik bertipe salah, sehingga tidak membuat program crash
try:
    pustaka.biomassa_total(bobot.astype(np.float32), jumlah, 3)
except ctypes.ArgumentError:
    print("ArgumentError: larik float32 ditolak sebelum menyentuh kode C")
DLL terbentuk: True
biomassa dari C : 1399.9
biomassa dari NumPy: 1399.9
pohon sehat : 5
ArgumentError: larik float32 ditolak sebelum menyentuh kode Cctypes ada di pustaka standar. Ia tidak bisa membaca deklarasi C dari DLL, jadi Anda wajib mengisi argtypes dan restype. Lupa mengisi restype membuat hasil double dibaca sebagai int dan nilainya salah tanpa pemberitahuan (kami mencoba: hasilnya 2, bukan 1399,9). np.ctypeslib.ndpointer memeriksa tipe dan keberurutan larik NumPy, sehingga larik float32 yang salah ditolak (ArgumentError) sebelum menyentuh kode C. Biomassa 1399,9 kg cocok dengan hitungan NumPy.
06_cffi.py
# Bab 66 - cffi: cara lain memanggil pustaka C (mode ABI), cukup menyalin deklarasi C
import shutil
from pathlib import Path

import numpy as np
from cffi import FFI

from pembangun_native import bangun_dll

kerja = Path(__file__).parent / "_tmp" / "cffi"
shutil.rmtree(kerja, ignore_errors=True)
kerja.mkdir(parents=True)
sumber = shutil.copy(Path(__file__).parent / "native" / "hutan.c", kerja / "hutan.c")
dll = bangun_dll(sumber, kerja / "hutan.dll")

ffi = FFI()
ffi.cdef("""
    double biomassa_total(const double *bobot_g, const int *jumlah, int n);
    int hitung_sehat(const unsigned char *sehat, int n);
""")                                    # deklarasi disalin dari C, bukan ditebak
pustaka = ffi.dlopen(str(dll))

bobot = np.array([540.5, 480.0, 612.5])
jumlah = np.array([800, 1250, 600], dtype=np.intc)
total = pustaka.biomassa_total(
    ffi.from_buffer("double[]", bobot),     # meminjam memori larik NumPy, tanpa menyalin
    ffi.from_buffer("int[]", jumlah),
    len(bobot))
print("biomassa dari C:", round(total, 3))

sehat = np.array([1, 1, 0, 1, 0, 1, 1], dtype=np.uint8)
print("pohon sehat    :", pustaka.hitung_sehat(ffi.from_buffer("unsigned char[]", sehat), len(sehat)))

# Tipe sudah diketahui dari deklarasi, jadi salah argumen langsung ketahuan
try:
    pustaka.hitung_sehat("bukan penunjuk", 3)
except TypeError as e:
    print("TypeError:", str(e).split(",")[0])
biomassa dari C: 1399.9
pohon sehat : 5
TypeError: initializer for ctype 'unsigned char *' must be a bytes or list or tuplecffi (paket terpisah) memakai deklarasi C yang disalin ke ffi.cdef. Karena tipenya diketahui, kesalahan argumen langsung ketahuan sebagai TypeError, dan ffi.from_buffer meminjam memori larik NumPy tanpa menyalin. Untuk pustaka C yang punya berkas header, cffi nyaman karena Anda tinggal menyalin deklarasinya.
Rust dengan PyO3: tidak dijalankan di sini
Rust adalah bahasa yang menjamin keamanan memori saat kompilasi. PyO3 menghubungkan Rust dengan Python, dan maturin membangun serta memasangnya. Contoh di bawah mengikuti panduan resmi PyO3 versi 0.29.3 (pyo3.rs, dibaca 2026-10-10): Rust minimal 1.83, Python minimal 3.8, perintah maturin develop --release.
07_rust_pyo3.py
# Bab 66 - Rust dengan PyO3 dan maturin (TIDAK dijalankan saat buku dibuat)
import subprocess
from pathlib import Path

proyek = Path(__file__).parent / "_tmp" / "hutan_rs"
(proyek / "src").mkdir(parents=True, exist_ok=True)

(proyek / "Cargo.toml").write_text('''
[package]
name = "hutan_rs"
version = "0.1.0"
edition = "2021"

[lib]
name = "hutan_rs"                 # harus sama dengan nama modul di lib.rs
crate-type = ["cdylib"]           # pustaka dinamis yang bisa di-import Python

[dependencies]
pyo3 = { version = "0.29.3" }
''', encoding="utf-8")

(proyek / "pyproject.toml").write_text('''
[build-system]
requires = ["maturin>=1.9.4,<2"]
build-backend = "maturin"

[project]
name = "hutan_rs"
requires-python = ">=3.9"
''', encoding="utf-8")

(proyek / "src" / "lib.rs").write_text('''
#[pyo3::pymodule]
mod hutan_rs {
    use pyo3::prelude::*;

    /// Jumlah i*i untuk i dari 0 sampai n-1.
    #[pyfunction]
    fn jumlah_kuadrat(n: u64) -> u64 {
        (0..n).map(|i| i * i).sum()
    }
}
''', encoding="utf-8")

# Membangun dan memasang ke lingkungan Python yang aktif (mode optimal)
subprocess.run(["maturin", "develop", "--release"], cwd=proyek, check=True)

import hutan_rs
print(hutan_rs.jumlah_kuadrat(1000))      # seharusnya 332833500, sama dengan versi C dan Python
Kode ini tidak dijalankan saat buku dibuat karena Rust (rustc dan cargo) tidak terpasang di komputer penulis (kami tidak mengunduh toolchain Rust yang berukuran ratusan megabita), jadi keluarannya tidak ditampilkan. Komentar terakhir menyebut hasil yang diharapkan (332833500), bukan hasil yang kami amati. Jalur ini dipakai luas: berkas WHEEL paket ruff, uv, pydantic_core, dan polars_runtime_32 di lingkungan buku ini mencatat Generator: maturin (kami memeriksanya langsung), artinya semuanya dibangun dengan maturin dari kode Rust.
Komputasi GPU: ribuan pekerja kecil
GPU (Graphics Processing Unit) punya ribuan inti sederhana yang mengerjakan operasi yang sama pada banyak data sekaligus. Cocok untuk citra (tiap piksel dihitung sama) dan matriks; kurang cocok untuk logika bercabang yang rumit. Dua istilah: host (CPU dan memori komputer) dan device (GPU dan VRAM-nya). Data harus dipindahkan lewat PCIe dari host ke device, dan itu ada ongkosnya.
Paket yang kami pasang lewat alat/pasang.py: cupy-cuda13x 14.2.0 (wheel resmi untuk Python 3.14, sekitar 36 MB) dan numba-cuda 0.30.4. Dokumentasi CuPy menyebut dukungan Python 3.10 sampai 3.14, CUDA 12.0 sampai 13.2, dan membutuhkan driver NVIDIA yang kompatibel; ia diuji di Ubuntu, CentOS, dan Windows Server (docs.cupy.dev, dibaca 2026-10-10). Di komputer ini CuPy bekerja dengan Windows 11 dan CUDA Toolkit 13.4; catatan kejujuran: dokumentasi mencantumkan NumPy 2.0 sampai 2.4, sedangkan terpasang NumPy 2.5.3, dan semua skrip di bawah tetap berjalan.
08_cupy_dasar.py
# Bab 66 - CuPy: NumPy di GPU
import math

import cupy as cp
import numpy as np

sifat = cp.cuda.runtime.getDeviceProperties(0)
print("GPU                :", sifat["name"].decode())
print("compute capability :", f'{sifat["major"]}.{sifat["minor"]}')
print("VRAM               :", round(sifat["totalGlobalMem"] / 2**30, 1), "GiB")

# Data tiruan di memori komputer (CPU / "host")
rng = np.random.default_rng(42)
diameter_cpu = rng.uniform(10, 60, 1_000_000).astype(np.float32)

# 1. CPU -> GPU: salinan lewat PCIe ke memori kartu grafis ("device")
diameter_gpu = cp.asarray(diameter_cpu)
print("jenis objek        :", type(diameter_gpu).__module__ + "." + type(diameter_gpu).__name__)

# 2. Hitungan memakai sintaks NumPy yang sama, tetapi dikerjakan GPU
luas_dasar_gpu = math.pi * (diameter_gpu / 200) ** 2        # m2 bidang dasar tiap pohon
rata_gpu = float(luas_dasar_gpu.mean())                     # GPU -> CPU: satu angka

luas_dasar_cpu = math.pi * (diameter_cpu / 200) ** 2
print("rata-rata (GPU)    :", round(rata_gpu, 5))
print("rata-rata (CPU)    :", round(float(luas_dasar_cpu.mean()), 5))
print("hasil sama         :", np.allclose(cp.asnumpy(luas_dasar_gpu), luas_dasar_cpu, rtol=1e-5))

# 3. Memori kartu grafis dikelola oleh "kolam memori" CuPy
kolam = cp.get_default_memory_pool()
print("memori terpakai    :", kolam.used_bytes() >= 4_000_000 * 2, "(>= dua larik float32 sejuta elemen)")

# 4. Mencampur larik CPU dan GPU tidak diizinkan: pindahkan dulu secara eksplisit
try:
    diameter_gpu + diameter_cpu
except TypeError as e:
    print("TypeError:", e)
GPU : NVIDIA GeForce GTX 1660 SUPER
compute capability : 7.5
VRAM : 6.0 GiB
jenis objek : cupy.ndarray
rata-rata (GPU) : 0.11258
rata-rata (CPU) : 0.11258
hasil sama : True
memori terpakai : True (>= dua larik float32 sejuta elemen)
TypeError: Unsupported type <class 'numpy.ndarray'>CuPy meniru API NumPy: cp.asarray memindahkan data ke GPU, rumusnya persis rumus NumPy, dan float(...) membawa satu angka kembali ke CPU. Hasil GPU dan CPU sama (allclose). Perhatikan baris terakhir: mencampur larik CPU dan GPU dalam satu operasi ditolak dengan TypeError; Anda harus memindahkan secara eksplisit, sehingga ongkos pemindahan tidak tersembunyi. Memori kartu dikelola kolam memori (memory pool): CuPy menahan blok yang sudah dialokasi agar alokasi berikutnya cepat.
09_pindah_data_cpu_gpu.py
# Bab 66 - Memindahkan data CPU <-> GPU: kapan GPU benar-benar menang?
import time

import cupy as cp
import numpy as np


def terbaik(fungsi, ulang=5):
    waktu = []
    for _ in range(ulang):
        mulai = time.perf_counter()
        fungsi()
        cp.cuda.Stream.null.synchronize()       # tunggu GPU selesai sebelum berhenti mengukur
        waktu.append(time.perf_counter() - mulai)
    return min(waktu)


rng = np.random.default_rng(42)

# Kasus 1: larik KECIL (seribu angka): kerepotan menyalakan GPU lebih mahal daripada hitungannya
kecil = rng.random(1_000, dtype=np.float32)
kecil_gpu = cp.asarray(kecil)
cp.exp(kecil_gpu)                                # pemanasan: GPU menyiapkan kernel
cpu = terbaik(lambda: np.exp(kecil))
gpu = terbaik(lambda: cp.exp(kecil_gpu))
print("1. larik kecil, CPU lebih cepat dari GPU                :", cpu < gpu)

# Kasus 2: larik BESAR dan hitungan berat (exp), data SUDAH di GPU
besar = rng.random(20_000_000, dtype=np.float32)   # 80 MB
besar_gpu = cp.asarray(besar)
cp.exp(besar_gpu)
cpu = terbaik(lambda: np.exp(besar), 3)
gpu = terbaik(lambda: cp.exp(besar_gpu), 3)
print("2. larik besar, data sudah di GPU: GPU lebih dari 10x    :", cpu / gpu > 10)

# Kasus 3: SAMA seperti kasus 2, tetapi data harus dikirim dan hasilnya diambil kembali
cpu = terbaik(lambda: np.exp(besar), 3)
gpu = terbaik(lambda: cp.asnumpy(cp.exp(cp.asarray(besar))), 3)
print("3. larik besar + kirim + ambil: GPU lebih dari 2x        :", cpu / gpu > 2)

# Kasus 4: hitungan ringan (tambah 1): waktu habis untuk memindahkan data
cpu = terbaik(lambda: besar + 1, 3)
gpu = terbaik(lambda: cp.asnumpy(cp.asarray(besar) + 1), 3)
print("4. hitungan ringan + pindah data: GPU lebih dari 2x      :", cpu / gpu > 2)
1. larik kecil, CPU lebih cepat dari GPU : True
2. larik besar, data sudah di GPU: GPU lebih dari 10x : True
3. larik besar + kirim + ambil: GPU lebih dari 2x : False
4. hitungan ringan + pindah data: GPU lebih dari 2x : FalseEmpat kasus ini adalah pelajaran terpenting bab ini:
- Larik kecil: CPU menang; menyalakan kernel GPU lebih mahal daripada hitungannya.
- Larik besar, data sudah di GPU, hitungan berat: GPU menang jauh (lebih dari 10 kali).
- Sama, tetapi data harus dikirim dan hasilnya diambil: keunggulan GPU hampir lenyap (tidak sampai 2 kali); dua kali melewati PCIe memakan waktu hampir sebanyak hitungannya.
- Hitungan ringan (tambah 1): GPU kalah; seluruh waktu habis untuk pemindahan.
Aturan praktis: GPU menang bila (a) datanya besar, (b) hitungannya berat per elemen, dan (c) data tetap di GPU untuk banyak langkah berurutan, tidak bolak-balik ke CPU. Itulah mengapa pustaka AI (Bab 55) menyimpan seluruh model dan lapisan di VRAM.
Profiling GPU: mengukur dengan benar
11_profil_gpu.py
# Bab 66 - Profiling GPU: mengukur waktu yang BENAR
import time

import cupy as cp
import numpy as np

x = cp.asarray(np.random.default_rng(42).random(20_000_000, dtype=np.float32))
cp.exp(x)                                           # pemanasan
cp.cuda.Stream.null.synchronize()

# 1. Peluncuran kernel bersifat ASINKRON: Python kembali lebih dulu sebelum GPU selesai
mulai = time.perf_counter()
y = cp.exp(x)
tanpa_sinkron = time.perf_counter() - mulai          # hanya mengukur "memesan" pekerjaan
cp.cuda.Stream.null.synchronize()
mulai = time.perf_counter()
y = cp.exp(x)
cp.cuda.Stream.null.synchronize()                    # tunggu GPU benar-benar selesai
dengan_sinkron = time.perf_counter() - mulai
print("tanpa sinkronisasi tampak jauh lebih cepat (salah ukur):", tanpa_sinkron * 3 < dengan_sinkron)

# 2. Cara resmi dan akurat: event CUDA, jam di dalam GPU
awal, akhir = cp.cuda.Event(), cp.cuda.Event()
awal.record()
y = cp.exp(x)
akhir.record()
akhir.synchronize()
milidetik = cp.cuda.get_elapsed_time(awal, akhir)
print("waktu event CUDA lebih dari 0 ms:", milidetik > 0)

# 3. Memori kartu grafis: total, dan berapa yang kita pakai lewat kolam memori CuPy
bebas, total = cp.cuda.Device().mem_info
print("VRAM total (GiB)                :", round(total / 2**30, 1))
print("kolam memori memegang > 150 MB  :", cp.get_default_memory_pool().total_bytes() > 150e6)

# 4. Melepas memori yang tak terpakai kembali ke kartu grafis
del x, y
cp.get_default_memory_pool().free_all_blocks()
print("sesudah dilepas, kolam memori   :", cp.get_default_memory_pool().total_bytes(), "byte")
tanpa sinkronisasi tampak jauh lebih cepat (salah ukur): True
waktu event CUDA lebih dari 0 ms: True
VRAM total (GiB) : 6.0
kolam memori memegang > 150 MB : True
sesudah dilepas, kolam memori : 0 bytePeluncuran kernel asinkron: Python kembali sesudah “memesan” pekerjaan, sebelum GPU selesai. Pengukuran tanpa synchronize() hanya mengukur waktu memesan, dan di sini tampak lebih dari 3 kali lebih cepat (True): salah ukur. Cara yang akurat adalah event CUDA (jam di dalam GPU) atau menyinkronkan sebelum menghentikan jam. Bagian bawah memeriksa VRAM (6,0 GiB di kartu penulis) dan melepas blok kolam memori (free_all_blocks, sehingga kolam kembali 0 byte). Untuk profiling mendalam (kernel mana yang lambat, pemakaian memori, perbandingan CPU dan GPU), NVIDIA menyediakan Nsight Systems dan Nsight Compute; keduanya terpasang di komputer penulis (folder instalasi ada di C:\Program Files\NVIDIA Corporation), tetapi tidak kami jalankan untuk buku ini karena keluarannya antarmuka grafis dan berbeda tiap komputer.
RAPIDS: pandas dan scikit-learn di GPU
RAPIDS adalah keluarga pustaka NVIDIA: cuDF (mirip pandas), cuML (mirip scikit-learn), cuGraph, dan lain-lain. Ia berguna bila data Anda sudah berbentuk tabel besar. Menurut halaman pemasangan NVIDIA (docs.nvidia.com/datascience/install, dibaca 2026-10-10), RAPIDS membutuhkan GPU compute capability 7.0 atau lebih (kartu penulis 7.5 memenuhi), driver CUDA 12 atau 13 yang cukup baru, dan Linux; pada Windows hanya lewat WSL2 (satu GPU saja). Pemasangan Windows biasa tidak disebut. Karena itu:
12_rapids_cudf.py
# Bab 66 - RAPIDS cuDF: pandas di GPU (TIDAK dijalankan saat buku dibuat)
#
# Jalankan di Linux/WSL2 yang punya GPU NVIDIA (compute capability 7.0 atau lebih),
# setelah memasang cudf sesuai pemilih pemasangan di docs.rapids.ai/install.

# Cara 1: pandas yang sama, dipercepat tanpa mengubah kode.
#   python -m cudf.pandas skrip_ini.py        (di Jupyter: %load_ext cudf.pandas)
import pandas as pd

data = pd.DataFrame({
    "jenis": ["Jati", "Meranti", "Mahoni", "Jati", "Meranti", "Mahoni"] * 1_000_000,
    "diameter_cm": [32.5, 45.2, 28.0, 30.0, 50.0, 26.5] * 1_000_000,
})
print(data.groupby("jenis")["diameter_cm"].mean())    # dikerjakan GPU; bila tak didukung, kembali ke pandas

# Cara 2: memakai cuDF langsung (API mirip pandas)
import cudf

gdf = cudf.DataFrame({"jenis": ["Jati", "Meranti"], "diameter_cm": [32.5, 45.2]})
print(gdf.groupby("jenis")["diameter_cm"].mean())
Kode ini tidak dijalankan saat buku dibuat karena RAPIDS tidak tersedia di Windows biasa, jadi keluarannya tidak ditampilkan. Fitur menarik cudf.pandas: kode pandas yang sama berjalan di GPU bila didukung, dan kembali ke pandas (CPU) untuk operasi yang belum didukung (sumber: dokumentasi cuDF, dibaca 2026-10-10). Nama python -m cudf.pandas skrip.py adalah bentuk yang kami simpulkan dari dokumentasi, belum kami uji.
Proyek Bersambung A5: indeks vegetasi empat cara
Kita satukan semuanya: NDVI untuk citra tiruan 2048 x 2048 piksel (4 juta piksel), dengan NumPy, numba, numba-CUDA, dan CuPy.
13_proyek_ndvi_empat_cara.py
# Bab 66 - Proyek A5: indeks vegetasi (NDVI) untuk citra 2048 x 2048, empat cara
import time
import warnings

import numpy as np

if not hasattr(np, "row_stack"):         # tambalan sementara numba-cuda (lihat skrip 10)
    np.row_stack = np.vstack
warnings.filterwarnings("ignore")

import cupy as cp
from numba import cuda, njit

rng = np.random.default_rng(42)
merah = rng.uniform(0.05, 0.40, (2048, 2048)).astype(np.float32)   # citra tiruan 4 juta piksel
nir = rng.uniform(0.20, 0.60, (2048, 2048)).astype(np.float32)


def ndvi_numpy(m, n):
    return (n - m) / (n + m)


@njit
def ndvi_numba(m, n):
    hasil = np.empty_like(m)
    for i in range(m.shape[0]):
        for j in range(m.shape[1]):
            hasil[i, j] = (n[i, j] - m[i, j]) / (n[i, j] + m[i, j])
    return hasil


@cuda.jit
def kernel(m, n, hasil):
    i, j = cuda.grid(2)
    if i < hasil.shape[0] and j < hasil.shape[1]:
        hasil[i, j] = (n[i, j] - m[i, j]) / (n[i, j] + m[i, j])


d_m, d_n = cuda.to_device(merah), cuda.to_device(nir)
d_hasil = cuda.device_array_like(d_m)
kisi, blok = (128, 128), (16, 16)


def ndvi_numba_cuda():
    kernel[kisi, blok](d_m, d_n, d_hasil)
    cuda.synchronize()


c_m, c_n = cp.asarray(merah), cp.asarray(nir)


def ndvi_cupy():
    hasil = (c_n - c_m) / (c_n + c_m)
    cp.cuda.Stream.null.synchronize()
    return hasil


def terbaik(fungsi, ulang=7):
    waktu = []
    for _ in range(ulang):
        mulai = time.perf_counter()
        fungsi()
        waktu.append(time.perf_counter() - mulai)
    return min(waktu)


acuan = ndvi_numpy(merah, nir)
ndvi_numba(merah, nir)                   # pemanasan: kompilasi
ndvi_numba_cuda()
print("numba sama dengan NumPy      :", np.allclose(ndvi_numba(merah, nir), acuan))
print("numba-CUDA sama dengan NumPy :", np.allclose(d_hasil.copy_to_host(), acuan, atol=1e-6))
print("CuPy sama dengan NumPy       :", np.allclose(ndvi_cupy().get(), acuan, atol=1e-6))

t_numpy = terbaik(lambda: ndvi_numpy(merah, nir))
t_numba = terbaik(lambda: ndvi_numba(merah, nir))
t_cuda = terbaik(ndvi_numba_cuda)
t_cupy = terbaik(ndvi_cupy)
print("numba lebih cepat dari NumPy             :", t_numba < t_numpy)
print("GPU (data sudah di kartu) lebih dari 10x NumPy:", min(t_cuda, t_cupy) * 10 < t_numpy)
print("CuPy dan numba-CUDA setara (selisih < 5x):", max(t_cuda, t_cupy) < 5 * min(t_cuda, t_cupy))
numba sama dengan NumPy : True
numba-CUDA sama dengan NumPy : True
CuPy sama dengan NumPy : True
numba lebih cepat dari NumPy : True
GPU (data sudah di kartu) lebih dari 10x NumPy: True
CuPy dan numba-CUDA setara (selisih < 5x): TrueKeempatnya menghasilkan angka yang sama dalam toleransi. numba mengalahkan NumPy (kemungkinan karena ia menghindari larik sementara), dan GPU dengan data yang sudah ada di kartu mengalahkan NumPy lebih dari 10 kali; CuPy dan kernel numba-CUDA setara. Tetapi ingat pelajaran bab ini: angka GPU itu belum memasukkan waktu mengirim citra ke kartu dan mengambil hasilnya. Untuk satu citra yang dibaca dari disk lalu langsung disimpan, mungkin CPU dengan numba sudah cukup. Untuk ribuan citra yang diproses berantai di GPU, atau saat banyak komputer mengerjakannya bersama, GPU dan pembagian kerja mulai berguna, dan itulah topik Bab 67.
| Kebutuhan | Pilihan awal | Catatan |
|---|---|---|
| Perulangan numerik di larik NumPy | numba | mudah; kompilasi saat panggilan pertama |
| Modul yang dibagikan sebagai paket | Cython atau Rust (PyO3) | butuh kompilator saat membangun |
| Memanggil pustaka C yang sudah ada | ctypes atau cffi | tentukan tipe dengan teliti |
| Larik/matriks besar, hitungan berat | CuPy | data tetap di GPU selama mungkin |
| Logika khusus per elemen di GPU | kernel (numba-CUDA/RawKernel) |
tulis dan ukur; waspada status pemeliharaan |
| Tabel besar | Polars/DuckDB (Bab 50) atau RAPIDS | RAPIDS butuh Linux/WSL2 |
Latihan
- Ubah
01_numba_njit.py: hitung juga EVI atau indeks lain dari tiga pita, dan buktikan hasil numba sama dengan NumPy. - Pada
02_numba_paralel_vectorize.py, ganti@njit(parallel=True)dengan@njitbiasa. Apakah hasilnya tetap sama? Mengapa hasil penjumlahan bilangan desimal paralel boleh berbeda di angka paling belakang? - Ulangi
09_pindah_data_cpu_gpu.pydengan larik berukuran 100.000 dan 2.000.000 elemen. Di ukuran berapa (kira-kira) GPU mulai menang di kasus 2? - Tantangan: tulis kernel numba-CUDA yang menghitung
luas_dasar = pi * (diameter / 200) ** 2untuk satu juta pohon, bandingkan dengan CuPy (08_cupy_dasar.py), dan tentukan apakah hasilnya sama.
Ringkasan Bab
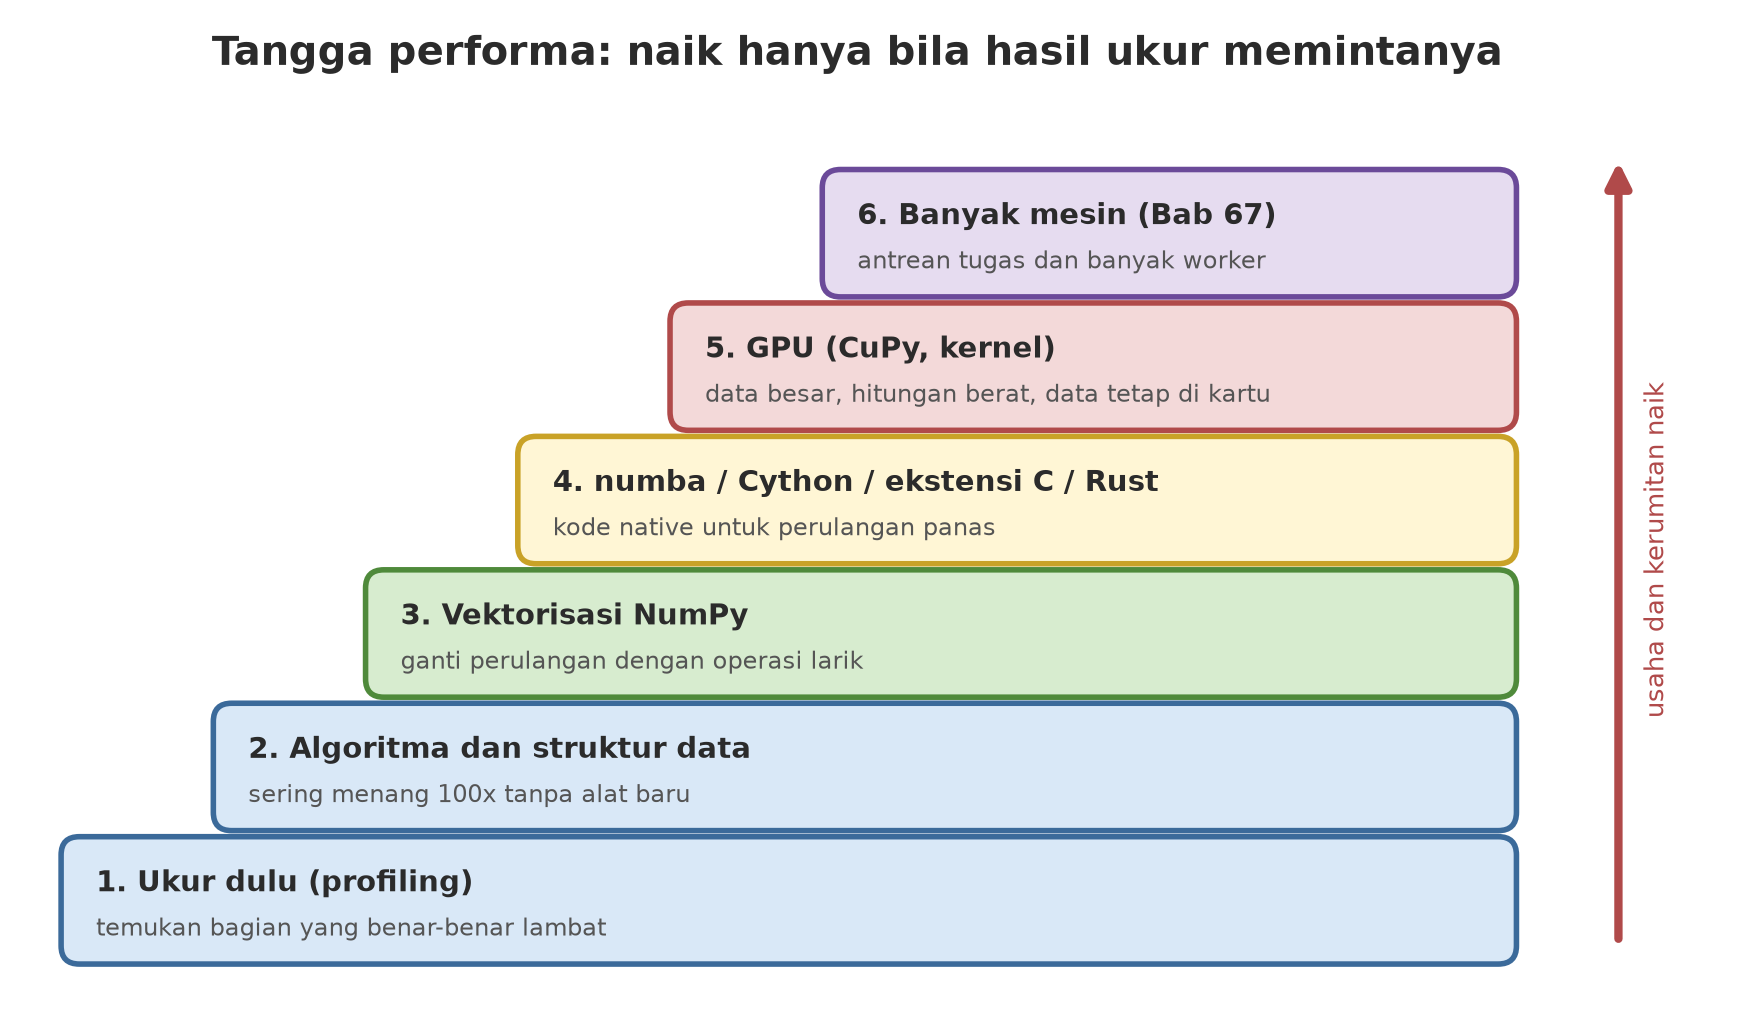
- Urutan naik: algoritma dan vektorisasi (Bab 44), lalu numba, Cython/ekstensi C/Rust, lalu GPU. Naik hanya bila hasil pengukuran memintanya.
- numba mengompilasi fungsi saat panggilan pertama; ukur tanpa panggilan pertama. Cython dan ekstensi C dikompilasi sekali, butuh kompilator.
- ctypes dan cffi memanggil pustaka native; tipe harus dideklarasikan dengan teliti.
- Rust (PyO3) dijelaskan dari dokumentasi resmi tetapi tidak diuji di sini.
- GPU menang bila data besar, hitungan berat, dan data tetap di kartu; memindahkan data CPU-GPU adalah ongkos yang sering menghapus keuntungan.
- Ukur GPU dengan sinkronisasi atau event CUDA; peluncuran kernel itu asinkron.
- numba-CUDA berstatus pemeliharaan dan di sini butuh tambalan; RAPIDS butuh Linux/WSL2 dan tidak diuji.
Selanjutnya, di Bab 67: satu komputer sudah dimaksimalkan. Sekarang kita membagi pekerjaan ke banyak worker: antrean tugas dengan Celery dan RQ, coba-ulang saat gagal, dan hitungan biaya, dengan studi kasus ribuan foto drone dan citra satelit.