Bab 65 — Internals CPython: Mengintip Ruang Mesin
Seri A5 — Python Tingkat Ahli
Semua skrip bab ini ada di folder kode/bab65/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Di Bab 64 kita membuka kap mobil Python lewat deskriptor dan AST. Sekarang kita menengok mesinnya: CPython, yaitu implementasi Python resmi yang ditulis dalam bahasa C dan yang hampir pasti Anda pakai (ada juga PyPy, MicroPython, dan lain-lain). Ibarat membuka gudang hasil panen: Anda mau tahu bagaimana karung ditumpuk (objek dan memori), siapa yang mencatat karung kosong lalu membuangnya (penghitung referensi dan pembersih), dan bagaimana mandor membaca perintah (bytecode). Fakta di bab ini dijalankan di Python 3.14.8 dan dicocokkan dengan dokumentasi 3.14 (docs.python.org: “What’s New in Python 3.14”, gc, dis, concurrent.interpreters, dan “Python support for free threading”; semua dibaca 2026-10-10). Catatan versi: blog resmi Python Insider melaporkan Python 3.15.0 final dirilis pada 9 Oktober 2026 (blog.python.org, dibaca 2026-10-10). Buku ini tetap memakai 3.14 sebagai acuan; untuk perbedaan di 3.15, baca halaman “What’s New in Python 3.15” di docs.python.org.
Hampir semua yang dibahas di sini adalah detail implementasi CPython, bukan janji bahasa Python. Angka ukuran memori, bentuk bytecode, dan nilai ambang gc bisa berubah antarversi. Pakai untuk memahami dan mengukur, jangan menggantungkan program pada angka-angka itu.
Semua adalah objek
Di CPython setiap nilai, bahkan angka 3 dan fungsi len, adalah objek di memori. Tiap objek punya identitas (alamat), jenis (type), dan nilai. Nama variabel hanyalah label yang ditempel pada objek.
01_objek_dan_identitas.py
# Bab 65 - Semua adalah objek: identitas, jenis, dan nilai
import sys

# Setiap objek punya tiga hal: identitas (id), jenis (type), dan nilai
a = [1, 2, 3]
b = a                     # b menunjuk objek yang SAMA, bukan salinan
c = [1, 2, 3]             # objek lain dengan isi yang sama
print(a is b, a is c, a == c)
b.append(4)
print(a)                  # a ikut berubah, karena a dan b satu objek

# Nama hanyalah label yang menempel pada objek
print(type(a).__name__, type(len).__name__, type(Exception).__name__)

# Bilangan bulat kecil dipakai bersama (di CPython: -5 sampai 256)
for n in (255, 256, 257):
    x, y = int(str(n)), int(str(n))     # dibuat saat program berjalan, bukan konstanta
    print(n, "objek sama" if x is y else "objek berbeda")

# String yang "diinternkan" juga dipakai bersama
s1 = "".join(["pohon", "_jati"])
s2 = "".join(["pohon", "_jati"])
print(s1 == s2, s1 is s2, sys.intern(s1) is sys.intern(s2))

# Ukuran objek (byte). Angka ini khas CPython 3.14 di Windows 64-bit
for contoh in (0, 2**64, 1.5, "a", "a" * 100, (), [], {}):
    print(f"{type(contoh).__name__:>5} {sys.getsizeof(contoh):>4}")
True False True
[1, 2, 3, 4]
list builtin_function_or_method type
255 objek sama
256 objek sama
257 objek berbeda
True False True
int 28
int 36
float 24
str 42
str 141
tuple 48
list 56
dict 64b = atidak menyalin:a is bbernilaiTruedanappendlewatbmengubaha.cberisi sama (==) tetapi objek lain (isbernilaiFalse).- Bilangan bulat 255 dan 256 dipakai bersama (objek sama), sedangkan 257 dibuat baru tiap kali. CPython menyimpan bilangan kecil (-5 sampai 256) agar tidak membuat ulang. Itu penghematan internal; jangan membandingkan angka dengan
is, gunakan==. - String bisa diinternkan (
sys.intern): dua string berisi sama dijadikan satu objek untuk menghemat memori dan mempercepat perbandingan. - Ukuran: bilangan kecil 28 byte, string satu huruf 42 byte, dict kosong 64 byte. Objek “kosong” pun makan puluhan byte karena ada kepala objek (penghitung referensi dan penunjuk jenis).
02_pertumbuhan_list.py
# Bab 65 - List menyediakan ruang cadangan agar append() cepat
import sys

daftar = []
ukuran_lama = sys.getsizeof(daftar)
naik = []
print(f"list kosong: {ukuran_lama} byte")
for i in range(1, 41):
    daftar.append(i)
    ukuran = sys.getsizeof(daftar)
    if ukuran != ukuran_lama:               # hanya cetak saat memori ditambah
        print(f"isi {i:>2} elemen -> memori naik ke {ukuran} byte")
        ukuran_lama = ukuran
        naik.append((i, ukuran))

# Tiap elemen list hanyalah penunjuk; objeknya ada di tempat lain
(n1, u1), (n2, u2) = naik[0], naik[1]
print(f"dari {n1} ke {n2} elemen memori naik {u2 - u1} byte; per elemen: {(u2 - u1) // (n2 - n1)} byte (satu penunjuk)")

# Perbandingan: tuple tidak punya ruang cadangan
print(sys.getsizeof((1, 2, 3, 4)), "byte untuk tuple 4 elemen vs",
      sys.getsizeof([1, 2, 3, 4]), "byte untuk list 4 elemen")
list kosong: 56 byte
isi 1 elemen -> memori naik ke 88 byte
isi 5 elemen -> memori naik ke 120 byte
isi 9 elemen -> memori naik ke 184 byte
isi 17 elemen -> memori naik ke 248 byte
isi 25 elemen -> memori naik ke 312 byte
isi 33 elemen -> memori naik ke 376 byte
dari 1 ke 5 elemen memori naik 32 byte; per elemen: 8 byte (satu penunjuk)
80 byte untuk tuple 4 elemen vs 88 byte untuk list 4 elemenList tidak menambah memori tiap append. Ia menyediakan ruang cadangan (naik di elemen ke-1, 5, 9, 17, …), sehingga append rata-rata sangat murah. Dari 1 ke 5 elemen memori naik 32 byte untuk 4 elemen baru: 8 byte per elemen, yaitu satu penunjuk (list hanya menyimpan penunjuk, bukan objeknya). Tuple tidak punya ruang cadangan sehingga lebih kecil (80 lawan 88 byte).
Penghitung referensi dan garbage collector
Setiap objek mencatat berapa nama atau wadah yang menunjuknya: penghitung referensi (reference count). Saat hitungan jatuh ke nol, objek dibuang seketika.
03_hitung_referensi.py
# Bab 65 - Penghitung referensi: kapan sebuah objek dibuang?
import sys
import weakref


class Pohon:
    def __init__(self, nama):
        self.nama = nama

    def __del__(self):
        print(f"  [__del__] {self.nama} dibersihkan")


p = Pohon("jati-1")
dasar = sys.getrefcount(p)       # angka ini selalu +1 karena argumen pemanggilan ikut menghitung
print("hitungan dasar tercatat")

daftar = [p]                      # satu penunjuk baru
print("setelah masuk list    :", sys.getrefcount(p) - dasar)
kamus = {"a": p}                  # satu lagi
print("setelah masuk dict    :", sys.getrefcount(p) - dasar)
del daftar
print("setelah list dibuang  :", sys.getrefcount(p) - dasar)
del kamus
print("setelah dict dibuang  :", sys.getrefcount(p) - dasar)

lemah = weakref.ref(p)            # referensi lemah: tidak menahan objek tetap hidup
print("referensi lemah hidup :", lemah() is not None)
print("membuang nama terakhir:")
del p                             # hitungan menjadi 0 -> dibersihkan SEKARANG juga
print("referensi lemah hidup :", lemah() is not None)
hitungan dasar tercatat
setelah masuk list : 1
setelah masuk dict : 2
setelah list dibuang : 1
setelah dict dibuang : 0
referensi lemah hidup : True
membuang nama terakhir:
[__del__] jati-1 dibersihkan
referensi lemah hidup : Falsegetrefcount selalu lebih satu dari kenyataan karena argumennya sendiri ikut menunjuk, maka kita mencetak selisih: masuk list +1, masuk dict +2, dibuang kembali ke 1 dan 0. Saat del p membuang nama terakhir, __del__ berjalan saat itu juga (bandingkan dengan bahasa yang membersihkan “nanti”). Referensi lemah (weakref) menunjuk tanpa menambah hitungan, jadi ia tahu kapan objek sudah mati: itu dasar cache yang tidak menahan memori.
Penghitung punya kelemahan: dua objek yang saling menunjuk (siklus) tidak pernah turun ke nol. Untuk itu ada pembersih tambahan, garbage collector (modul gc):
04_gc_siklus.py
# Bab 65 - Garbage collector: penyapu untuk objek yang saling menunjuk
import gc
import weakref


class Simpul:
    def __init__(self, nama):
        self.nama = nama
        self.pasangan = None


gc.collect()
gc.disable()                      # matikan penyapu otomatis agar kita bisa mengamati

a, b = Simpul("a"), Simpul("b")
a.pasangan, b.pasangan = b, a     # saling menunjuk: sebuah SIKLUS
lemah = weakref.ref(a)
del a, b                          # nama dibuang, tetapi a dan b masih saling memegang
print("sesudah del, masih ada di memori:", lemah() is not None)

ditemukan = gc.collect()          # penyapu mencari objek yang tak terjangkau lagi
print("collect() menemukan sampah    :", ditemukan > 0)
print("sesudah collect, masih ada    :", lemah() is not None)
gc.enable()

print("jumlah generasi               :", len(gc.get_threshold()))
print("kunci statistik per generasi  :", sorted(gc.get_stats()[0]))
sesudah del, masih ada di memori: True
collect() menemukan sampah : True
sesudah collect, masih ada : False
jumlah generasi : 3
kunci statistik per generasi : ['collected', 'collections', 'uncollectable']Setelah del a, b, kedua simpul masih saling memegang sehingga masih ada di memori. gc.collect() mencari objek yang tak terjangkau lagi, menemukannya, dan membuangnya. Pembersih ini membagi objek dalam tiga generasi (objek muda lebih sering diperiksa). Ada catatan versi yang jujur dari dokumentasi: Python 3.14.0 sampai 3.14.4 membawa GC incremental, tetapi karena laporan tekanan memori di produksi, sejak 3.14.5 kembali ke GC generasi seperti 3.13; komputer penulis memakai 3.14.8, jadi itulah yang berlaku di sini.
Hindari siklus bila bisa (pakai weakref untuk penunjuk balik “anak ke induk”). Mematikan gc (gc.disable()) hanya masuk akal bila Anda yakin tidak ada siklus; dokumentasi resmi menyebut hal itu, tetapi risikonya kebocoran memori.
Bytecode: perintah untuk mesin virtual
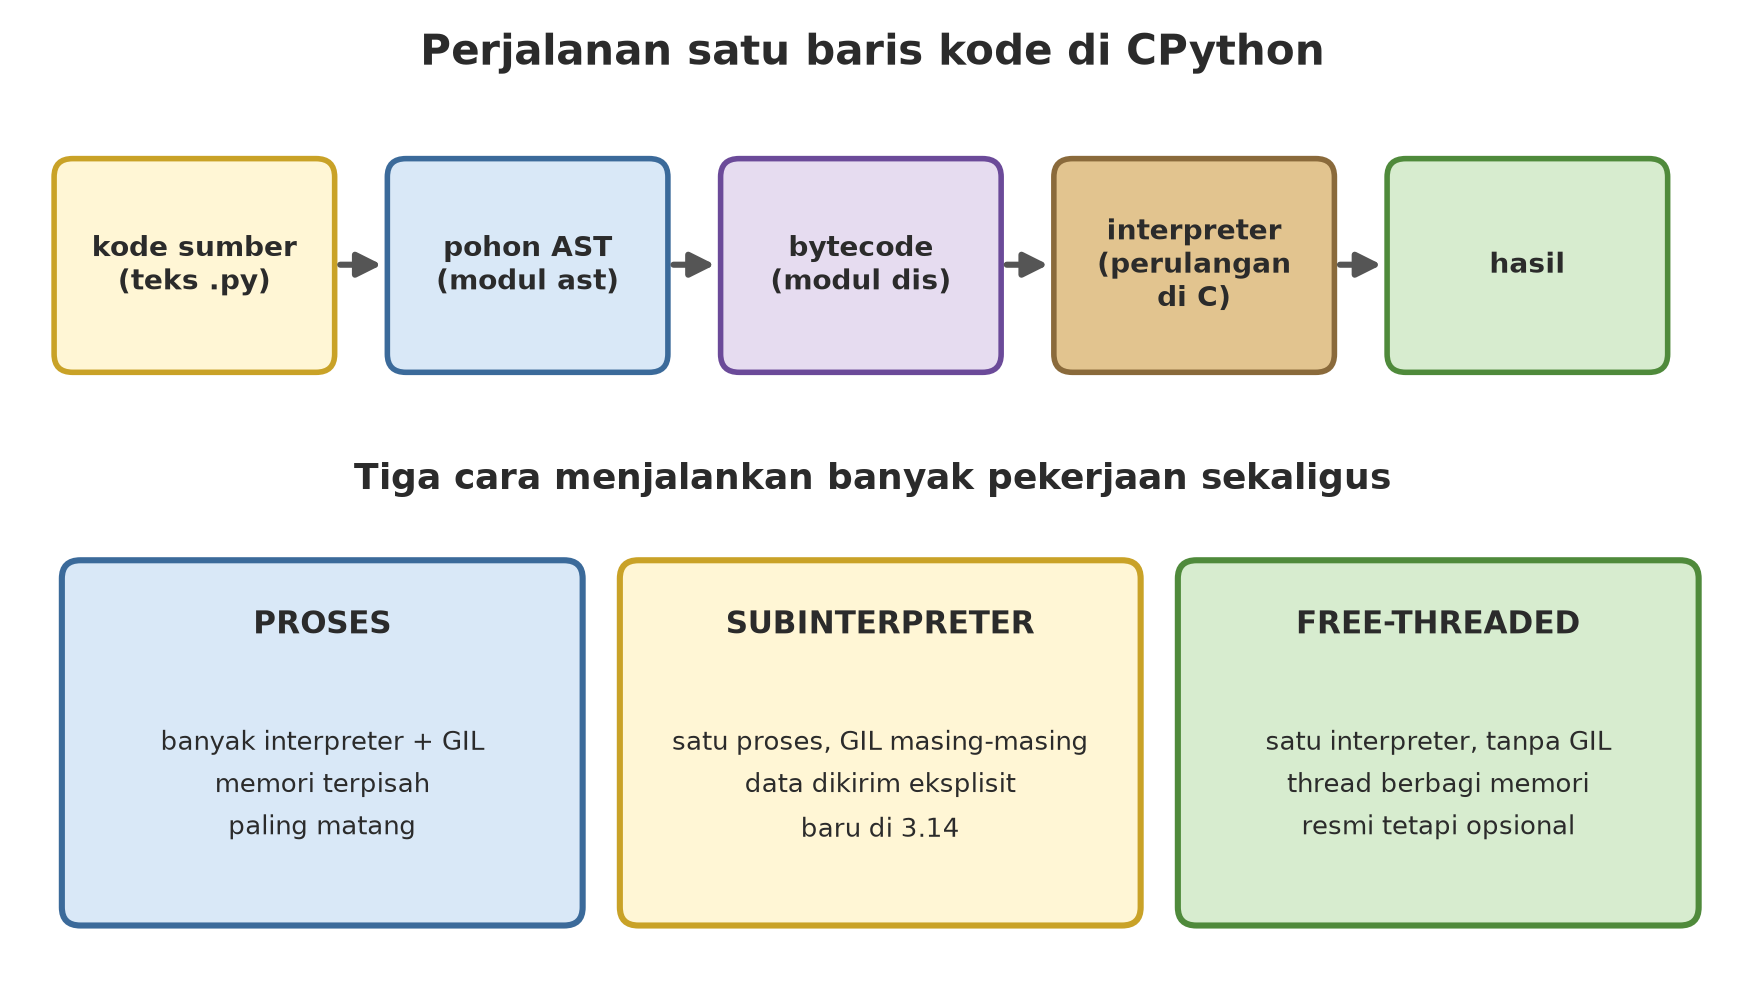
Python tidak langsung menjalankan teks Anda. Ia mengubahnya menjadi bytecode, daftar instruksi kecil untuk mesin virtual CPython, lalu sebuah perulangan besar di C menjalankannya satu per satu.
05_bytecode_dis.py
# Bab 65 - Bytecode: bahasa mesin virtual Python
import dis


def biomassa(jumlah, bobot):
    return jumlah * bobot / 1000


dis.dis(biomassa)
kode = biomassa.__code__
print("konstanta :", kode.co_consts)
print("variabel  :", kode.co_varnames)


def total(daftar):
    hasil = 0
    for x in daftar:
        hasil += x
    return hasil


# Python "belajar" dari pemakaian: sesudah dipanggil berulang, instruksi dispesialisasi
for _ in range(200):
    total([1, 2, 3])
print("--- sesudah dipanggil 200 kali (adaptive=True) ---")
dis.dis(total, adaptive=True)
5 RESUME 0
6 LOAD_FAST_BORROW_LOAD_FAST_BORROW 1 (jumlah, bobot)
BINARY_OP 5 (*)
LOAD_CONST 0 (1000)
BINARY_OP 11 (/)
RETURN_VALUE
konstanta : (1000,)
variabel : ('jumlah', 'bobot')
--- sesudah dipanggil 200 kali (adaptive=True) ---
15 RESUME_CHECK 0
16 LOAD_SMALL_INT 0
STORE_FAST 1 (hasil)
17 LOAD_FAST_BORROW 0 (daftar)
GET_ITER
L1: FOR_ITER_LIST 11 (to L2)
STORE_FAST 2 (x)
18 LOAD_FAST_BORROW_LOAD_FAST_BORROW 18 (hasil, x)
BINARY_OP_ADD_INT 13 (+=)
STORE_FAST 1 (hasil)
JUMP_BACKWARD_NO_JIT 13 (to L1)
17 L2: END_FOR
POP_ITER
19 LOAD_FAST_BORROW 1 (hasil)
RETURN_VALUERumus jumlah * bobot / 1000 menjadi: muat dua variabel, BINARY_OP perkalian (*, kode 5), muat konstanta 1000, BINARY_OP pembagian, RETURN_VALUE. Ini mesin bertumpuk (stack machine): angka diletakkan di tumpukan lalu operasi mengambilnya.
Bagian kedua menunjukkan hal menarik sejak Python 3.11: interpreter adaptif. Setelah fungsi total dipanggil 200 kali, instruksi umum diganti versi khusus yang tahu tipenya: FOR_ITER menjadi FOR_ITER_LIST (iterasi list) dan += menjadi BINARY_OP_ADD_INT (tambah dua int). Dokumentasi dis mengingatkan: bytecode adalah detail implementasi tanpa jaminan antarversi.
GIL, free-threaded, dan subinterpreter
GIL (Global Interpreter Lock) adalah kunci global: pada build biasa, hanya satu thread yang menjalankan bytecode Python pada satu saat. Akibatnya: thread tetap berguna untuk pekerjaan menunggu (jaringan, berkas, sleep), tetapi tidak mempercepat pekerjaan menghitung.
06_gil_dan_thread.py
# Bab 65 - GIL: apakah build Python ini punya gembok global?
import sys
import sysconfig
import threading
import time

print("build free-threaded :", bool(sysconfig.get_config_var("Py_GIL_DISABLED")))
print("GIL aktif sekarang  :", sys._is_gil_enabled())


# Tugas yang MENUNGGU (I/O): thread tetap berguna walau ada GIL,
# karena saat menunggu, sebuah thread melepas GIL.
def menunggu():
    time.sleep(0.2)


mulai = time.perf_counter()
pekerja = [threading.Thread(target=menunggu) for _ in range(8)]
for t in pekerja:
    t.start()
for t in pekerja:
    t.join()
lama = time.perf_counter() - mulai
print("8 tugas menunggu 0,2 dtk selesai dalam < 1 dtk (bukan 1,6 dtk):", lama < 1.0)

# Data bersama tetap perlu kunci (Lock), dengan atau tanpa GIL
total = 0
kunci = threading.Lock()


def tambah(n):
    global total
    for _ in range(n):
        with kunci:
            total += 1


pekerja = [threading.Thread(target=tambah, args=(20000,)) for _ in range(4)]
for t in pekerja:
    t.start()
for t in pekerja:
    t.join()
print("total dengan Lock    :", total)
build free-threaded : False
GIL aktif sekarang : True
8 tugas menunggu 0,2 dtk selesai dalam < 1 dtk (bukan 1,6 dtk): True
total dengan Lock : 80000Delapan tugas yang masing-masing menunggu 0,2 detik selesai dalam waktu jauh di bawah 1,6 detik, karena thread yang menunggu melepas GIL. Lock tetap diperlukan untuk data bersama (total 80.000 = 4 x 20.000).
07_thread_cpu.py
# Bab 65 - Thread untuk pekerjaan CPU: apakah benar-benar paralel?
import sys
import threading
import time


def hitung(n):
    total = 0
    for i in range(n):
        total += i * i
    return total


N, JUMLAH = 1_500_000, 4


def berurutan():
    for _ in range(JUMLAH):
        hitung(N)


def paralel():
    pekerja = [threading.Thread(target=hitung, args=(N,)) for _ in range(JUMLAH)]
    for t in pekerja:
        t.start()
    for t in pekerja:
        t.join()


def terbaik(fungsi, ulang=5):
    """Waktu tercepat dari beberapa percobaan: lebih tahan terhadap gangguan komputer."""
    hasil = []
    for _ in range(ulang):
        mulai = time.perf_counter()
        fungsi()
        hasil.append(time.perf_counter() - mulai)
    return min(hasil)


percepatan = terbaik(berurutan) / terbaik(paralel)
print("GIL aktif                           :", sys._is_gil_enabled())
print("4 thread lebih dari 1,5x lebih cepat:", percepatan > 1.5)
GIL aktif : True
4 thread lebih dari 1,5x lebih cepat: FalseUntuk pekerjaan menghitung murni, empat thread tidak lebih dari 1,5 kali lebih cepat di build biasa ini. Sejak Python 3.14, ada alternatif resmi: build free-threaded tanpa GIL. Menurut “What’s New in Python 3.14”, build itu kini “officially supported” (PEP 779; fase II: didukung tetapi masih opsional), dan penalti kecepatan pada kode satu-thread diperkirakan sekitar 5-10%. Komputer penulis tidak memilikinya secara bawaan, sehingga kami memasangnya terpisah (Python 3.14.6 free-threaded lewat uv python install 3.14+freethreaded, tidak mengganggu Python utama) dan menjalankan skrip yang sama:
08_thread_cpu_bebas_gil.py
# Bab 65 - Skrip yang sama, dijalankan dengan Python free-threaded
import os
import subprocess
from pathlib import Path

# Alamat penafsir free-threaded milik Anda: isi lewat variabel lingkungan PYTHON_FT.
# Contoh pemasangan yang tidak mengganggu Python utama:  uv python install 3.14+freethreaded
penafsir = os.environ.get("PYTHON_FT")
if not penafsir:
    raise SystemExit("isi PYTHON_FT dengan alamat python 3.14t Anda")

skrip = Path(__file__).with_name("07_thread_cpu.py")
hasil = subprocess.run([penafsir, str(skrip)], capture_output=True, text=True, check=True)
print(hasil.stdout.strip())
GIL aktif : False
4 thread lebih dari 1,5x lebih cepat: TrueKeluaran ini diambil sekali dari komputer penulis (@statis; angka di komputer Anda berbeda): GIL mati (False) dan empat thread kini lebih dari 1,5 kali lebih cepat. Ingat peringatan dokumentasi: sebagian pustaka dengan modul C belum siap dan menyalakan kembali GIL saat diimpor (daftar dukungan ada di py-free-threading.github.io). Anda juga bisa menyalakan atau mematikan GIL di build itu lewat PYTHON_GIL atau -X gil; kami mencoba PYTHON_GIL=1 dan -X gil=1, dan keduanya membuat sys._is_gil_enabled() kembali True. Cara memasang di Windows menurut dokumentasi: py install 3.14t (Python install manager), lalu py -V:3.14t (perintah ini belum kami uji; kami memakai uv).
JIT eksperimental (Just-In-Time compiler, menerjemahkan kode panas menjadi mesin) ikut dalam biner resmi Windows dan macOS sejak 3.14, tetapi tidak dianjurkan untuk produksi: dokumentasi menyebut dampaknya “10% lebih lambat sampai 20% lebih cepat” tergantung beban, dan build free-threaded belum mendukung JIT.
09_jit_eksperimental.py
# Bab 65 - JIT eksperimental: ada di build, tetapi mati secara bawaan
import os
import subprocess
import sys

print("JIT tersedia di build ini :", sys._jit.is_available())
print("JIT aktif secara bawaan   :", sys._jit.is_enabled())

KODE = """
import sys
def f(n):
    total = 0
    for i in range(n):
        total += i * i
    return total
print(sys._jit.is_enabled(), f(300000))
"""

for nilai in ("0", "1"):
    lingkungan = dict(os.environ, PYTHON_JIT=nilai)
    hasil = subprocess.run([sys.executable, "-c", KODE], env=lingkungan,
                           capture_output=True, text=True, check=True)
    jit_aktif, jumlah = hasil.stdout.split()
    print(f"PYTHON_JIT={nilai}: JIT aktif={jit_aktif}, hasil hitungan={jumlah}")
JIT tersedia di build ini : True
JIT aktif secara bawaan : False
PYTHON_JIT=0: JIT aktif=False, hasil hitungan=8999955000050000
PYTHON_JIT=1: JIT aktif=True, hasil hitungan=8999955000050000JIT tersedia di build penulis tetapi mati secara bawaan; PYTHON_JIT=1 menyalakannya dan hasil hitungan tetap sama. Kami tidak menampilkan perbandingan kecepatan karena hasilnya bergantung beban dan mesin.
Jalur ketiga: subinterpreter (PEP 734, modul concurrent.interpreters baru di 3.14). Sebuah proses boleh memuat banyak interpreter terpisah; masing-masing punya GIL sendiri, sehingga gabungan thread dan subinterpreter memberi paralelisme multi-inti tanpa harus memakai proses terpisah.
10_subinterpreter.py
# Bab 65 - Subinterpreter: banyak "Python mini" dalam satu proses
from concurrent import interpreters
from concurrent.futures import InterpreterPoolExecutor

utama = "variabel milik interpreter utama"

# 1. Subinterpreter punya dunia sendiri: variabel global tidak dibagi
sub = interpreters.create()
sub.exec("x = 41")
sub.exec("x += 1")
print("x di dalam sub      :", sub.call(eval, "x"))
try:
    sub.call(eval, "utama")
except interpreters.ExecutionFailed as e:
    print("utama terlihat dari sub?", False, "-", type(e).__name__)

# 2. Data dikirim secara eksplisit, misalnya lewat antrean
antrean = interpreters.create_queue()
sub.prepare_main(q=antrean)
sub.exec("q.put('halo dari sub')")
print("dari antrean        :", antrean.get())
sub.close()
print("interpreter tersisa :", len(interpreters.list_all()))


# 3. Kumpulan pekerja: tiap pekerja adalah subinterpreter, tanpa saling mengunci GIL
def jumlah_kuadrat(n):
    total = 0
    for i in range(n):
        total += i * i
    return total


with InterpreterPoolExecutor(max_workers=3) as kolam:
    print("hasil paralel       :", list(kolam.map(jumlah_kuadrat, [10, 100, 1000])))
x di dalam sub : 42
utama terlihat dari sub? False - ExecutionFailed
dari antrean : halo dari sub
interpreter tersisa : 1
hasil paralel : [285, 328350, 332833500]Sub punya dunianya sendiri (x dihitung di dalam, variabel utama tidak terlihat), data dikirim eksplisit lewat antrean, dan InterpreterPoolExecutor menjalankan fungsi di beberapa pekerja. Dokumentasi mengingatkan: memulai interpreter belum dioptimalkan, banyak paket PyPI belum mendukung, dan jangan memakainya sebagai batas keamanan.
Tiga jalan menuju paralelisme CPU di Python: proses (multiprocessing; paling matang), subinterpreter (baru; 3.14), dan thread di build free-threaded (resmi tetapi opsional). Di Bab 66 dan 67 kita memakai jalan lain yang lebih praktis hari ini: kode native dan banyak worker.
Proyek Bersambung A5: memilih struktur data dari ukuran memori
Proyek A5 harus mempercepat bagian kritis. Langkah pertama adalah mengukur. Berapa memori untuk 50.000 catatan pohon (diameter dan tinggi) dalam lima bentuk?
11_proyek_memori_pohon.py
# Bab 65 - Proyek A5: berapa memori untuk 50.000 catatan pohon?
import tracemalloc
from dataclasses import dataclass

import numpy as np

N = 50_000


@dataclass
class PohonBiasa:
    diameter_cm: float
    tinggi_m: float


@dataclass(slots=True)
class PohonSlots:
    diameter_cm: float
    tinggi_m: float


def dari_dict(i):
    return {"diameter_cm": 20 + i * 0.001, "tinggi_m": 10 + i * 0.0005}


def dari_tuple(i):
    return (20 + i * 0.001, 10 + i * 0.0005)


def dari_biasa(i):
    return PohonBiasa(20 + i * 0.001, 10 + i * 0.0005)


def dari_slots(i):
    return PohonSlots(20 + i * 0.001, 10 + i * 0.0005)


def byte_per_catatan(pabrik):
    tracemalloc.start()
    sebelum = tracemalloc.get_traced_memory()[0]
    koleksi = [pabrik(i) for i in range(N)]
    sesudah = tracemalloc.get_traced_memory()[0]
    tracemalloc.stop()
    return round((sesudah - sebelum) / len(koleksi))


hasil = {nama: byte_per_catatan(f) for nama, f in
         [("dict", dari_dict), ("kelas biasa", dari_biasa),
          ("tuple", dari_tuple), ("kelas slots", dari_slots)]}

# Susunan kolom NumPy: dua larik float64, tanpa objek Python per catatan
tracemalloc.start()
sebelum = tracemalloc.get_traced_memory()[0]
diameter = np.linspace(20, 20 + N * 0.001, N)
tinggi = np.linspace(10, 10 + N * 0.0005, N)
sesudah = tracemalloc.get_traced_memory()[0]
tracemalloc.stop()
hasil["larik NumPy"] = round((sesudah - sebelum) / N)

for nama, byte in sorted(hasil.items(), key=lambda kv: -kv[1]):
    print(f"{nama:<12} {byte:>4} byte/catatan  {'#' * (byte // 8)}")
print("Larik NumPy lebih hemat dari dict lebih dari 10x:", hasil["dict"] / hasil["larik NumPy"] > 10)
dict 241 byte/catatan ##############################
kelas biasa 145 byte/catatan ##################
tuple 121 byte/catatan ###############
kelas slots 105 byte/catatan #############
larik NumPy 16 byte/catatan ##
Larik NumPy lebih hemat dari dict lebih dari 10x: TrueSatu dict per catatan memakan 241 byte; kelas biasa 145; tuple 121; kelas dengan __slots__ 105 (tanpa kamus per objek); sedangkan larik NumPy hanya 16 byte (dua float 8 byte, tanpa objek Python per catatan). Sebagian besar byte per catatan terbuang untuk kepala objek dan penunjuk. Itulah alasan pustaka seperti NumPy, pandas, dan Polars cepat dan hemat: data disusun sebagai kolom angka mentah, bukan jutaan objek. Di Bab 66 kita mengambil langkah berikutnya: menjalankan perhitungan pada kolom itu dengan numba, CuPy, dan kode native.
Latihan
- Ubah
03_hitung_referensi.py: tambahkan objek ketiga yang juga memegangp(misalnya tuple). Berapa selisih hitungan? Buktikan. - Buat siklus dari tiga simpul (a menunjuk b, b menunjuk c, c menunjuk a). Buktikan dengan
weakrefbahwa ketiganya baru hilang setelahgc.collect(). Lalu ganti satu penunjuk menjadiweakrefdan buktikan siklusnya hilang tanpagc.collect(). - Dengan
dis.dis, bandingkan bytecode[x * 2 for x in daftar]dan versiforbiasa. Instruksi apa yang berbeda? - Tantangan: tambahkan ke proyek 11 satu bentuk lagi:
array.array("d")(dua larik) dannumpy.dtypeterstruktur. Mana yang paling hemat, dan mana yang paling mudah dipakai?
Ringkasan Bab
- CPython menyimpan semuanya sebagai objek berkepala; nama hanyalah label. Bilangan kecil dan string internan dipakai bersama; bandingkan dengan
==, bukanis. - Penghitung referensi membuang objek seketika saat hitungan nol;
gcmenyapu siklus;weakrefmenunjuk tanpa menahan. - Kode menjadi bytecode; interpreter adaptif mengganti instruksi dengan versi khusus tipe (
dis(adaptive=True)). Bytecode bukan antarmuka stabil. - GIL: satu thread menjalankan bytecode sekali waktu. Thread membantu pekerjaan menunggu, bukan menghitung.
- Python 3.14: build free-threaded didukung resmi tetapi opsional; JIT eksperimental dan mati secara bawaan; subinterpreter punya GIL sendiri-sendiri.
- Struktur data berkolom (NumPy) jauh lebih hemat daripada jutaan objek kecil.
Selanjutnya, di Bab 66: kita mempercepat bagian kritis dengan numba, Cython, C, dan GPU (CuPy dan numba-CUDA), serta jujur soal apa yang tidak bisa diuji di komputer ini.