%%{init: {"flowchart": {"diagramPadding": 40}}}%%
flowchart LR
A[Citra multi-pita<br/>GeoTIFF] --> B[Hitung indeks<br/>NDVI dll]
B --> C[Susun matriks<br/>piksel x fitur]
D[Poligon latih<br/>dari lapangan] --> E[Latih<br/>random forest]
C --> E
E --> F[Prediksi seluruh<br/>piksel]
F --> G[GeoTIFF kelas<br/>luas per kelas]
Bab 59 — ML untuk Kehutanan, Pertanian, Perikanan, Peternakan, dan Sumber Daya Alam
Seri A3 — Machine Learning untuk Sumber Daya Alam
Semua skrip bab ini ada di folder kode/bab59/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Bab ini adalah titik temu semua yang Anda pelajari di Seri A3: model pohon (Bab 54), GPU dan jaringan saraf (Bab 55), deteksi objek (Bab 56), optimisasi (Bab 57), dan penjelasan model (Bab 58), sekarang dipakai pada pekerjaan lapangan. Bayangkan satu peta besar sebuah kabupaten: ada hutan di hulu, sawah di tengah, tambak di pesisir, padang ternak di perbukitan. Satu perangkat (Python) dapat melayani semuanya.
CatatanINGAT
Semua data di bab ini tiruan buatan skrip, dan semua persamaan hasil panen, pertumbuhan, dan bobot adalah contoh untuk belajar, bukan anjuran budidaya. Di buku ini ada tiga macam isi: yang dijalankan (ada keluarannya), yang tinjauan (penjelasan tanpa kode), dan yang tidak dijalankan (ada kodenya tetapi dinyatakan terus terang mengapa tidak dijalankan).
Kehutanan: dari titik LiDAR ke pohon
LiDAR (Light Detection and Ranging) menembakkan pulsa laser dari pesawat atau drone dan mencatat waktu pantulnya. Hasilnya awan titik (point cloud): jutaan titik (x, y, z). Sebagian titik memantul dari tajuk, sebagian menembus celah dan memantul dari tanah. Dari titik-titik itu kita membuat tiga raster:
- DSM (Digital Surface Model): ketinggian permukaan teratas (puncak tajuk atau tanah di tempat kosong).
- DTM (Digital Terrain Model): ketinggian tanah telanjang.
- CHM (Canopy Height Model) = DSM dikurangi DTM: tinggi pohon di atas tanah.
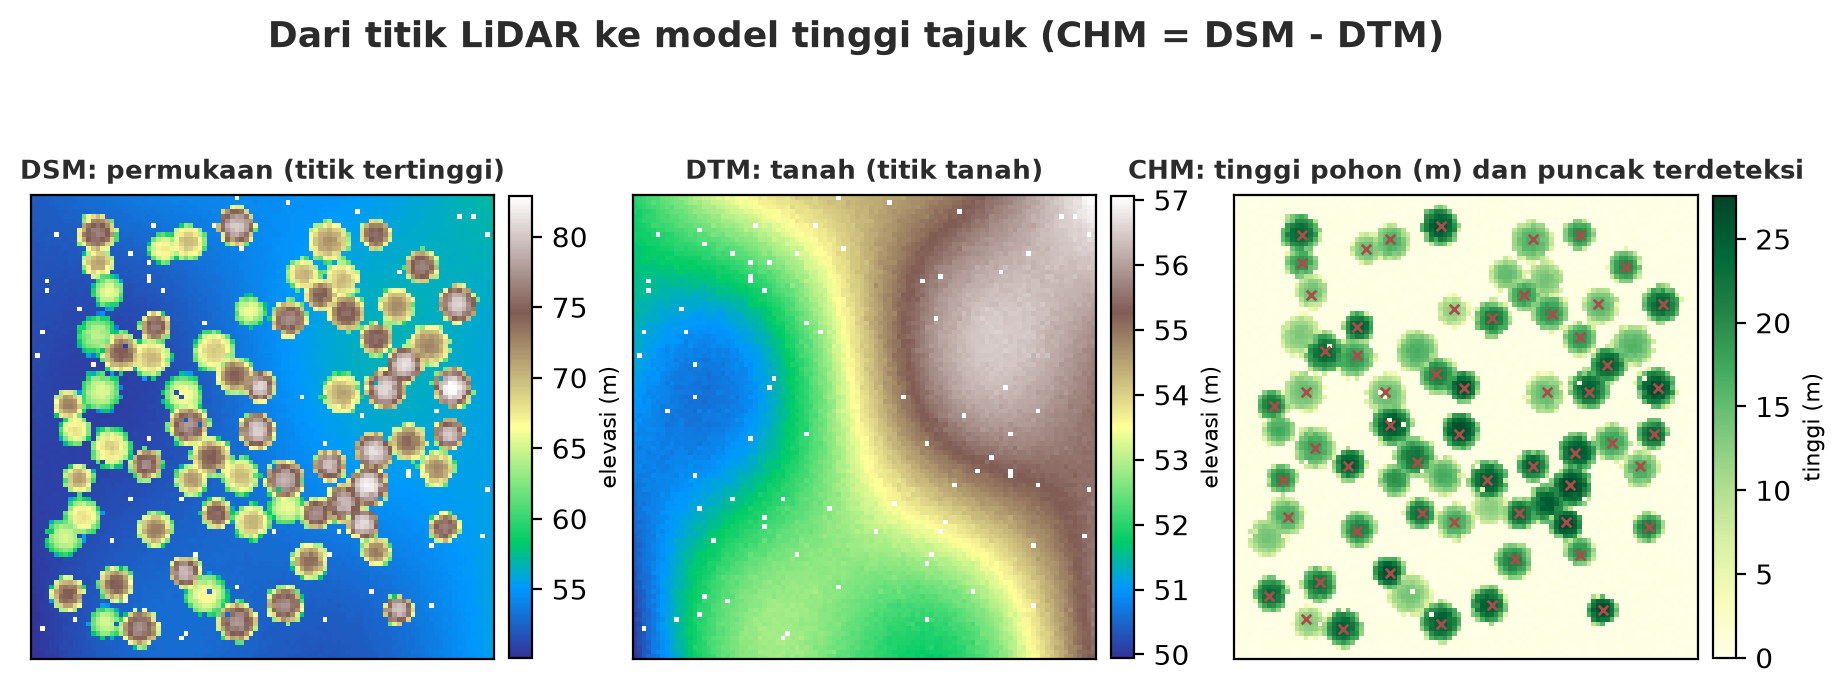
Skrip membuat awan titik tiruan 1 hektare (tanah berlereng, 70 pohon berbentuk kubah, kelas titik mengikuti standar LAS: 2 = tanah, 5 = vegetasi tinggi), menulisnya ke berkas LAS dengan laspy, membacanya kembali, lalu mengolahnya. Pohon dihitung dengan mencari puncak lokal pada CHM.
01_lidar_chm.py
# Bab 59 - LiDAR tiruan -> berkas LAS -> model tinggi tajuk (CHM) -> hitung pohon
from pathlib import Path

import laspy
import numpy as np

from alat_alam import buat_lidar, hitung_chm, puncak_pohon

x, y, z, kelas, pohon = buat_lidar()
print("Titik total:", len(x), "| titik tanah:", int((kelas == 2).sum()), "| titik tajuk:", int((kelas == 5).sum()))

# Tulis ke format LAS (standar awan titik), baca kembali: memastikan alur berkas benar
folder = Path(__file__).parent / "_tmp"
folder.mkdir(exist_ok=True)
las = laspy.create(point_format=1, file_version="1.4")
las.header.scales = [0.001, 0.001, 0.001]
las.x, las.y, las.z = x, y, z
las.classification = kelas.astype(np.uint8)
las.write(folder / "lidar_tiruan.las")
dibaca = laspy.read(folder / "lidar_tiruan.las")
print("LAS dibaca ulang: jumlah titik =", len(dibaca.points), "| kelas unik =", sorted(set(np.array(dibaca.classification).tolist())))

chm = hitung_chm(np.array(dibaca.x), np.array(dibaca.y), np.array(dibaca.z), np.array(dibaca.classification))
print("\nCHM:", chm.shape, "sel 1 m | tinggi maksimum =", round(float(chm.max()), 1), "m")

baris, kolom, tinggi = puncak_pohon(chm)
print("Pohon sebenarnya:", len(pohon), "| puncak terdeteksi:", len(baris))

# Cocokkan puncak terdeteksi dengan pohon sebenarnya (jarak <= 2 m)
cocok, selisih = 0, []
for cx, cy, h, r in pohon:
    jarak = np.hypot(kolom + 0.5 - cx, baris + 0.5 - cy)
    j = jarak.argmin()
    if jarak[j] <= 2.0:
        cocok += 1
        selisih.append(tinggi[j] - h)
print("Pohon yang ditemukan (jarak <= 2 m):", cocok, "dari", len(pohon))
print("Selisih tinggi CHM - sebenarnya: rata-rata", round(float(np.mean(selisih)), 2), "m, simpangan baku", round(float(np.std(selisih)), 2), "m")
print("Tinggi rata-rata pohon terdeteksi:", round(float(tinggi.mean()), 1), "m")
Titik total: 67500 | titik tanah: 50000 | titik tajuk: 17500
LAS dibaca ulang: jumlah titik = 67500 | kelas unik = [2, 5]
CHM: (100, 100) sel 1 m | tinggi maksimum = 27.5 m
Pohon sebenarnya: 70 | puncak terdeteksi: 57
Pohon yang ditemukan (jarak <= 2 m): 57 dari 70
Selisih tinggi CHM - sebenarnya: rata-rata 0.1 m, simpangan baku 0.12 m
Tinggi rata-rata pohon terdeteksi: 21.6 m- Ada 67.500 titik; 50.000 tanah dan 17.500 tajuk. LAS dibaca ulang utuh: jumlah titik dan kelas sama.
- Dari 70 pohon sebenarnya, 57 puncak ditemukan (semuanya cocok dengan pohon asli dalam jarak 2 m). Tiga belas pohon tidak ditemukan; kemungkinan besar pohon yang lebih pendek dan berhimpit dengan tetangga yang lebih tinggi “tersembunyi” di bawah tajuk tetangganya (penyebab pastinya tidak diperiksa satu per satu). Ini keterbatasan nyata pendekatan CHM: pohon tertekan sulit terlihat dari atas.
- Tinggi pohon yang ditemukan akurat: selisih rata-rata 0,1 m (simpangan baku 0,12 m). Karena data tiruan bebas derau besar, galat di lapangan akan lebih besar.
- Tinggi rata-rata pohon terdeteksi 21,6 m.
Di Bab 51 Anda membahas laspy/PDAL lebih dalam; untuk awan titik sungguhan berukuran miliaran titik, pemrosesan dilakukan per ubin dan dengan alat khusus.
Biomassa dan karbon dari tinggi pohon
Pemerintah dan pasar karbon ingin tahu berapa biomassa atas tanah (above-ground biomass, AGB) dan karbon yang tersimpan. Pendekatan umum: hitung biomassa tiap pohon dengan persamaan alometrik (persamaan yang menghubungkan ukuran pohon yang mudah diukur dengan biomassa), lalu jumlahkan.
Kami memakai persamaan pantropis dari Chave dkk. (2014), Global Change Biology 20: 3177-3190, “Improved allometric models to estimate the aboveground biomass of tropical trees”:
AGB = 0,0673 x (kerapatan_kayu x D² x H) ^ 0,976
dengan D diameter setinggi dada dalam cm, H tinggi total dalam m, kerapatan kayu dalam g/cm³. Sumber verifikasi: bentuk dan koefisien persamaan ini dibaca dari dokumentasi paket R BIOMASS (Persamaan 4; search.r-project.org/CRAN/refmans/BIOMASS/html/computeAGB.html, dibaca 2026-10-10). Makalah aslinya tidak bisa dibuka dari sini (halaman penerbit menolak akses otomatis), jadi verifikasi memakai sumber sekunder. Dokumentasi BIOMASS menyebut keluaran dalam Mg (ton); pemeriksaan kewajaran kami menunjukkan rumus mentahnya menghasilkan kilogram (pohon 30 cm dan 20 m menghasilkan 582 kg, wajar untuk pohon sebesar itu), sehingga kode memakai kilogram dan hasilnya dibagi 1.000 untuk ton. Hubungan tinggi-diameter (D = 1,6 x H^1,05), kerapatan kayu 0,6, dan fraksi karbon 0,47 di skrip adalah nilai contoh (0,47 dikenal luas sebagai nilai bawaan IPCC untuk biomassa kering, tetapi hasil pencarian kami hari ini tidak berhasil mengonfirmasinya; periksa pedoman IPCC dan pedoman nasional yang berlaku).
02_biomassa_karbon.py
# Bab 59 - Biomassa dan karbon dari CHM: tinggi -> diameter (CONTOH) -> persamaan Chave 2014 -> karbon
import numpy as np

from alat_alam import agb_chave_kg, buat_lidar, hitung_chm, puncak_pohon

# Pemeriksaan kewajaran persamaan: pohon 30 cm dan 20 m dengan kerapatan kayu 0,6 g/cm3 (nilai contoh)
print("Pohon D = 30 cm, H = 20 m  ->  AGB =", round(float(agb_chave_kg(30, 20, 0.6))), "kg per pohon")

x, y, z, kelas, pohon = buat_lidar()
chm = hitung_chm(x, y, z, kelas)
_, _, tinggi = puncak_pohon(chm)


def diameter_dari_tinggi(h):
    """HUBUNGAN CONTOH (bukan hasil penelitian): D = 1,6 x H^1,05 cm. Di lapangan, ukur D dan H lalu cocokkan sendiri."""
    return 1.6 * h ** 1.05


diameter = diameter_dari_tinggi(tinggi)
agb = agb_chave_kg(diameter, tinggi, kerapatan_kayu=0.6)
FRAKSI_KARBON = 0.47                                   # nilai umum untuk biomassa kering (periksa pedoman lokal)
karbon = agb * FRAKSI_KARBON
co2e = karbon * 44 / 12                                # massa molekul CO2 (44) dibanding C (12)
print(f"\nPohon terdeteksi: {len(tinggi)} pada 1 ha")
print(f"Biomassa atas tanah : {agb.sum() / 1000:7.1f} ton/ha")
print(f"Karbon              : {karbon.sum() / 1000:7.1f} tC/ha")
print(f"Setara CO2          : {co2e.sum() / 1000:7.1f} tCO2e/ha")

# Seberapa peka hasil terhadap galat tinggi? Persamaan ~ (H)^0,976 dan D juga bergantung H, jadi galat 10% pada H berdampak lebih besar
for galat in (-0.1, 0.1):
    h2 = tinggi * (1 + galat)
    a2 = agb_chave_kg(diameter_dari_tinggi(h2), h2, 0.6).sum() / 1000
    print(f"Galat tinggi {galat:+.0%}: biomassa {a2:7.1f} ton/ha ({a2 / (agb.sum() / 1000) - 1:+.0%})")
Pohon D = 30 cm, H = 20 m -> AGB = 582 kg per pohon
Pohon terdeteksi: 58 pada 1 ha
Biomassa atas tanah : 71.6 ton/ha
Karbon : 33.7 tC/ha
Setara CO2 : 123.4 tCO2e/ha
Galat tinggi -10%: biomassa 52.1 ton/ha (-27%)
Galat tinggi +10%: biomassa 95.6 ton/ha (+33%)- Pada hektare tiruan ini: biomassa 71,6 ton/ha, karbon 33,7 tC/ha (biomassa x 0,47), setara 123,4 tCO2e/ha (karbon dikali 44/12, perbandingan massa molekul CO2 dan C).
- Jumlah pohon 58 di sini, sedikit berbeda dari 57 pada skrip sebelumnya, karena skrip 01 memakai koordinat yang sudah dibulatkan ke milimeter lewat berkas LAS dan skrip ini memakai angka asli: satu puncak yang tingginya berimbang berpindah pilihan. Perbedaan kecil seperti ini wajar dan perlu diketahui.
- Kepekaan: galat tinggi hanya ±10% mengubah biomassa -27% sampai +33%, karena tinggi masuk dua kali (langsung, dan lewat diameter turunannya). Inilah mengapa laporan karbon harus menyertakan ketidakpastian dan mengukur diameter di lapangan sebagai pembanding.
PeringatanAWAS
Jangan memakai angka di atas untuk klaim karbon. Persamaan alometrik yang benar bergantung pada jenis hutan dan wilayah; peneliti menganjurkan membuat hubungan tinggi-diameter lokal bila mungkin. Perhitungan karbon resmi mengikuti standar dan pedoman yang berlaku (dan verifikasi pihak ketiga).
Deteksi tajuk dari foto udara: YOLO dan DetecTree
Bila Anda hanya punya foto RGB (tanpa LiDAR), Bab 56 sudah menunjukkan jalannya: latih YOLO dengan kotak tajuk dan terapkan dengan ubin. Alternatif yang dibuat khusus untuk pohon adalah pustaka DetecTree, yang mengklasifikasikan piksel citra udara menjadi pohon dan bukan pohon. Berdasarkan README dan dokumentasinya (dibaca 2026-10-10): Classifier() tanpa argumen memakai model pra-latih yang diunduh dari Hugging Face Hub; ClassifierTrainer melatih sendiri dari pasangan citra dan citra jawaban; pustaka berlisensi GPL-3.0.
09_detectree_catatan.py
# Bab 59 - DetecTree (deteksi pohon dari citra udara RGB): kode contoh dari README resmi
import detectree as dtr

# 1) Memakai model pra-latih bawaan (diunduh otomatis saat Classifier() dibuat tanpa argumen clf)
y_pred = dtr.Classifier().predict_img("ubin_ortofoto.tif")          # mengembalikan larik piksel pohon / bukan pohon

# 2) Melatih sendiri dari pasangan citra dan citra jawaban (piksel pohon bernilai 255, lainnya 0)
latih = dtr.TrainingSelector(img_dir="citra_latih")                  # memilih ubin latih/uji yang mewakili
pemisah = latih.train_test_split(method="cluster-II")
klasifikator = dtr.ClassifierTrainer().train_classifier(split_df=pemisah, response_img_dir="jawaban_latih")
y_pred = dtr.Classifier(clf=klasifikator).classify_img("ubin_ortofoto.tif")
Kode ini tidak dijalankan saat buku dibuat karena DetecTree belum bisa dipasang di Python 3.14 milik buku ini (dependensinya pymaxflow tidak punya paket jadi untuk 3.14; pip gagal menyelesaikan dependensi) dan model bawaannya diunduh dari internet, jadi keluarannya tidak ditampilkan. Kode di atas belum diuji, disalin dari README. Perhatikan README sendiri memakai dua nama metode berbeda (predict_img untuk model bawaan dan classify_img untuk model sendiri); periksa versi yang Anda pasang. Dokumentasi tentang classify_img tidak kami temukan di halaman dokumentasi resmi.
Deforestasi dan kebakaran: perubahan antar-waktu
Cara paling sederhana mendeteksi hilangnya hutan: bandingkan indeks vegetasi dua tanggal. Bila NDVI satu piksel turun jauh, kemungkinan tutupan hilang. Langkah berikutnya mengelompokkan piksel yang berdekatan menjadi bercak dan menghitung luasnya. Untuk bekas kebakaran, indeks yang dipakai biasanya berbasis pita inframerah gelombang pendek (misalnya NBR), tetapi skrip ini hanya memakai NDVI; indeks lain dan ambang bakunya tidak dijalankan di buku ini.
04_deforestasi.py
# Bab 59 - Deteksi perubahan tutupan hutan: selisih NDVI dua tanggal, lalu cari bercak dan hitung luasnya (hektare)
import numpy as np
from scipy import ndimage

rng = np.random.default_rng(11)
n = 200                                                  # raster 200 x 200 piksel, 1 piksel = 10 m (seperti resolusi Sentinel-2), jadi 4 x 4 km
piksel_ha = 10 * 10 / 10_000                             # 0,01 ha per piksel

ndvi_t1 = np.clip(rng.normal(0.80, 0.04, (n, n)), 0, 1)  # tahun 1: hutan padat
ndvi_t2 = ndvi_t1 + rng.normal(0, 0.10, (n, n))          # tahun 2: sama + derau yang cukup besar (awan tipis, bayangan)
benar = np.zeros((n, n), bool)
for (r, k, tinggi, lebar) in [(30, 40, 20, 25), (100, 120, 35, 30), (160, 50, 12, 15)]:    # 3 petak pembukaan lahan
    ndvi_t2[r:r + tinggi, k:k + lebar] -= 0.45
    benar[r:r + tinggi, k:k + lebar] = True

selisih = ndvi_t2 - ndvi_t1
hilang = selisih < -0.25                                 # ambang selisih NDVI (contoh; di lapangan dikalibrasi dengan data acuan)
bersih = ndimage.binary_opening(hilang, structure=np.ones((3, 3)))              # buang bintik derau kecil
label, jumlah = ndimage.label(bersih)
luas = ndimage.sum(bersih, label, index=range(1, jumlah + 1)) * piksel_ha
print("Piksel dengan penurunan NDVI > 0,25 (mentah):", int(hilang.sum()))
print("Setelah membuang bintik kecil :", int(bersih.sum()))
print("Jumlah bercak pembukaan lahan :", jumlah)
for i, l in enumerate(sorted(luas, reverse=True), 1):
    print(f"  bercak {i}: {l:.1f} ha")
print("Luas sebenarnya (kunci):", round(benar.sum() * piksel_ha, 1), "ha | terdeteksi:", round(bersih.sum() * piksel_ha, 1), "ha")
presisi = (bersih & benar).sum() / bersih.sum()
recall = (bersih & benar).sum() / benar.sum()
print(f"Presisi = {presisi:.2f}   recall = {recall:.2f}")
Piksel dengan penurunan NDVI > 0,25 (mentah): 1916
Setelah membuang bintik kecil : 1667
Jumlah bercak pembukaan lahan : 3
bercak 1: 10.1 ha
bercak 2: 4.9 ha
bercak 3: 1.7 ha
Luas sebenarnya (kunci): 17.3 ha | terdeteksi: 16.7 ha
Presisi = 1.00 recall = 0.96Raster 200 x 200 piksel (1 piksel = 10 m, seperti resolusi pita utama Sentinel-2: B2, B3, B4, dan B8 beresolusi 10 m menurut SentiWiki, dibaca 2026-10-10). Tiga petak pembukaan lahan seluas 17,3 ha disisipkan. Derau besar (sd 0,10, anggap awan tipis dan bayangan) menghasilkan 1.916 piksel yang tampak “turun”. Pembukaan morfologi (binary_opening) membuang bintik kecil sehingga tersisa 1.667. Ditemukan 3 bercak (10,1; 4,9; 1,7 ha) dengan luas total 16,7 ha, presisi 1,00 dan recall 0,96. Di data sungguhan, awan adalah musuh utama: citra berawan harus disaring dulu (pita masker awan).
Pertanian: NDVI dan prediksi hasil panen
NDVI = (NIR - Merah) / (NIR + Merah). Tumbuhan sehat memantulkan banyak inframerah dekat (NIR) dan menyerap merah, sehingga NDVI tinggi (mendekati 0,8). Tanah kosong sedang, air negatif.
03_ndvi_panen.py
# Bab 59 - NDVI dari pita citra, lalu prediksi hasil panen padi dari deret waktu NDVI (data tiruan, angka contoh)
import numpy as np
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import GroupKFold, cross_val_score

rng = np.random.default_rng(3)


def ndvi(nir, merah):
    return (nir - merah) / (nir + merah)               # indeks vegetasi: -1..1, makin hijau makin tinggi


# Satu piksel: tanah (pantulan merah tinggi, NIR rendah) vs vegetasi sehat (merah rendah, NIR tinggi)
print("NDVI tanah  :", round(float(ndvi(0.25, 0.20)), 2))
print("NDVI sehat  :", round(float(ndvi(0.50, 0.05)), 2))
print("NDVI air    :", round(float(ndvi(0.02, 0.04)), 2))

# 4 blok sawah x 40 petak; 8 tanggal sepanjang musim (hari ke 10, 25, ..., 115)
hari = np.arange(10, 120, 15)
baris = []
for blok in range(4):
    for _ in range(40):
        puncak = rng.uniform(0.55, 0.88)                              # kehijauan puncak petak ini
        hujan = rng.normal(900, 120) + blok * 40                      # curah hujan musim (mm), tiap blok sedikit beda
        kurva = 0.2 + (puncak - 0.2) * np.exp(-((hari - 70) / 28) ** 2) + rng.normal(0, 0.02, len(hari))
        panen = 2500 + 6200 * (puncak - 0.5) + 2.2 * (hujan - 900) + rng.normal(0, 250)          # kg/ha (contoh)
        baris.append((blok, kurva, hujan, panen))
blok = np.array([b[0] for b in baris])
deret = np.stack([b[1] for b in baris])
hujan = np.array([b[2] for b in baris])
panen = np.array([b[3] for b in baris])

fitur = np.column_stack([deret.max(axis=1), deret.sum(axis=1), hujan])        # NDVI puncak, "luas di bawah kurva", hujan
print("\nPetak:", len(panen), "| fitur: NDVI puncak, jumlah NDVI sepanjang musim, curah hujan")
for nama, model in [("Regresi linear", LinearRegression()),
                    ("Random forest ", RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=1))]:
    r2 = cross_val_score(model, fitur, panen, groups=blok, cv=GroupKFold(n_splits=4), scoring="r2")
    print(f"{nama}: R2 validasi per blok = {r2.mean():.2f}")
print("Prediksi dini: pakai hanya 5 tanggal pertama (sampai hari 70):")
dini = np.column_stack([deret[:, :5].max(axis=1), deret[:, :5].sum(axis=1), hujan])
r2 = cross_val_score(LinearRegression(), dini, panen, groups=blok, cv=GroupKFold(n_splits=4), scoring="r2")
print(f"Regresi linear dini: R2 validasi per blok = {r2.mean():.2f}")
NDVI tanah : 0.11
NDVI sehat : 0.82
NDVI air : -0.33
Petak: 160 | fitur: NDVI puncak, jumlah NDVI sepanjang musim, curah hujan
Regresi linear: R2 validasi per blok = 0.83
Random forest : R2 validasi per blok = 0.76
Prediksi dini: pakai hanya 5 tanggal pertama (sampai hari 70):
Regresi linear dini: R2 validasi per blok = 0.83- NDVI tanah 0,11, tanaman sehat 0,82, air -0,33.
- 160 petak (4 blok x 40) punya deret NDVI 8 tanggal (hari 10 sampai 115) dan curah hujan musim. Fitur: NDVI puncak, jumlah NDVI sepanjang musim (pendekatan luas di bawah kurva), dan curah hujan.
- Regresi linear mencapai R² 0,83 pada validasi per blok (Bab 54), lebih baik daripada random forest (0,76). Itu bukan kebetulan: kita membuat panen linear terhadap fiturnya, dan model sederhana yang cocok dengan sifat data sering mengalahkan model rumit. Pelajaran: coba model sederhana dulu.
- Prediksi dini dengan hanya 5 tanggal pertama (sampai hari 70, masa puncak) menghasilkan R² yang sama (0,83): bukti bahwa informasi terpenting sudah ada sebelum musim selesai, hal yang berguna untuk peringatan dini kegagalan panen.
Deteksi penyakit tanaman: pendekatan yang Anda pelajari di Bab 55 (CNN pada citra daun, di GPU) adalah bentuk dasarnya. Model sungguhan dilatih dengan ribuan foto berlabel dari kebun; kami tidak menjalankan model penyakit daun nyata di buku ini karena data dan bobot yang relevan harus diunduh dan diverifikasi lisensinya. Pertanian presisi (aplikasi pupuk dan air per zona) dan pemetaan tanah digital (memprediksi sifat tanah dari kovariat seperti elevasi dan indeks citra, dengan model seperti random forest dan validasi spasial dari Bab 54) memakai alat yang sama; keduanya tinjauan di sini.
Dari citra satelit ke peta tutupan lahan
Inilah alur utama banyak proyek sumber daya alam:
Skrip membuat citra 4 pita tiruan (biru, hijau, merah, NIR) yang meniru pita B2, B3, B4, B8 Sentinel-2, menulisnya sebagai GeoTIFF dengan rasterio (lengkap dengan CRS dan ukuran piksel 10 m), melatih random forest dari 150 piksel per kelas, memprediksi seluruh raster, menulis hasilnya sebagai GeoTIFF baru, dan menghitung luas per kelas.
05_peta_tutupan_raster.py
# Bab 59 - Dari citra satelit tiruan sampai peta hasil: GeoTIFF 4 pita -> random forest -> GeoTIFF kelas
from pathlib import Path

import numpy as np
import rasterio
from rasterio.transform import from_origin
from sklearn.ensemble import RandomForestClassifier

rng = np.random.default_rng(5)
n = 120                                                      # 120 x 120 piksel, 10 m => 1,44 x 1,44 km
NAMA = ["air", "hutan", "sawah", "permukiman"]
# Pantulan rata-rata tiap kelas pada 4 pita [biru, hijau, merah, NIR] (angka contoh, mirip pita B2, B3, B4, B8 Sentinel-2)
RATA = np.array([[0.06, 0.05, 0.04, 0.02],
                 [0.03, 0.06, 0.03, 0.40],
                 [0.05, 0.09, 0.06, 0.30],
                 [0.14, 0.16, 0.18, 0.22]])

# Peta kelas sebenarnya: sungai diagonal, hutan di barat laut, sawah di selatan, permukiman di timur laut
yy, xx = np.mgrid[0:n, 0:n]
peta = np.full((n, n), 2)                                    # dasar: sawah
peta[(yy < 60) & (xx < 70)] = 1                              # hutan
peta[(yy < 50) & (xx > 85)] = 3                              # permukiman
peta[np.abs(yy - xx * 0.8 - 20) < 3] = 0                     # sungai
citra = RATA[peta] + rng.normal(0, 0.025, (n, n, 4))

folder = Path(__file__).parent / "_tmp"
folder.mkdir(exist_ok=True)
transform = from_origin(500_000, 9_300_000, 10, 10)          # sudut kiri atas (UTM fiktif), piksel 10 m
profil = dict(driver="GTiff", height=n, width=n, count=4, dtype="float32", crs="EPSG:32748", transform=transform)
with rasterio.open(folder / "citra_tiruan.tif", "w", **profil) as dst:
    dst.write(np.moveaxis(citra, 2, 0).astype("float32"))

with rasterio.open(folder / "citra_tiruan.tif") as src:      # pembacaan ulang: pita x tinggi x lebar
    data = src.read()
    meta = src.meta.copy()
    print("Citra:", src.count, "pita,", src.width, "x", src.height, "piksel | CRS:", src.crs, "| ukuran piksel:", src.res[0], "m")
bentuk = data.shape
nir, merah = data[3], data[2]
ndvi = (nir - merah) / (nir + merah)                         # indeks sebagai fitur tambahan
X = np.concatenate([data.reshape(4, -1).T, ndvi.reshape(-1, 1)], axis=1)

# Contoh latih: 150 piksel per kelas, diambil dari "poligon latih" (di sini acak dari peta kunci)
idx_latih = np.concatenate([rng.choice(np.where(peta.ravel() == k)[0], 150, replace=False) for k in range(4)])
model = RandomForestClassifier(n_estimators=100, random_state=42, n_jobs=1).fit(X[idx_latih], peta.ravel()[idx_latih])
prediksi = model.predict(X).reshape(n, n)

akurasi = (prediksi == peta).mean()
print("Akurasi seluruh peta (terhadap kunci):", round(float(akurasi), 3))
meta.update(count=1, dtype="uint8")
with rasterio.open(folder / "peta_kelas.tif", "w", **meta) as dst:
    dst.write(prediksi.astype("uint8"), 1)
with rasterio.open(folder / "peta_kelas.tif") as src:
    kelas = src.read(1)
    piksel_ha = src.res[0] * src.res[1] / 10_000
print("Peta hasil ditulis dan dibaca ulang; bentuk:", kelas.shape)
print("\nLuas per kelas (ha): prediksi | kunci")
for k, nama in enumerate(NAMA):
    print(f"  {nama:11s} {(kelas == k).sum() * piksel_ha:7.1f} | {(peta == k).sum() * piksel_ha:7.1f}")
Citra: 4 pita, 120 x 120 piksel | CRS: EPSG:32748 | ukuran piksel: 10.0 m
Akurasi seluruh peta (terhadap kunci): 0.985
Peta hasil ditulis dan dibaca ulang; bentuk: (120, 120)
Luas per kelas (ha): prediksi | kunci
air 7.0 | 7.0
hutan 39.4 | 39.1
sawah 80.5 | 80.9
permukiman 17.1 | 17.0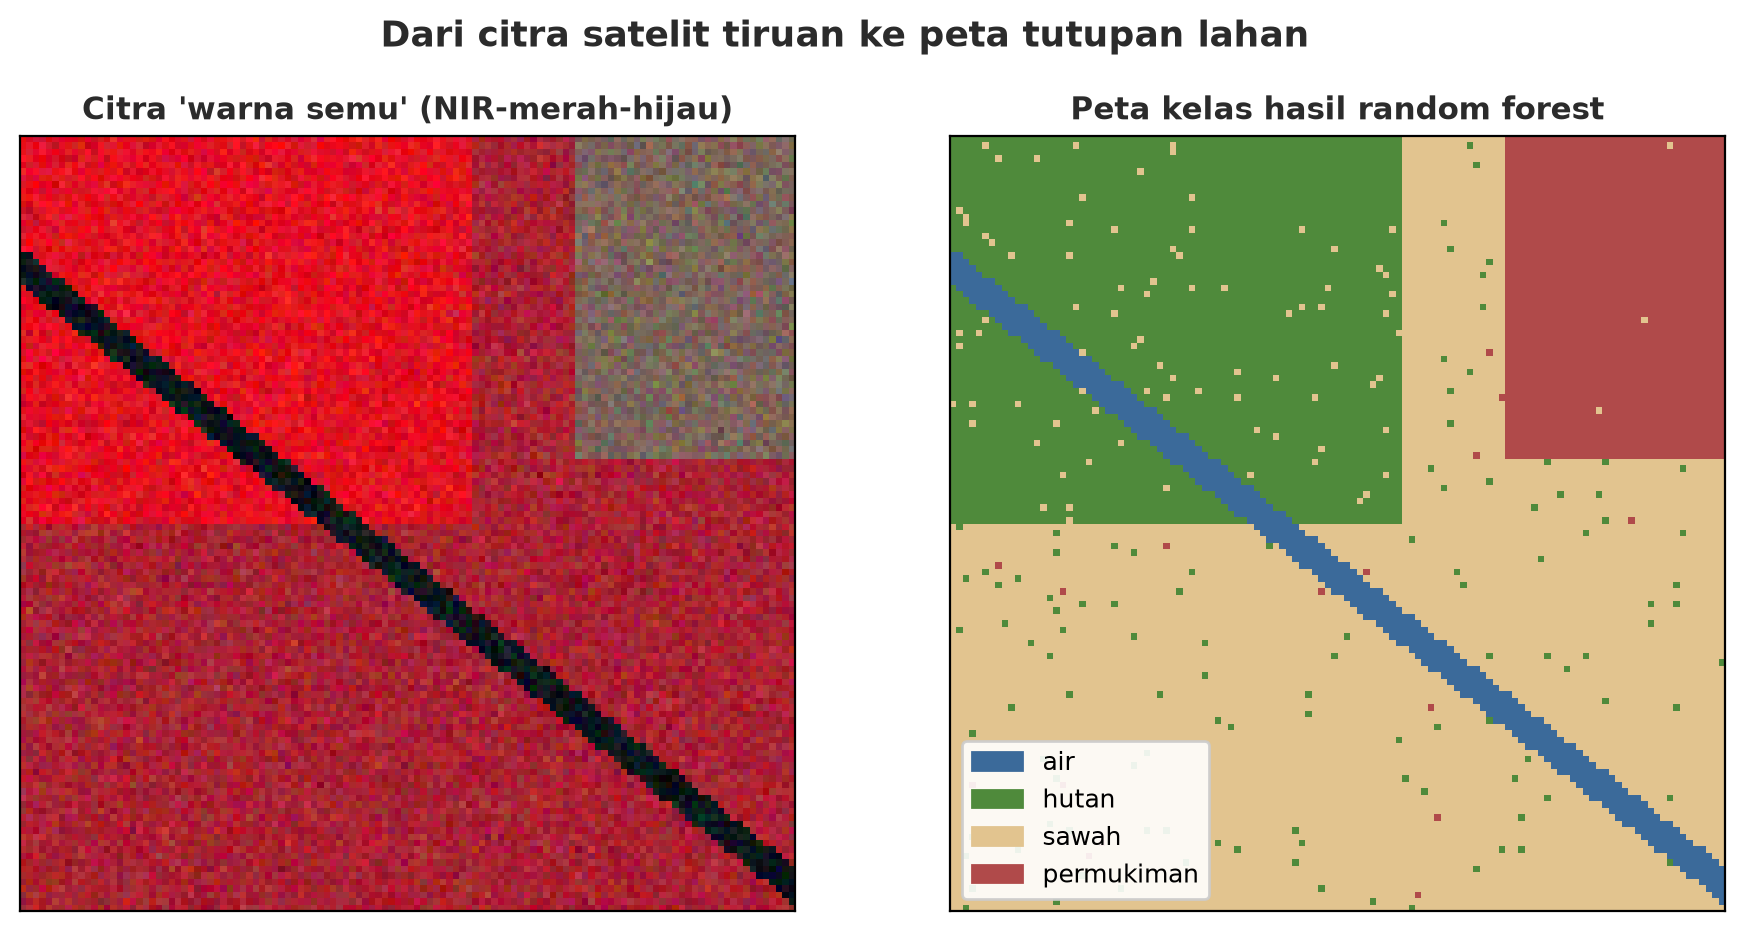
Akurasi 0,985 terhadap peta kunci dan luas tiap kelas hampir sama dengan kunci (hutan 39,4 vs 39,1 ha). Titik-titik kecil salah di peta (efek “garam dan merica”) adalah ciri klasifikasi per piksel; di praktik, hasilnya sering dihaluskan dengan filter mayoritas atau segmentasi objek. Angka setinggi itu karena kelas tiruan sangat terpisah; citra sungguhan jauh lebih sulit.
TipTIPS
Untuk data yang tak muat di memori, gabungkan alur ini dengan xarray dan Dask (Bab 51 dan 53). Untuk mengambil citra Sentinel-2 langsung dari katalog STAC, lihat Bab 51.
Google Earth Engine (lewat paket geemap) menyediakan arsip satelit dan komputasi di cloud. Dokumentasi geemap (dibaca 2026-10-10) menyatakan Earth Engine tidak bisa dipakai sebelum pendaftaran akun disetujui. Karena itu kami tidak menjalankan Earth Engine di buku ini (butuh akun milik Anda; kami tidak membuat akun).
Perikanan
Kualitas air dan peringatan dini. Ikan di kolam padat bisa mati dalam beberapa jam bila oksigen terlarut (DO) jatuh. Skrip memakai pola harian DO (turun pada malam hari) dan dua kejadian: aerator mati, dan pakan berlebih. Peringatan dini membandingkan DO dengan pola normal jam yang sama.
07_kolam_ikan.py
# Bab 59 - Kolam ikan: peringatan dini oksigen terlarut, dan kurva pertumbuhan (data tiruan, angka contoh)
import numpy as np
from scipy.optimize import curve_fit

rng = np.random.default_rng(8)

# 1) Sensor oksigen terlarut (DO) tiap jam selama 10 hari; kolam tiruan punya pola harian + dua kejadian "kekurangan oksigen"
jam = np.arange(240)
do = 6.0 + 1.2 * np.sin((jam % 24 - 9) / 24 * 2 * np.pi) + rng.normal(0, 0.15, len(jam))      # mg/L: turun saat malam
do[130:160] -= np.concatenate([np.linspace(0, 3.2, 10), np.full(14, 3.2), np.linspace(3.2, 0, 6)])   # kejadian 1: aerator mati
do[200:212] -= np.concatenate([np.linspace(0, 2.4, 6), np.full(2, 2.4), np.linspace(2.4, 0, 4)])      # kejadian 2: pakan berlebih
BATAS = 4.0                                                  # contoh ambang peringatan (mg/L); ambang nyata bergantung jenis ikan

rendah = do < BATAS
awal_ambang = [int(i) for i in np.where(rendah & ~np.roll(rendah, 1))[0]]
print("Pengukuran:", len(jam), "| jam di bawah ambang", BATAS, "mg/L:", int(rendah.sum()))
print("Ambang terlewati pertama kali pada jam ke:", awal_ambang)

# Peringatan DINI berbasis anomali: bandingkan dengan pola harian "normal" (rata-rata tiap jam pada 5 hari pertama, sebelum kejadian)
normal = do[:120].reshape(5, 24).mean(axis=0)
sisa = do - normal[jam % 24]                                  # selisih terhadap pola normal pada jam yang sama
anomali = sisa < -1.0                                         # turun lebih dari 1 mg/L dari kebiasaan jam itu
awal_dini = [int(i) for i in np.where(anomali & ~np.roll(anomali, 1))[0]]
print("Peringatan dini (anomali < -1,0 mg/L) mulai jam ke:", awal_dini)
for d in awal_dini:
    berikut = [a for a in awal_ambang if a >= d]
    if berikut and berikut[0] - d < 24:
        print(f"  dini jam {d} -> ambang 4,0 terlewati jam {berikut[0]}: ada waktu {berikut[0] - d} jam untuk menyalakan aerator")
    else:
        print(f"  dini jam {d} -> ambang 4,0 TIDAK terlewati (DO terendah {do[d:d + 12].min():.1f} mg/L), tetapi sudah menyimpang dari pola normal")

# 2) Kurva pertumbuhan bobot ikan nila: bobot_awal ke bobot_maks (kurva logistik)
umur = np.arange(0, 181, 15)                                 # hari
bobot_nyata = 800 / (1 + 40 * np.exp(-0.035 * umur)) + rng.normal(0, 8, len(umur))        # gram (contoh)


def logistik(t, maks, k, t0):
    return maks / (1 + np.exp(-k * (t - t0)))


param, _ = curve_fit(logistik, umur, bobot_nyata, p0=[700, 0.03, 100])
print(f"\nKurva logistik terpasang: bobot maksimum = {param[0]:.0f} g, laju = {param[1]:.3f}/hari, titik belok = hari ke-{param[2]:.0f}")
for target in (300, 500):
    hari = param[2] - np.log(param[0] / target - 1) / param[1]
    print(f"  bobot {target} g tercapai pada hari ke-{hari:.0f}")
print("  prediksi hari ke-120 :", round(float(logistik(120, *param))), "g")
Pengukuran: 240 | jam di bawah ambang 4.0 mg/L: 16
Ambang terlewati pertama kali pada jam ke: [139]
Peringatan dini (anomali < -1,0 mg/L) mulai jam ke: [133, 203]
dini jam 133 -> ambang 4,0 terlewati jam 139: ada waktu 6 jam untuk menyalakan aerator
dini jam 203 -> ambang 4,0 TIDAK terlewati (DO terendah 4.4 mg/L), tetapi sudah menyimpang dari pola normal
Kurva logistik terpasang: bobot maksimum = 797 g, laju = 0.035/hari, titik belok = hari ke-105
bobot 300 g tercapai pada hari ke-91
bobot 500 g tercapai pada hari ke-120
prediksi hari ke-120 : 499 g- Ambang tetap 4,0 mg/L baru terlewati pada jam ke-139, saat kolam sudah kritis. Peringatan dini berbasis anomali bunyi pada jam ke-133: 6 jam lebih awal, cukup untuk menyalakan aerator.
- Kejadian kedua (jam ke-203): DO hanya turun sampai 4,4, tidak pernah menembus ambang 4,0, tetapi tetap menyimpang jauh dari pola normal dan ditandai. Ambang tetap akan melewatkan kejadian ini.
- Bagian kedua mencocokkan kurva logistik pada bobot ikan nila tiruan: bobot maksimum 797 g, titik belok hari ke-105; bobot 500 g tercapai pada hari ke-120. Kurva seperti ini dipakai untuk menjadwalkan panen dan pakan; angkanya contoh.
Topik perikanan lain adalah tinjauan di sini: menghitung dan mengukur ikan dari foto atau video (pendekatannya sama dengan deteksi tajuk di Bab 56, dengan kamera bawah air dan tantangan keruh dan ikan bertumpuk), estimasi stok dari data tangkapan, serta citra suhu permukaan laut dan klorofil dari satelit untuk memperkirakan zona tangkapan. Kami tidak menjalankan satu pun dari ketiganya.
Peternakan
Menghitung ternak dari foto udara. Kita memakai YOLO nano seperti di Bab 56, tetapi dengan dataset tiruan sapi (elips berbagai warna di padang rumput, 200 citra latih dan 40 citra validasi), dilatih di GPU.
06_ternak_yolo.py
# Bab 59 - Menghitung ternak dari foto udara tiruan dengan YOLO nano di GPU
import logging
import os
import shutil

import numpy as np
import torch
from ultralytics import YOLO
from ultralytics.utils import LOGGER

from buat_ternak import TMP, buat_citra, buat_dataset

LOGGER.setLevel(logging.ERROR)
data_yaml = buat_dataset()
bobot = TMP / "bobot"
bobot.mkdir(parents=True, exist_ok=True)
os.chdir(bobot)                                              # bobot pra-latih yolo26n.pt (5 MB) diunduh ke sini bila belum ada
model = YOLO("yolo26n.pt")
hasil_dir = TMP / "runs"
shutil.rmtree(hasil_dir, ignore_errors=True)
hasil = model.train(data=str(data_yaml), epochs=25, imgsz=320, batch=16, device=0 if torch.cuda.is_available() else "cpu",
                    workers=0, seed=0, deterministic=True, project=str(hasil_dir), name="sapi", exist_ok=True,
                    plots=False, verbose=False, amp=False)
m = hasil.results_dict
print("Validasi: presisi", round(m["metrics/precision(B)"], 2), "| recall", round(m["metrics/recall(B)"], 2),
      "| mAP50", round(m["metrics/mAP50(B)"], 2), "| mAP50-95", round(m["metrics/mAP50-95(B)"], 2))

# Menghitung: 20 foto baru (benih lain), bandingkan jumlah terdeteksi dengan jumlah sebenarnya
terlatih = YOLO(hasil.save_dir / "weights" / "best.pt")
rng = np.random.default_rng(999)
selisih, benar_total, deteksi_total = [], 0, 0
for _ in range(20):
    citra, kotak = buat_citra(rng)
    r = terlatih.predict(citra, conf=0.25, imgsz=320, device=0 if torch.cuda.is_available() else "cpu", verbose=False)[0]
    selisih.append(len(r.boxes) - len(kotak))
    benar_total += len(kotak)
    deteksi_total += len(r.boxes)
selisih = np.array(selisih)
print(f"\n20 foto baru: sapi sebenarnya = {benar_total}, terdeteksi = {deteksi_total}")
print("Galat mutlak rata-rata per foto:", round(float(np.abs(selisih).mean()), 2), "ekor")
print("Foto dengan jumlah tepat:", int((selisih == 0).sum()), "dari 20")

# Dari jumlah ke kepadatan: bila 1 piksel = 0,1 m, satu foto 320 x 320 piksel = 32 x 32 m = 0,1024 ha
luas_ha = (320 * 0.1) ** 2 / 10_000
print(f"\nContoh kepadatan: {deteksi_total / 20 / luas_ha:.0f} ekor/ha (rata-rata terdeteksi) -- padang tiruan sengaja padat")
Validasi: presisi 1.0 | recall 0.99 | mAP50 0.99 | mAP50-95 0.82
20 foto baru: sapi sebenarnya = 209, terdeteksi = 213
Galat mutlak rata-rata per foto: 0.3 ekor
Foto dengan jumlah tepat: 16 dari 20
Contoh kepadatan: 104 ekor/ha (rata-rata terdeteksi) -- padang tiruan sengaja padat- Validasi: presisi 1,00, recall 0,99, mAP50 0,99, mAP50-95 0,82. mAP50-95 lebih rendah karena sapi kecil (sekitar 20 piksel) membuat kotak yang pas sulit.
- Pada 20 foto baru: sapi sebenarnya 209, terdeteksi 213. Galat mutlak rata-rata 0,3 ekor per foto; 16 dari 20 foto tepat. Untuk menghitung ternak, galat jumlah (bias) lebih penting daripada mAP.
- Kepadatan 104 ekor/ha hanya menunjukkan cara mengubah jumlah menjadi kepadatan (1 piksel = 0,1 m); padang tiruan sengaja dibuat padat.
Bobot dan pertumbuhan. Kurva Gompertz adalah model klasik pertumbuhan hewan. Selain itu, bobot bisa ditaksir dari luas siluet pada foto udara (luas berbanding lurus kuadrat panjang, bobot berbanding kubik panjang, jadi bobot sebanding luas pangkat 1,5).
08_bobot_ternak.py
# Bab 59 - Bobot ternak: kurva pertumbuhan Gompertz, dan menaksir bobot dari luas siluet di foto (data tiruan)
import numpy as np
from scipy.optimize import curve_fit
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_score

rng = np.random.default_rng(4)

# 1) Kurva Gompertz untuk sapi: bobot = A * exp(-B * exp(-k * umur_bulan))
umur = np.arange(0, 37, 3)
bobot = 520 * np.exp(-3.2 * np.exp(-0.11 * umur)) + rng.normal(0, 5, len(umur))             # kg (contoh)


def gompertz(t, A, B, k):
    return A * np.exp(-B * np.exp(-k * t))


param, _ = curve_fit(gompertz, umur, bobot, p0=[500, 3, 0.1])
print(f"Gompertz: bobot dewasa A = {param[0]:.0f} kg, B = {param[1]:.2f}, k = {param[2]:.3f}/bulan")
for u in (12, 24):
    print(f"  umur {u} bulan: {gompertz(u, *param):.0f} kg")
print("  pertambahan harian rata-rata bulan 12-24:", round(float((gompertz(24, *param) - gompertz(12, *param)) / 365 / 1), 2), "kg/hari  (selisih per 12 bulan dibagi 365)")

# 2) Bobot dari citra: luas siluet (piksel) dari foto udara berskala tetap. Model: bobot ~ luas^1,5 (volume ~ panjang^3, luas ~ panjang^2)
n = 80
luas_px = rng.uniform(900, 2200, n)
bobot_nyata = 0.0045 * luas_px ** 1.5 + rng.normal(0, 18, n)                                # kg (contoh)
X = np.log(luas_px).reshape(-1, 1)
y = np.log(bobot_nyata)
model = LinearRegression().fit(X, y)
r2 = cross_val_score(LinearRegression(), X, y, cv=5, scoring="r2").mean()
print(f"\nRegresi log-log bobot ~ luas^b: eksponen b = {model.coef_[0]:.2f} (teori: 1,5) | R2 validasi silang = {r2:.2f}")
baru = np.array([[np.log(1500)]])
print("Taksiran bobot sapi dengan siluet 1.500 piksel:", round(float(np.exp(model.predict(baru))[0])), "kg")
print("Catatan: foto sungguhan butuh koreksi sudut kamera, tinggi terbang, dan timbangan untuk kalibrasi.")
Gompertz: bobot dewasa A = 529 kg, B = 3.12, k = 0.105/bulan
umur 12 bulan: 220 kg
umur 24 bulan: 413 kg
pertambahan harian rata-rata bulan 12-24: 0.53 kg/hari (selisih per 12 bulan dibagi 365)
Regresi log-log bobot ~ luas^b: eksponen b = 1.48 (teori: 1,5) | R2 validasi silang = 0.94
Taksiran bobot sapi dengan siluet 1.500 piksel: 264 kg
Catatan: foto sungguhan butuh koreksi sudut kamera, tinggi terbang, dan timbangan untuk kalibrasi.- Kurva Gompertz memberi bobot dewasa 529 kg, 220 kg pada umur 12 bulan dan 413 kg pada 24 bulan; pertambahan rata-rata 0,53 kg/hari pada tahun kedua (angka contoh).
- Regresi log-log mendapat eksponen 1,48, dekat nilai teori 1,5, R² validasi silang 0,94; sebuah siluet 1.500 piksel ditaksir 264 kg. Pada foto sungguhan perlu koreksi sudut kamera dan tinggi terbang, dan kalibrasi dengan timbangan.
Ransum pakan (optimisasi biaya vs pertumbuhan) sudah dibahas dengan NSGA-II di Bab 57. Pemantauan perilaku dan kesehatan ternak lewat sensor atau kamera, serta pemetaan padang penggembalaan dengan indeks vegetasi, adalah tinjauan; tidak ada kode di buku ini.
Sumber daya alam lain: peta jalan
| Bidang | Pendekatan yang umum | Status di buku ini |
|---|---|---|
| Klasifikasi tutupan/penggunaan lahan | Random forest atau CNN pada citra multipita | Dijalankan (Bab 54 dan bab ini) |
| Sebaran spesies | Model yang menghubungkan titik kehadiran spesies dengan variabel lingkungan (mis. MaxEnt, random forest) | Tinjauan, tidak dijalankan |
| Hidrologi (DAS, debit, banjir) | Model hujan-aliran dan prediksi debit dari deret waktu; analisis DEM untuk DAS | Tinjauan, tidak dijalankan |
| Kualitas air | Regresi dari indeks citra dan data sensor; deteksi anomali (seperti DO di atas) | Anomali dijalankan pada kolam; sisanya tinjauan |
| Pertambangan | Pemantauan perubahan lahan dengan deteksi perubahan (seperti deforestasi di atas) | Tinjauan |
| Perubahan iklim | Analisis deret waktu panjang dan skenario; xarray untuk data iklim | Tinjauan (alat data di Bab 51 dan 53) |
Daftar ini bukan klaim lengkap. Bagi sektor yang berstatus tinjauan, tidak ada kode, angka, atau pustaka yang kami verifikasi.
Proyek Bersambung A3: laporan terpadu per blok
Sebagai penutup, skrip berikut menggabungkan potongan seri ini menjadi laporan satu tabel untuk empat blok: awan titik LiDAR tiruan per blok menghasilkan jumlah pohon, tinggi, biomassa, dan karbon; persamaan hasil panen contoh (dari skrip 03) menghasilkan perkiraan panen padi.
10_proyek_penutup.py
# Bab 59 - Proyek penutup Seri A3: laporan terpadu per blok (pohon, biomassa, karbon, perkiraan panen), data tiruan
import numpy as np
import pandas as pd

from alat_alam import agb_chave_kg, buat_lidar, hitung_chm, puncak_pohon

rng = np.random.default_rng(2)
baris = []
for blok, (jumlah_pohon, ndvi_puncak, hujan) in zip("ABCD", [(70, 0.82, 1000), (55, 0.76, 950), (35, 0.70, 900), (62, 0.80, 1020)]):
    x, y, z, kelas, _ = buat_lidar(benih=100 + ord(blok), jumlah_pohon=jumlah_pohon)
    chm = hitung_chm(x, y, z, kelas)
    _, _, h = puncak_pohon(chm)
    d = 1.6 * h ** 1.05                                              # hubungan tinggi-diameter CONTOH (Bab 59, skrip 02)
    agb_ton = agb_chave_kg(d, h, 0.6).sum() / 1000
    panen = 2500 + 6200 * (ndvi_puncak - 0.5) + 2.2 * (hujan - 900)  # persamaan CONTOH dari skrip 03 (kg/ha)
    baris.append({"blok": blok, "pohon_terdeteksi": len(h), "tinggi_rata_m": round(float(h.mean()), 1),
                  "biomassa_ton_ha": round(float(agb_ton), 1), "karbon_tC_ha": round(float(agb_ton * 0.47), 1),
                  "panen_padi_kg_ha": round(float(panen))})
tabel = pd.DataFrame(baris).set_index("blok")
print(tabel.to_string())
print("\nTotal karbon 4 ha (blok 1 ha masing-masing):", round(float(tabel["karbon_tC_ha"].sum()), 1), "tC")
print("Blok dengan biomassa tertinggi:", tabel["biomassa_ton_ha"].idxmax(), "| terendah:", tabel["biomassa_ton_ha"].idxmin())
pohon_terdeteksi tinggi_rata_m biomassa_ton_ha karbon_tC_ha panen_padi_kg_ha
blok
A 57 20.9 66.4 31.2 4704
B 51 21.8 65.4 30.8 4222
C 33 21.3 39.3 18.5 3740
D 52 21.0 61.2 28.7 4624
Total karbon 4 ha (blok 1 ha masing-masing): 109.2 tC
Blok dengan biomassa tertinggi: A | terendah: CBlok A paling kaya biomassa (66,4 ton/ha, 31,2 tC/ha), blok C paling miskin (39,3 ton/ha; hanya 33 pohon terdeteksi). Total karbon empat blok 109,2 tC. Tabel seperti ini mudah diubah menjadi laporan, dasbor, atau layer peta.
Latihan
- Di
01_lidar_chm.py, gantitinggi_mindipuncak_pohonmenjadi 8 m. Berapa pohon yang ditemukan? Pohon apa yang hilang? - Di
02_biomassa_karbon.py, ganti kerapatan kayu 0,6 dengan 0,4 dan 0,8. Berapa persen biomassa berubah? (Petunjuk: lihat pangkat 0,976.) - Di
04_deforestasi.py, ubah ambang-0.25menjadi-0.10dan-0.40. Bagaimana presisi dan recall bergeser? - Tantangan: di
05_peta_tutupan_raster.py, tambahkan filter mayoritas 3 x 3 (scipy.ndimage.generic_filterataumodal) pada peta hasil dan hitung ulang akurasinya. Apakah titik-titik “garam dan merica” hilang?
Ringkasan Bab
- LiDAR: DSM, DTM, CHM = tinggi pohon; puncak lokal pada CHM = pohon; pohon tertekan sulit ditemukan.
- Biomassa dan karbon: persamaan alometrik (Chave dkk. 2014 dibaca dari sumber sekunder), sangat peka terhadap galat tinggi (±10% jadi -27% sampai +33%).
- Perubahan NDVI dua tanggal menandai deforestasi; NDVI deret waktu memprediksi panen, dan model sederhana yang cocok dengan sifat data bisa mengalahkan model rumit.
- Alur citra ke peta: GeoTIFF masuk, fitur, random forest, GeoTIFF keluar, luas per kelas.
- Perikanan: peringatan dini anomali mengalahkan ambang tetap; peternakan: YOLO menghitung ternak, Gompertz dan luas siluet menaksir bobot.
- Banyak topik lain berstatus tinjauan atau tidak dijalankan, dan buku ini menyatakannya.
Penutup Seri A3
Selamat! Anda menutup Seri A3. Dalam enam bab, Anda sudah bisa:
- melatih model berbasis pohon dan menilainya dengan validasi silang spasial (Bab 54);
- memakai PyTorch dan GPU, memperkirakan VRAM, dan melatih CNN (Bab 55);
- mendeteksi dan menghitung objek dari foto udara dengan YOLO, mengukurnya dengan IoU dan mAP (Bab 56);
- memilih kompromi terbaik dengan NSGA-II dan NSGA-III (Bab 57);
- menjelaskan, mencatat, memantau, dan mendokumentasikan model secara bertanggung jawab (Bab 58);
- menerapkan semuanya pada hutan, kebun, kolam, dan kandang (bab ini).
Model sudah bisa memprediksi. Seri A4 membuat AI yang bisa diajak bicara dan bertindak.
Selanjutnya, di Bab 60: kita masuk ke Seri A4 dengan aplikasi model bahasa besar (LLM) lewat API, RAG, embedding dan basis data vektor, evaluasi, biaya, dan MLOps untuk LLM.