Bab 22 — Regex dan Pengolahan Teks: Menggali Data dari Tulisan Berantakan
Seri I2 — Data dan Internet
Semua skrip bab ini ada di folder kode/bab22/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Data dari API (Bab 21) biasanya rapi. Data dari manusia tidak. Petugas lapangan mengetik “dia 32,5 cm”, rekannya “diameter=32.5cm”, yang lain “JATI” dengan huruf besar semua. Menyaring tulisan seperti itu dengan if dan split cepat berubah menjadi hutan belantara. Regex adalah ibarat kartu cetakan pola: Anda melubangi kartu sesuai bentuk yang dicari (“dua angka, garis miring, dua angka…”), lalu menempelkannya di atas teks; bagian yang pas dengan lubang itulah yang diambil.
Mencari: search, match, findall
Modul re sudah bawaan Python, tidak perlu dipasang.
01_cari_dasar.py
# Bab 22 - Dasar modul re: search, match, fullmatch, findall
import re

teks = "Plot A: diameter 32,5 cm, tinggi 18 m"

print(re.search(r"diameter", teks))                 # mencari di MANA SAJA
print(re.match(r"diameter", teks))                  # match: hanya dari AWAL teks
print(re.match(r"Plot", teks) is not None)
print(re.fullmatch(r"\d+", "2026"), re.fullmatch(r"\d+", "2026 "))

hasil = re.search(r"\d+,\d+", teks)                 # angka desimal berkoma
print(hasil.group(), "ada di posisi", hasil.start(), "sampai", hasil.end())

print(re.findall(r"\d+", teks))                     # semua deretan angka
for cocok in re.finditer(r"[A-Z]", teks):           # setiap huruf besar beserta posisinya
    print(cocok.group(), cocok.start(), end=" | ")
print()
<re.Match object; span=(8, 16), match='diameter'>
None
True
<re.Match object; span=(0, 4), match='2026'> None
32,5 ada di posisi 17 sampai 21
['32', '5', '18']
P 0 | A 5 | re.searchmencari di mana saja; hasilnya objek Match (ada posisispan=(8, 16)) atauNonebila tidak ada.re.matchhanya cocok bila pola ada di awal teks, makanyadiametermenghasilkanNone.re.fullmatchmenuntut seluruh teks cocok:"2026"lolos,"2026 "(ada spasi) gagal.findallmemberi daftar semua kecocokan: tiga deretan angka['32', '5', '18']. Perhatikan:32,5terpecah menjadi32dan5, karena pola\d+tidak tahu soal koma.- Awalan
r"..."(raw string) membuat garis miring terbalik dibaca apa adanya. Biasakan selalu memakainya untuk pola.
Bahan-bahan pola
| Pola | Artinya |
|---|---|
\d |
satu angka; \w satu huruf/angka/garis bawah; \s satu spasi (atau tab) |
. |
satu karakter apa saja (kecuali baris baru) |
[A-C] |
satu karakter dari himpunan itu; [^"] = apa saja kecuali tanda kutip |
+ / * / ? |
satu atau lebih / nol atau lebih / nol atau satu |
{4} / {2,3} |
tepat 4 kali / 2 sampai 3 kali |
(...) |
grup; (?:...) grup tanpa nomor; (?P<nama>...) grup bernama |
\| |
atau; \b batas kata |
02_pola_umum.py
# Bab 22 - Pola umum: kelas karakter dan pengulang
import re

teks = "Plot A: 32,5 cm; Plot B: 45 cm; kode JT-0042; Plot C: 28,0 cm"

pola = {
    r"\d":           "satu angka",
    r"\d+":          "satu atau lebih angka",
    r"\d+,\d+":      "angka berkoma",
    r"\d+(?:,\d+)?": "angka, koma boleh ada boleh tidak",
    r"[A-C]":        "satu huruf antara A dan C",
    r"Plot \w":      "kata Plot, spasi, satu huruf/angka",
    r"[A-Z]{2}-\d{4}": "dua huruf besar, tanda minus, empat angka",
}
for p, arti in pola.items():
    print(f"{p:20} {arti:44} -> {re.findall(p, teks)}")
\d satu angka -> ['3', '2', '5', '4', '5', '0', '0', '4', '2', '2', '8', '0']
\d+ satu atau lebih angka -> ['32', '5', '45', '0042', '28', '0']
\d+,\d+ angka berkoma -> ['32,5', '28,0']
\d+(?:,\d+)? angka, koma boleh ada boleh tidak -> ['32,5', '45', '0042', '28,0']
[A-C] satu huruf antara A dan C -> ['A', 'B', 'C']
Plot \w kata Plot, spasi, satu huruf/angka -> ['Plot A', 'Plot B', 'Plot C']
[A-Z]{2}-\d{4} dua huruf besar, tanda minus, empat angka -> ['JT-0042']Telusuri barisnya: \d+(?:,\d+)? menangkap 32,5 dan 45 sekaligus karena bagian koma dibuat boleh ada, boleh tidak (?). Pola terakhir menemukan kode JT-0042.
Jangan menulis pola panjang sekaligus. Tulis satu bagian, uji dengan findall di teks contoh, tambah bagian berikutnya. Situs seperti regex101.com membantu melihat kecocokan secara visual.
Grup: mengambil bagian-bagian
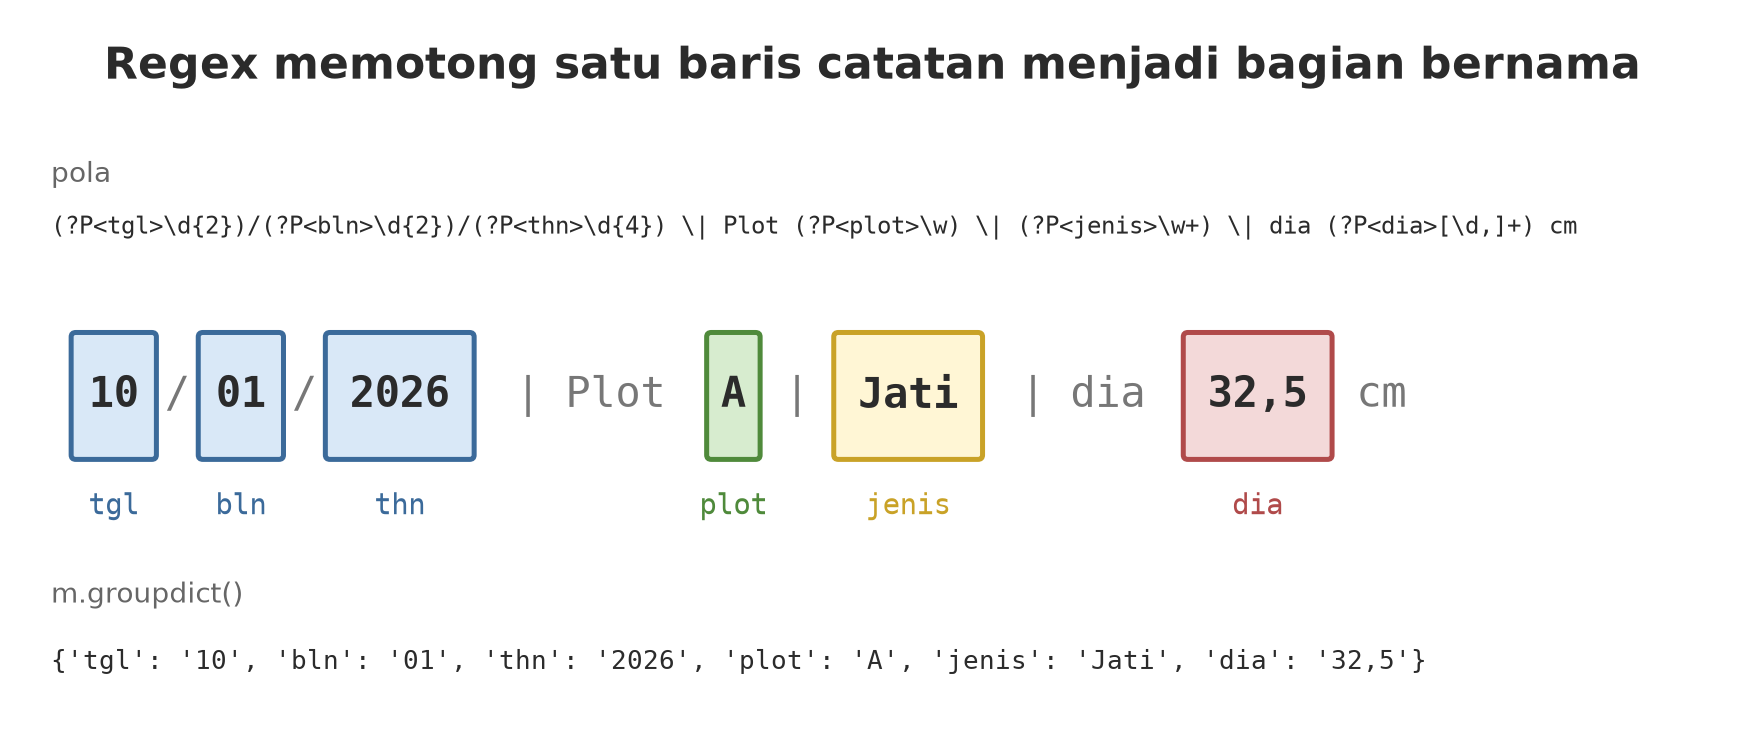
Tanda kurung membuat grup, bagian pola yang hasilnya bisa diambil terpisah. Grup bernama (?P<nama>) jauh lebih mudah dibaca daripada nomor.
03_grup.py
# Bab 22 - Grup: mengambil bagian-bagian yang cocok
import re

baris = "10/01/2026 | Plot A | Jati | dia 32,5 cm"

# kurung biasa = grup bernomor
m = re.search(r"(\d{2})/(\d{2})/(\d{4})", baris)
print(m.groups())                                   # ('10', '01', '2026')
print("Tahun:", m.group(3))

# (?P<nama>...) = grup bernama: lebih mudah dibaca
pola = r"(?P<tgl>\d{2})/(?P<bln>\d{2})/(?P<thn>\d{4}) \| Plot (?P<plot>\w) \| (?P<jenis>\w+)"
m = re.match(pola, baris)
print(m.groupdict())
print(f"{m['thn']}-{m['bln']}-{m['tgl']}")           # menyusun tanggal ISO
('10', '01', '2026')
Tahun: 2026
{'tgl': '10', 'bln': '01', 'thn': '2026', 'plot': 'A', 'jenis': 'Jati'}
2026-01-10m.groups() memberi tuple, m.groupdict() memberi dict, dan m['thn'] mengambil satu grup. Tanggal 10/01/2026 kita susun ulang menjadi 2026-01-10 (format ISO, mudah diurutkan).
Mengganti dan memisah
04_ganti_dan_pisah.py
# Bab 22 - Mengganti (sub) dan memisah (split)
import re

teks = "dia 32,5 cm; dia 45,2 cm; dia 28 cm"

print(re.sub(r"(\d),(\d)", r"\1.\2", teks))          # koma desimal -> titik; \1 \2 = grup 1 dan 2
print(re.sub(r"\s+", " ", "Plot    A   Jati"))        # banyak spasi -> satu spasi
print(re.subn(r"cm", "CM", teks))                    # subn juga memberi jumlah penggantian


def ke_meter(cocok):
    """Dipanggil untuk setiap kecocokan; mengembalikan teks penggantinya."""
    cm = float(cocok.group(1).replace(",", "."))
    return f"{cm / 100:.3f} m"


print(re.sub(r"(\d+(?:,\d+)?) cm", ke_meter, teks))
print(re.split(r"\s*[;,|]\s*", "A ; B,C |D"))         # pisah di salah satu pemisah
dia 32.5 cm; dia 45.2 cm; dia 28 cm
Plot A Jati
('dia 32,5 CM; dia 45,2 CM; dia 28 CM', 3)
dia 0.325 m; dia 0.452 m; dia 0.280 m
['A', 'B', 'C', 'D']re.sub(pola, pengganti, teks)mengganti semua kecocokan.\1dan\2di pengganti merujuk grup 1 dan 2, jadi32,5menjadi32.5.re.subnjuga melaporkan jumlah penggantian: 3.- Pengganti boleh berupa fungsi yang dipanggil untuk tiap kecocokan: kita ubah sentimeter menjadi meter (
32,5 cmmenjadi0.325 m). re.splitmemotong di salah satu pemisah, termasuk bila ada spasi di sekitarnya.
compile, flags, dan VERBOSE
05_compile_flags.py
# Bab 22 - compile, flags (IGNORECASE) dan pola VERBOSE
import re

# Pola yang dipakai berulang: compile sekali, pakai berkali-kali
pola_jenis = re.compile(r"\b(jati|meranti|mahoni|sengon)\b", re.IGNORECASE)
print(pola_jenis.findall("JATI sehat, Meranti sakit, mahoni, pohon lain"))

# VERBOSE: spasi dan komentar di dalam pola diabaikan, jadi pola panjang bisa dijelaskan
pola_tanggal = re.compile(r"""
    (?P<tgl>\d{1,2})      # tanggal
    [/-]                  # pemisah: garis miring atau minus
    (?P<bln>\d{1,2})      # bulan
    [/-]
    (?P<thn>\d{4})        # tahun
""", re.VERBOSE)
for s in ["10/01/2026", "5-3-2026", "2026-01-10"]:
    m = pola_tanggal.fullmatch(s)
    print(f"{s:11} ->", m.groupdict() if m else "tidak cocok")
['JATI', 'Meranti', 'mahoni']
10/01/2026 -> {'tgl': '10', 'bln': '01', 'thn': '2026'}
5-3-2026 -> {'tgl': '5', 'bln': '3', 'thn': '2026'}
2026-01-10 -> tidak cocokre.compile menyiapkan pola sekali untuk dipakai berulang. re.IGNORECASE mengabaikan besar-kecil huruf (makanya JATI ikut). re.VERBOSE membolehkan spasi dan komentar di dalam pola, sehingga pola panjang bisa dijelaskan baris demi baris. Perhatikan 2026-01-10 tidak cocok karena pola kita mengharapkan tahun di belakang.
Jebakan: serakah dan lupa None
06_serakah_dan_malas.py
# Bab 22 - Jebakan: pengulang yang serakah (greedy) dan yang malas (lazy)
import re

teks = 'catatan "sehat" lalu catatan "sakit" selesai'

print(re.findall(r'".*"', teks))        # serakah: menelan sebanyak mungkin
print(re.findall(r'".*?"', teks))       # malas (?): berhenti secepat mungkin
print(re.findall(r'"([^"]*)"', teks))   # cara lain: "apa pun kecuali tanda kutip"
['"sehat" lalu catatan "sakit"']
['"sehat"', '"sakit"']
['sehat', 'sakit']Pola ".*" serakah (greedy): ia menelan sebanyak mungkin, dari kutip pertama sampai kutip terakhir, jadi dua catatan menyatu. Tambahan ? membuatnya malas (lazy): berhenti pada kutip terdekat. Cara ketiga, [^"]*, sering paling jelas.
re.search mengembalikan None bila tidak ada kecocokan. Memanggil .group() pada None memunculkan AttributeError. Selalu periksa dulu: if hasil:.
07_galat_dan_none.py
# Bab 22 - Dua galat klasik: pola rusak dan lupa memeriksa None
import re

try:
    re.compile(r"(\d+")                     # kurung buka tanpa pasangan
except re.error as galat:
    print("Pola rusak:", galat)

hasil = re.search(r"\d+", "tidak ada angka di sini")
print("Hasil pencarian:", hasil)             # None, bukan galat

try:
    print(hasil.group())
except AttributeError as galat:
    print("Galat:", galat)

# Cara aman: periksa dulu
if hasil:
    print(hasil.group())
else:
    print("Tidak ada angka; lanjutkan dengan aman.")
Pola rusak: missing ), unterminated subpattern at position 0
Hasil pencarian: None
Galat: 'NoneType' object has no attribute 'group'
Tidak ada angka; lanjutkan dengan aman.Pola dengan kurung tanpa pasangan memunculkan re.error saat compile. Bunyi pesan galat bisa berbeda antarversi Python; yang penting Anda tahu galat itu ada di pola, bukan di teks.
Proyek Bersambung I2: membersihkan catatan lapangan
Langkah 2: lima catatan lapangan fiktif ditulis dengan gaya berbeda-beda, ditambah satu baris rusak. Satu pola VERBOSE menerima semua gaya, lalu kode merapikan: tanggal menjadi ISO, plot menjadi huruf besar, jenis dengan huruf awal besar, angka berkoma menjadi desimal Python, dan “sehat/sakit” menjadi True/False.
08_proyek_bersihkan.py
# Bab 22 - Proyek bersambung I2, langkah 2: membersihkan catatan lapangan dengan regex
import json
import re
from pathlib import Path

catatan = [
    "10/01/2026 | Plot A | Jati | dia 32,5 cm | tinggi 18 m | SEHAT",
    "10/01/2026 | plot a | meranti | diameter=45.2cm | tinggi: 25,5 m | sakit",
    "11-01-2026 | Plot B | Mahoni | dia 28 cm | tinggi 15 m | sehat",
    "11/01/2026 | Plot C | sengon | dia  19,8cm | tinggi 12 m | Sehat ",
    "12/01/2026 | Plot B | JATI | dia 36,1 cm | tinggi 20,5 m | sakit",
    "rusak: baris tanpa data yang jelas",
]

POLA = re.compile(r"""
    (?P<tgl>\d{1,2})[/-](?P<bln>\d{1,2})[/-](?P<thn>\d{4}) \s*\|\s*
    plot\s+(?P<plot>[a-z]) \s*\|\s*
    (?P<jenis>[a-z]+) \s*\|\s*
    (?:dia|diameter)\s*[=:]?\s*(?P<dia>\d+(?:[.,]\d+)?)\s*cm \s*\|\s*
    tinggi\s*[=:]?\s*(?P<tinggi>\d+(?:[.,]\d+)?)\s*m \s*\|\s*
    (?P<kondisi>sehat|sakit)
""", re.VERBOSE | re.IGNORECASE)


def angka(teks):
    return float(teks.replace(",", "."))


bersih, ditolak = [], []
for baris in catatan:
    m = POLA.fullmatch(baris.strip())
    if m is None:
        ditolak.append(baris)
        continue
    bersih.append({
        "tanggal": f"{m['thn']}-{int(m['bln']):02d}-{int(m['tgl']):02d}",
        "plot": m["plot"].upper(),
        "jenis": m["jenis"].capitalize(),
        "diameter_cm": angka(m["dia"]),
        "tinggi_m": angka(m["tinggi"]),
        "sehat": m["kondisi"].lower() == "sehat",
    })

for b in bersih:
    print(b)
print("Ditolak:", ditolak)

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)
(tmp / "catatan_bersih.json").write_text(json.dumps(bersih, ensure_ascii=False, indent=1), encoding="utf-8")
print(f"{len(bersih)} baris bersih, {len(ditolak)} ditolak")
{'tanggal': '2026-01-10', 'plot': 'A', 'jenis': 'Jati', 'diameter_cm': 32.5, 'tinggi_m': 18.0, 'sehat': True}
{'tanggal': '2026-01-10', 'plot': 'A', 'jenis': 'Meranti', 'diameter_cm': 45.2, 'tinggi_m': 25.5, 'sehat': False}
{'tanggal': '2026-01-11', 'plot': 'B', 'jenis': 'Mahoni', 'diameter_cm': 28.0, 'tinggi_m': 15.0, 'sehat': True}
{'tanggal': '2026-01-11', 'plot': 'C', 'jenis': 'Sengon', 'diameter_cm': 19.8, 'tinggi_m': 12.0, 'sehat': True}
{'tanggal': '2026-01-12', 'plot': 'B', 'jenis': 'Jati', 'diameter_cm': 36.1, 'tinggi_m': 20.5, 'sehat': False}
Ditolak: ['rusak: baris tanpa data yang jelas']
5 baris bersih, 1 ditolakDari enam baris, 5 bersih dan 1 ditolak. Menolak dengan jujur lebih baik daripada menebak: baris yang ditolak dicatat agar manusia bisa memeriksanya. Hasil bersih disimpan di _tmp/catatan_bersih.json, siap digabung dengan data lain di bab berikutnya.
Latihan
- Tulis pola yang menemukan semua kode seperti
JT-0042di"JT-0042, MR-0107, xx-12". (Hasilnya hanya dua.) - Dengan
re.sub, ubah"Plot A,Plot B , Plot C"menjadi"Plot A, Plot B, Plot C". - Tambahkan satu baris catatan baru di
08_proyek_bersihkan.pydengan gaya yang belum ada (mis.tinggi=14 mtanpa spasi). Apakah diterima? Ubah pola bila perlu. - Tantangan: perluas pola agar suhu seperti
suhu 27,5 Cdi akhir baris menjadi grup opsional (boleh ada, boleh tidak).
Ringkasan Bab
- Regex = bahasa pola teks; modul
rebawaan Python; tulis pola denganr"...". search(di mana saja),match(dari awal),fullmatch(seluruhnya),findall(semua).- Grup
(...)dan(?P<nama>...)mengambil bagian;groupdict()menghasilkan dict. submengganti (boleh dengan fungsi),splitmemisah,compilemenyiapkan pola,VERBOSEmembuat pola terbaca.- Waspadai pengulang serakah dan selalu periksa hasil
None. - Data kotor dibersihkan dengan satu pola yang jelas; baris yang tidak cocok ditolak dan dicatat.
Selanjutnya, di Bab 23: data sudah bersih, tetapi puluhan ribu baris tak muat diolah dengan perulangan biasa. Kenalan dengan numpy dan pandas.