Bab 53 — Data Besar dan Komputasi Ilmiah: Saat Data Tidak Muat di Memori
Seri A2 — Data Skala Besar dan Geospasial Lanjut
Semua skrip bab ini ada di folder kode/bab53/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip). buat_data.py hanyalah modul bantu pembuat data tiruan (fiktif).
Pada Bab 50, Anda mengolah jutaan baris dengan Polars dan DuckDB; bab itu tidak diulang di sini. Tetapi ada batas yang tak bisa dilewati satu komputer: memori (RAM). Citra satelit dua puluh tahun, tumpukan foto drone, atau data sensor sepuluh tahun bisa lebih besar dari RAM. Bila Anda memaksa memuatnya, program berhenti dengan MemoryError (atau komputer melambat sampai macet).
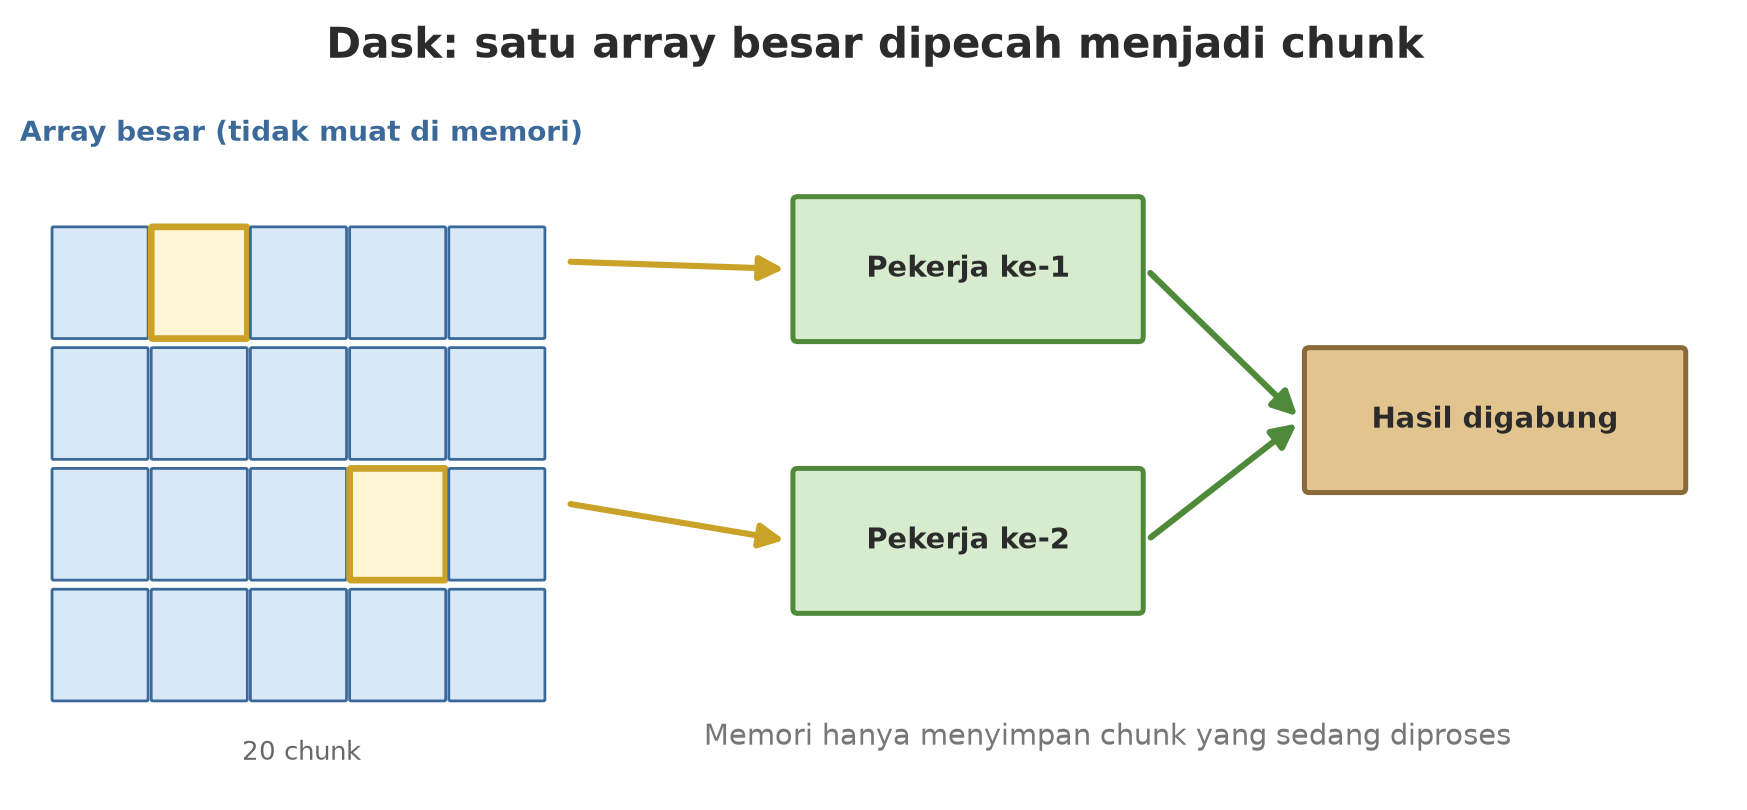
Bayangkan memindahkan satu truk padi ke lumbung. Anda tak mengangkat seluruh truk sekaligus; Anda mengangkat karung demi karung. Memproses per potongan (chunk) adalah prinsip bab ini: baca satu karung, kerjakan, buang, ambil karung berikutnya. Dask mengotomatiskannya, dan membagi karung-karung itu ke banyak inti CPU.
Dask DataFrame: banyak berkas, satu tabel
Dask adalah pustaka komputasi paralel yang meniru antarmuka pandas dan NumPy. Pada Dask DataFrame, satu tabel besar terdiri dari banyak partisi (masing-masing sebuah tabel pandas), dan perhitungannya malas: Anda menyusun rencana, baru compute() yang benar-benar bekerja.
Kita membuat 12 berkas Parquet bulanan (600.000 baris di semuanya) dan membacanya sebagai satu tabel.
01_dask_dataframe.py
# Bab 53 - Dask DataFrame: banyak berkas Parquet dibaca sebagai satu tabel besar, dihitung per potongan
import dask
import dask.dataframe as dd

from buat_data import buat_parquet_bulanan

folder = buat_parquet_bulanan()                      # 12 berkas x 50.000 baris = 600.000 baris

ddf = dd.read_parquet(folder)                        # MALAS: hanya membaca metadata
print("Jenis:", type(ddf).__name__)
print("Jumlah partisi (potongan):", ddf.npartitions)
print("Kolom:", list(ddf.columns))

# Menyusun perhitungan belum menghitung apa-apa
rata = ddf.groupby("unit")["nilai"].mean()
print("Rata-rata per unit (masih rencana):", type(rata).__name__)

hasil = rata.compute()                                # BARU di sini data dibaca dan dihitung
print(hasil.round(3).sort_index())

# Beberapa hasil sekaligus: Dask berbagi pekerjaan bersama (data hanya dibaca sekali)
jumlah_baris, nilai_maks = dask.compute(ddf.shape[0], ddf["nilai"].max())
print("Jumlah baris:", jumlah_baris, "| nilai maksimum:", nilai_maks)
Jenis: DataFrame
Jumlah partisi (potongan): 12
Kolom: ['bulan', 'unit', 'nilai']
Rata-rata per unit (masih rencana): Series
unit
kandang 26.484
kebun 26.493
kolam 26.506
Name: nilai, dtype: float64
Jumlah baris: 600000 | nilai maksimum: 44.938read_parquet(folder)langsung selesai: hanya metadata yang dibaca. Tabelnya punya 12 partisi, satu per berkas.ddf.groupby("unit")["nilai"].mean()hanya menghasilkan rencana (sebuah objekSeriesmalas). Belum ada data yang dibaca..compute()menjalankan rencana: data dibaca per partisi, dirangkum, lalu digabung. Rata-rata ketiga unit sekitar 26,5.dask.compute(a, b)menghitung beberapa hasil sekaligus sehingga data hanya dibaca sekali: 600.000 baris, nilai maksimum 44,938.
Untuk data yang masih muat di RAM, Polars atau DuckDB (Bab 50) biasanya lebih cepat dan lebih sederhana daripada Dask. Pakai Dask bila datanya lebih besar dari memori, bila Anda butuh antarmuka mirip pandas/NumPy pada data besar, atau bila pekerjaan harus dibagi ke banyak mesin.
Graf tugas: bagaimana Dask berpikir
Di balik layar, Dask mengubah rencana Anda menjadi graf tugas (task graph): simpul adalah pekerjaan kecil, panah adalah “yang ini butuh hasil yang itu”. Tugas yang tidak bergantung satu sama lain bisa jalan bersamaan. Dengan dask.delayed, Anda membuat graf sendiri dari fungsi Python biasa.
02_graf_tugas.py
# Bab 53 - Dask delayed: menyusun graf tugas, lalu menjalankannya (bisa paralel)
import dask
from dask import delayed


def baca_blok(nomor):
    """Pura-pura membaca satu blok data lapangan (angka contoh)."""
    return [nomor * 10 + i for i in range(5)]


def jumlah(blok):
    return sum(blok)


blok = [delayed(baca_blok)(n) for n in range(4)]       # 4 tugas baca, belum berjalan
jumlah_blok = [delayed(jumlah)(b) for b in blok]       # 4 tugas jumlah, bergantung pada tugas baca
total = delayed(sum)(jumlah_blok)                      # satu tugas penutup

print("Jenis total:", type(total).__name__)
graf = dict(total.__dask_graph__())
print("Jumlah tugas dalam graf:", len(graf), "(4 baca + 4 jumlah + 1 total)")

# Tugas 'jumlah' dan 'baca' antarblok saling bebas, jadi boleh jalan bersamaan
print("Hasil (benang/threads):", total.compute(scheduler="threads"))
print("Hasil (sinkron, satu per satu):", total.compute(scheduler="synchronous"))
print("Hitung manual:", sum(sum(baca_blok(n)) for n in range(4)))
Jenis total: Delayed
Jumlah tugas dalam graf: 9 (4 baca + 4 jumlah + 1 total)
Hasil (benang/threads): 340
Hasil (sinkron, satu per satu): 340
Hitung manual: 340Ada 4 tugas baca, 4 tugas jumlah, dan 1 tugas penutup: 9 simpul, tepat seperti yang tercetak. Hasilnya 340, baik dihitung dengan benang paralel, secara sinkron (satu per satu), maupun dengan rumus manual. Hasil harus sama; hanya cara dan kecepatannya yang berbeda.
Dask Array: array raksasa dalam chunk
Dask Array meniru NumPy. Array 20.000 x 20.000 bilangan float32 memakan sekitar 1,6 GB bila utuh, lebih dari yang nyaman untuk banyak komputer. Pada Dask, array itu dipecah menjadi 100 chunk berukuran 16 MB.
03_dask_array.py
# Bab 53 - Dask Array: array raksasa dipecah menjadi chunk; hanya satu-dua chunk di memori pada satu waktu
import dask.array as da
import numpy as np

# 20.000 x 20.000 float32 = sekitar 1,6 GB bila utuh. Di sini hanya RENCANA; belum ada yang dibuat.
x = da.random.default_rng(42).random((20_000, 20_000), chunks=(2_000, 2_000), dtype="float32")
print("Bentuk:", x.shape, "| chunk:", x.chunksize, "| jumlah chunk:", x.npartitions)
print("Ukuran seluruhnya (GB):", round(x.nbytes / 1e9, 2), "| ukuran satu chunk (MB):", round(x.blocks[0, 0].nbytes / 1e6, 1))

# Pengurangan (reduksi): setiap chunk dihitung sendiri-sendiri, lalu hasil kecil digabung
rata = x.mean()
print("Rata-rata:", round(float(rata.compute()), 4), "(harapan sekitar 0,5)")

# Operasi gaya NumPy tetap bekerja: rata-rata per kolom, lalu ambil 3 nilai pertama
per_kolom = x.mean(axis=0)
print("Rata-rata per kolom (3 pertama):", [round(float(v), 3) for v in per_kolom[:3].compute()])

# Bandingkan dengan NumPy pada array kecil: hasilnya harus sama
kecil = np.arange(10_000, dtype="float64").reshape(100, 100)
dk = da.from_array(kecil, chunks=(25, 25))
print("Dask sama dengan NumPy:", bool(np.allclose(dk.sum(axis=1).compute(), kecil.sum(axis=1))))
Bentuk: (20000, 20000) | chunk: (2000, 2000) | jumlah chunk: 100
Ukuran seluruhnya (GB): 1.6 | ukuran satu chunk (MB): 16.0
Rata-rata: 0.5 (harapan sekitar 0,5)
Rata-rata per kolom (3 pertama): [0.495, 0.499, 0.501]
Dask sama dengan NumPy: Trueda.random...hanya membuat rencana untuk 100 chunk (2.000 x 2.000 tiap chunk). Memori tidak terpakai sebesar 1,6 GB.x.mean()dihitung chunk demi chunk: tiap chunk dibuat, dirata-ratakan, lalu dibuang; hanya hasil kecilnya yang digabung. Hasilnya 0,5, sesuai harapan untuk bilangan acak seragam.- Operasi gaya NumPy seperti
mean(axis=0)tetap berfungsi. Pada array kecil, Dask menghasilkan angka yang sama dengan NumPy (True).
Bagaimana memilih ukuran chunk? Dokumentasi Dask menyebut ukuran 10 MB sampai 1 GB lazim dipakai, bergantung pada RAM dan lamanya perhitungan; ukuran harus cukup kecil agar banyak chunk muat di memori bersamaan. Ia juga menyarankan satu tugas sebaiknya berjalan lebih lama dari sekitar 100 ms, karena penjadwalan memakan sekitar 1 ms per tugas: chunk yang terlalu kecil membuat penjadwalan lebih mahal daripada pekerjaannya. Ukuran bawaan otomatisnya 128 MiB.
Memproses per potongan tanpa Dask
Dask hanya mengotomatiskan sesuatu yang bisa Anda tulis sendiri. Contoh berikut membaca citra 4096 x 4096 piksel (sekitar 64 MB; kecil, agar bisa dibandingkan dengan cara utuh) blok demi blok dan hanya menyimpan tiga angka penampung: jumlah, jumlah kuadrat, dan banyaknya piksel. Itu cukup untuk rata-rata dan simpangan baku.
04_potongan_manual.py
# Bab 53 - Pemrosesan per potongan tanpa pustaka khusus: baca satu blok, rangkum, buang, lanjut
import tracemalloc
from pathlib import Path

import numpy as np
import rasterio
from rasterio.transform import from_origin
from rasterio.windows import Window

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)
jalur = tmp / "citra_besar.tif"
UKURAN, BLOK = 4096, 512

# Tulis citra tiruan blok demi blok (supaya pembuatnya pun tidak butuh memori besar)
if not jalur.exists():
    with rasterio.open(jalur, "w", driver="GTiff", height=UKURAN, width=UKURAN, count=1, dtype="float32",
                       crs="EPSG:32748", transform=from_origin(700000, 9270000, 10, 10),
                       tiled=True, blockxsize=BLOK, blockysize=BLOK) as dst:
        for baris in range(0, UKURAN, BLOK):
            for kolom in range(0, UKURAN, BLOK):
                rng = np.random.default_rng(baris * UKURAN + kolom)
                dst.write(rng.normal(0.5, 0.1, (BLOK, BLOK)).astype("float32"), 1,
                          window=Window(kolom, baris, BLOK, BLOK))

# Cara 1: per blok, menyimpan hanya jumlah, kuadrat, dan banyaknya (cukup untuk rata-rata dan simpangan baku)
tracemalloc.start()
n, s, s2, tinggi = 0, 0.0, 0.0, 0
with rasterio.open(jalur) as src:
    for _, jendela in src.block_windows(1):
        blok = src.read(1, window=jendela).astype("float64")
        n += blok.size
        s += blok.sum()
        s2 += (blok ** 2).sum()
        tinggi += int((blok > 0.7).sum())
puncak_blok = tracemalloc.get_traced_memory()[1]
tracemalloc.stop()
rata = s / n
simpang = (s2 / n - rata ** 2) ** 0.5

# Cara 2: baca semuanya sekaligus (di sini masih muat, jadi bisa dijadikan pembanding)
tracemalloc.start()
with rasterio.open(jalur) as src:
    semua = src.read(1).astype("float64")
puncak_penuh = tracemalloc.get_traced_memory()[1]
tracemalloc.stop()

print("Jumlah piksel:", n, "| jumlah blok:", (UKURAN // BLOK) ** 2)
print("Per blok -> rata-rata:", round(rata, 5), " simpangan baku:", round(simpang, 5), " piksel > 0,7:", tinggi)
print("Utuh     -> rata-rata:", round(float(semua.mean()), 5), " simpangan baku:", round(float(semua.std()), 5),
      " piksel > 0,7:", int((semua > 0.7).sum()))
print("Memori puncak cara per blok kurang dari 1/10 cara utuh:", puncak_blok < puncak_penuh / 10)
Jumlah piksel: 16777216 | jumlah blok: 64
Per blok -> rata-rata: 0.50002 simpangan baku: 0.10002 piksel > 0,7: 382303
Utuh -> rata-rata: 0.50002 simpangan baku: 0.10002 piksel > 0,7: 382303
Memori puncak cara per blok kurang dari 1/10 cara utuh: True- Citra tersusun dari 64 blok 512 x 512. Pembuatnya pun menulis blok demi blok.
- Hasil per blok dan hasil utuh identik: rata-rata 0,50002, simpangan baku 0,10002, dan 382.303 piksel di atas 0,7.
- Memori puncak cara per blok kurang dari sepersepuluh cara utuh (diukur dengan
tracemalloc). Itulah intinya: hasilnya sama, tetapi memorinya kecil, sehingga ukuran citra hampir tidak lagi menjadi masalah.
Rumus simpangan baku s2/n - rata**2 mudah ditulis tetapi bisa tidak stabil secara numerik pada angka yang sangat besar atau sangat rapat (selisih dua bilangan hampir sama). Untuk data nyata, pakai algoritma yang stabil seperti Welford atau gabungkan statistik per blok dengan rumus gabungan yang dikenal. Di sini datanya jinak sehingga hasilnya cocok sampai lima angka desimal.
xarray + Dask: tumpukan citra multitemporal
Pada Bab 51 Anda memakai xarray untuk tumpukan kecil. Bila tumpukannya besar, xarray memakai Dask di baliknya: array tetap bernama (waktu, y, x) tetapi datanya berupa chunk Dask yang malas, dibaca dari Zarr. Berikut 24 tanggal x 1024 x 1024 piksel (sekitar 100 MB); di dunia nyata ini bisa ratusan GB.
05_xarray_dask.py
# Bab 53 - xarray + Dask: tumpukan citra multitemporal tiruan yang diproses per potongan
import shutil
from pathlib import Path

import dask.array as da
import numpy as np
import pandas as pd
import xarray as xr

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)
zarr_path = tmp / "ndvi_24bulan.zarr"
shutil.rmtree(zarr_path, ignore_errors=True)

# 1. Buat 24 tanggal x 1024 x 1024 piksel (sekitar 100 MB) langsung ke Zarr, satu chunk per tanggal-ubin
waktu = pd.date_range("2024-01-01", periods=24, freq="MS")
y, x = np.arange(1024), np.arange(1024)
kebisingan = da.random.default_rng(5).normal(0, 0.02, (24, 1024, 1024), chunks=(1, 256, 256)).astype("float32")
bulan_ke = np.arange(24, dtype="float32")[:, None, None]
petak_kering = ((y[:, None] < 256) & (x[None, :] < 256))[None, :, :]     # satu sudut 256x256 'mengering'
tren = bulan_ke * np.where(petak_kering, -0.02, 0.01).astype("float32")  # NDVI naik 0,01/bulan, petak turun 0,02
dasar = (0.4 + 0.2 * np.sin(x / 150))[None, None, :].astype("float32")        # pola ruang sederhana
ndvi = xr.DataArray(kebisingan + tren + dasar, dims=("waktu", "y", "x"),
                    coords={"waktu": waktu, "y": y, "x": x}, name="ndvi")
ndvi.to_dataset().to_zarr(zarr_path, mode="w", consolidated=False)

# 2. Buka kembali: LANGSUNG selesai karena hanya metadata yang dibaca
ds = xr.open_zarr(zarr_path, consolidated=False)
da_ndvi = ds["ndvi"]
print("Bentuk:", dict(da_ndvi.sizes), "| chunk:", da_ndvi.data.chunksize)
print("Ukuran bila utuh (MB):", round(da_ndvi.nbytes / 1e6), "| terhitung di memori sekarang: belum ada")

# 3. Agregasi spasial: rata-rata per bulan, dihitung chunk demi chunk
per_bulan = da_ndvi.mean(dim=("y", "x")).compute()
print("NDVI rata-rata bulan ke-1, 12, 24:", [round(float(per_bulan[i]), 3) for i in (0, 11, 23)])

# 4. Agregasi waktu: kenaikan per piksel (akhir - awal) lalu persentase piksel yang naik
kenaikan = da_ndvi.isel(waktu=slice(-3, None)).mean("waktu") - da_ndvi.isel(waktu=slice(0, 3)).mean("waktu")
print("Piksel yang NDVI-nya naik:", round(float((kenaikan > 0).mean().compute()) * 100, 1), "%")

# 5. Rechunk: operasi sepanjang waktu lebih cocok bila seluruh deret waktu satu piksel ada dalam satu chunk
untuk_waktu = da_ndvi.chunk({"waktu": -1, "y": 128, "x": 128})
print("Chunk setelah rechunk:", untuk_waktu.data.chunksize)
maks_per_piksel = untuk_waktu.max("waktu")
print("NDVI maksimum seluruh periode (rata-rata semua piksel):", round(float(maks_per_piksel.mean().compute()), 3))
Bentuk: {'waktu': 24, 'y': 1024, 'x': 1024} | chunk: (1, 256, 256)
Ukuran bila utuh (MB): 101 | terhitung di memori sekarang: belum ada
NDVI rata-rata bulan ke-1, 12, 24: [0.404, 0.494, 0.591]
Piksel yang NDVI-nya naik: 93.8 %
Chunk setelah rechunk: (24, 128, 128)
NDVI maksimum seluruh periode (rata-rata semua piksel): 0.629- Array dibuat dan ditulis ke Zarr chunk demi chunk tanpa pernah utuh di memori. Saat dibuka kembali, ia langsung siap: hanya metadata yang dibaca (chunk
(1, 256, 256)). mean(dim=("y", "x"))dihitung per chunk: NDVI rata-rata bulan ke-1, 12, dan 24 adalah 0,404; 0,494; 0,591.- Kenaikan per piksel (rata-rata tiga bulan terakhir dikurangi tiga bulan pertama) bernilai positif di 93,8% piksel. Sisanya, sudut 256 x 256 piksel (6,25%) yang sengaja dibuat “mengering”, turun.
- Rechunk: untuk operasi sepanjang waktu (seperti
max("waktu")), lebih efisien bila seluruh deret waktu satu piksel berada di satu chunk, sehingga chunk diubah menjadi(24, 128, 128). Pola chunk ideal bergantung pada pertanyaan yang Anda ajukan.
Penjadwal dan banyak inti
Dask punya beberapa penjadwal: yang memutuskan bagaimana tugas dijalankan.
| Penjadwal | Cara kerja | Cocok untuk |
|---|---|---|
synchronous |
satu tugas per satu, di proses utama | debugging dan uji |
threads |
beberapa benang dalam satu proses | pekerjaan yang melepas GIL (NumPy, pembacaan berkas) |
processes |
beberapa proses terpisah | pekerjaan Python murni yang berat di CPU |
Pada Python standar, GIL membuat benang tidak mempercepat perulangan Python murni; proses terpisah mengatasinya. (Bab 47 membahas mode tanpa GIL.) Contoh berikut menjalankan hitungan Python murni yang sama dengan ketiga penjadwal.
06_penjadwal_dask.py
# Bab 53 - Penjadwal (scheduler) Dask: sinkron, benang (threads), dan proses (processes)
import dask
from dask import delayed


def hitung_berat(n):
    """Pekerjaan Python murni (perulangan) yang terikat CPU: contoh hitungan 'berat' per blok."""
    total = 0
    for i in range(300_000):
        total += (i * n) % 7
    return total


if __name__ == "__main__":              # wajib di Windows: proses anak mengimpor ulang berkas ini
    tugas = [delayed(hitung_berat)(n) for n in range(1, 9)]
    jumlah = delayed(sum)(tugas)

    hasil = {}
    for nama in ("synchronous", "threads", "processes"):
        hasil[nama] = jumlah.compute(scheduler=nama)
        print(f"{nama:12s} -> {hasil[nama]}")
    print("Ketiganya sama:", len(set(hasil.values())) == 1)

    # Penjadwal bawaan bisa diganti untuk satu blok kode saja
    with dask.config.set(scheduler="synchronous"):
        print("Dalam blok 'with' (sinkron):", jumlah.compute())
synchronous -> 6299979
threads -> 6299979
processes -> 6299979
Ketiganya sama: True
Dalam blok 'with' (sinkron): 6299979Ketiganya memberi hasil yang sama (6.299.979); hanya cara berjalannya yang berbeda. Perhatikan if __name__ == "__main__":: di Windows, proses anak mengimpor ulang berkas Anda; tanpa pelindung itu, tiap proses anak akan menjalankan ulang seluruh skrip. (Keluaran tidak menampilkan waktu proses karena bergantung pada komputer Anda; ukurlah sendiri di komputer Anda.)
Tanpa Dask, Python punya ProcessPoolExecutor (Bab 35). Contoh berikut membagi 64 blok citra ke 2 pekerja, lalu membandingkan dengan cara berurutan. Terakhir, map_blocks dari Dask menerapkan fungsi NumPy biasa pada tiap chunk secara paralel.
07_paralel_inti.py
# Bab 53 - Paralel di banyak inti untuk potongan citra: ProcessPoolExecutor dan dask.map_blocks
from concurrent.futures import ProcessPoolExecutor
from pathlib import Path

import dask.array as da
import numpy as np
import rasterio
import rioxarray

jalur = Path(__file__).parent / "_tmp" / "citra_besar.tif"       # dibuat oleh skrip 04


def hitung_blok(jendela):
    """Dikerjakan di proses lain: buka berkas sendiri, baca satu blok, kembalikan ringkasan kecil."""
    with rasterio.open(jalur) as src:
        blok = src.read(1, window=jendela)
    return int((blok > 0.7).sum()), blok.size


if __name__ == "__main__":
    if not jalur.exists():
        raise SystemExit("jalankan 04_potongan_manual.py dulu")
    with rasterio.open(jalur) as src:
        jendela = [w for _, w in src.block_windows(1)]

    serial = [hitung_blok(w) for w in jendela]
    with ProcessPoolExecutor(max_workers=2) as kolam:
        paralel = list(kolam.map(hitung_blok, jendela, chunksize=8))
    print("Jumlah blok:", len(jendela))
    print("Hasil paralel sama dengan serial:", serial == paralel)
    print("Piksel > 0,7:", sum(a for a, _ in paralel), "dari", sum(b for _, b in paralel))

    # Cara Dask: map_blocks menerapkan fungsi NumPy biasa pada tiap chunk; citra dibuka MALAS (per chunk)
    with rioxarray.open_rasterio(jalur, chunks={"x": 512, "y": 512}) as citra:   # 'with' menutup berkas dengan rapi
        besar = citra.squeeze("band").data
        kelas = da.map_blocks(lambda b: np.digitize(b, [0.4, 0.6]).astype("uint8"), besar, dtype="uint8")
        hitungan = da.bincount(kelas.ravel(), minlength=3).compute()
    print("Kelas 0 (<0,4), 1 (0,4-0,6), 2 (>=0,6):", hitungan.tolist())
Jumlah blok: 64
Hasil paralel sama dengan serial: True
Piksel > 0,7: 382303 dari 16777216
Kelas 0 (<0,4), 1 (0,4-0,6), 2 (>=0,6): [2662364, 11451060, 2663792]Hasil paralel sama dengan serial (382.303 dari 16.777.216 piksel di atas 0,7). Tiap proses membuka berkas sendiri dan hanya mengembalikan ringkasan kecil, bukan blok piksel. Aturan emasnya: kirim sedikit, hitung banyak; memindahkan data besar antarproses justru lambat. map_blocks mengelompokkan nilai ke tiga kelas: 2.662.364 piksel di bawah 0,4, 11.451.060 antara 0,4 dan 0,6, dan 2.663.792 piksel 0,6 ke atas.
Paralel tidak selalu lebih cepat. Ada biaya memulai proses, memindahkan data, dan menggabung hasil. Ukur dulu pada contoh kecil, dan pastikan hasil paralel sama dengan hasil serial sebelum memercayainya. Bila satu mesin tak cukup, Dask juga bisa berjalan di banyak mesin (paket distributed); itu tidak dicoba di bab ini.
Proyek Bersambung A2: deret waktu NDVI per blok kebun
Penutup proyek: dari Zarr 24 bulan, hitung rata-rata NDVI untuk empat blok kebun dalam satu kali jalan, cari kemiringan trennya, dan simpan tabel hasilnya sebagai Parquet.
08_proyek_penutup.py
# Bab 53 - Proyek bersambung A2 (penutup): deret waktu NDVI per blok kebun dari Zarr, simpan sebagai tabel Parquet
from pathlib import Path

import dask
import numpy as np
import polars as pl
import xarray as xr

tmp = Path(__file__).parent / "_tmp"
zarr_path = tmp / "ndvi_24bulan.zarr"                  # dibuat oleh skrip 05
if not zarr_path.exists():
    raise SystemExit("jalankan 05_xarray_dask.py dulu")

ds = xr.open_zarr(zarr_path, consolidated=False)
ndvi = ds["ndvi"]

# Empat blok kebun 256 x 256 piksel (jendela baris, kolom). Blok A adalah petak yang 'mengering'.
blok = {"A": (0, 0), "B": (0, 512), "C": (512, 0), "D": (512, 512)}
deret = {nama: ndvi.isel(y=slice(r, r + 256), x=slice(k, k + 256)).mean(dim=("y", "x")) for nama, (r, k) in blok.items()}

# Semua rata-rata dihitung SEKALI jalan: Dask membaca tiap chunk Zarr sekali saja
hasil = dict(zip(deret, dask.compute(*deret.values())))

baris = []
bulan = np.arange(24)
for nama, seri in hasil.items():
    nilai = seri.values.astype("float64")
    lereng = float(np.polyfit(bulan, nilai, 1)[0])          # perubahan NDVI per bulan
    baris.append({"blok": nama, "ndvi_awal": round(nilai[:3].mean(), 3), "ndvi_akhir": round(nilai[-3:].mean(), 3),
                  "lereng_per_bulan": round(lereng, 4), "menurun": lereng < 0})
tabel = pl.DataFrame(baris)
print(tabel)

tabel.write_parquet(tmp / "fitur_blok.parquet")
print("Tersimpan:", "fitur_blok.parquet", "| blok menurun:", tabel.filter(pl.col("menurun"))["blok"].to_list())
shape: (4, 5)
┌──────┬───────────┬────────────┬──────────────────┬─────────┐
│ blok ┆ ndvi_awal ┆ ndvi_akhir ┆ lereng_per_bulan ┆ menurun │
│ --- ┆ --- ┆ --- ┆ --- ┆ --- │
│ str ┆ f64 ┆ f64 ┆ f64 ┆ bool │
╞══════╪═══════════╪════════════╪══════════════════╪═════════╡
│ A ┆ 0.513 ┆ 0.093 ┆ -0.02 ┆ true │
│ B ┆ 0.251 ┆ 0.461 ┆ 0.01 ┆ false │
│ C ┆ 0.543 ┆ 0.753 ┆ 0.01 ┆ false │
│ D ┆ 0.251 ┆ 0.461 ┆ 0.01 ┆ false │
└──────┴───────────┴────────────┴──────────────────┴─────────┘
Tersimpan: fitur_blok.parquet | blok menurun: ['A']Blok A, yang sengaja dibuat “mengering”, turun dari NDVI 0,513 menjadi 0,093 dengan kemiringan -0,02 per bulan, dan ditandai menurun. Blok B, C, dan D naik 0,01 per bulan (selisih nilai awal antarblok berasal dari pola ruang tiruan). Hasil akhirnya sebuah tabel kecil (fitur_blok.parquet) yang berisi ringkasan siap pakai, jauh lebih mudah dikelola daripada 100 MB citra.
Latihan
- Pada
03_dask_array.py, ubah chunk menjadi(500, 500)dan(10000, 10000). Berapa jumlah chunk dan ukuran satu chunk pada masing-masing? Mana yang terlalu kecil atau terlalu besar menurut saran dokumentasi? - Pada
01_dask_dataframe.py, hitung juga nilai rata-rata per bulan (groupby("bulan")). Apakah rata-ratanya naik tiap bulan seperti yang dirancang pembuat data? - Ubah
08_proyek_penutup.pyagar menandai blok “menurun” bila lerengnya di bawah -0,005 (bukan di bawah 0). Apakah hasilnya berubah? - Tantangan: tulis fungsi per blok yang menghitung nilai minimum dan maksimum citra
citra_besar.tiftanpa memuat seluruh citra, lalu bandingkan dengansrc.read(1).min()dan.max().
Ringkasan Bab
- Data lebih besar dari memori diproses per potongan (chunk): baca, ringkas, buang, ulangi.
- Dask menyusun graf tugas malas;
compute()menjalankannya. DataFrame (banyak partisi) dan Array (banyak chunk) meniru pandas dan NumPy. - Ukuran chunk: cukup kecil agar banyak muat di memori, cukup besar agar tugas lebih lama dari sekitar 100 ms; pola chunk mengikuti pertanyaan Anda (rechunk bila perlu).
- xarray + Dask mengolah tumpukan citra multitemporal dari Zarr tanpa memuatnya utuh.
- Penjadwal:
synchronous(debug),threads(melepas GIL),processes(CPU berat); hasilnya harus sama. Di Windows, pakaiif __name__ == "__main__":. - Paralel butuh biaya: kirim data kecil, hitung banyak, ukur dulu, dan cocokkan dengan hasil serial.
Penutup Seri A2
Selamat! Anda telah menyelesaikan Seri A2. Anda sekarang bisa membangun alur data modern (Parquet, Polars, DuckDB, Prefect), membaca bumi dari jauh lewat format cloud-native (COG, GeoParquet, Zarr, STAC), mengolah LiDAR menjadi model tinggi tajuk, merancang sistem sensor lapangan yang tahan gangguan, dan memproses data yang tidak muat di memori dengan Dask.
Proyek bersambung A2 kini punya tiga kaki: gudang sensor kebun, kolam, dan kandang; citra yang tertata lewat katalog STAC menjadi COG dan Zarr, plus model tinggi tajuk dari LiDAR; dan tabel fitur per blok kebun yang diturunkan dari deret waktu NDVI.
Data besar sudah tersedia dan tertata. Seri A3 melatih model dari data itu: machine learning untuk sumber daya alam, dengan fitur seperti tabel fitur_blok tadi sebagai bahan latihannya.
Selanjutnya, di Bab 54: machine learning klasik dan model berbasis pohon: decision tree, random forest, dan gradient boosting, dilatih dari data tabel seperti fitur_blok.