%%{init: {"flowchart": {"diagramPadding": 40}}}%%
flowchart TD
A["Pertanyaan<br/>dan data"] --> B["Pilih bentuk model<br/>(garis, logistik, kurva, dinamis)"]
B --> C["Taksir parameter<br/>(OLS, curve_fit, solve_ivp)"]
C --> D["Periksa asumsi<br/>dan uji pada data baru"]
D -- "tidak masuk akal" --> B
D -- "lolos" --> E["Ketidakpastian dan<br/>sensitivitas"]
E --> F["Keputusan<br/>dan laporan"]
Bab 27 — Regresi dan Pemodelan Kuantitatif: Membuat Model dari Data
Seri I3 — Statistik dan Pemodelan
Semua skrip bab ini ada di folder kode/bab27/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Bab 26 menjawab “apakah dua kelompok berbeda?”. Bab ini menjawab pertanyaan yang lebih berguna: “Seberapa besar pengaruh X terhadap Y, dan apa ramalan Y bila X berubah?” Itulah regresi: menarik garis (atau lengkung) terbaik lewat sekumpulan titik, lalu memakainya untuk menjelaskan dan meramal. Bayangkan Anda menimbang sapi tiap bulan dan mencatat pakannya; regresi menyimpulkan “tiap tambahan 1 kg pakan harian rata-rata menambah sekian kg bobot”, lengkap dengan seberapa yakin Anda terhadap angka itu.
CatatanINGAT
Semua data di bab ini tiruan (fiktif) buatan skrip dengan benih tetap, dan sengaja dibuat dari aturan yang kita ketahui supaya kita bisa memeriksa apakah model menemukannya kembali. Jangan pakai angkanya sebagai anjuran budidaya, harga, atau pakan.
Regresi linear sederhana: persamaan alometrik pohon
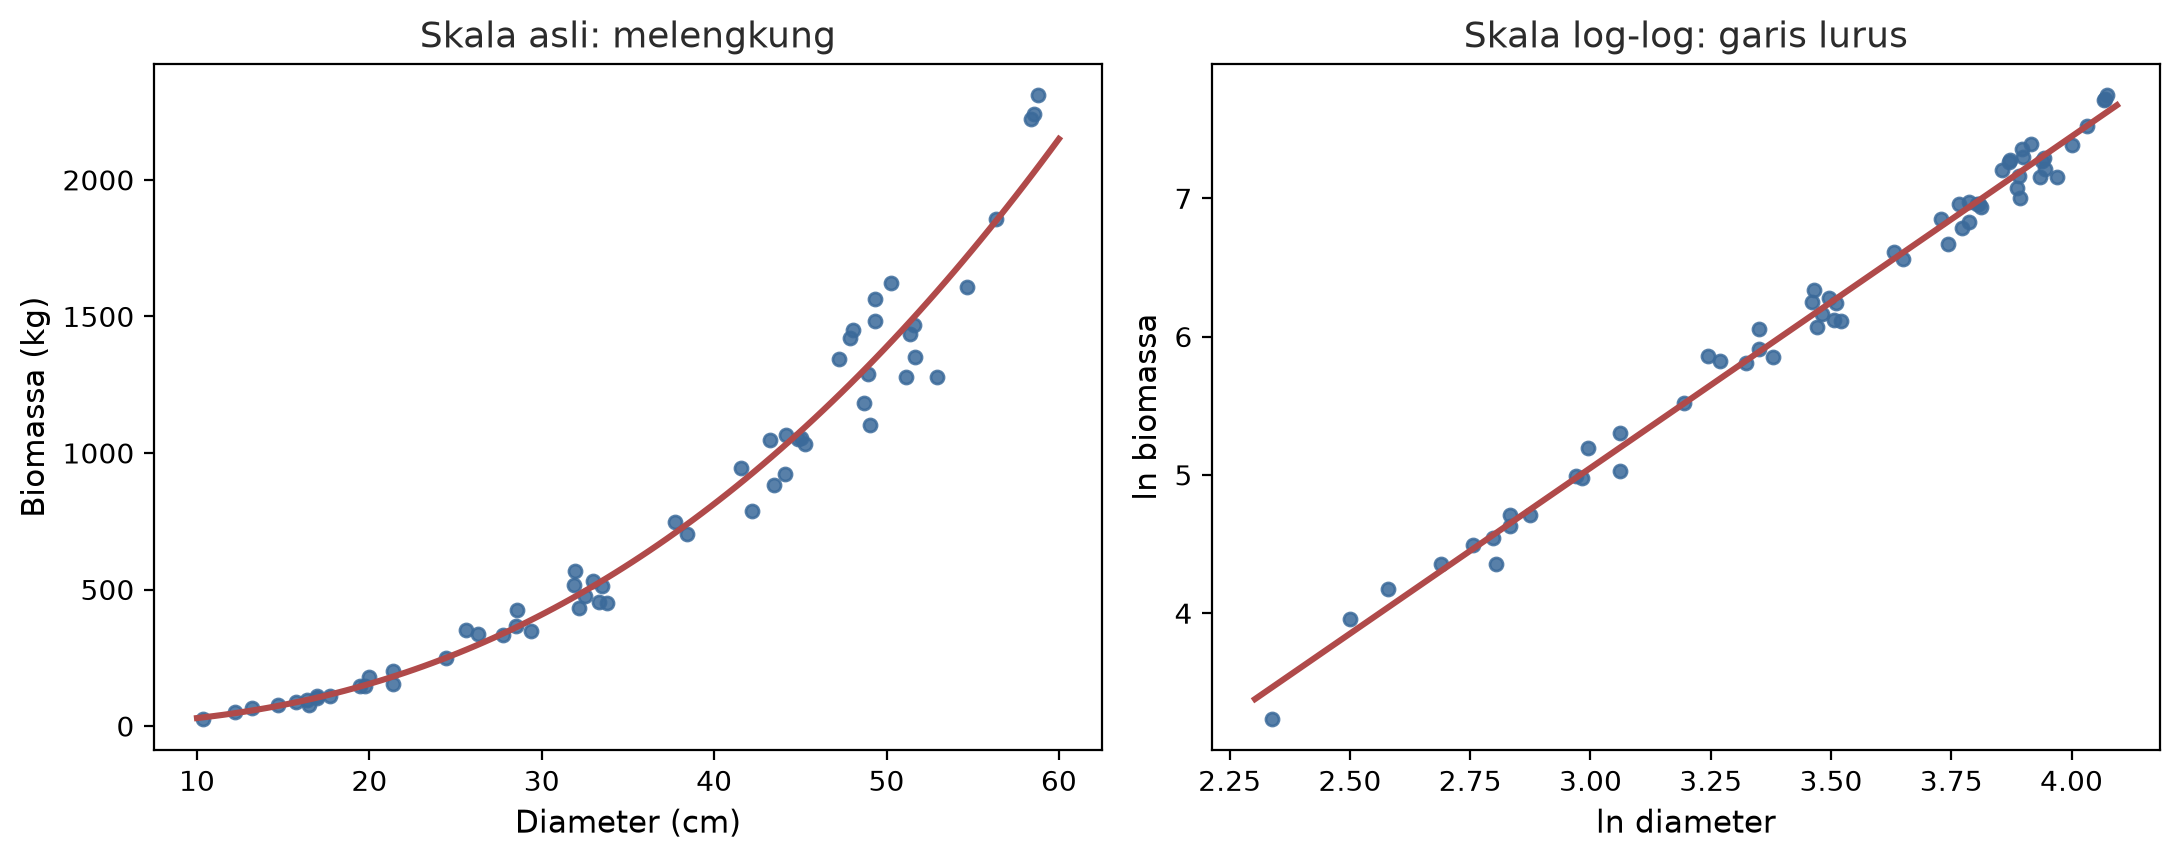
Menimbang biomassa pohon berarti menebangnya. Para rimbawan lebih suka mengukur diameter (mudah) lalu meramal biomassa lewat persamaan alometrik. Hubungannya melengkung (pohon dua kali lebih tebal jauh lebih dari dua kali lebih berat), tetapi bila kedua sisi di-log, hubungannya menjadi garis lurus: ln(biomassa) = a + b × ln(diameter).
01_ols_alometrik.py
# Bab 27 - Regresi linear sederhana: persamaan alometrik pohon
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 60
diameter = rng.uniform(10, 60, n)                                   # cm
biomassa = 0.12 * diameter ** 2.4 * np.exp(rng.normal(0, 0.15, n))  # kg (fiktif)
pohon = pd.DataFrame({"diameter_cm": diameter, "biomassa_kg": biomassa})
pohon["ln_d"] = np.log(pohon["diameter_cm"])
pohon["ln_b"] = np.log(pohon["biomassa_kg"])

# Hubungan asli melengkung; setelah dilog menjadi garis lurus
model = smf.ols("ln_b ~ ln_d", data=pohon).fit()
print(model.params.round(3))
print("R kuadrat       :", round(model.rsquared, 3))
print("Selang 95% ln_d :", model.conf_int().loc["ln_d"].round(3).tolist())
print("p-value ln_d    :", format(model.pvalues["ln_d"], ".1e"))

# Meramal biomassa pohon berdiameter 40 cm (kembalikan dari skala log)
a, b = model.params["Intercept"], model.params["ln_d"]
koreksi = np.exp(model.mse_resid / 2)        # koreksi bias hasil log
print()
print("Ramalan tanpa koreksi :", round(np.exp(a) * 40 ** b, 1), "kg")
print("Ramalan dengan koreksi:", round(np.exp(a) * 40 ** b * koreksi, 1), "kg")

# Bandingkan dengan garis lurus langsung pada skala asli
lurus = smf.ols("biomassa_kg ~ diameter_cm", data=pohon).fit()
print("R kuadrat garis lurus langsung:", round(lurus.rsquared, 3))
print("Ramalan garis lurus di 5 cm   :", round(lurus.predict(pd.DataFrame({"diameter_cm": [5]}))[0], 1), "kg (ngawur: bisa negatif)")
Intercept -2.140
ln_d 2.397
dtype: float64
R kuadrat : 0.99
Selang 95% ln_d : [2.333, 2.461]
p-value ln_d : 1.9e-59
Ramalan tanpa koreksi : 813.5 kg
Ramalan dengan koreksi: 818.8 kg
R kuadrat garis lurus langsung: 0.908
Ramalan garis lurus di 5 cm : -501.4 kg (ngawur: bisa negatif)- Rumus
"ln_b ~ ln_d"dibaca “ln_b dijelaskan oleh ln_d”.smf.ols(...).fit()mencari garis yang meminimalkan jumlah kuadrat selisih (metode kuadrat terkecil, ordinary least squares, OLS). - Kemiringan b = 2,397 dengan selang 95% 2,333 sampai 2,461. Kita menanam 2,4 di data, dan model menemukannya kembali. Bila diameter naik 1%, biomassa naik sekitar 2,4%.
- R kuadrat = 0,99: sekitar 99% keragaman ln(biomassa) dijelaskan oleh ln(diameter). R kuadrat tinggi bukan jaminan model benar; ia hanya menunjukkan kecocokan dengan data ini.
- Meramal kembali ke kilogram perlu
np.exp, dan karena rata-rata log tidak sama dengan log rata-rata, ada koreksi bias kecil: 813,5 kg tanpa koreksi, 818,8 kg dengan koreksi (faktorexp(sisaan / 2)). - Garis lurus langsung pada skala asli hanya mencapai R kuadrat 0,908 dan meramal -501,4 kg untuk pohon 5 cm: massa negatif. Pilihan bentuk model itu penting.
Regresi berganda dan diagnostik
Bobot ikan dipengaruhi banyak hal sekaligus. Regresi berganda menaruh beberapa penjelas dalam satu model; tiap koefisien berarti “pengaruh variabel itu bila yang lain ditahan tetap”.
02_ols_berganda.py
# Bab 27 - Regresi berganda dan diagnostik: pertumbuhan ikan terhadap pakan
import numpy as np
import pandas as pd
import statsmodels.api as sm
import statsmodels.formula.api as smf
from scipy import stats
from statsmodels.stats.diagnostic import het_breuschpagan
from statsmodels.stats.outliers_influence import variance_inflation_factor

rng = np.random.default_rng(42)
n = 80
pakan = rng.uniform(20, 60, n)                         # gram pakan per ikan per hari
suhu = rng.normal(28, 1.5, n)                          # derajat Celsius
padat = rng.uniform(10, 40, n)                         # ekor per m3
bobot = 50 + 6.0 * pakan + 12 * (suhu - 28) - 2.5 * padat + rng.normal(0, 25, n)
ikan = pd.DataFrame({"bobot_g": bobot, "pakan_g": pakan, "suhu_c": suhu, "padat": padat})

model = smf.ols("bobot_g ~ pakan_g + suhu_c + padat", data=ikan).fit()
print(model.summary().tables[1])
print("R kuadrat:", round(model.rsquared, 3), " R kuadrat disesuaikan:", round(model.rsquared_adj, 3))

# Diagnostik 1: apakah sisaan (residual) berdistribusi normal?
print()
print("Shapiro sisaan p      :", round(stats.shapiro(model.resid).pvalue, 3))
# Diagnostik 2: apakah ragam sisaan sama di semua tingkat? (homoskedastisitas)
print("Breusch-Pagan p       :", round(het_breuschpagan(model.resid, model.model.exog)[1], 3))

# Diagnostik 3: multikolinearitas (VIF). Tambahkan pakan "kembar" yang hampir sama
ikan["pakan_pelet_g"] = 0.9 * ikan["pakan_g"] + rng.normal(0, 1.5, n)
X = sm.add_constant(ikan[["pakan_g", "suhu_c", "padat", "pakan_pelet_g"]])
print()
for i, nama in enumerate(X.columns):
    if nama != "const":
        print(f"VIF {nama:14}: {variance_inflation_factor(X.values, i):6.1f}")
==============================================================================
coef std err t P>|t| [0.025 0.975]
------------------------------------------------------------------------------
Intercept -336.0406 61.612 -5.454 0.000 -458.751 -213.330
pakan_g 5.9493 0.282 21.133 0.000 5.389 6.510
suhu_c 13.8181 2.183 6.330 0.000 9.470 18.166
padat -2.4164 0.325 -7.436 0.000 -3.064 -1.769
==============================================================================
R kuadrat: 0.888 R kuadrat disesuaikan: 0.883
Shapiro sisaan p : 0.804
Breusch-Pagan p : 0.746
VIF pakan_g : 43.4
VIF suhu_c : 1.0
VIF padat : 1.0
VIF pakan_pelet_g : 43.4- Tabel koefisien: tiap gram pakan menambah bobot 5,95 g; tiap derajat suhu menambah 13,8 g; tiap tambahan ekor per m3 mengurangi 2,42 g. Nilai yang kita tanam: 6, 12, dan -2,5. Selang kepercayaan (dua kolom terakhir) dan p-value (
P>|t|) tersedia untuk tiap baris.0.000berarti di bawah 0,0005. - R kuadrat disesuaikan (0,883) menghukum penambahan variabel yang tidak berguna; pakai ini untuk membandingkan model dengan jumlah variabel berbeda.
- Diagnostik memeriksa apakah asumsi regresi masuk akal. (1) Sisaan (residual, selisih data dan model) sebaiknya mendekati normal: uji Shapiro p = 0,804, tidak ada tanda pelanggaran. (2) Ragam sisaan sebaiknya sama di semua tingkat (homoskedastisitas): uji Breusch-Pagan p = 0,746, aman. (3) Penjelas sebaiknya tidak terlalu kembar satu sama lain (multikolinearitas).
- VIF (variance inflation factor) mengukur itu. Kita tambah
pakan_pelet_gyang hampir kembar denganpakan_g, dan VIF keduanya melonjak ke 43,4 (aturan kasar: di atas 5 sampai 10 mengkhawatirkan), sedangkan suhu dan padat tetap 1,0. Akibatnya koefisien tiap kembaran menjadi tidak stabil. Obatnya: buang salah satu, gabungkan, atau pakai regularisasi (bagian berikut).
TipTIPS
Selalu gambar sisaan terhadap nilai ramalan. Pola lengkung berarti bentuk model salah; pola corong (melebar) berarti ragam tidak sama. Diagnostik bukan formalitas: model yang asumsinya patah memberi selang kepercayaan yang menyesatkan.
Regresi logistik: hasilnya ya atau tidak
Bila yang diramal hanya dua kemungkinan (pohon hidup atau mati, ternak sakit atau sehat), garis lurus akan meramal “peluang” di bawah 0 atau di atas 1. Regresi logistik meramal peluang (selalu antara 0 dan 1) lewat kurva S.
03_logistik.py
# Bab 27 - Regresi logistik: peluang pohon bertahan hidup
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 200
diameter = rng.uniform(5, 50, n)
plot = rng.choice(["A", "B", "C"], n)
logit = -2.5 + 0.12 * diameter + np.where(plot == "C", -0.8, 0)
hidup = rng.random(n) < 1 / (1 + np.exp(-logit))
pohon = pd.DataFrame({"hidup": hidup.astype(int), "diameter_cm": diameter, "plot": plot})

model = smf.logit("hidup ~ diameter_cm + C(plot)", data=pohon).fit(disp=False)
print(model.params.round(3))

# Koefisien ada dalam skala log-odds; ubah jadi rasio odds (odds ratio)
print()
print("Rasio odds (OR):")
print(np.exp(model.params).round(3))
print("Tiap tambahan 1 cm diameter mengalikan odds bertahan dengan", round(np.exp(model.params["diameter_cm"]), 3))

# Peluang untuk pohon baru
baru = pd.DataFrame({"diameter_cm": [10, 30], "plot": ["A", "A"]})
print()
print("Peluang bertahan (diameter 10 dan 30 cm, plot A):", model.predict(baru).round(3).tolist())

# Ketepatan dengan ambang 0,5
prediksi = (model.predict(pohon) >= 0.5).astype(int)
print("Ketepatan:", round((prediksi == pohon["hidup"]).mean(), 3))
print("Proporsi hidup sebenarnya:", round(pohon["hidup"].mean(), 3))
Intercept -2.385
C(plot)[T.B] -0.084
C(plot)[T.C] -0.487
diameter_cm 0.107
dtype: float64
Rasio odds (OR):
Intercept 0.092
C(plot)[T.B] 0.919
C(plot)[T.C] 0.614
diameter_cm 1.113
dtype: float64
Tiap tambahan 1 cm diameter mengalikan odds bertahan dengan 1.113
Peluang bertahan (diameter 10 dan 30 cm, plot A): [0.211, 0.693]
Ketepatan: 0.77
Proporsi hidup sebenarnya: 0.555- Koefisien ada di skala log-odds, sulit dibaca langsung.
np.exp(koefisien)mengubahnya menjadi rasio odds (OR): tiap tambahan 1 cm diameter mengalikan odds bertahan hidup dengan 1,113 (naik sekitar 11%). Plot C punya OR 0,614: odds bertahan lebih rendah, sesuai yang kita tanam. - Odds = peluang / (1 - peluang). Peluang 0,5 sama dengan odds 1. Odds dan peluang bukan hal yang sama, jadi jangan menyebut “11% lebih mungkin” untuk peluang.
predictmemberi peluang: pohon 10 cm di plot A sekitar 0,211 dan 30 cm sekitar 0,693.- Dengan ambang 0,5, ketepatan 0,77, lebih baik dari menebak “semua hidup” (proporsi hidup sebenarnya 0,555). Untuk kasus tak seimbang (penyakit langka), ketepatan saja menyesatkan; periksa juga presisi dan recall di Seri A3.
GLM: data cacah dengan Poisson
Jumlah buah per pohon, jumlah telur, atau jumlah pohon tumbang adalah bilangan bulat tak negatif. GLM (generalized linear model) memperluas regresi ke keluarga sebaran lain. Untuk cacahan, keluarga Poisson dengan tautan log dipakai.
04_glm_poisson.py
# Bab 27 - GLM Poisson untuk data cacah: jumlah buah per pohon
import numpy as np
import pandas as pd
import statsmodels.api as sm
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
n = 150
diameter = rng.uniform(10, 50, n)
mu = np.exp(0.5 + 0.06 * diameter)
rata = mu * rng.gamma(shape=4, scale=0.25, size=n)   # keragaman ekstra antarpohon
buah = rng.poisson(rata)
data = pd.DataFrame({"buah": buah, "diameter_cm": diameter})

poisson = smf.glm("buah ~ diameter_cm", data=data, family=sm.families.Poisson()).fit()
print(poisson.params.round(4))
print("Rasio laju (IRR) per cm:", round(np.exp(poisson.params["diameter_cm"]), 4))

# Periksa overdispersion: bagi chi-kuadrat Pearson dengan derajat bebas; idealnya sekitar 1
dispersi = poisson.pearson_chi2 / poisson.df_resid
print("Dispersi:", round(dispersi, 2), "(jauh di atas 1 berarti Poisson terlalu optimis)")

# Alternatif: binomial negatif, yang menaksir sendiri keragaman ekstra (alpha)
nb = smf.negativebinomial("buah ~ diameter_cm", data=data).fit(disp=False)
print()
print("Binomial negatif, alpha  :", round(nb.params["alpha"], 3))
print("SE diameter Poisson      :", round(poisson.bse["diameter_cm"], 5))
print("SE diameter binom. negatif:", round(nb.bse["diameter_cm"], 5))
Intercept 0.6400
diameter_cm 0.0577
dtype: float64
Rasio laju (IRR) per cm: 1.0594
Dispersi: 4.64 (jauh di atas 1 berarti Poisson terlalu optimis)
Binomial negatif, alpha : 0.267
SE diameter Poisson : 0.00234
SE diameter binom. negatif: 0.00477exp(0,0577)= 1,0594: tiap tambahan 1 cm diameter menaikkan jumlah buah rata-rata sekitar 5,9% (rasio laju, IRR).- Poisson mengandaikan ragam = rata-rata. Data nyata sering lebih beragam (overdispersion). Ukurannya: chi-kuadrat Pearson dibagi derajat bebas. Di sini 4,64, jauh di atas 1. Akibatnya galat baku Poisson terlalu kecil dan kesimpulan terlalu percaya diri.
- Binomial negatif menaksir keragaman ekstra sendiri (
alpha= 0,267). Galat baku diameter menjadi 0,00477, hampir dua kali lipat 0,00234 dari Poisson. Itulah harga kejujuran.
Ridge dan Lasso: bila penjelas banyak dan saling mirip
Dengan banyak penjelas yang saling berkaitan, OLS menaksir koefisien yang liar (positif di satu tempat, negatif di tempat lain) dan overfit: bagus pada data latih, jelek pada data baru. Regularisasi menambahkan “denda” untuk koefisien besar. Ridge menyusutkan semua koefisien; Lasso menyusutkan dan bisa menolkan sebagian, sehingga sekaligus memilih variabel.
05_ridge_lasso.py
# Bab 27 - Regularisasi (Ridge dan Lasso): bobot sapi dari banyak ukuran badan
import numpy as np
from sklearn.linear_model import LassoCV, LinearRegression, RidgeCV
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

rng = np.random.default_rng(42)
n, p = 90, 10
dasar = rng.normal(size=(n, 1))
# 10 pengukuran yang saling berkaitan erat; hanya 3 yang benar-benar berpengaruh
X = dasar + rng.normal(0, 0.5, size=(n, p))
koef_sebenarnya = np.array([30, 20, 10, 0, 0, 0, 0, 0, 0, 0])
bobot = 350 + X @ koef_sebenarnya / 3 + rng.normal(0, 15, n)   # kg (fiktif)

X_latih, X_uji, y_latih, y_uji = train_test_split(X, bobot, test_size=0.3, random_state=42)

model = {
    "OLS biasa": make_pipeline(StandardScaler(), LinearRegression()),
    "Ridge": make_pipeline(StandardScaler(), RidgeCV(alphas=np.logspace(-2, 3, 30))),
    "Lasso": make_pipeline(StandardScaler(), LassoCV(cv=5, random_state=42)),
}
for nama, m in model.items():
    m.fit(X_latih, y_latih)
    koef = m[-1].coef_
    print(f"{nama:10} R2 uji = {m.score(X_uji, y_uji):.3f}   koefisien nol: {int((np.abs(koef) < 1e-9).sum())} dari {p}")
    print("           ", np.round(koef, 1) + 0.0)
OLS biasa R2 uji = 0.680 koefisien nol: 0 dari 10
[12.9 0.5 -4.8 6.5 -1.8 -0.4 3.6 2. 2.5 -0.4]
Ridge R2 uji = 0.754 koefisien nol: 0 dari 10
[ 8.5 2.2 -2. 4.3 -1.1 0.6 2.5 2.1 2.5 0.6]
Lasso R2 uji = 0.724 koefisien nol: 5 dari 10
[12.2 0. 0. 3.2 0. 0. 1.5 0.7 1.9 0. ]Kita memisahkan 30% data sebagai data uji yang tidak dilihat model saat belajar. R kuadrat pada data uji: OLS 0,680, Lasso 0,724, Ridge 0,754. Koefisien OLS acak-acakan (12,9, 0,5, -4,8, …), Ridge lebih tenang, dan Lasso menolkan 5 dari 10. Skala penjelas diseragamkan lebih dulu (StandardScaler) karena denda bergantung pada skala. Besar denda dipilih otomatis oleh validasi silang (RidgeCV, LassoCV).
PeringatanAWAS
Skor di data latih selalu terlalu bagus. Nilai model hanya jujur bila diuji pada data yang tidak dipakai menyusunnya. Prinsip ini dipakai terus di Seri A3.
Regresi non-linear: kurva pertumbuhan
Ikan tidak tumbuh lurus selamanya; ia mendekati panjang maksimum. Kurva von Bertalanffy menggambarkannya: L(t) = Lmaks × (1 - e^(-k (t - t0))). Parameternya bukan koefisien linear, jadi kita pakai curve_fit yang mencari nilai terbaik secara bertahap, dimulai dari tebakan awal p0.
06_nonlinear.py
# Bab 27 - Regresi non-linear: kurva pertumbuhan ikan (von Bertalanffy)
import numpy as np
from scipy.optimize import curve_fit


def panjang(umur, l_maks, k, t0):
    """Panjang ikan (cm) pada umur tertentu (bulan)."""
    return l_maks * (1 - np.exp(-k * (umur - t0)))


rng = np.random.default_rng(42)
umur = np.linspace(1, 24, 30)
nyata = panjang(umur, l_maks=45, k=0.15, t0=-0.5)
ukur = nyata + rng.normal(0, 1.2, umur.size)       # panjang terukur dengan galat

taksiran, kovarians = curve_fit(panjang, umur, ukur, p0=[40, 0.1, 0])
galat = np.sqrt(np.diag(kovarians))
for nama, nilai, se in zip(["l_maks", "k", "t0"], taksiran, galat):
    print(f"{nama:7} = {nilai:7.3f}  (galat baku {se:.3f})")

sisa = ukur - panjang(umur, *taksiran)
print("Akar rata-rata kuadrat sisaan:", round(float(np.sqrt((sisa ** 2).mean())), 3), "cm")
print("Panjang ramalan umur 12 bulan:", round(float(panjang(12, *taksiran)), 1), "cm")
print("Panjang ramalan umur 36 bulan:", round(float(panjang(36, *taksiran)), 1), "cm (mendekati l_maks)")
l_maks = 45.405 (galat baku 0.521)
k = 0.146 (galat baku 0.007)
t0 = -0.484 (galat baku 0.165)
Akar rata-rata kuadrat sisaan: 0.899 cm
Panjang ramalan umur 12 bulan: 38.1 cm
Panjang ramalan umur 36 bulan: 45.2 cm (mendekati l_maks)Taksiran: Lmaks = 45,405 cm (galat baku 0,521), k = 0,146 per bulan (0,007), t0 = -0,484. Nilai yang kita tanam: 45, 0,15, dan -0,5, jadi ketiganya ditemukan kembali dalam kisaran galat baku. Ramalan umur 36 bulan (45,2 cm) mendekati Lmaks: kurva melandai. Galat baku berasal dari matriks kovarians yang dikembalikan curve_fit.
PeringatanAWAS
Kurva non-linear bisa sangat peka pada tebakan awal p0 dan bisa gagal konvergen. Gambar kurva di atas datanya sebelum percaya. Jangan meramal jauh di luar rentang data (ekstrapolasi): model hanya tahu apa yang pernah dilihatnya.
Model efek campuran: data berkelompok
Sapi di kandang yang sama tidak independen: mereka berbagi pakan, kebersihan, dan pengurus. Memperlakukan semuanya seolah independen (OLS biasa) menipu galat baku. Model efek campuran (mixed-effects) menambahkan efek acak per kelompok (kandang) di samping efek tetap yang ingin diketahui (pakan).
07_mixed_effects.py
# Bab 27 - Model efek campuran (mixed-effects): sapi di banyak kandang
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
baris = []
for kandang in range(1, 9):
    efek_kandang = rng.normal(0, 12)            # tiap kandang punya "nasib" sendiri
    for _ in range(10):
        pakan = rng.uniform(8, 14)              # kg pakan per hari
        tambah = 20 + 6 * pakan + efek_kandang + rng.normal(0, 8)
        baris.append({"kandang": f"K{kandang}", "pakan_kg": pakan, "tambah_bobot_kg": tambah})
sapi = pd.DataFrame(baris)

biasa = smf.ols("tambah_bobot_kg ~ pakan_kg", data=sapi).fit()
campuran = smf.mixedlm("tambah_bobot_kg ~ pakan_kg", data=sapi, groups=sapi["kandang"]).fit()

print("OLS biasa     : koef pakan =", round(biasa.params["pakan_kg"], 3), " galat baku =", round(biasa.bse["pakan_kg"], 3))
print("Efek campuran : koef pakan =", round(campuran.params["pakan_kg"], 3), " galat baku =", round(campuran.bse["pakan_kg"], 3))

ragam_kandang = float(campuran.cov_re.iloc[0, 0])
ragam_sisa = float(campuran.scale)
print("Ragam antar-kandang :", round(ragam_kandang, 1))
print("Ragam sisa          :", round(ragam_sisa, 1))
print("ICC (porsi keragaman karena kandang):", round(ragam_kandang / (ragam_kandang + ragam_sisa), 3))
print()
print("Efek acak per kandang (selisih dari rata-rata):")
print(pd.Series({k: round(float(v.iloc[0]), 1) for k, v in campuran.random_effects.items()}).to_string())
OLS biasa : koef pakan = 5.131 galat baku = 0.772
Efek campuran : koef pakan = 5.635 galat baku = 0.476
Ragam antar-kandang : 103.0
Ragam sisa : 47.9
ICC (porsi keragaman karena kandang): 0.683
Efek acak per kandang (selisih dari rata-rata):
K1 6.5
K2 -5.7
K3 -8.0
K4 7.5
K5 -14.9
K6 -2.6
K7 16.3
K8 1.0- OLS biasa menaksir pengaruh pakan 5,131 (galat baku 0,772); model campuran 5,635 (0,476). Nilai yang kita tanam 6. Model campuran memisahkan “nasib kandang” dari kebisingan, sehingga lebih tepat.
- Ragam antar-kandang 103,0 dan ragam sisa 47,9. ICC (intraclass correlation) = 103,0 / (103,0 + 47,9) = 0,683: sekitar 68% keragaman pertambahan bobot berasal dari perbedaan kandang. Ini besar: mengabaikan kandang adalah kesalahan serius.
- Efek acak per kandang menunjukkan K7 (+16,3) paling beruntung dan K5 (-14,9) paling merugi, relatif terhadap rata-rata.
Model campuran adalah alat standar untuk plot bersarang di hutan, kolam dalam tambak, atau pengukuran berulang pada pohon yang sama.
Deret waktu dan peramalan dengan ARIMA
Data yang diukur berurutan dalam waktu (curah hujan bulanan) punya ingatan: nilai bulan ini mirip bulan lalu, dan ada pola musiman. ARIMA memodelkan itu lewat tiga bagian: AR (nilai lalu menjelaskan nilai sekarang), I (selisih untuk meratakan tren), MA (galat lalu ikut berpengaruh). seasonal_order=(P, D, Q, 12) menambahkan pola berulang tiap 12 bulan.
08_arima.py
# Bab 27 - Deret waktu dan peramalan dengan ARIMA: curah hujan bulanan
import numpy as np
import pandas as pd
from statsmodels.tsa.arima.model import ARIMA

rng = np.random.default_rng(42)
bulan = pd.period_range("2019-01", periods=72, freq="M")
musim = 120 + 70 * np.cos(2 * np.pi * (np.arange(72) - 1) / 12)       # pola tahunan
hujan = pd.Series(musim + rng.normal(0, 18, 72), index=bulan).clip(lower=0).round(1)  # mm (fiktif)

latih, uji = hujan[:60], hujan[60:]          # simpan 12 bulan terakhir untuk menguji ramalan

model = ARIMA(latih, order=(1, 0, 0), seasonal_order=(1, 1, 0, 12)).fit()
ramalan = model.forecast(steps=12)

mae = (uji - ramalan).abs().mean()
# Pembanding sederhana: "bulan ini sama dengan bulan yang sama tahun lalu"
naif = pd.Series(latih.values[-12:], index=uji.index)
mae_naif = (uji - naif).abs().mean()
print("MAE ramalan ARIMA musiman  :", round(mae, 1), "mm")
print("MAE pembanding naif musiman:", round(mae_naif, 1), "mm")
print()
print(pd.DataFrame({"sebenarnya": uji, "ramalan": ramalan.round(1)}).head(6))
MAE ramalan ARIMA musiman : 15.0 mm
MAE pembanding naif musiman: 17.8 mm
sebenarnya ramalan
2024-01 150.3 187.5
2024-02 184.0 185.1
2024-03 183.6 178.4
2024-04 165.6 166.5
2024-05 132.8 108.5
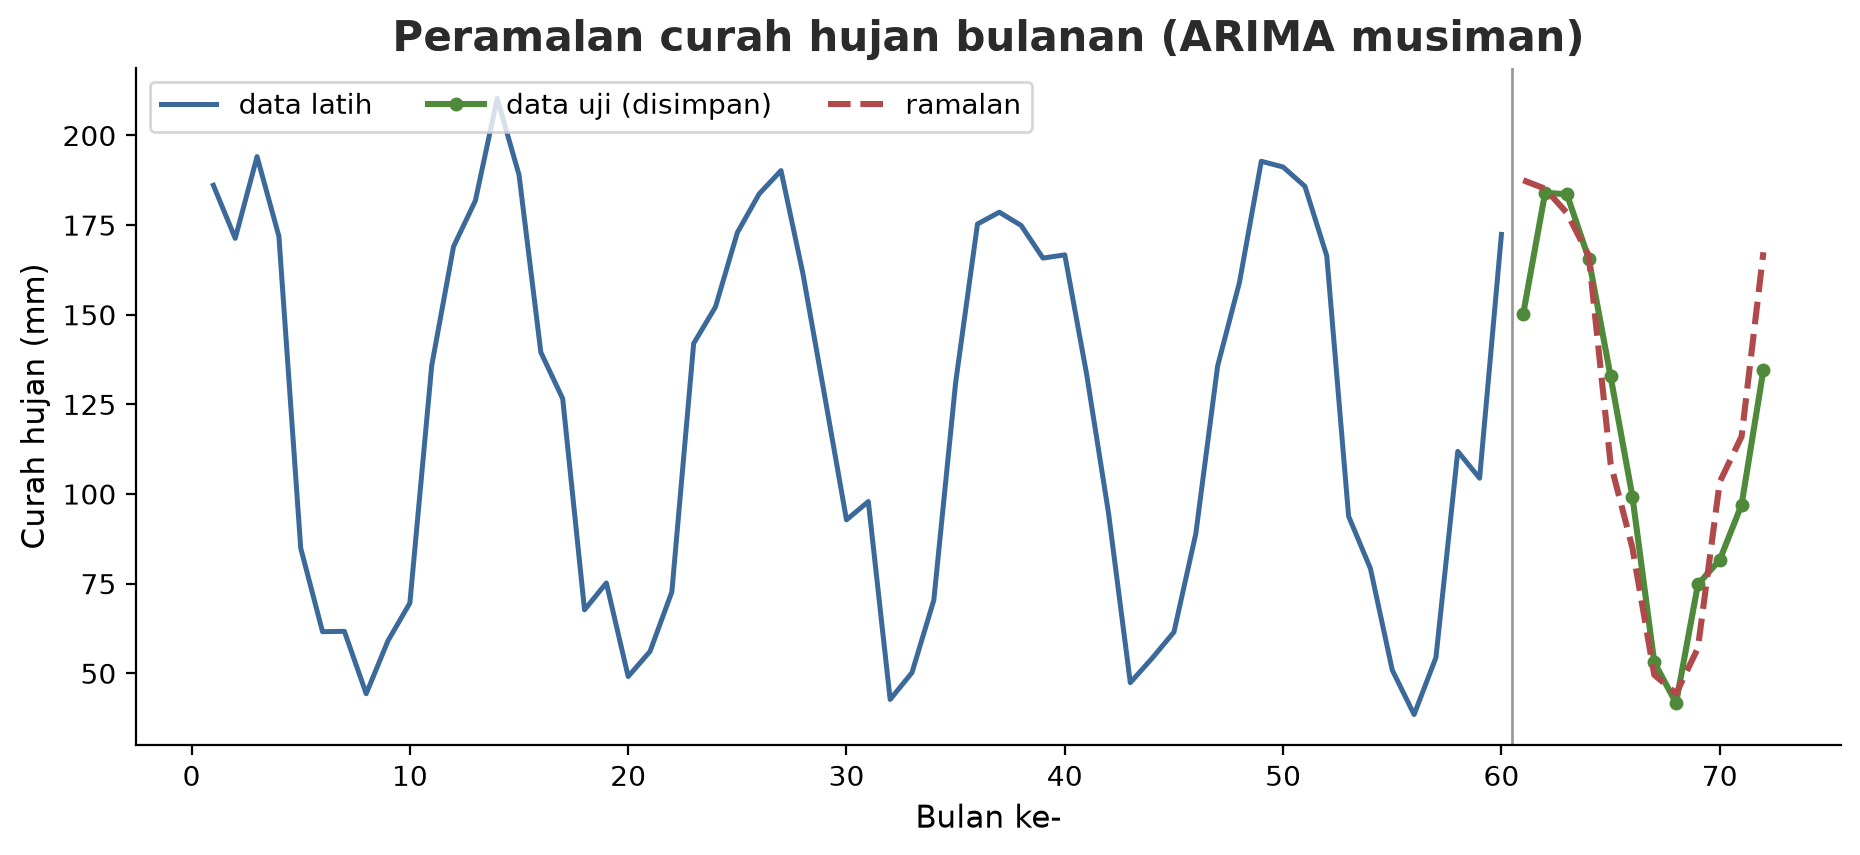
2024-06 99.3 85.0- Kita menyimpan 12 bulan terakhir sebagai ujian dan meramalnya dari 60 bulan sebelumnya. Itu cara jujur menguji peramalan.
- Pembanding sederhana (“bulan ini = bulan sama tahun lalu”) rata-rata meleset 17,8 mm; ARIMA musiman 15,0 mm. Model yang rumit harus selalu dibandingkan dengan pembanding sederhana; bila tidak menang jauh, pakai yang sederhana.
- Tabel menunjukkan enam bulan pertama: ramalan dekat pada musim, tetapi tidak menangkap kebisingan acak tiap bulan (Januari: 187,5 vs 150,3 sebenarnya). Peramalan memberi pola, bukan kepastian.
Regresi spasial: GWR
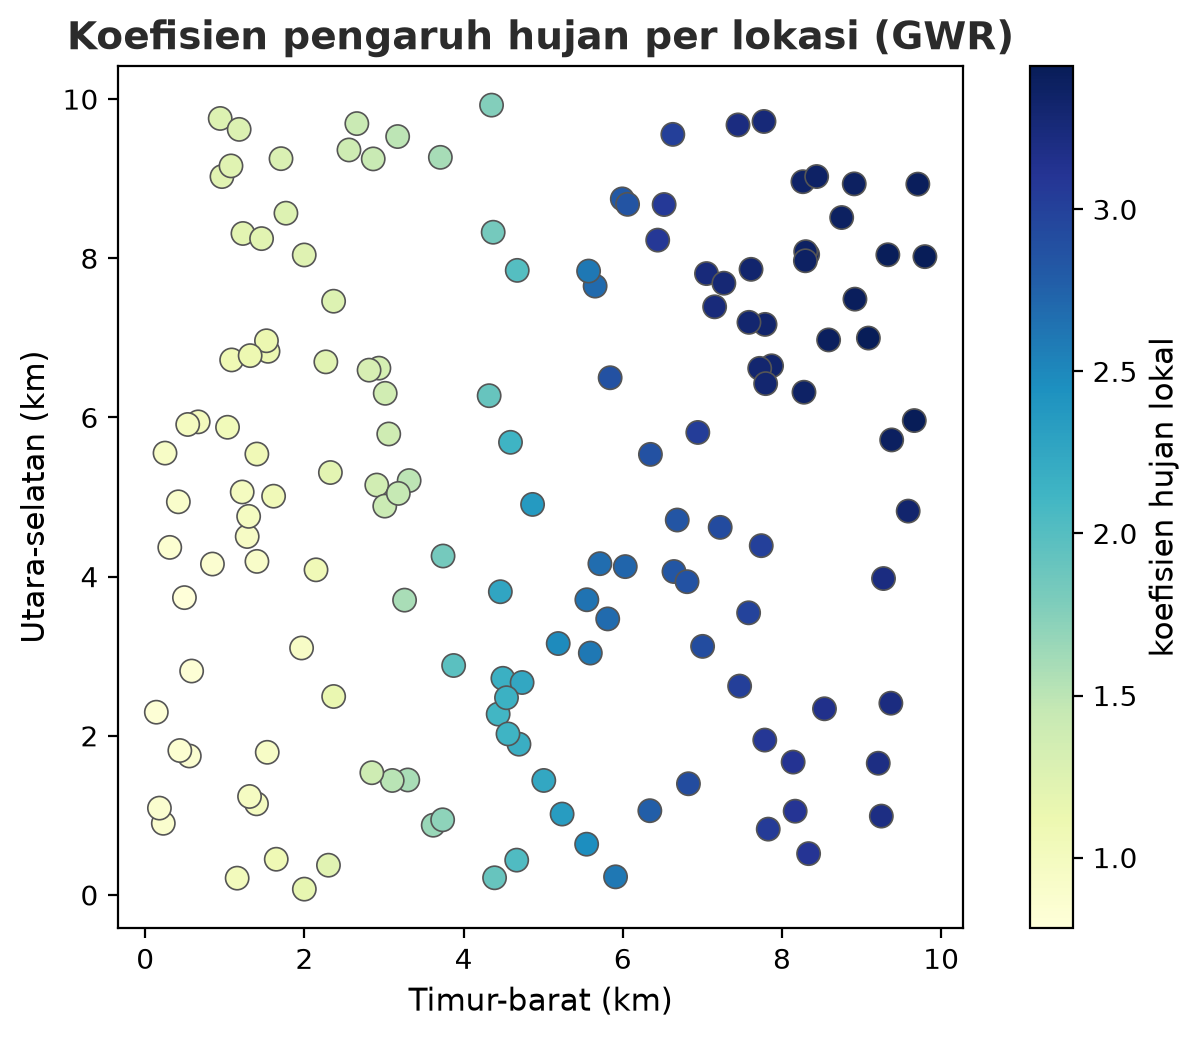
Regresi biasa memberi satu koefisien untuk seluruh wilayah. Padahal pengaruh hujan terhadap hasil panen bisa berbeda di lereng barat dan timur. GWR (geographically weighted regression) menjalankan banyak regresi lokal, tiap lokasi dengan koefisien sendiri, menimbang tetangga dekat lebih berat. Pustaka mgwr mengerjakannya.
09_gwr.py
# Bab 27 - Regresi spasial: GWR (geographically weighted regression) dengan mgwr
import numpy as np
import statsmodels.api as sm
from mgwr.gwr import GWR
from mgwr.sel_bw import Sel_BW

rng = np.random.default_rng(42)
n = 150
# Koordinat 150 petak kebun di area 10 x 10 km (fiktif)
koordinat = rng.uniform(0, 10, size=(n, 2))
hujan = rng.normal(0, 1, size=(n, 1))                  # curah hujan terstandar
# Pengaruh hujan menguat dari barat (x = 0) ke timur (x = 10)
pengaruh = 0.5 + 0.35 * koordinat[:, [0]]
panen = 5 + pengaruh * hujan + rng.normal(0, 0.4, size=(n, 1))   # ton/ha (fiktif)

# Model global: satu koefisien untuk seluruh area
global_ols = sm.OLS(panen, sm.add_constant(hujan)).fit()
print("OLS global: koefisien hujan =", round(float(global_ols.params[1]), 3), " R2 =", round(float(global_ols.rsquared), 3))

# GWR: koefisien berbeda di tiap lokasi
lebar = Sel_BW(koordinat, panen, hujan).search()
hasil = GWR(koordinat, panen, hujan, lebar).fit()
lokal = hasil.params[:, 1]
print("Lebar jendela terpilih (jumlah tetangga):", int(lebar))
print("GWR: R2 =", round(float(hasil.R2), 3))
print("Koefisien hujan lokal: min =", round(float(lokal.min()), 2), " maks =", round(float(lokal.max()), 2))

barat = koordinat[:, 0] < 3
timur = koordinat[:, 0] > 7
print("Rata-rata koefisien di barat (x < 3):", round(float(lokal[barat].mean()), 2))
print("Rata-rata koefisien di timur (x > 7):", round(float(lokal[timur].mean()), 2))
print("Pengaruh sebenarnya di barat/timur :", round(float(pengaruh[barat].mean()), 2), "/", round(float(pengaruh[timur].mean()), 2))
OLS global: koefisien hujan = 2.176 R2 = 0.788
Lebar jendela terpilih (jumlah tetangga): 46
GWR: R2 = 0.97
Koefisien hujan lokal: min = 0.78 maks = 3.44
Rata-rata koefisien di barat (x < 3): 1.09
Rata-rata koefisien di timur (x > 7): 3.26
Pengaruh sebenarnya di barat/timur : 1.01 / 3.41- Skrip ini memakai
mgwr, pustaka tambahan di luar paket dasar bab ini; pasang denganpip install mgwr(ia ikut membawalibpysal,spreg, danspglm). Di komputer penulis, pustaka itu tersedia sebagai paket jadi untuk Python 3.14 dan skrip ini dijalankan sungguhan. - OLS global menaksir satu koefisien hujan 2,176 (R kuadrat 0,788). GWR menemukan koefisien lokal dari 0,78 sampai 3,44: lemah di barat (rata-rata 1,09) dan kuat di timur (3,26), mendekati nilai yang kita tanam (1,01 dan 3,41). Satu angka global menyembunyikan pola ini.
Sel_BWmemilih lebar jendela (di sini 46 tetangga terdekat) lewat pencarian otomatis. Jendela sempit = sangat lokal tetapi berisik; lebar = mulus tetapi kurang peka.- Hati-hati: R kuadrat GWR 0,97 dihitung pada data yang sama dengan yang dipakai menaksir, dan GWR jauh lebih fleksibel dari OLS, jadi angka itu tidak boleh dibandingkan begitu saja dengan 0,788. Gunakan kriteria seperti AICc atau data uji. Koordinat di sini fiktif; data peta sungguhan dan proyeksinya dibahas di seri geospasial.
Simulasi Monte Carlo: menghitung ketidakpastian
Hasil, harga, dan biaya tidak pasti. Alih-alih satu angka laba, kita mengundi nilai masukan ratusan ribu kali dari sebaran yang masuk akal, menghitung laba tiap kali, dan melihat sebaran labanya. Ini Monte Carlo (dinamai kasino, karena “mengundi”).
10_monte_carlo.py
# Bab 27 - Simulasi Monte Carlo: ketidakpastian pendapatan panen jagung
import numpy as np

rng = np.random.default_rng(42)
N = 100_000
luas_ha = 2.0

# Tiap masukan tidak pasti, jadi kita undi dari sebaran yang masuk akal (angka contoh fiktif)
hasil_ton_ha = rng.triangular(left=3.0, mode=5.0, right=6.5, size=N)   # hasil panen
harga_rp_kg = rng.normal(loc=5000, scale=700, size=N)                  # harga jual
biaya_rp = rng.normal(loc=40_000_000, scale=3_000_000, size=N)         # biaya total

pendapatan = hasil_ton_ha * 1000 * luas_ha * harga_rp_kg
laba = pendapatan - biaya_rp

print("Rata-rata laba (juta Rp):", round(laba.mean() / 1e6, 2))
print("Simpangan baku (juta Rp):", round(laba.std() / 1e6, 2))
print("Selang 90% laba (juta Rp):", np.percentile(laba, [5, 95]).round(-4) / 1e6)
print("Peluang rugi             :", round(float((laba < 0).mean()), 3))

# Berapa banyak undian yang cukup? Bandingkan beberapa ukuran
for n in (100, 1000, 100_000):
    print(f"  taksiran peluang rugi dari {n:>7} undian:", round(float((laba[:n] < 0).mean()), 3))
Rata-rata laba (juta Rp): 8.36
Simpangan baku (juta Rp): 10.34
Selang 90% laba (juta Rp): [-8.03 25.96]
Peluang rugi : 0.216
taksiran peluang rugi dari 100 undian: 0.21
taksiran peluang rugi dari 1000 undian: 0.224
taksiran peluang rugi dari 100000 undian: 0.216Rata-rata laba 8,36 juta rupiah, tetapi simpangan bakunya 10,34 juta: ketidakpastiannya besar. Selang 90% laba: dari -8,03 sampai 25,96 juta. Peluang rugi 21,6%. Satu angka rata-rata menyembunyikan risiko ini. Tiga baris terakhir menunjukkan taksiran peluang rugi stabil di sekitar 0,2 setelah ribuan undian; 100 undian terlalu sedikit untuk angka yang rapi. Semua angka (hasil, harga, biaya) adalah contoh fiktif, bukan harga atau anjuran sebenarnya.
Optimisasi: mencari pilihan terbaik
scipy.optimize menyelesaikan dua jenis soal umum. Pemrograman linear (linprog): minimalkan biaya dengan syarat berupa persamaan dan pertidaksamaan lurus. Optimisasi satu variabel (minimize_scalar): cari titik tertinggi atau terendah suatu fungsi.
11_optimisasi.py
# Bab 27 - Optimisasi dengan scipy.optimize: ramuan pakan termurah
from scipy.optimize import linprog, minimize_scalar

# Dua bahan: jagung (Rp 5.000/kg, protein 8%) dan bungkil kedelai (Rp 9.000/kg, protein 44%)
# Kebutuhan: 100 kg ramuan dengan protein paling sedikit 18%. Angka contoh fiktif.
biaya = [5000, 9000]
# linprog meminta bentuk "kurang dari": -(protein) <= -(kebutuhan)
batas_protein_a = [[-0.08, -0.44]]
batas_protein_b = [-0.18 * 100]
total_a = [[1, 1]]
total_b = [100]

hasil = linprog(biaya, A_ub=batas_protein_a, b_ub=batas_protein_b,
                A_eq=total_a, b_eq=total_b, bounds=[(0, None), (0, None)])
print("Berhasil?   :", hasil.success)
print("Jagung (kg) :", round(hasil.x[0], 2))
print("Kedelai (kg):", round(hasil.x[1], 2))
print("Biaya (Rp)  :", round(hasil.fun))

# Optimisasi satu variabel: padat tebar ikan yang memaksimalkan laba (model fiktif)
def laba_negatif(padat):
    bobot_akhir = 900 * (1 - padat / 120)          # bobot makin kecil bila terlalu padat
    return -(padat * bobot_akhir / 1000 * 25000 - padat * 800)

cari = minimize_scalar(laba_negatif, bounds=(1, 100), method="bounded")
print()
print("Padat tebar terbaik (ekor/m2):", round(cari.x, 1))
print("Laba maksimum (Rp/m2)        :", round(-cari.fun))
Berhasil? : True
Jagung (kg) : 72.22
Kedelai (kg): 27.78
Biaya (Rp) : 611111
Padat tebar terbaik (ekor/m2): 57.9
Laba maksimum (Rp/m2) : 627853- Ramuan pakan 100 kg dengan protein paling sedikit 18% memakai 72,22 kg jagung dan 27,78 kg bungkil kedelai, biaya Rp 611.111. Bungkil kedelai lebih mahal tetapi kaya protein; mesin menemukan campuran termurah yang memenuhi syarat.
linproghanya menerima bentuk “kurang dari atau sama dengan”, sehingga syarat “protein minimal” ditulis dengan tanda minus. - Soal kedua: padat tebar yang memaksimalkan laba adalah 57,9 ekor/m2. Terlalu jarang memboroskan kolam; terlalu padat mengerdilkan ikan. Optimum ada di tengah. Modelnya sengaja sederhana dan fiktif.
Model sistem dinamis dan analisis sensitivitas
Sistem yang berubah terhadap waktu (stok ikan, tegakan hutan) sering ditulis sebagai persamaan laju perubahan. Model logistik menyatakan stok tumbuh sebesar r × stok × (1 - stok / K) (K = daya dukung), dikurangi panen. solve_ivp menghitung perjalanannya langkah demi langkah.
12_sistem_dinamis.py
# Bab 27 - Sistem dinamis dan analisis sensitivitas: stok ikan di waduk kecil
import numpy as np
from scipy.integrate import solve_ivp


def stok_akhir(r=0.8, K=1000.0, panen=100.0, awal=300.0, tahun=10):
    """Populasi logistik dengan panen tetap per tahun (ton, angka fiktif)."""
    def laju(t, y):
        return [r * y[0] * (1 - y[0] / K) - panen]
    punah = lambda t, y: y[0]       # peristiwa: stok menyentuh nol
    punah.terminal = True
    sol = solve_ivp(laju, (0, tahun), [awal], events=punah, t_eval=[tahun])
    return 0.0 if sol.status == 1 else float(sol.y[0, -1])


dasar = stok_akhir()
print("Stok setelah 10 tahun (kasus dasar):", round(dasar, 1), "ton")

# Analisis sensitivitas satu-per-satu: ubah tiap parameter +-20%
print()
print(f"{'parameter':10} {'-20%':>8} {'+20%':>8} {'rentang':>9}")
for nama in ("r", "K", "panen", "awal"):
    nilai = dict(r=0.8, K=1000.0, panen=100.0, awal=300.0)
    bawah = stok_akhir(**{**nilai, nama: nilai[nama] * 0.8})
    atas = stok_akhir(**{**nilai, nama: nilai[nama] * 1.2})
    print(f"{nama:10} {bawah:8.1f} {atas:8.1f} {abs(atas - bawah):9.1f}")

# Titik kritis: panen berapa yang masih lestari?
for panen in (100, 150, 190, 210):
    print(f"panen {panen} ton/tahun -> stok akhir {stok_akhir(panen=panen):7.1f} ton")
Stok setelah 10 tahun (kasus dasar): 844.8 ton
parameter -20% +20% rentang
r 753.3 880.2 126.9
K 636.5 1048.6 412.1
panen 882.4 798.9 83.5
awal 837.7 847.9 10.2
panen 100 ton/tahun -> stok akhir 844.8 ton
panen 150 ton/tahun -> stok akhir 679.6 ton
panen 190 ton/tahun -> stok akhir 0.0 ton
panen 210 ton/tahun -> stok akhir 0.0 ton- Kasus dasar: stok 300 ton naik menjadi 844,8 ton setelah 10 tahun dengan panen 100 ton per tahun.
- Analisis sensitivitas mengubah satu parameter sebesar ±20% sambil menahan yang lain, lalu melihat seberapa jauh hasil bergeser. Daya dukung K paling berpengaruh (rentang 412,1 ton), laju r sedang (126,9), panen kecil (83,5), dan stok awal hampir tidak (10,2) karena stok akan menuju keseimbangan. Hasil ini menunjukkan data mana yang layak diukur teliti: K.
- Titik kritis: panen 150 ton/tahun masih aman (stok 679,6), tetapi 190 ton/tahun menghancurkan stok (0,0), padahal angka itu di bawah batas teoretis rK/4 = 200 ton. Sebabnya, dengan panen 190 persamaan keseimbangan stok memiliki dua titik: sekitar 388 ton (tak stabil) dan 612 ton (stabil). Stok awal 300 berada di bawah titik tak stabil, jadi stok meluncur turun sampai habis. Stok ikan nyata bisa runtuh mendadak. Itulah alasan model sistem berguna.
Proyek Bersambung I3: model untuk sistem informasi kita
Kita menyatukan empat model proyek: alometrik pohon, bobot ikan terhadap pakan, bobot sapi terhadap pakan, dan hasil panen terhadap curah hujan. Fungsi ringkas() merangkum tiap model menjadi satu baris.
13_proyek_regresi.py
# Bab 27 - Proyek bersambung I3: empat model untuk sistem informasi kita
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)


def ringkas(nama, model, peubah):
    """Satu baris ringkasan: koefisien, selang 95%, R kuadrat."""
    b = model.params[peubah]
    lo, hi = model.conf_int().loc[peubah]
    return {"model": nama, "peubah": peubah, "koef": round(b, 3),
            "bawah95": round(lo, 3), "atas95": round(hi, 3), "R2": round(model.rsquared, 3)}


# 1. Alometrik pohon: ln(biomassa) ~ ln(diameter)
d = rng.uniform(10, 60, 60)
pohon = pd.DataFrame({"ln_d": np.log(d), "ln_b": np.log(0.12 * d ** 2.4 * np.exp(rng.normal(0, 0.15, 60)))})
m1 = smf.ols("ln_b ~ ln_d", data=pohon).fit()

# 2. Ikan: pertambahan bobot (g) ~ pakan (g/hari)
pakan_ikan = rng.uniform(20, 60, 50)
ikan = pd.DataFrame({"pakan": pakan_ikan, "tambah_g": 15 + 4.2 * pakan_ikan + rng.normal(0, 20, 50)})
m2 = smf.ols("tambah_g ~ pakan", data=ikan).fit()

# 3. Sapi: pertambahan bobot (kg) ~ pakan (kg/hari)
pakan_sapi = rng.uniform(8, 14, 40)
sapi = pd.DataFrame({"pakan": pakan_sapi, "tambah_kg": 10 + 5.5 * pakan_sapi + rng.normal(0, 7, 40)})
m3 = smf.ols("tambah_kg ~ pakan", data=sapi).fit()

# 4. Panen vs curah hujan: kurva berpunuk (terlalu kering atau terlalu basah sama-sama merugikan)
hujan = rng.uniform(600, 2400, 70)                       # mm per musim
panen = 0.5 + 0.0060 * hujan - 0.0000018 * hujan ** 2 + rng.normal(0, 0.3, 70)   # ton/ha
kebun = pd.DataFrame({"hujan": hujan, "panen": panen})
m4 = smf.ols("panen ~ hujan + I(hujan ** 2)", data=kebun).fit()

tabel = pd.DataFrame([
    ringkas("Alometrik pohon (skala log)", m1, "ln_d"),
    ringkas("Ikan: bobot ~ pakan", m2, "pakan"),
    ringkas("Sapi: bobot ~ pakan", m3, "pakan"),
])
print(tabel.to_string(index=False))

b1, b2 = m4.params["hujan"], m4.params["I(hujan ** 2)"]
optimum = -b1 / (2 * b2)
print()
print("Panen ~ hujan + hujan^2: R2 =", round(m4.rsquared, 3), " koef kuadrat p =", format(m4.pvalues["I(hujan ** 2)"], ".1e"))
print("Curah hujan optimum (puncak kurva):", round(optimum), "mm per musim")

# Ketidakpastian titik puncak lewat bootstrap (ulang-sampel dengan pengembalian)
puncak = []
for _ in range(500):
    s = kebun.sample(len(kebun), replace=True, random_state=int(rng.integers(1_000_000)))
    mb = smf.ols("panen ~ hujan + I(hujan ** 2)", data=s).fit()
    puncak.append(-mb.params["hujan"] / (2 * mb.params["I(hujan ** 2)"]))
print("Selang 95% bootstrap untuk puncak:", np.percentile(puncak, [2.5, 97.5]).round().tolist(), "mm")
model peubah koef bawah95 atas95 R2
Alometrik pohon (skala log) ln_d 2.397 2.333 2.461 0.990
Ikan: bobot ~ pakan pakan 4.210 3.753 4.667 0.877
Sapi: bobot ~ pakan pakan 5.917 4.788 7.045 0.748
Panen ~ hujan + hujan^2: R2 = 0.608 koef kuadrat p = 1.6e-10
Curah hujan optimum (puncak kurva): 1711 mm per musim
Selang 95% bootstrap untuk puncak: [1653.0, 1800.0] mm- Tabel: alometrik b = 2,397 (R kuadrat 0,990), ikan 4,210 g per gram pakan (0,877), sapi 5,917 kg per kg pakan (0,748). Selang kepercayaan memuat nilai yang kita tanam (2,4; 4,2; 5,5). Selang sapi paling lebar (4,788 sampai 7,045) karena datanya paling sedikit (40) dan paling berisik.
- Panen versus hujan berbentuk lengkung berpunuk: terlalu kering atau terlalu basah sama-sama merugikan. Model
panen ~ hujan + I(hujan ** 2)tetap linear dalam koefisien, jadi OLS biasa cukup. Suku kuadrat sangat signifikan (p = 1,6e-10), R kuadrat 0,608. - Puncak kurva, -b1 / (2 × b2), ada di sekitar 1711 mm per musim (nilai yang kita tanam: 1667). Bootstrap (500 pengulangan sampel dengan pengembalian) memberi selang 95% untuk puncak: 1653 sampai 1800 mm. Memberi selang ketidakpastian pada angka “optimum” jauh lebih jujur daripada satu angka tunggal.
Semua model ini masuk ke laporan Quarto di Bab 29.
Latihan
- Di
01_ols_alometrik.py, ramal biomassa pohon 25 cm dan 55 cm (dengan koreksi bias). Mengapa meramal pohon 150 cm tidak aman? - Di
03_logistik.py, ubah koefisien diameter di data dari 0,12 menjadi 0,02. Bagaimana ketepatan dan rasio odds berubah? - Di
12_sistem_dinamis.py, cari (dengan mencoba beberapa nilai) panen terbesar yang membuat stok masih bertahan setelah 10 tahun. Bandingkan dengan 200 ton. - Tantangan: buat data dengan satu penjelas penting dan lima penjelas sampah, lalu bandingkan R kuadrat uji OLS dan Lasso. Kapan Lasso menang?
Ringkasan Bab
- OLS:
smf.ols("y ~ x", data=...); baca koefisien, selang 95%, R kuadrat. Log-log mengubah hubungan pangkat menjadi garis lurus. - Diagnostik: sisaan normal (Shapiro), ragam sama (Breusch-Pagan), tidak kembar (VIF).
- Logistik untuk ya/tidak (rasio odds), GLM Poisson untuk cacah (periksa overdispersion), Ridge/Lasso untuk penjelas banyak (uji pada data uji).
- Non-linear (
curve_fit), efek campuran (mixedlm) untuk data berkelompok, ARIMA untuk deret waktu (uji dengan data simpanan), GWR untuk koefisien yang berubah menurut lokasi. - Monte Carlo menghitung ketidakpastian; optimisasi mencari pilihan terbaik; sistem dinamis dan sensitivitas menunjukkan titik kritis dan variabel yang paling berpengaruh.
- Model itu alat, bukan kebenaran: periksa asumsi, uji pada data baru, dan laporkan ketidakpastiannya.
Selanjutnya, di Bab 28: metode kualitatif dan campuran: bagaimana menganalisis wawancara dengan petani, nelayan, dan peternak, dan menggabungkannya dengan angka.