%%{init: {"flowchart": {"diagramPadding": 40}}}%%
flowchart TD
A["Apa jenis datanya?"] --> B["Angka<br/>(tinggi, bobot)"]
A --> C["Kategori<br/>(sehat/sakit)"]
B --> D{"Berapa kelompok?"}
D -- "2" --> E["Uji t<br/>(Mann-Whitney bila miring)"]
D -- "3 atau lebih" --> F["ANOVA<br/>(Kruskal-Wallis bila miring)"]
C --> G["Chi-square"]
Bab 26 — Statistika dengan Python: Dari Angka Menjadi Keputusan
Seri I3 — Statistik dan Pemodelan
Semua skrip bab ini ada di folder kode/bab26/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Di Seri I2, Anda sudah mengambil, membersihkan, dan menyimpan data. Data yang rapi belum menjawab pertanyaan yang sebenarnya: “Apakah pohon di plot B memang tumbuh lebih cepat, atau itu kebetulan saja?” Menjawabnya perlu statistika, yaitu cara berpikir yang jujur tentang angka yang bergoyang. Bayangkan Anda mencicipi satu sendok sup untuk menilai sepanci: Anda tidak perlu menghabiskan panci, asalkan sendoknya diambil setelah diaduk. Itulah inti bab ini: menilai yang besar dari contoh kecil, sambil tahu seberapa yakin kita boleh merasa.
CatatanINGAT
Semua data di bab ini tiruan (fiktif) buatan skrip dengan benih tetap (default_rng(42)), jadi angkanya sama setiap dijalankan. Angka-angka itu bukan hasil penelitian sungguhan dan tidak boleh dipakai sebagai anjuran budidaya.
Pustaka yang dipakai sudah dikenalkan di Seri I2 (numpy, pandas, matplotlib) ditambah tiga yang baru: scipy (scipy.stats: distribusi dan uji klasik), statsmodels (model dan tabel ANOVA bergaya laporan), dan pingouin (uji statistik dengan tabel hasil yang ringkas, termasuk ukuran efek). Untuk gambar, kita pakai seaborn.
Statistika deskriptif: merangkum tanpa menipu
Anda mengukur pertumbuhan diameter 30 pohon di plot A (cm per tahun). Memandangi 30 angka tidak membantu, jadi kita ringkas.
01_deskriptif.py
# Bab 26 - Statistika deskriptif: merangkum data pohon
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)
# Data tiruan (fiktif): pertumbuhan diameter (cm per tahun) 30 pohon di plot A
pertumbuhan = rng.normal(loc=1.8, scale=0.6, size=30).round(2)
pertumbuhan[0] = 4.9  # satu pohon luar biasa cepat (pencilan)

s = pd.Series(pertumbuhan, name="pertumbuhan_cm")
print("Jumlah data      :", s.count())
print("Rata-rata        :", round(s.mean(), 3))
print("Median           :", round(s.median(), 3))
print("Simpangan baku   :", round(s.std(), 3))
print("Kuartil 1 dan 3  :", s.quantile(0.25).round(3), s.quantile(0.75).round(3))
print("Min dan maks     :", s.min(), s.max())
print("Kemencengan      :", round(s.skew(), 3))

tanpa = s.drop(0)
print("Rata-rata tanpa pencilan:", round(tanpa.mean(), 3))
print("Median tanpa pencilan   :", round(tanpa.median(), 3))
print()
print(s.describe().round(3))
Jumlah data : 30
Rata-rata : 1.908
Median : 1.86
Simpangan baku : 0.732
Kuartil 1 dan 3 : 1.552 2.218
Min dan maks : 0.63 4.9
Kemencengan : 2.198
Rata-rata tanpa pencilan: 1.804
Median tanpa pencilan : 1.84
count 30.000
mean 1.908
std 0.732
min 0.630
25% 1.552
50% 1.860
75% 2.218
max 4.900
Name: pertumbuhan_cm, dtype: float64- Rata-rata (mean) = jumlah dibagi banyaknya. Median = nilai di tengah bila diurutkan. Keduanya “angka tengah”, tetapi berperilaku berbeda.
- Simpangan baku (standard deviation) = ukuran kasar seberapa jauh data biasanya menyebar dari rata-ratanya. Kuartil membagi data urut menjadi empat bagian sama banyak.
- Satu pohon “ajaib” bernilai 4,9 menarik rata-rata ke 1,908, sedangkan tanpa pohon itu rata-rata 1,804. Median hampir tidak bergeser (1,86 menjadi 1,84). Karena itu bila data punya pencilan (outlier) atau miring (kemencengan 2,198, jauh dari 0), median sering lebih jujur daripada rata-rata.
describe()memberi ringkasan lima angka sekaligus.
TipTIPS
Selalu gambar dulu sebelum menghitung. Satu histogram atau boxplot menunjukkan pencilan dan kemiringan yang tidak tampak dalam deretan angka. Bagian seaborn di bawah memberi caranya.
Peluang dan distribusi
Distribusi adalah “peta” seberapa mungkin tiap nilai muncul. scipy.stats menyediakan banyak distribusi dengan metode yang seragam: cdf (peluang di bawah suatu nilai), sf (peluang di atasnya), pmf (peluang tepat satu nilai, untuk data cacah), dan ppf (kebalikan cdf: nilai untuk peluang tertentu).
02_distribusi.py
# Bab 26 - Peluang dan distribusi dengan scipy.stats
from scipy import stats

# Normal: diameter pohon rata-rata 30 cm, simpangan baku 5 cm
d = stats.norm(loc=30, scale=5)
print("P(diameter < 25)        =", round(d.cdf(25), 4))
print("P(diameter > 40)        =", round(d.sf(40), 4))
print("P(25 < diameter < 35)   =", round(d.cdf(35) - d.cdf(25), 4))
print("Diameter persentil ke-90 =", round(d.ppf(0.90), 2))

# Binomial: 20 biji disemai, peluang tumbuh 0,8 per biji
b = stats.binom(n=20, p=0.8)
print()
print("Rata-rata biji tumbuh   =", b.mean())
print("P(tepat 16 tumbuh)      =", round(b.pmf(16), 4))
print("P(paling sedikit 18)    =", round(b.sf(17), 4))

# Poisson: rata-rata 3 pohon tumbang per hektar per musim
p = stats.poisson(mu=3)
print()
print("P(tidak ada yang tumbang) =", round(p.pmf(0), 4))
print("P(lebih dari 5 tumbang)   =", round(p.sf(5), 4))
P(diameter < 25) = 0.1587
P(diameter > 40) = 0.0228
P(25 < diameter < 35) = 0.6827
Diameter persentil ke-90 = 36.41
Rata-rata biji tumbuh = 16.0
P(tepat 16 tumbuh) = 0.2182
P(paling sedikit 18) = 0.2061
P(tidak ada yang tumbang) = 0.0498
P(lebih dari 5 tumbang) = 0.0839- Normal (lonceng): data ukuran sering mendekati ini. Diameter pohon rata-rata 30 cm dengan simpangan baku 5 cm: sekitar 68% pohon (0,6827) ada dalam satu simpangan baku dari rata-rata (25 sampai 35 cm), dan hanya 2,28% yang lebih dari 40 cm.
- Binomial: jumlah “berhasil” dari beberapa percobaan ya/tidak. 20 biji dengan peluang tumbuh 0,8 rata-rata menghasilkan 16 bibit; peluang tepat 16 hanya 0,2182, bukan 1. Peluang minimal 18 tumbuh sekitar 21%.
- Poisson: banyaknya kejadian langka dalam satu wilayah atau waktu (pohon tumbang per hektar). Dengan rata-rata 3, peluang tidak ada yang tumbang hanya 4,98%.
Sampling dan selang kepercayaan
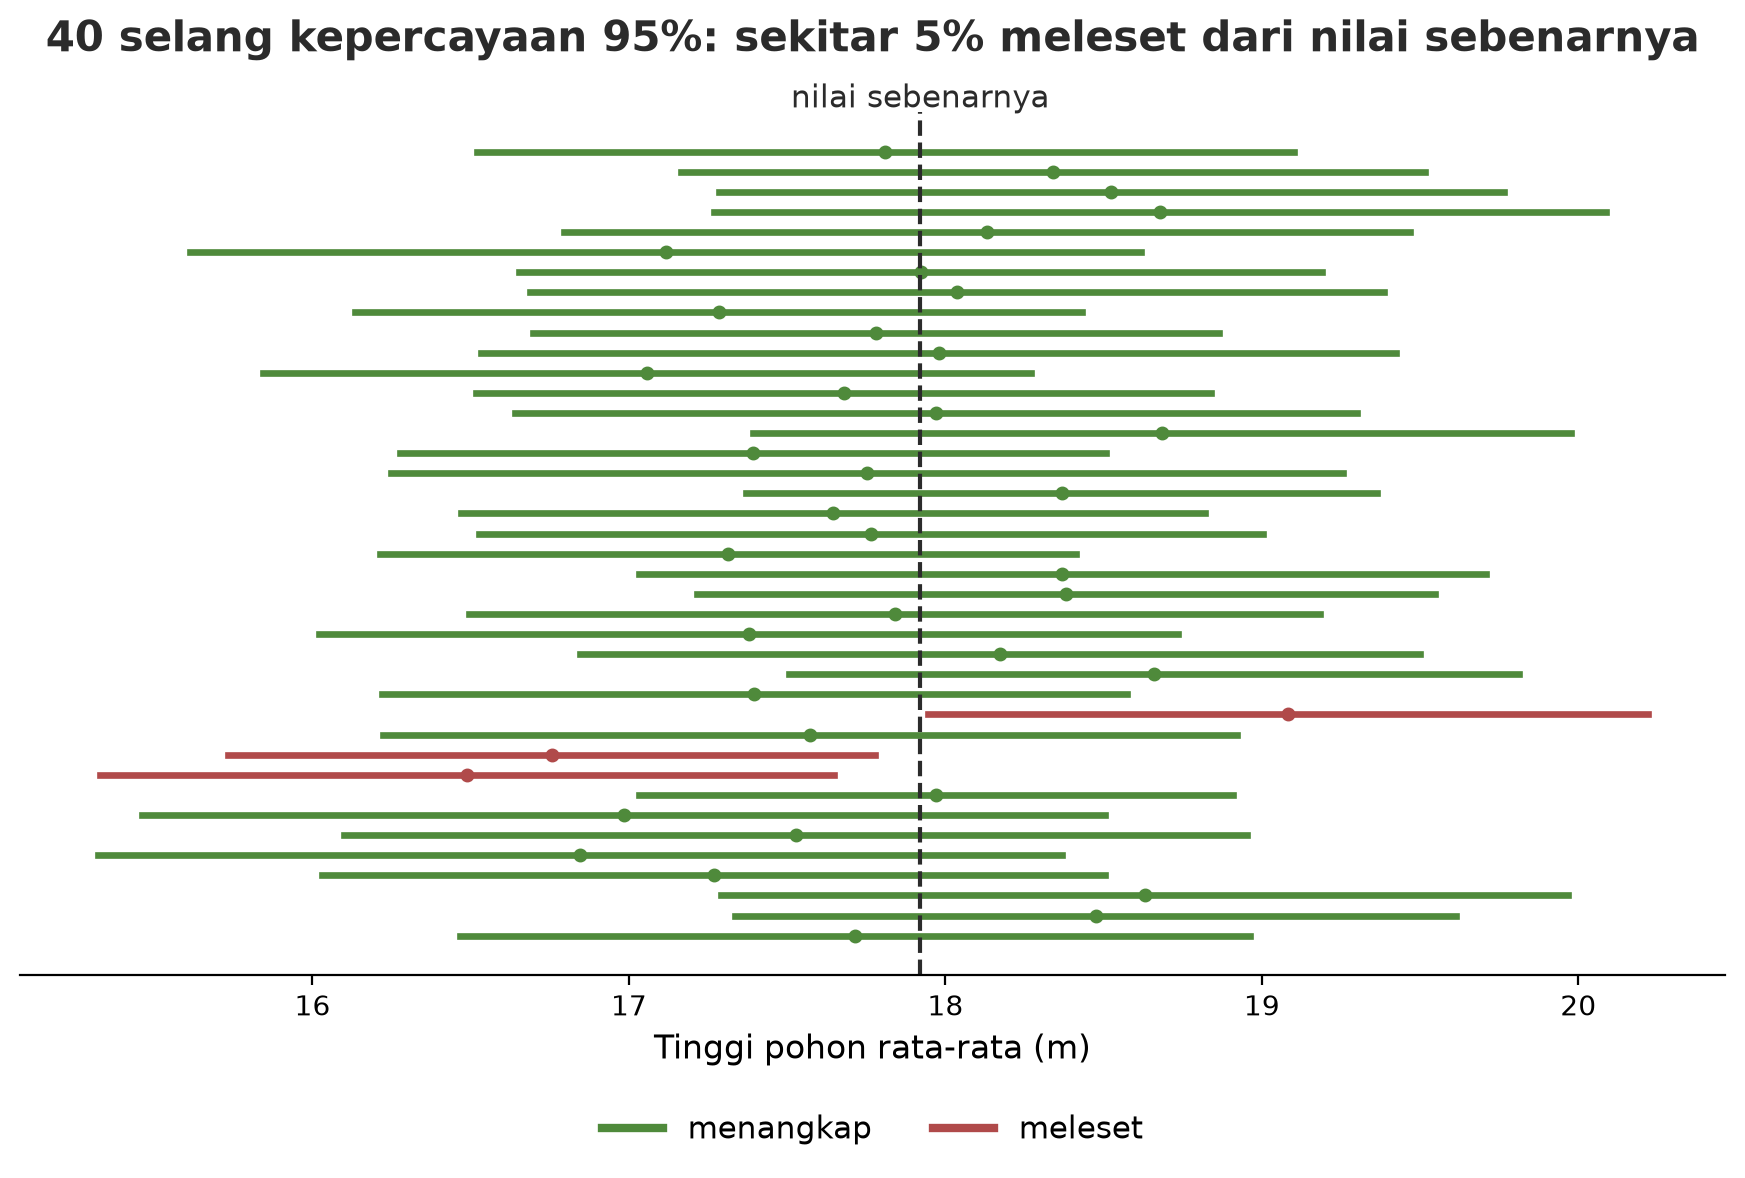
Kita hampir tidak pernah mengukur semua pohon (populasi). Kita mengambil sampel lalu menaksir. Taksiran dari sampel pasti agak meleset, dan galat baku (standard error) mengukur seberapa besar meleset itu: simpangan baku dibagi akar jumlah data. Selang kepercayaan 95% adalah rentang di sekitar taksiran yang dibuat dengan resep yang, bila diulang berkali-kali, menangkap nilai sebenarnya sekitar 95% dari waktu.
03_sampling_ci.py
# Bab 26 - Sampling dan selang kepercayaan
import numpy as np
from scipy import stats

rng = np.random.default_rng(42)
# "Populasi" fiktif: tinggi 5000 pohon (m)
populasi = rng.normal(loc=18.0, scale=4.0, size=5000)
print("Rata-rata populasi (nilai sebenarnya):", round(populasi.mean(), 3))

# Ambil satu sampel acak 40 pohon
sampel = rng.choice(populasi, size=40, replace=False)
rata = sampel.mean()
galat_baku = stats.sem(sampel)  # simpangan baku / akar n
print("Rata-rata sampel      :", round(rata, 3))
print("Galat baku            :", round(galat_baku, 3))

# Selang kepercayaan 95% memakai distribusi t
bawah, atas = stats.t.interval(0.95, df=len(sampel) - 1, loc=rata, scale=galat_baku)
print("Selang 95%            :", round(bawah, 2), "sampai", round(atas, 2))

# Ulangi 1000 kali: berapa kali selang menangkap nilai sebenarnya?
tangkap = 0
for _ in range(1000):
    s = rng.choice(populasi, size=40, replace=False)
    lo, hi = stats.t.interval(0.95, df=39, loc=s.mean(), scale=stats.sem(s))
    tangkap += lo <= populasi.mean() <= hi
print("Selang yang menangkap nilai sebenarnya:", tangkap, "dari 1000")
Rata-rata populasi (nilai sebenarnya): 17.92
Rata-rata sampel : 17.714
Galat baku : 0.617
Selang 95% : 16.47 sampai 18.96
Selang yang menangkap nilai sebenarnya: 961 dari 1000Nilai sebenarnya (rata-rata populasi) 17,92 m. Sampel kita menaksir 17,714 dengan selang 16,47 sampai 18,96, yang memang menangkap 17,92. Lalu kita ulangi 1000 kali: 961 selang menangkap nilai sebenarnya, dekat dengan janji 95%.
PeringatanAWAS
Selang 95% bukan berarti “ada peluang 95% nilai sebenarnya berada di dalam selang ini”. Nilai sebenarnya tetap (tidak acak); yang acak adalah selangnya. Yang benar: resep ini menangkap nilai sebenarnya di 95% dari sampel yang mungkin kita ambil. Lebih banyak data membuat selang lebih sempit.
Uji hipotesis: dua kelompok
Sekarang pertanyaan awal bab ini. Plot A dan B dibandingkan dengan uji hipotesis:
- Hipotesis nol (H0): tidak ada beda sebenarnya; selisih yang tampak hanya kebetulan.
- Hitung seberapa langka data seperti ini bila H0 benar. Ukurannya p-value.
- Bila p-value kecil (kebiasaan: di bawah 0,05, disebut taraf signifikansi), kita menolak H0.
04_uji_t.py
# Bab 26 - Uji t: apakah pertumbuhan plot A beda dengan plot B?
import numpy as np
import pingouin as pg
from scipy import stats

rng = np.random.default_rng(42)
plot_a = rng.normal(1.8, 0.6, 30).round(2)   # cm per tahun (fiktif)
plot_b = rng.normal(2.2, 0.7, 30).round(2)

print("Rata-rata A:", plot_a.mean().round(3), " Rata-rata B:", plot_b.mean().round(3))

# Uji t Welch (tidak mengandaikan ragam sama)
hasil = stats.ttest_ind(plot_a, plot_b, equal_var=False)
print("t =", round(hasil.statistic, 3), " p =", round(hasil.pvalue, 4))

# pingouin memberi tabel lengkap, termasuk ukuran efek (Cohen d)
tabel = pg.ttest(plot_a, plot_b, correction=True)
print(tabel[["T", "dof", "p_val", "cohen_d", "CI95"]].round(4).to_string())

# Uji berpasangan: 12 pohon yang sama diukur sebelum dan sesudah pemupukan
sebelum = rng.normal(1.5, 0.4, 12)
sesudah = sebelum + rng.normal(0.3, 0.25, 12)
pasangan = stats.ttest_rel(sesudah, sebelum)
print("Berpasangan: t =", round(pasangan.statistic, 3), " p =", format(pasangan.pvalue, ".1e"))
Rata-rata A: 1.81 Rata-rata B: 2.28
t = -3.512 p = 0.0009
T dof p_val cohen_d CI95
T_test -3.5121 56.012 0.0009 0.9068 [-0.74, -0.2]
Berpasangan: t = 7.457 p = 1.3e-05- Rata-rata A 1,81 dan B 2,28. Uji t Welch menghasilkan t = -3,512 dan p = 0,0009. Tanda minus hanya karena A dikurangi B. Welch tidak mengandaikan ragam kedua plot sama, jadi lebih aman sebagai pilihan awal.
pingouin.ttestmemberi tabel yang sama ditambah Cohen d = 0,9068 dan selang kepercayaan untuk selisih rata-rata (-0,74 sampai -0,2). Selang itu tidak memuat 0, sejalan dengan p kecil.- Uji berpasangan (
ttest_rel) dipakai bila pohon yang sama diukur dua kali (sebelum dan sesudah pemupukan). Ia lebih peka karena membandingkan tiap pohon dengan dirinya sendiri.
CatatanINGAT
p-value bukan peluang bahwa hipotesis Anda benar. p = 0,0009 berarti: bila tidak ada beda sebenarnya, data sejauh ini hanya muncul sekitar 9 kali dalam 10.000 pengambilan. Ia tidak mengatakan seberapa besar bedanya atau seberapa penting bedanya. Itu tugas ukuran efek.
Ukuran efek menjawab “seberapa besar”. Cohen d adalah selisih rata-rata dibagi simpangan baku gabungan. Pedoman kasar Cohen: 0,2 kecil, 0,5 sedang, 0,8 besar. Nilai 0,9 di atas tergolong besar.
Chi-square: dua kategori
Uji t untuk angka; untuk hitungan per kategori dipakai chi-square. Apakah jenis pohon berhubungan dengan sehat/sakit?
05_chi_square.py
# Bab 26 - Chi-square: apakah jenis pohon berhubungan dengan kesehatan?
import pandas as pd
from scipy import stats

# Tabel kontingensi fiktif (jumlah pohon)
tabel = pd.DataFrame(
    {"sehat": [42, 35, 28], "sakit": [8, 15, 22]},
    index=["Jati", "Meranti", "Mahoni"],
)
print(tabel)

chi2, p, dof, harapan = stats.chi2_contingency(tabel)
print()
print("chi2 =", round(chi2, 3), " derajat bebas =", dof, " p =", round(p, 4))
print("Nilai harapan jika tidak berhubungan:")
print(pd.DataFrame(harapan, index=tabel.index, columns=tabel.columns).round(1))

# Ukuran efek: Cramer's V
n = tabel.values.sum()
v = (chi2 / (n * (min(tabel.shape) - 1))) ** 0.5
print("Cramer V =", round(v, 3))
sehat sakit
Jati 42 8
Meranti 35 15
Mahoni 28 22
chi2 = 9.333 derajat bebas = 2 p = 0.0094
Nilai harapan jika tidak berhubungan:
sehat sakit
Jati 35.0 15.0
Meranti 35.0 15.0
Mahoni 35.0 15.0
Cramer V = 0.249Bila jenis dan kesehatan tidak berhubungan, tiap jenis (masing-masing 50 pohon) diharapkan 35 sehat dan 15 sakit. Yang teramati menyimpang: Jati lebih sehat (42), Mahoni lebih sakit (22). Chi-square = 9,333 dengan 2 derajat bebas (degrees of freedom) memberi p = 0,0094. Ukuran efeknya Cramer V = 0,249, hubungan yang nyata tetapi bukan yang sangat kuat.
ANOVA: tiga kelompok atau lebih
Membandingkan tiga varietas dengan tiga uji t berpasangan menaikkan risiko salah (lihat jebakan di bawah). ANOVA menguji semua kelompok sekaligus: “adakah paling tidak satu yang beda?” Ia mengandaikan data tiap kelompok mendekati normal dan ragamnya mirip, jadi diperiksa dulu dengan uji Shapiro dan Levene.
06_anova_nonparametrik.py
# Bab 26 - ANOVA untuk tiga varietas, dan uji nonparametrik sebagai cadangan
import numpy as np
import pandas as pd
import pingouin as pg
from scipy import stats

rng = np.random.default_rng(42)
data = pd.DataFrame({
    "varietas": np.repeat(["V1", "V2", "V3"], 25),
    "tinggi_cm": np.concatenate([
        rng.normal(120, 12, 25), rng.normal(128, 12, 25), rng.normal(137, 12, 25)
    ]).round(1),
})
print(data.groupby("varietas")["tinggi_cm"].agg(["mean", "std"]).round(2))

kelompok = [g["tinggi_cm"].values for _, g in data.groupby("varietas")]
print()
print("Shapiro (normal?) p per kelompok:", [round(float(stats.shapiro(k).pvalue), 3) for k in kelompok])
print("Levene (ragam sama?) p          :", round(stats.levene(*kelompok).pvalue, 3))

anova = pg.anova(data=data, dv="tinggi_cm", between="varietas", detailed=False)
print()
print("F =", round(anova.loc[0, "F"], 2), " p =", format(anova.loc[0, "p_unc"], ".2e"), " eta-kuadrat parsial =", round(anova.loc[0, "np2"], 3))

print()
print(pg.pairwise_tukey(data=data, dv="tinggi_cm", between="varietas")[["A", "B", "diff", "p_tukey"]].round(4).to_string())

# Cadangan nonparametrik (tidak mengandaikan sebaran normal)
print()
print("Kruskal-Wallis p =", format(stats.kruskal(*kelompok).pvalue, ".2e"))
print("Mann-Whitney V1 vs V3 p =", round(stats.mannwhitneyu(kelompok[0], kelompok[2]).pvalue, 5))
mean std
varietas
V1 119.58 9.97
V2 130.61 8.32
V3 135.45 9.94
Shapiro (normal?) p per kelompok: [0.572, 0.168, 0.851]
Levene (ragam sama?) p : 0.433
F = 18.55 p = 3.17e-07 eta-kuadrat parsial = 0.34
A B diff p_tukey
0 V1 V2 -11.036 0.0003
1 V1 V3 -15.872 0.0000
2 V2 V3 -4.836 0.1734
Kruskal-Wallis p = 4.19e-06
Mann-Whitney V1 vs V3 p = 1e-05- Rata-rata tinggi V1, V2, V3: 119,58, 130,61, 135,45 cm. Uji Shapiro (p semua di atas 0,05) dan Levene (p = 0,433) tidak menunjukkan pelanggaran asumsi.
- ANOVA: F = 18,55, p = 3,17e-07 (artinya 0,000000317). Eta-kuadrat parsial 0,34: sekitar 34% keragaman tinggi berkaitan dengan varietas.
- ANOVA hanya bilang “ada yang beda”. Uji lanjutan Tukey menunjukkan yang mana: V1-V2 (p = 0,0003) dan V1-V3 (0,0000, artinya di bawah 0,00005) beda, sedangkan V2-V3 (0,1734) belum terbukti beda.
- Uji nonparametrik tidak mengandaikan sebaran normal; ia bekerja pada peringkat data. Kruskal-Wallis menggantikan ANOVA, Mann-Whitney menggantikan uji t. Di sini keduanya sepakat dengan ANOVA. Pakai ini bila data sangat miring, berupa peringkat, atau sampelnya sangat kecil.
Dua jebakan p-value
07_pvalue_jebakan.py
# Bab 26 - Dua jebakan p-value: banyak uji dan sampel raksasa
import numpy as np
from scipy import stats

rng = np.random.default_rng(42)

# Jebakan 1: 20 uji pada data dari populasi yang sama (tidak ada beda sebenarnya)
signifikan = 0
for i in range(20):
    a = rng.normal(0, 1, 30)
    b = rng.normal(0, 1, 30)
    p = stats.ttest_ind(a, b).pvalue
    if p < 0.05:
        signifikan += 1
        print(f"  uji ke-{i + 1}: p = {p:.4f}  <- 'signifikan' padahal tidak ada beda")
print("Uji 'signifikan' dari 20:", signifikan)
print("Setelah koreksi Bonferroni, ambang menjadi", 0.05 / 20)

# Jebakan 2: beda sangat kecil, sampel sangat besar
a = rng.normal(100.0, 15, 200_000)
b = rng.normal(100.3, 15, 200_000)
hasil = stats.ttest_ind(a, b)
d = (b.mean() - a.mean()) / 15
print()
print("Beda rata-rata:", round(b.mean() - a.mean(), 3), " p =", format(hasil.pvalue, ".1e"))
print("Ukuran efek (d) :", round(d, 3), "-> sangat kecil, walau p sangat kecil")
uji ke-15: p = 0.0327 <- 'signifikan' padahal tidak ada beda
Uji 'signifikan' dari 20: 1
Setelah koreksi Bonferroni, ambang menjadi 0.0025
Beda rata-rata: 0.323 p = 9.7e-12
Ukuran efek (d) : 0.022 -> sangat kecil, walau p sangat kecil- Jebakan 1, terlalu banyak uji. Kita menjalankan 20 uji pada data yang sebenarnya dari populasi yang sama. Hasilnya satu uji (ke-15, p = 0,0327) tampak “signifikan”. Dengan ambang 0,05, kira-kira satu dari 20 uji tak berbeda pasti tampak signifikan. Bila Anda menguji banyak hal lalu hanya melaporkan yang “signifikan”, Anda sedang memanen kebetulan. Obatnya: tetapkan hipotesis lebih dulu, dan pakai koreksi seperti Bonferroni (ambang dibagi jumlah uji, di sini 0,0025).
- Jebakan 2, sampel raksasa. Dengan 200.000 data per kelompok, selisih 0,323 poin pada skala simpangan baku 15 (d = 0,022) menghasilkan p = 9,7e-12. Signifikan secara statistik, tetapi nyaris tidak berarti di dunia nyata. Signifikan bukan berarti penting. Selalu laporkan ukuran efek dan selang kepercayaan di samping p-value.
Korelasi bukan sebab-akibat
Korelasi mengukur seberapa kompak dua angka naik-turun bersama (dari -1 sampai 1). Pearson untuk hubungan garis lurus; Spearman memakai peringkat sehingga tahan pencilan.
08_korelasi.py
# Bab 26 - Korelasi bukan sebab-akibat: faktor tersembunyi
import numpy as np
import pandas as pd
from scipy import stats
import pingouin as pg

rng = np.random.default_rng(42)
n = 60
hujan = rng.normal(200, 50, n)                       # curah hujan (mm), faktor tersembunyi
jamur = 0.08 * hujan + rng.normal(0, 3, n)           # jamur tumbuh lebih banyak saat hujan
panen = 0.5 * hujan + rng.normal(0, 25, n)           # panen juga naik saat hujan
df = pd.DataFrame({"hujan_mm": hujan, "jamur": jamur, "panen_kg": panen})

r, p = stats.pearsonr(df["jamur"], df["panen_kg"])
print("Korelasi jamur vs panen (Pearson):", round(r, 3), " p =", format(p, ".1e"))
rho, p2 = stats.spearmanr(df["jamur"], df["panen_kg"])
print("Korelasi peringkat (Spearman)     :", round(rho, 3))

# Korelasi parsial: buang pengaruh hujan
parsial = pg.partial_corr(data=df, x="jamur", y="panen_kg", covar="hujan_mm")
print()
print("Korelasi jamur vs panen setelah hujan dikendalikan:")
print(parsial[["n", "r", "p_val"]].round(3).to_string())
Korelasi jamur vs panen (Pearson): 0.513 p = 2.8e-05
Korelasi peringkat (Spearman) : 0.504
Korelasi jamur vs panen setelah hujan dikendalikan:
n r p_val
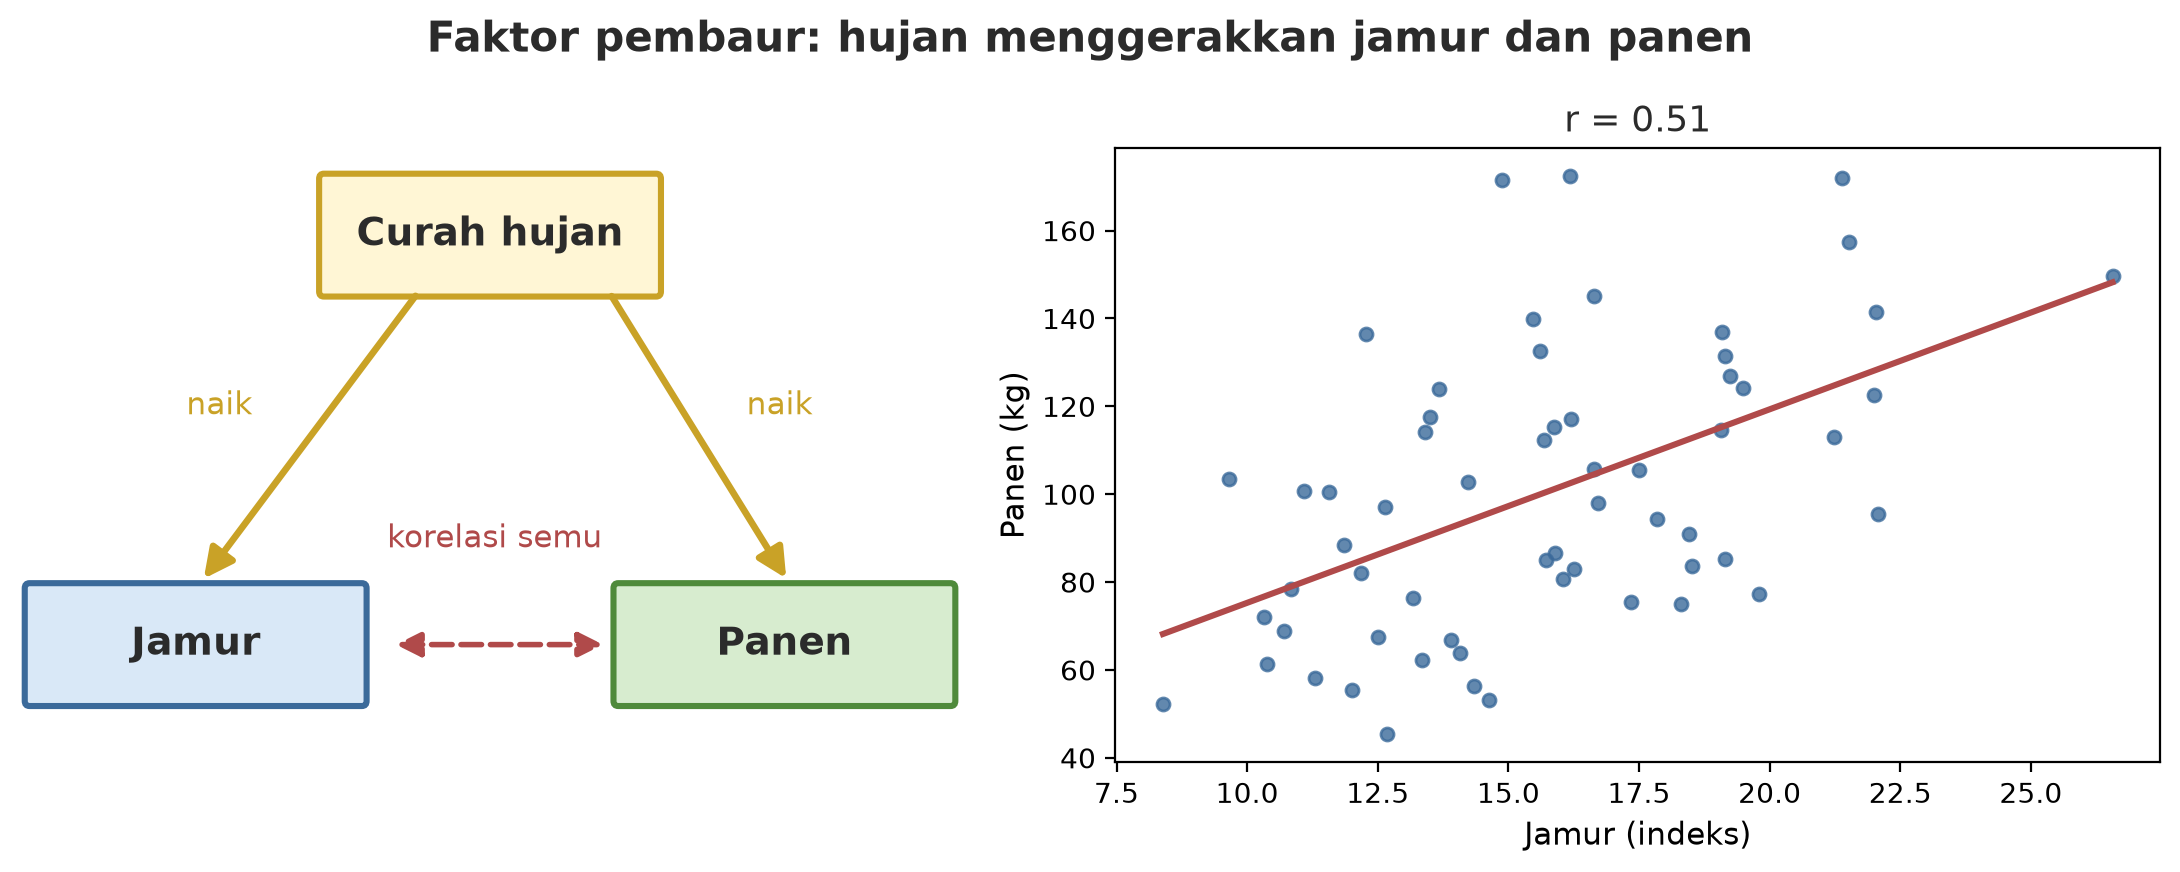
pearson 60 0.057 0.667Jamur dan panen berkorelasi 0,513 (p = 2,8e-05): hubungan tampak kuat. Apakah memberantas jamur menurunkan panen? Tidak. Dalam data ini, hujan menaikkan keduanya (jamur menyukai lembap, tanaman menyukai air). Setelah pengaruh hujan dikendalikan lewat korelasi parsial, hubungan jamur-panen tinggal 0,057 dengan p = 0,667, alias hilang. Hujan di sini disebut faktor pembaur (confounder).
PeringatanAWAS
Sebab-akibat hanya bisa disimpulkan dari percobaan terkontrol (misalnya plot diberi perlakuan secara acak) atau dari analisis yang sangat hati-hati. Data pengamatan biasa hanya menunjukkan hubungan. Waspadai kalimat “X menyebabkan Y” dari sekadar korelasi.
Visualisasi statistik dengan seaborn
09_visual_seaborn.py
# Bab 26 - Visualisasi statistik dengan seaborn
from pathlib import Path

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns

rng = np.random.default_rng(42)
data = pd.DataFrame({
    "plot": np.repeat(["A", "B", "C"], 30),
    "pertumbuhan_cm": np.concatenate([
        rng.normal(1.8, 0.6, 30), rng.normal(2.3, 0.7, 30), rng.normal(2.0, 0.5, 30)
    ]),
})

keluar = Path(__file__).parent / "_tmp"
keluar.mkdir(exist_ok=True)

fig, sumbu = plt.subplots(1, 2, figsize=(9, 3.6))
sns.boxplot(data=data, x="plot", y="pertumbuhan_cm", ax=sumbu[0])
sns.stripplot(data=data, x="plot", y="pertumbuhan_cm", color="black", size=3, ax=sumbu[0])
sns.histplot(data=data, x="pertumbuhan_cm", hue="plot", kde=True, ax=sumbu[1])
fig.tight_layout()
fig.savefig(keluar / "seaborn_plot.png", dpi=120)
print("Gambar tersimpan:", (keluar / "seaborn_plot.png").name)
print("Ukuran per plot:", data.groupby("plot").size().to_dict())
Gambar tersimpan: seaborn_plot.png
Ukuran per plot: {'A': 30, 'B': 30, 'C': 30}Skrip menyimpan gambar ke folder _tmp/ (tidak ditampilkan di buku). Buka dan lihat: boxplot menunjukkan median, kuartil, dan pencilan; titik-titik (stripplot) menunjukkan data mentahnya; histogram dengan garis kde menunjukkan bentuk sebaran. Menggabungkan ketiganya membuat Anda jarang tertipu oleh satu angka rata-rata.
Proyek Bersambung I3: uji beda pertumbuhan antar-plot dan antar-varietas
Tugas pertama proyek I3: pertumbuhan diameter pohon (cm per tahun) di tiga plot (A, B, C) dan dua varietas (V1, V2), 20 pohon per kombinasi. Semua angka fiktif dengan beda yang kita tanam sendiri (B lebih tinggi 0,5; V2 lebih tinggi 0,3), sehingga kita bisa memeriksa apakah uji menemukannya.
10_proyek_uji_beda.py
# Bab 26 - Proyek bersambung I3: uji beda pertumbuhan antar-plot dan antar-varietas
import numpy as np
import pandas as pd
import pingouin as pg
import statsmodels.api as sm
import statsmodels.formula.api as smf

rng = np.random.default_rng(42)
efek_plot = {"A": 0.0, "B": 0.5, "C": 0.2}      # fiktif
efek_varietas = {"V1": 0.0, "V2": 0.3}          # fiktif
baris = []
for p, ep in efek_plot.items():
    for v, ev in efek_varietas.items():
        for g in rng.normal(1.8 + ep + ev, 0.6, 20):
            baris.append({"plot": p, "varietas": v, "pertumbuhan_cm": round(g, 2)})
pohon = pd.DataFrame(baris)

print(pohon.pivot_table(index="plot", columns="varietas", values="pertumbuhan_cm", aggfunc="mean").round(2))

model = smf.ols("pertumbuhan_cm ~ C(plot) + C(varietas)", data=pohon).fit()
anova = sm.stats.anova_lm(model, typ=2)
print()
print(anova.round(4))

print()
print("Beda antar-plot (Tukey):")
print(pg.pairwise_tukey(data=pohon, dv="pertumbuhan_cm", between="plot")[["A", "B", "diff", "p_tukey", "hedges"]].round(3).to_string())

v1 = pohon.query("varietas == 'V1'")["pertumbuhan_cm"]
v2 = pohon.query("varietas == 'V2'")["pertumbuhan_cm"]
uji = pg.ttest(v1, v2)
print()
print("V1 vs V2: p =", uji["p_val"].round(4).iloc[0], " Cohen d =", uji["cohen_d"].round(2).iloc[0], " CI95 beda =", uji["CI95"].iloc[0])
varietas V1 V2
plot
A 1.78 2.17
B 2.37 2.54
C 1.79 2.23
sum_sq df F PR(>F)
C(plot) 5.8334 2.0 13.1621 0.0000
C(varietas) 3.3534 1.0 15.1327 0.0002
Residual 25.7053 116.0 NaN NaN
Beda antar-plot (Tukey):
A B diff p_tukey hedges
0 A B -0.485 0.000 -0.984
1 A C -0.037 0.942 -0.069
2 B C 0.448 0.000 0.922
V1 vs V2: p = 0.0006 Cohen d = 0.65 CI95 beda = [-0.52 -0.15]- Tabel pertama menunjukkan rata-rata tiap kombinasi. Plot B paling tinggi di kedua varietas, V2 selalu di atas V1.
ols("pertumbuhan_cm ~ C(plot) + C(varietas)")membuat model dengan dua faktor sekaligus;anova_lmmerangkumnya. Plot: F = 13,16, varietas: F = 15,13, keduanya p di bawah 0,001 (tampil 0,0000 dan 0,0002 karena dibulatkan).- Tukey antar-plot: A-B beda (selisih -0,485; ukuran efek Hedges -0,984), B-C beda, tetapi A-C tidak (p = 0,942, selisih -0,037). Uji menemukan beda yang kita tanam, dan tidak mengada-ada untuk pasangan yang memang mirip.
- V1 vs V2: p = 0,0006, Cohen d = 0,65 (sedang), selisih rata-rata ada di rentang -0,52 sampai -0,15 cm per tahun.
Proyek ini dilanjutkan di Bab 27 dengan regresi, dan seluruh hasilnya masuk ke laporan Quarto di Bab 29.
Latihan
- Ubah
01_deskriptif.py: ganti pencilan 4,9 menjadi 9,9. Mana yang bergeser lebih banyak, rata-rata atau median? Mengapa? - Dengan distribusi normal di
02_distribusi.py, hitung peluang diameter pohon antara 20 dan 30 cm, dan diameter yang melampaui 95% pohon. - Di
03_sampling_ci.py, ubah ukuran sampel dari 40 menjadi 160. Bagaimana lebar selang 95% berubah? (Petunjuk: galat baku turun kira-kira setengahnya.) - Tantangan: buat data untuk dua plot dengan rata-rata sama persis, ulang uji t 1000 kali dengan benih berbeda, dan hitung berapa persen uji menghasilkan p di bawah 0,05. Apakah mendekati 5%? Apa artinya?
Ringkasan Bab
- Deskriptif: rata-rata, median, simpangan baku, kuartil. Pencilan mengganggu rata-rata, tidak median.
- Distribusi di
scipy.stats:cdf,sf,pmf,ppf; normal untuk ukuran, binomial untuk berhasil/gagal, Poisson untuk kejadian langka. - Selang kepercayaan 95% = resep yang menangkap nilai sebenarnya di sekitar 95% sampel; bukan peluang untuk satu selang.
- Uji hipotesis: uji t (dua kelompok), chi-square (kategori), ANOVA (tiga atau lebih, dilanjutkan Tukey), dan cadangan nonparametrik.
- p-value bukan peluang hipotesis benar, tidak mengukur besar efek. Waspada banyak uji dan sampel raksasa; selalu laporkan ukuran efek.
- Korelasi bukan sebab-akibat: cari faktor pembaur dan kendalikan.
Selanjutnya, di Bab 27: regresi, cara membuat model yang menjelaskan dan meramalkan: pohon, ikan, ternak, panen, dan hujan.