Bab 54 — Machine Learning Klasik: Pohon, Hutan, dan Boosting
Seri A3 — Machine Learning untuk Sumber Daya Alam
Semua skrip bab ini ada di folder kode/bab54/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Di Seri I3 Anda memodelkan data dengan regresi: Anda yang memilih bentuk rumusnya. Di machine learning (ML), arahnya dibalik: Anda memberi contoh (data dengan jawaban), dan komputer mencari sendiri aturannya. Bayangkan seorang mantri hutan yang bertahun-tahun melihat petak lahan dari foto satelit. Ia akhirnya hafal: “hijau tua, tinggi, curam: hutan; hijau muda, datar, dekat air: sawah.” ML melakukan hal serupa, hanya dari ribuan contoh dalam hitungan detik.
Bab ini memakai ML klasik: model yang bekerja pada tabel angka dan sangat andal untuk data lapangan. Bab 55 baru membahas jaringan saraf (deep learning) dan GPU.
Semua data di bab ini tiruan buatan skrip (buat_data.py): 1.200 petak lahan di peta fiktif 1.000 x 1.000 meter, dengan fitur NDVI (indeks hijau vegetasi), elevasi, kemiringan, dan curah hujan. Angka akurasi di buku adalah angka contoh, bukan kemampuan nyata di hutan sungguhan.
Data: petak lahan dengan kelas
Tiap petak punya empat fitur (bahan penebak) dan satu label (jawaban: hutan, kebun, sawah, atau permukiman). Peta tiruan dibuat dari 40 “bercak” lahan, supaya petak bertetangga cenderung sekelas, seperti di dunia nyata. Hal ini penting di bagian validasi spasial nanti.
Pohon keputusan
Pohon keputusan adalah rangkaian pertanyaan ya/tidak, seperti permainan tebak-tebakan: “NDVI di atas 0,3? Kemiringan di atas 13? …” sampai tiba di jawaban. Kelebihannya besar: aturannya bisa dibaca manusia.
01_pohon_keputusan.py
# Bab 54 - Pohon keputusan: aturan "jika-maka" yang dipelajari dari data
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier, export_text

from buat_data import FITUR, buat_lahan

df = buat_lahan()
print("Bentuk data:", df.shape)
print(df["kelas"].value_counts().sort_index().to_string())

X_latih, X_uji, y_latih, y_uji = train_test_split(
    df[FITUR], df["kelas"], test_size=0.25, random_state=42, stratify=df["kelas"])

pohon = DecisionTreeClassifier(max_depth=3, random_state=42)
pohon.fit(X_latih, y_latih)
print("\nAturan yang dipelajari:")
print(export_text(pohon, feature_names=FITUR, decimals=3))
print("Akurasi data latih:", round(pohon.score(X_latih, y_latih), 3))
print("Akurasi data uji  :", round(pohon.score(X_uji, y_uji), 3))
Bentuk data: (1200, 8)
kelas
hutan 198
kebun 146
permukiman 530
sawah 326
Aturan yang dipelajari:
|--- ndvi <= 0.300
| |--- ndvi <= 0.218
| | |--- elevasi_m <= 306.000
| | | |--- class: permukiman
| | |--- elevasi_m > 306.000
| | | |--- class: kebun
| |--- ndvi > 0.218
| | |--- kemiringan_derajat <= 4.400
| | | |--- class: permukiman
| | |--- kemiringan_derajat > 4.400
| | | |--- class: permukiman
|--- ndvi > 0.300
| |--- elevasi_m <= 235.000
| | |--- kemiringan_derajat <= 10.950
| | | |--- class: sawah
| | |--- kemiringan_derajat > 10.950
| | | |--- class: kebun
| |--- elevasi_m > 235.000
| | |--- kemiringan_derajat <= 13.350
| | | |--- class: kebun
| | |--- kemiringan_derajat > 13.350
| | | |--- class: hutan
Akurasi data latih: 0.874
Akurasi data uji : 0.88- Data dibagi dua: 75% untuk melatih (belajar), 25% untuk menguji (ujian dengan soal yang belum pernah dilihat).
stratifymenjaga perbandingan kelas sama di kedua bagian.random_state=42mengunci pengacakan supaya hasilnya sama setiap dijalankan. max_depth=3membatasi pohon hanya tiga tingkat pertanyaan.- Perhatikan jalur
ndvi <= 0,300lalundvi > 0,218: kedua cabang akhirnyapermukiman. Pohon tetap membelah karena pembelahan itu membuat kelompoknya sedikit lebih “murni”, walau jawaban akhirnya sama. - Akurasi latih (0,874) dan uji (0,88) berdekatan: pohon kecil ini belum menghafal.
Overfitting: ketika model menghafal
Murid yang menghafal kunci jawaban dapat nilai 100 di latihan, tetapi jeblok di ujian dengan soal baru. Itulah overfitting. Kita lihat dengan membiarkan pohon makin dalam:
02_overfitting.py
# Bab 54 - Overfitting: pohon yang terlalu dalam menghafal data latih
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

from buat_data import FITUR, buat_lahan

df = buat_lahan()
X_latih, X_uji, y_latih, y_uji = train_test_split(
    df[FITUR], df["kelas"], test_size=0.25, random_state=42, stratify=df["kelas"])

print("kedalaman | akurasi latih | akurasi uji | selisih")
for dalam in [1, 2, 3, 5, 8, 12, None]:
    pohon = DecisionTreeClassifier(max_depth=dalam, random_state=42).fit(X_latih, y_latih)
    a_latih = pohon.score(X_latih, y_latih)
    a_uji = pohon.score(X_uji, y_uji)
    print(f"{str(dalam):>9} | {a_latih:13.3f} | {a_uji:11.3f} | {a_latih - a_uji:7.3f}")
kedalaman | akurasi latih | akurasi uji | selisih
1 | 0.647 | 0.660 | -0.013
2 | 0.804 | 0.823 | -0.019
3 | 0.874 | 0.880 | -0.006
5 | 0.916 | 0.880 | 0.036
8 | 0.969 | 0.853 | 0.116
12 | 0.997 | 0.837 | 0.160
None | 1.000 | 0.847 | 0.153Akurasi latih naik terus sampai 1,000 (pohon tanpa batas menghafal setiap petak), sedangkan akurasi uji berhenti naik di sekitar kedalaman 3 dan malah turun. Selisihnya melebar dari -0,006 menjadi 0,153.
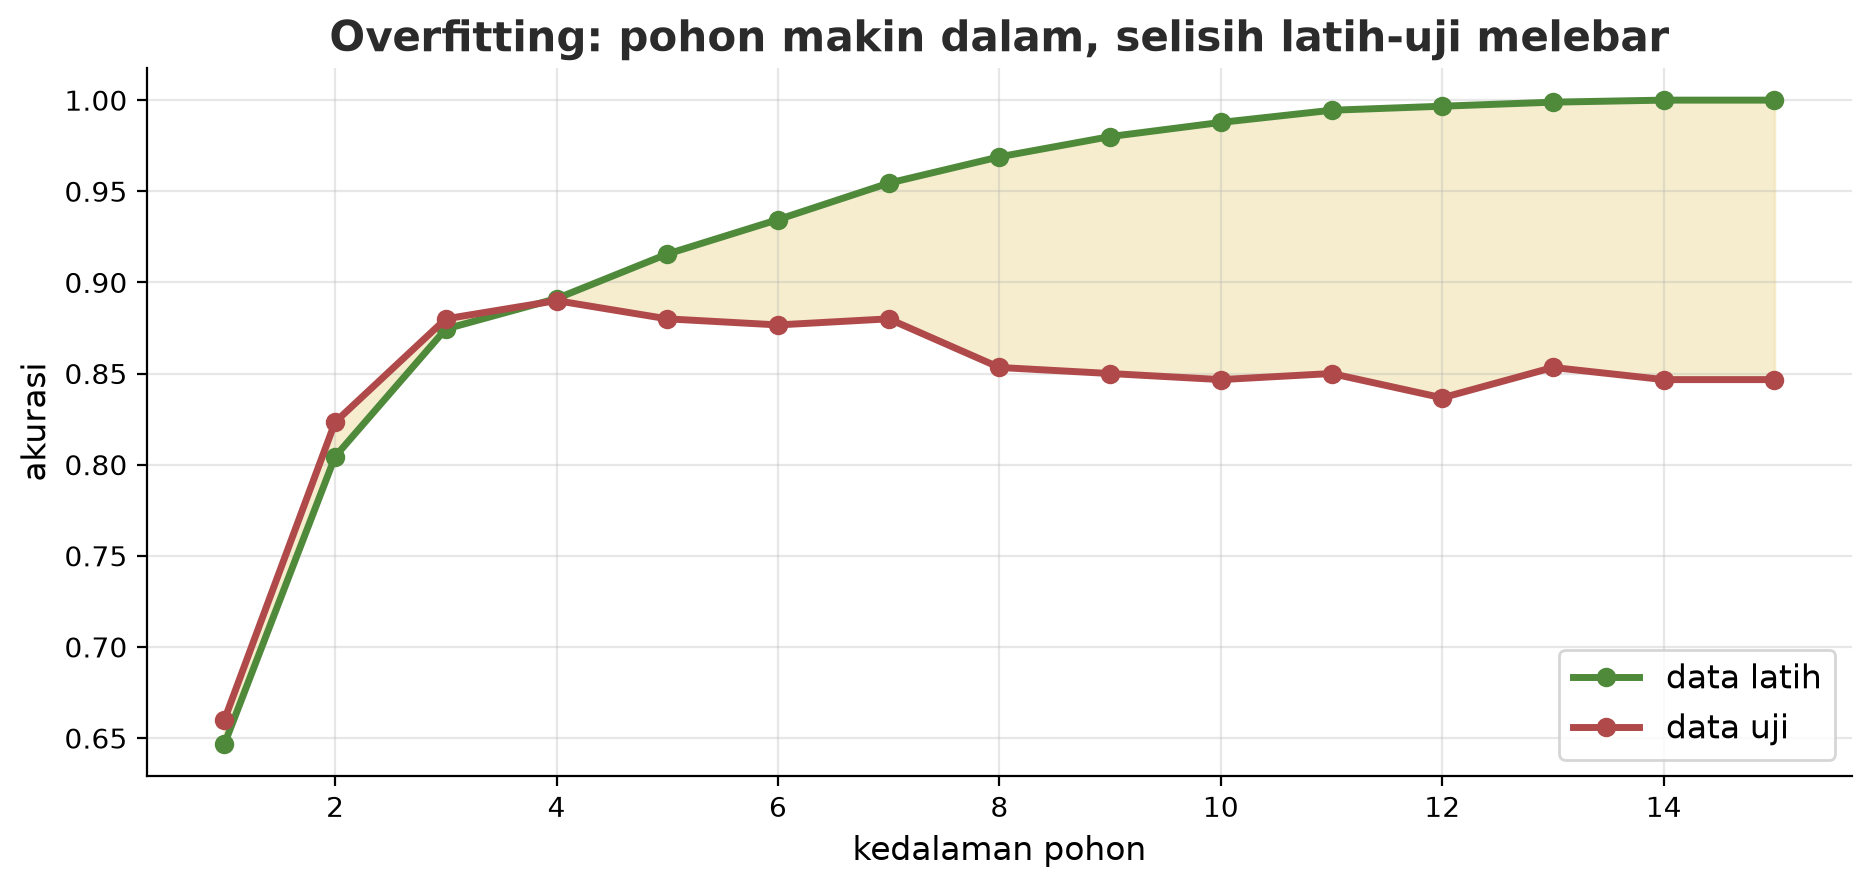
Akurasi tinggi pada data latih tidak membuktikan apa-apa. Yang penting adalah nilai pada data yang belum pernah dilihat model. Jangan pernah melaporkan nilai data latih sebagai kemampuan model.
Random forest: banyak pohon, satu suara
Satu pohon mudah salah. Random forest (hutan acak) membuat ratusan pohon, tiap pohon dilatih pada contoh data yang diacak ulang dan memilih dari sebagian fitur secara acak. Hasil akhir diambil dengan voting. Seperti rapat desa: satu orang bisa keliru, tetapi suara mayoritas biasanya lebih bijak.
03_random_forest.py
# Bab 54 - Random forest: banyak pohon "voting", plus pentingnya fitur
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

from buat_data import FITUR, buat_lahan

df = buat_lahan()
X_latih, X_uji, y_latih, y_uji = train_test_split(
    df[FITUR], df["kelas"], test_size=0.25, random_state=42, stratify=df["kelas"])

satu = DecisionTreeClassifier(random_state=42).fit(X_latih, y_latih)
hutan = RandomForestClassifier(n_estimators=200, oob_score=True, random_state=42, n_jobs=1)
hutan.fit(X_latih, y_latih)

print("Satu pohon (tanpa batas)  - akurasi uji:", round(satu.score(X_uji, y_uji), 3))
print("Random forest 200 pohon   - akurasi uji:", round(hutan.score(X_uji, y_uji), 3))
print("Skor OOB (tanpa data uji) :", round(hutan.oob_score_, 3))

print("\nPentingnya fitur (jumlah = 1):")
for nama, nilai in sorted(zip(FITUR, hutan.feature_importances_), key=lambda p: -p[1]):
    print(f"  {nama:20s} {nilai:.3f}")

print("\nLaporan per kelas:")
print(classification_report(y_uji, hutan.predict(X_uji), digits=2))
Satu pohon (tanpa batas) - akurasi uji: 0.847
Random forest 200 pohon - akurasi uji: 0.897
Skor OOB (tanpa data uji) : 0.892
Pentingnya fitur (jumlah = 1):
ndvi 0.462
elevasi_m 0.282
kemiringan_derajat 0.190
curah_hujan_mm 0.066
Laporan per kelas:
precision recall f1-score support
hutan 0.96 0.94 0.95 50
kebun 0.77 0.83 0.80 36
permukiman 0.94 0.94 0.94 133
sawah 0.85 0.83 0.84 81
accuracy 0.90 300
macro avg 0.88 0.89 0.88 300
weighted avg 0.90 0.90 0.90 300- Satu pohon tanpa batas: 0,847. Random forest 200 pohon: 0,897. Menggabungkan banyak pohon meredam overfitting.
- Skor OOB (out-of-bag, 0,892) adalah ujian gratis: tiap pohon tidak melihat sekitar sepertiga data, dan data itulah yang dipakai menilainya. Hasilnya mendekati akurasi uji, jadi tanpa data uji pun kita punya perkiraan jujur.
- Pentingnya fitur:
ndvipaling berpengaruh (0,462), curah hujan paling sedikit (0,066). Jumlah semuanya 1. Ini rata-rata seberapa besar tiap fitur mengurangi ketidakmurnian di semua pohon. - Laporan per kelas:
precision(dari yang ditebak sawah, berapa yang benar) danrecall(dari semua sawah sebenarnya, berapa yang tertangkap). Kelaskebunpaling sulit (f1 0,80), karena mirip sawah dan hutan.
Pentingnya fitur bawaan random forest bisa menyesatkan bila fitur saling berkorelasi (NDVI dan elevasi sering berhubungan). Bab 58 mengajarkan cara yang lebih adil: SHAP dan permutation importance.
Gradient boosting: belajar dari kesalahan
Random forest membuat pohon sejajar (independen). Gradient boosting membuat pohon berurutan: pohon kedua dilatih khusus untuk memperbaiki kesalahan pohon pertama, pohon ketiga memperbaiki sisa kesalahan keduanya, dan seterusnya. Seperti petani yang tiap musim memperbaiki kesalahan musim lalu.
Tiga implementasi populer: GradientBoostingClassifier (scikit-learn), XGBoost, dan LightGBM. Ketiganya dipakai dengan pola .fit() dan .score() yang sama.
04_boosting.py
# Bab 54 - Gradient boosting: pohon kecil ditambahkan satu per satu untuk memperbaiki kesalahan
from lightgbm import LGBMClassifier
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import LabelEncoder
from xgboost import XGBClassifier

from buat_data import FITUR, buat_lahan

df = buat_lahan()
kode = LabelEncoder().fit(df["kelas"])            # XGBoost butuh kelas berupa angka 0,1,2,3
y = kode.transform(df["kelas"])
X_latih, X_uji, y_latih, y_uji = train_test_split(
    df[FITUR], y, test_size=0.25, random_state=42, stratify=y)

model = {
    "sklearn GradientBoosting": GradientBoostingClassifier(n_estimators=100, max_depth=3, random_state=42),
    "XGBoost": XGBClassifier(n_estimators=100, max_depth=3, learning_rate=0.1, random_state=42, n_jobs=1),
    "LightGBM": LGBMClassifier(n_estimators=100, max_depth=3, learning_rate=0.1, random_state=42,
                               n_jobs=1, verbose=-1),
}
for nama, m in model.items():
    m.fit(X_latih, y_latih)
    print(f"{nama:26s} akurasi uji = {m.score(X_uji, y_uji):.3f}")
print("Urutan kelas (angka -> nama):", list(kode.classes_))
sklearn GradientBoosting akurasi uji = 0.890
XGBoost akurasi uji = 0.890
LightGBM akurasi uji = 0.897
Urutan kelas (angka -> nama): ['hutan', 'kebun', 'permukiman', 'sawah']Ketiganya hampir sama (0,890 sampai 0,897) di data kecil ini. XGBoost dan LightGBM unggul bila data besar (puluhan ribu baris ke atas) karena sangat cepat dan punya banyak fitur (penanganan nilai kosong, penghentian dini). Catatan: XGBoost menuntut label berupa angka, maka kelas diubah dulu oleh LabelEncoder.
SVM dan k-means
SVM (support vector machine) mencari batas pemisah terbaik antar-kelas. k-means adalah pengelompokan tanpa label: ia hanya mengumpulkan petak yang mirip menjadi k gugus. Keduanya peka terhadap skala angka: elevasi (ratusan) akan “mengalahkan” NDVI (di bawah 1) kecuali kita menyamakan skalanya dengan StandardScaler.
05_svm_kmeans.py
# Bab 54 - SVM (dengan penskalaan) dan k-means (tanpa label)
from sklearn.cluster import KMeans
from sklearn.metrics import adjusted_rand_score
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

from buat_data import FITUR, buat_lahan

df = buat_lahan()
X_latih, X_uji, y_latih, y_uji = train_test_split(
    df[FITUR], df["kelas"], test_size=0.25, random_state=42, stratify=df["kelas"])

tanpa_skala = SVC(kernel="rbf").fit(X_latih, y_latih)
dengan_skala = make_pipeline(StandardScaler(), SVC(kernel="rbf")).fit(X_latih, y_latih)
print("SVM tanpa penskalaan - akurasi uji:", round(tanpa_skala.score(X_uji, y_uji), 3))
print("SVM dengan penskalaan - akurasi uji:", round(dengan_skala.score(X_uji, y_uji), 3))

# k-means TIDAK diberi label; ia hanya mengelompokkan petak yang mirip
X_skala = StandardScaler().fit_transform(df[FITUR])
km = KMeans(n_clusters=4, n_init=10, random_state=42).fit(X_skala)
df["gugus"] = km.labels_
print("\nTabel silang gugus k-means (baris) x kelas sebenarnya (kolom):")
print(df.groupby(["gugus", "kelas"]).size().unstack(fill_value=0).to_string())
print("Adjusted Rand Index (1 = cocok sempurna):", round(adjusted_rand_score(df["kelas"], df["gugus"]), 3))
SVM tanpa penskalaan - akurasi uji: 0.617
SVM dengan penskalaan - akurasi uji: 0.913
Tabel silang gugus k-means (baris) x kelas sebenarnya (kolom):
kelas hutan kebun permukiman sawah
gugus
0 0 1 215 94
1 195 18 0 0
2 0 3 313 154
3 3 124 2 78
Adjusted Rand Index (1 = cocok sempurna): 0.367- SVM tanpa penskalaan hanya 0,617, dengan penskalaan 0,913. Satu baris tambahan mengubah segalanya.
- k-means tidak pernah melihat label. Gugus 1 hampir murni
hutan(195 dari 213 petak), tetapisawahdanpermukimanbercampur di gugus 0 dan 2. Adjusted Rand Index 0,367 (1 = cocok sempurna) menunjukkan gugus tak berlabel bukan pengganti klasifikasi berlabel, tetapi berguna untuk eksplorasi awal.
Pohon, random forest, dan boosting tidak butuh penskalaan karena mereka hanya membandingkan “lebih besar atau lebih kecil dari ambang”. SVM, k-means, regresi, dan jaringan saraf butuh.
Validasi silang
Satu kali bagi latih/uji bergantung pada keberuntungan pembagiannya. Validasi silang (cross-validation) membagi data menjadi k lipatan (fold), lalu bergiliran memakai satu lipatan untuk menguji dan sisanya untuk melatih.
06_validasi_silang.py
# Bab 54 - Validasi silang: menguji model berkali-kali pada potongan data yang berbeda
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import KFold, cross_val_score

from buat_data import FITUR, buat_lahan

df = buat_lahan()
X, y = df[FITUR], df["kelas"]
model = RandomForestClassifier(n_estimators=100, random_state=42, n_jobs=1)

lipatan = KFold(n_splits=5, shuffle=True, random_state=42)
skor = cross_val_score(model, X, y, cv=lipatan, scoring="accuracy")
print("Akurasi tiap lipatan:", skor.round(3))
print(f"Rata-rata = {skor.mean():.3f}   simpangan baku = {skor.std():.3f}")
Akurasi tiap lipatan: [0.879 0.888 0.888 0.888 0.912]
Rata-rata = 0.891 simpangan baku = 0.011Lima lipatan, lima nilai (0,879 sampai 0,912), rata-rata 0,891. Simpangan baku 0,011 memberi rasa seberapa stabil modelnya. Melaporkan “0,891 ± 0,011” jauh lebih jujur daripada satu angka.
Data spasial: lipatan acak itu curang
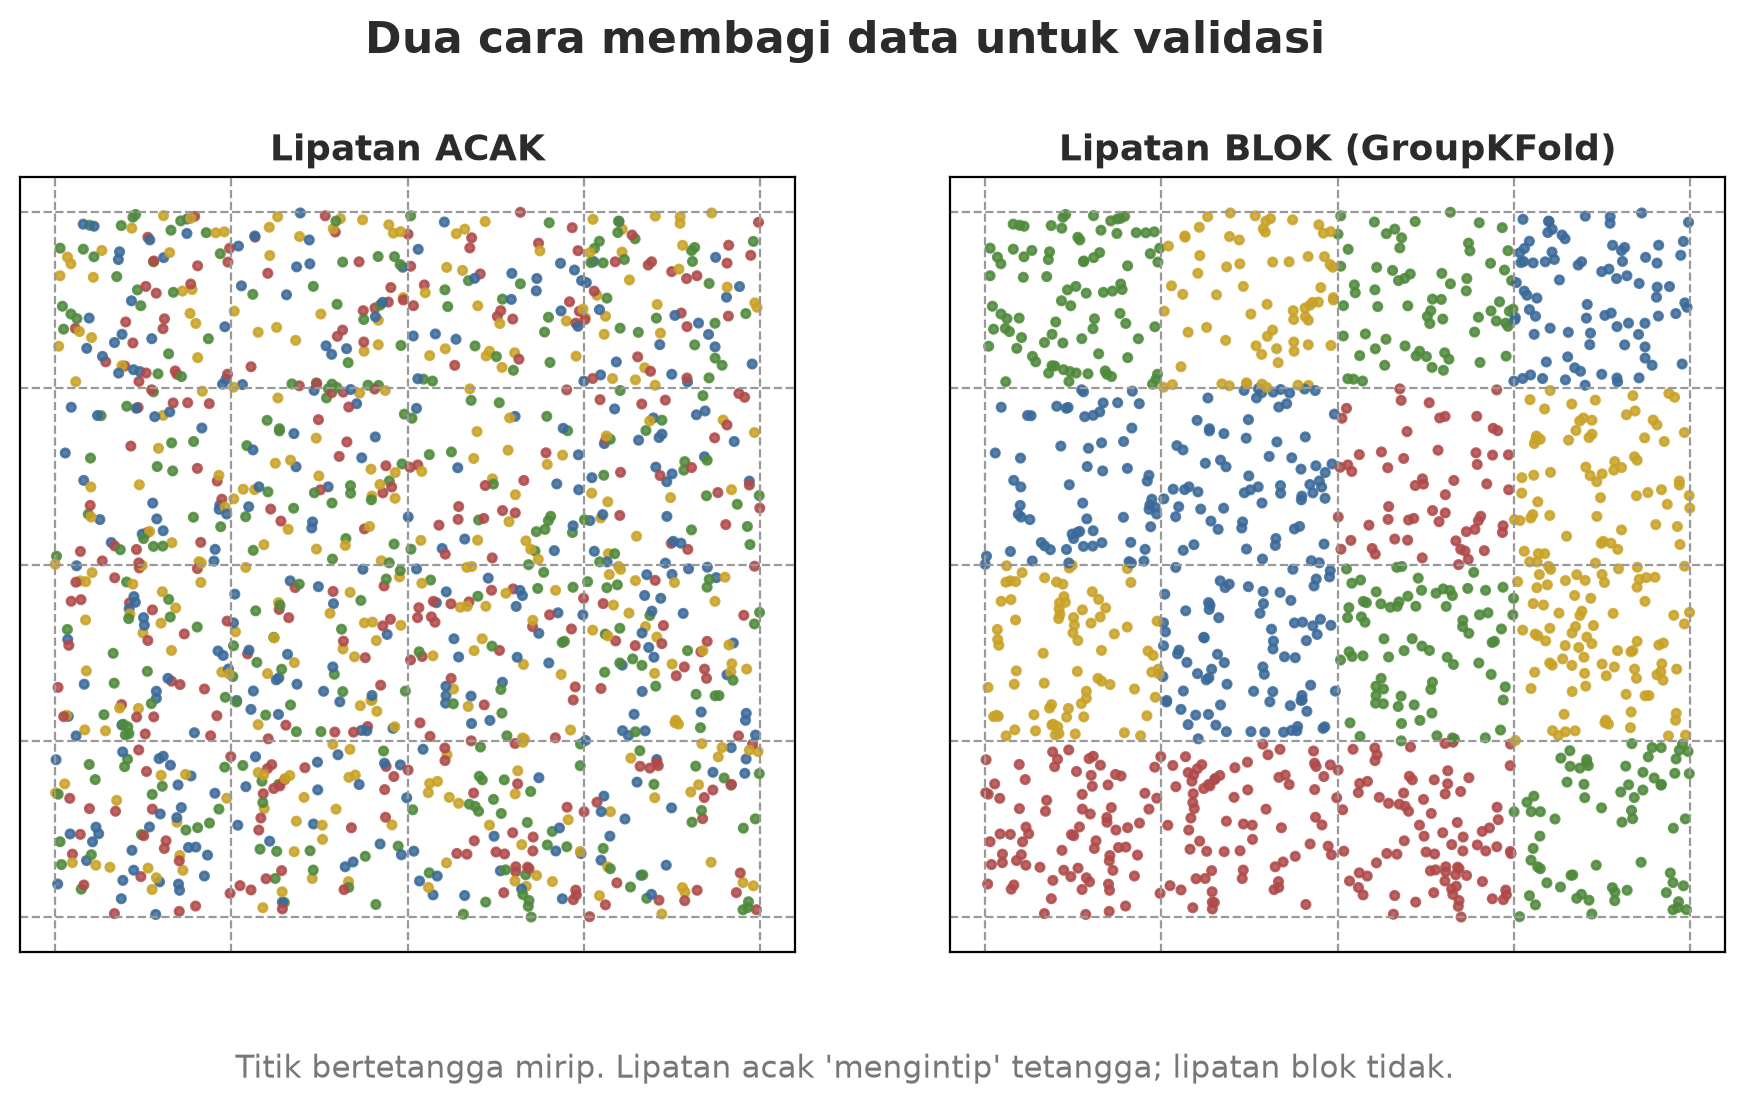
Hukum pertama geografi: segala sesuatu berhubungan dengan segala sesuatu lainnya, tetapi yang berdekatan lebih berhubungan. Karena petak bertetangga mirip, lipatan acak menaruh tetangga kembar di lipatan latih dan uji: model “mengintip” tetangganya. Nilainya terlalu bagus untuk dipakai di wilayah baru.
Obatnya: spatial cross-validation. Bagi peta menjadi blok (sel grid), lalu pastikan satu blok utuh berada di lipatan yang sama. Di scikit-learn, pakai GroupKFold dengan kolom blok sebagai groups.
07_spatial_cv.py
# Bab 54 - Validasi silang spasial: lipatan menurut blok geografis (GroupKFold pada sel grid)
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GroupKFold, KFold, cross_val_score

from buat_data import FITUR, buat_lahan

df = buat_lahan()
y = df["kelas"]
model = RandomForestClassifier(n_estimators=100, random_state=42, n_jobs=1)
print("Jumlah blok (sel grid 250 m):", df["blok"].nunique())

for judul, kolom in [("fitur citra saja", FITUR), ("fitur + koordinat x,y", FITUR + ["x", "y"])]:
    acak = cross_val_score(model, df[kolom], y, cv=KFold(5, shuffle=True, random_state=42))
    blok = cross_val_score(model, df[kolom], y, groups=df["blok"], cv=GroupKFold(n_splits=4))
    print(f"\n{judul}")
    print(f"  lipatan ACAK: akurasi = {acak.mean():.3f}")
    print(f"  lipatan BLOK: akurasi = {blok.mean():.3f}")
Jumlah blok (sel grid 250 m): 16
fitur citra saja
lipatan ACAK: akurasi = 0.891
lipatan BLOK: akurasi = 0.885
fitur + koordinat x,y
lipatan ACAK: akurasi = 0.923
lipatan BLOK: akurasi = 0.873- Dengan fitur citra saja, selisih acak vs blok kecil (0,891 vs 0,885), karena hubungan fitur ke kelas relatif sama di seluruh peta.
- Begitu koordinat x, y ikut jadi fitur, lipatan acak melonjak ke 0,923 (model menghafal “di titik sekian kelasnya begini”) tetapi lipatan blok turun ke 0,873, bahkan di bawah model tanpa koordinat. Itu kebocoran spasial yang nyata.
Bila model akan dipakai di wilayah lain atau waktu lain, uji dengan cara itu: lipatan blok untuk wilayah, lipatan per tahun untuk waktu. Ukuran blok sebaiknya lebih besar dari jarak mirip antar-petak. Blok yang terlalu kecil masih bocor.
Kapan ML klasik lebih baik daripada deep learning?
| Situasi | Pilihan yang biasanya tepat |
|---|---|
| Data tabel (kolom angka), ribuan sampai ratusan ribu baris | ML klasik (random forest, boosting) |
| Data sedikit, anggaran terbatas, tanpa GPU | ML klasik |
| Perlu penjelasan (“mengapa petak ini sawah?”) | ML klasik (pohon mudah dijelaskan) |
| Data citra mentah, suara, teks panjang | Deep learning (Bab 55 dan 56) |
| Data jutaan contoh dan pola sangat rumit | Deep learning |
Aturan praktis: untuk data tabel, mulailah dari random forest atau LightGBM. Hanya bila terbukti kurang, pertimbangkan model yang lebih berat. Pengalaman banyak praktisi menunjukkan model berbasis pohon sering sulit dikalahkan pada data tabel.
Proyek Bersambung A3: tutupan lahan dan hasil panen
Kita satukan semuanya: (1) klasifikasi tutupan lahan dengan random forest dinilai lipatan blok, (2) prediksi hasil panen sawah (angka contoh, bukan anjuran budidaya) dengan random forest dibanding regresi linear.
08_proyek_rf_lahan_panen.py
# Bab 54 - Proyek A3: random forest untuk tutupan lahan (klasifikasi) dan hasil panen (regresi)
import numpy as np
from sklearn.ensemble import RandomForestClassifier, RandomForestRegressor
from sklearn.linear_model import LinearRegression
from sklearn.metrics import confusion_matrix
from sklearn.model_selection import GroupKFold, cross_val_predict, cross_val_score

from buat_data import FITUR, buat_lahan

df = buat_lahan()
lipat = GroupKFold(n_splits=4)

# 1) Klasifikasi tutupan lahan, dinilai dengan lipatan BLOK
rf = RandomForestClassifier(n_estimators=200, random_state=42, n_jobs=1)
prediksi = cross_val_predict(rf, df[FITUR], df["kelas"], groups=df["blok"], cv=lipat)
nama = sorted(df["kelas"].unique())
print("Matriks kebingungan (baris = sebenarnya, kolom = prediksi):", nama)
print(confusion_matrix(df["kelas"], prediksi, labels=nama))
print("Akurasi (blok):", round((prediksi == df["kelas"]).mean(), 3))

# 2) Regresi hasil panen sawah (angka contoh): hubungan dibuat melengkung supaya model linear kesulitan
rng = np.random.default_rng(7)
sawah = df[df["kelas"] == "sawah"].copy()
sawah["panen_kg_ha"] = (4000 + 5000 * np.sin(np.pi * sawah["ndvi"].clip(0, 1))
                        + 0.8 * (sawah["curah_hujan_mm"] - 2200) + rng.normal(0, 250, len(sawah))).round(0)
kolom = ["ndvi", "curah_hujan_mm", "elevasi_m"]
for nama_model, model in [("Regresi linear", LinearRegression()),
                          ("Random forest ", RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=1))]:
    r2 = cross_val_score(model, sawah[kolom], sawah["panen_kg_ha"], groups=sawah["blok"],
                         cv=GroupKFold(n_splits=4), scoring="r2")
    print(f"{nama_model}: R2 lipatan blok = {r2.mean():.3f}")
print("Jumlah petak sawah:", len(sawah))
Matriks kebingungan (baris = sebenarnya, kolom = prediksi): ['hutan', 'kebun', 'permukiman', 'sawah']
[[186 12 0 0]
[ 12 115 1 18]
[ 0 0 491 39]
[ 0 15 41 270]]
Akurasi (blok): 0.885
Regresi linear: R2 lipatan blok = 0.130
Random forest : R2 lipatan blok = 0.758
Jumlah petak sawah: 326- Matriks kebingungan: diagonal adalah tebakan benar. Kesalahan terbanyak: 41 petak
sawahditebakpermukimandan 39 sebaliknya; 18kebunditebaksawah. Pola kesalahan memberi tahu kelas mana yang perlu fitur tambahan (mis. citra musim lain). - Hasil panen: regresi linear hanya R² 0,130 (nilai 1 = sempurna), random forest 0,758. Di data ini hubungan NDVI ke panen melengkung (naik lalu turun), dan model linear tidak bisa menirunya. Karena kita memakai blok untuk validasi, angka 0,758 lebih bisa dipercaya untuk wilayah baru.
- Ada 326 petak sawah di data tiruan ini.
Model dan pengetahuan bab ini dipakai lagi di Bab 58 (penjelasan SHAP, pelacakan MLflow) dan Bab 59 (dari citra satelit ke peta).
Latihan
- Ubah
max_depthdi01_pohon_keputusan.pymenjadi 2 dan 4. Bagaimana aturan dan akurasi ujinya berubah? - Di
03_random_forest.py, gantin_estimators=200dengan 10, 50, dan 500. Apakah skor OOB terus naik? Berapa jumlah pohon yang “cukup”? - Di
05_svm_kmeans.py, ubahn_clustersmenjadi 3 dan 6 lalu lihat tabel silangnya. Apakah gugus baru menemukan kelompok yang bermakna? - Tantangan: di
07_spatial_cv.py, ubah ukuran blok menjadi sel 500 m (2 x 2 blok; hitung ulang kolomblok) dan bandingkan hasilnya dengan sel 250 m. Mana yang lebih tajam membedakan lipatan acak dan lipatan blok?
Ringkasan Bab
- ML mencari aturan dari contoh; model klasik cocok untuk data tabel dan mudah dijelaskan.
- Pohon mudah dibaca tetapi mudah menghafal; random forest (paralel) dan gradient boosting (berurutan) lebih kuat.
- Overfitting: nilai latih tinggi, nilai uji rendah. Periksa dengan data uji dan validasi silang.
- SVM dan k-means butuh penskalaan; pohon tidak.
- Pada data spasial, pakai validasi silang blok (
GroupKFold); koordinat sebagai fitur membuat lipatan acak menipu.
Selanjutnya, di Bab 55: kita masuk ke dunia deep learning: alur kerja ML, PyTorch, dan perangkat keras (GPU, CUDA, VRAM) yang membuat jaringan saraf bisa dilatih dalam menit, bukan hari.