Bab 60 — Aplikasi LLM dan MLOps: Asisten yang Menjawab dari Dokumen Anda
Seri A4 — AI Generatif dan Agent AI
Semua skrip bab ini ada di folder kode/bab60/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
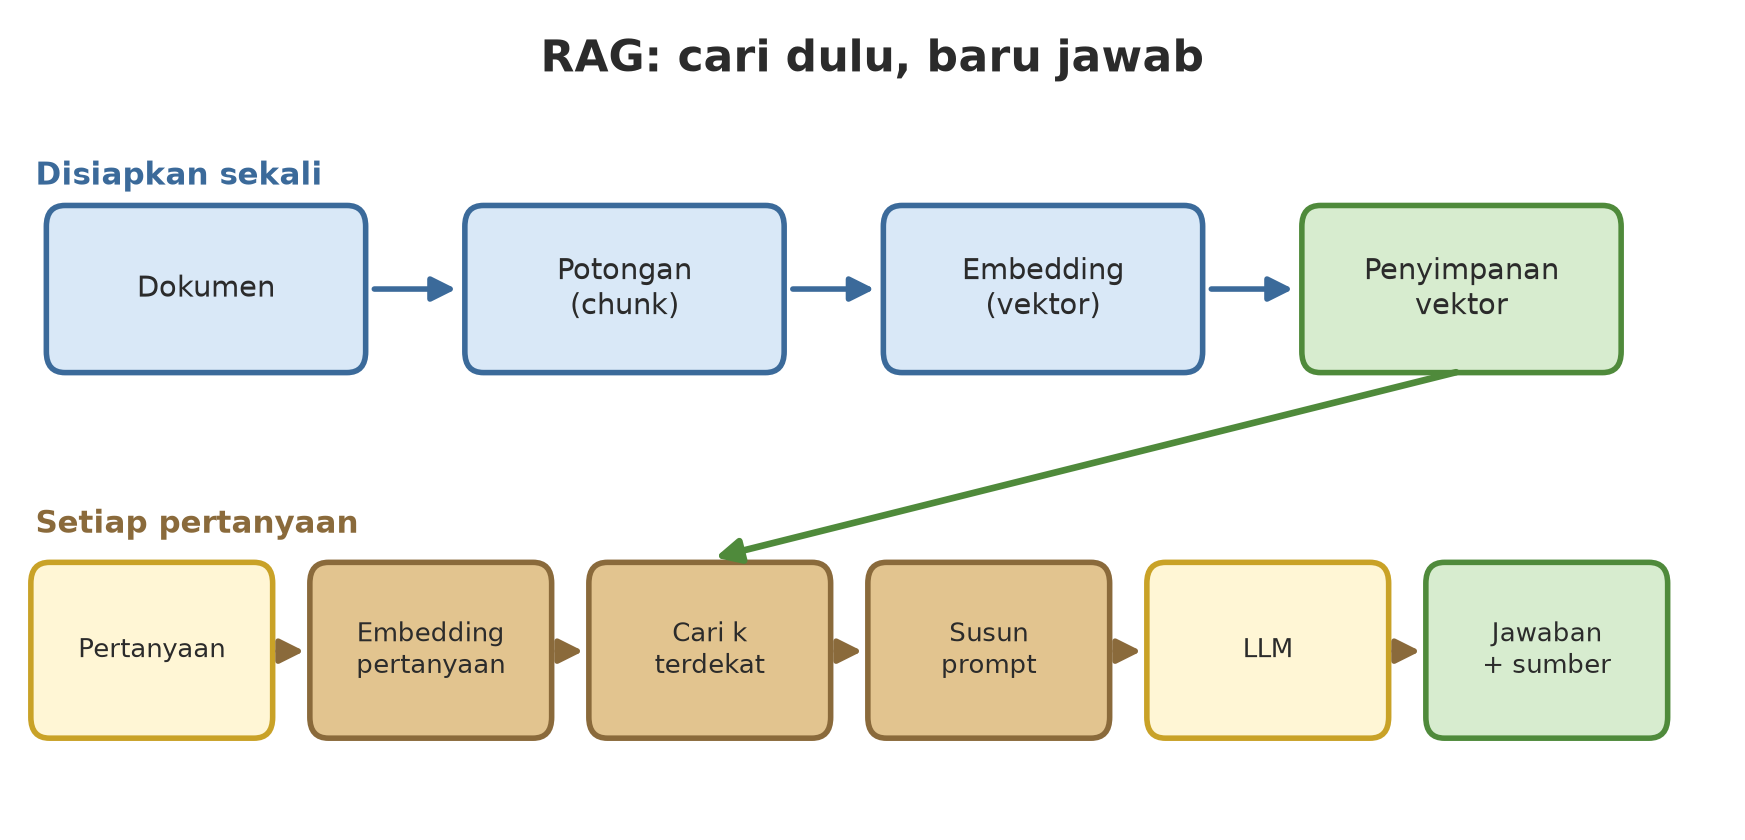
Seri A3 mengajari model memprediksi: tutupan lahan, panen, penyakit daun. Sekarang kita masuk ke model yang bisa diajak bicara. Bayangkan seorang mandor baru bertanya, “Jarak tanam jati berapa meter?” Mandor lama tidak menjawab dari ingatan yang samar-samar; ia membuka buku SOP, menemukan halamannya, lalu membacakan jawabannya. Itulah RAG: model bahasa tidak diminta mengingat, tetapi diberi buku untuk dibuka dulu.
Cara bab ini jujur kepada Anda. Model bahasa besar sungguhan hanya bisa dipakai lewat akun berbayar, atau dijalankan di komputer yang kuat. Bab ini tidak memakai akun atau kunci API apa pun. Untuk bagian yang bisa dijalankan, kita membuat LLM tiruan buatan sendiri: program kecil yang berpura-pura menjadi model bahasa dengan aturan sederhana, sehingga hasilnya selalu sama dan bisa diuji. LLM tiruan bukan model bahasa sungguhan dan tidak bisa menalar. Ia berguna untuk satu hal: memperlihatkan seluruh alur sistem (cari, susun prompt, jawab, evaluasi) dengan keluaran asli yang bisa Anda ulang di komputer sendiri.
Memakai LLM lewat API
Penyedia model bahasa umumnya menawarkan API (pintu layanan lewat internet, lihat Bab 21): Anda mengirim pertanyaan lewat HTTP, penyedia mengirim jawaban. Kodenya seperti ini:
01_panggil_api.py
# Bab 60 - Memanggil model bahasa lewat API HTTP
import os

import httpx

ALAMAT = os.environ["LLM_API_URL"]       # alamat layanan, dari dokumentasi penyedia
KUNCI = os.environ["LLM_API_KEY"]        # nilainya [disamarkan]; jangan pernah ditulis di kode


def tanya_model(pertanyaan, model="nama-model-dari-penyedia"):
    badan = {
        "model": model,
        "messages": [{"role": "user", "content": pertanyaan}],
        "max_tokens": 300,
        "temperature": 0.0,
    }
    balasan = httpx.post(
        ALAMAT,
        headers={"Authorization": f"Bearer {KUNCI}"},
        json=badan,
        timeout=30,
    )
    balasan.raise_for_status()
    return balasan.json()


# Bentuk badan permintaan dan balasan berbeda antarpenyedia. Baca dokumentasinya.
# hasil = tanya_model("Apa jarak tanam jati?")
Kode ini tidak dijalankan saat buku dibuat karena butuh akun dan kunci API milik pembaca serta koneksi ke layanan luar, jadi keluarannya tidak ditampilkan.
Perhatikan tiga hal:
- Kunci dibaca dari variabel lingkungan (
os.environ["LLM_API_KEY"]), tidak pernah ditulis di kode. Kode yang tersimpan di Git atau terkirim ke orang lain tidak boleh membawa kunci. Di buku ini nilainya selalu[disamarkan]. - Bentuk badan permintaan berbeda-beda antarpenyedia (nama kolom, nama model, cara menghitung token). Contoh di atas hanya kerangka; ikuti dokumentasi penyedia yang Anda pilih.
temperature=0.0meminta jawaban paling “pasti” (kurang acak). Kita bahas artinya di Bab 61.
Memakai API berarti pertanyaan dan dokumen Anda dikirim ke pihak lain. Sebelum mengirim data kantor atau data pribadi, baca syarat penyedia dan lihat Bab 63.
LLM tiruan: model palsu yang bisa diuji
Agar kita bisa bereksperimen tanpa akun, kita buat kelas LLMTiruan (ada di kode/bab60/pustaka/tiruan.py). Cara kerjanya sederhana: dari bagian KONTEKS pada prompt, ia memilih satu kalimat yang kata-katanya paling banyak sama dengan pertanyaan, lalu menambahkan nomor sumbernya. Bila tidak ada yang cukup mirip, ia menjawab bahwa jawabannya tidak ada.
02_llm_tiruan.py
# Bab 60 - LLM tiruan: model bahasa palsu yang bisa diuji
from pustaka.tiruan import LLMTiruan

llm = LLMTiruan()

prompt = """Jawab hanya berdasarkan KONTEKS.
KONTEKS:
[1] Padi ditanam dengan jarak 25 x 25 sentimeter. Pemupukan susulan pada umur 21 hari setelah tanam.
PERTANYAAN: Kapan pemupukan susulan padi diberikan?"""

print("Dengan konteks   :", llm.jawab(prompt))
print("Diulang          :", llm.jawab(prompt) == llm.jawab(prompt))

tanpa_jawaban = prompt.replace("Kapan pemupukan susulan padi diberikan?", "Berapa harga kakao hari ini?")
print("Pertanyaan di luar dokumen:", llm.jawab(tanpa_jawaban))

print("Tanpa konteks    :", llm.jawab("Berapa jarak tanam jati?"))
Dengan konteks : Pemupukan susulan pada umur 21 hari setelah tanam. [1]
Diulang : True
Pertanyaan di luar dokumen: Maaf, jawabannya tidak ada di dokumen yang diberikan.
Tanpa konteks : Jarak tanam jati yang paling baik adalah 5 x 5 meter.Telusuri hasilnya:
- Dengan konteks: kalimat yang paling mirip dengan “kapan pemupukan susulan padi diberikan” dipilih dan diberi nomor
[1]. - Diulang:
True. Masukan sama, jawaban sama. Itu syarat agar bisa diuji; model sungguhan kadang menjawab berbeda untuk pertanyaan yang sama. - Pertanyaan di luar dokumen: ditolak dengan sopan, tidak mengarang.
- Tanpa konteks: baris terakhir meniru kebiasaan buruk model sungguhan. Tanpa buku di tangan, ia menjawab “5 x 5 meter” dengan percaya diri, padahal dokumen kita berkata 3 x 3 meter. Inilah halusinasi (jawaban meyakinkan tetapi tidak berdasar), dan RAG dibuat untuk mengurangi masalah ini. Angka 5 x 5 itu karangan penulis untuk tiruan, bukan fakta tentang jati.
Menyiapkan dokumen: potongan (chunk)
Dokumen asli bisa berhalaman-halaman, sedangkan prompt punya batas panjang dan setiap token ada harganya. Karena itu dokumen dipotong menjadi potongan (chunk) kecil, dan hanya potongan yang relevan yang dikirim ke model.
03_potong_dokumen.py
# Bab 60 - Memotong dokumen panjang menjadi potongan (chunk)
from pustaka.dokumen import DOKUMEN


def potong(teks, ukuran, tumpang):
    """Potong teks per `ukuran` karakter; tiap potongan mengulang `tumpang` karakter terakhir sebelumnya."""
    hasil, awal = [], 0
    while awal < len(teks):
        hasil.append(teks[awal:awal + ukuran])
        if awal + ukuran >= len(teks):
            break
        awal += ukuran - tumpang
    return hasil


panjang = " ".join(d["isi"] for d in DOKUMEN[:3])
print("Panjang dokumen:", len(panjang), "karakter")

for ukuran, tumpang in [(150, 0), (150, 30)]:
    potongan = potong(panjang, ukuran, tumpang)
    print(f"ukuran={ukuran} tumpang={tumpang} -> {len(potongan)} potongan")

print()
for p in potong(panjang, 150, 30)[:3]:
    print(repr(p))
Panjang dokumen: 644 karakter
ukuran=150 tumpang=0 -> 5 potongan
ukuran=150 tumpang=30 -> 6 potongan
'Penanaman jati dilakukan pada awal musim hujan dengan jarak tanam 3 x 3 meter. Lubang tanam berukuran 30 x 30 x 30 sentimeter. Penyulaman bibit yang m'
'meter. Penyulaman bibit yang mati dilakukan paling lambat 30 hari setelah tanam. Inventarisasi pohon mengukur diameter setinggi dada, yaitu 1,3 meter '
'etinggi dada, yaitu 1,3 meter dari tanah. Pohon dengan diameter di bawah 10 sentimeter tidak dicatat dalam inventarisasi tegakan. Setiap pohon dicatat'Dokumen gabungan tiga SOP kehutanan panjangnya 644 karakter. Dengan ukuran 150 tanpa tumpang tindih, ada 5 potongan. Dengan tumpang tindih (overlap) 30 karakter, ada 6, karena tiap potongan mengulang ekor potongan sebelumnya. Lihat tiga potongan pertama: kalimat “Penyulaman bibit yang mati…” terbelah di tengah, tetapi potongan berikutnya mengulang awalnya sehingga maknanya tidak hilang. Itulah gunanya tumpang tindih.
Memilih ukuran potongan adalah seni: terlalu kecil membuat konteks kehilangan makna, terlalu besar membuat pencarian kabur dan biaya naik. Untuk dokumen SOP yang rapi, memotong per paragraf atau per butir biasanya lebih baik daripada per karakter. Di proyek bab ini, setiap SOP memang sudah berupa satu paragraf, jadi satu SOP = satu potongan. Dokumen contohnya (12 SOP kehutanan, pertanian, perikanan, peternakan) ada di kode/bab60/pustaka/dokumen.py. Semuanya fiktif; angka di dalamnya contoh, bukan anjuran teknis.
Embedding: mengubah teks menjadi angka
Komputer tidak bisa membandingkan makna kalimat secara langsung, tetapi bisa membandingkan angka. Embedding adalah cara mengubah teks menjadi deretan angka (vektor) sehingga teks yang mirip punya vektor yang berdekatan. “Berdekatan” diukur dengan kemiripan kosinus: sudut antara dua vektor (1 = searah, 0 = tidak berhubungan).
Model embedding sungguhan (misalnya yang dipakai pustaka sentence-transformers) memahami kemiripan makna, bahkan antar-bahasa. Tetapi mengunduh model semacam itu butuh puluhan megabita atau lebih, sedangkan aturan penulisan buku ini melarang mengunduh bobot berukuran 50 MB ke atas. Sebagai pengganti yang dijelaskan jujur, kita pakai TF-IDF dari scikit-learn: ia hanya menghitung kata (atau potongan huruf) yang sama, dengan bobot lebih besar untuk kata yang jarang. TF-IDF tidak memahami makna; “sapi” dan “ternak besar” tidak dianggap mirip. Meski begitu ia cukup baik untuk dokumen kecil dan cepat dihitung, dan seluruh alur di bawah ini sama persis bila Anda mengganti TF-IDF dengan model embedding sungguhan.
04_embedding_tfidf.py
# Bab 60 - Embedding sederhana: TF-IDF dan kemiripan kosinus
from pustaka.dokumen import DOKUMEN
from pustaka.pencari import Pencari

pencari = Pencari(DOKUMEN, jenis="karakter")
print("Bentuk matriks (dokumen, dimensi):", pencari.matriks.shape)

pertanyaan = "Berapa jarak tanam jati?"
vektor = pencari.vektor(pertanyaan)
print("Dimensi vektor pertanyaan:", vektor.shape[0])

print("\nTiga dokumen paling mirip:")
for dok, skor in pencari.cari(pertanyaan, k=3):
    print(f"  {skor:.3f}  {dok['id']:<10} {dok['isi'][:50]}...")
Bentuk matriks (dokumen, dimensi): (12, 2114)
Dimensi vektor pertanyaan: 2114
Tiga dokumen paling mirip:
0.392 HUTAN-01 Penanaman jati dilakukan pada awal musim hujan den...
0.272 TANI-01 Padi ditanam dengan jarak 25 x 25 sentimeter. Pemu...
0.042 HUTAN-03 Patroli kebakaran hutan dilakukan setiap hari pada...Matriks (12, 2114) artinya 12 dokumen, masing-masing diwakili 2.114 angka (satu angka per potongan huruf 3-5 karakter yang pernah muncul). Pertanyaan “Berapa jarak tanam jati?” diubah dengan cara yang sama, lalu dibandingkan. Tiga dokumen terdekat: SOP penanaman jati (0,392), SOP penanaman padi (0,272, karena sama-sama membahas jarak tanam), dan patroli kebakaran (0,042, nyaris tak berhubungan). Selisih besar antara peringkat 1 dan 3 adalah tanda pencarian yakin.
Kami memakai potongan huruf (analyzer="char_wb") agar kata berimbuhan seperti “tanam”, “ditanam”, dan “penanaman” tetap saling mirip, sebab bahasa Indonesia kaya imbuhan. Bandingkan dengan per-kata penuh di bagian evaluasi nanti.
Penyimpanan vektor: FAISS dan Chroma
Untuk 12 dokumen, cukup perkalian matriks. Untuk jutaan potongan, kita butuh penyimpanan vektor (vector store, vector database) yang mencari tetangga terdekat dengan cepat. Dua pilihan yang berjalan di komputer sendiri tanpa server:
- FAISS (
faiss-cpu): pustaka pencari vektor dari Meta. Ia hanya mengurus vektor dan nomor urutnya. - Chroma (
chromadb): basis data vektor yang juga menyimpan teks asli, metadata (label seperti sektor), dan menyimpan ke disk.
Keduanya terpasang di komputer penulis lewat alat/pasang.py (faiss-cpu 1.15.1 dan chromadb 1.5.9, keduanya tersedia untuk Python 3.14).
05_vektor_faiss.py
# Bab 60 - Penyimpanan vektor lokal dengan FAISS
import faiss
import numpy as np

from pustaka.dokumen import DOKUMEN
from pustaka.pencari import Pencari

pencari = Pencari(DOKUMEN)
vektor = pencari.matriks.astype("float32")
indeks = faiss.IndexFlatIP(vektor.shape[1])     # IP = inner product (hasil kali titik)
indeks.add(vektor)
print("Jumlah vektor di indeks:", indeks.ntotal)

q = pencari.vektor("Berapa rentang pH yang baik untuk kolam nila?").astype("float32")[None, :]
skor, nomor = indeks.search(q, 3)
for s, i in zip(skor[0], nomor[0]):
    print(f"  {s:.3f}  {DOKUMEN[i]['id']}")

dari_numpy = [DOKUMEN[i]["id"] for i in np.argsort(-(vektor @ q[0]), kind="stable")[:3]]
print("Sama dengan hitungan numpy:", dari_numpy == [DOKUMEN[i]["id"] for i in nomor[0]])
Jumlah vektor di indeks: 12
0.363 IKAN-02
0.107 IKAN-01
0.070 HUTAN-01
Sama dengan hitungan numpy: TrueIndexFlatIP mencari dengan inner product (hasil kali titik). Karena vektor TF-IDF sudah dinormalkan, hasil kali titik sama dengan kemiripan kosinus. Pertanyaan tentang pH kolam nila menemukan SOP kualitas air nila (0,363) jauh di atas yang kedua (0,107). Baris terakhir membuktikan hasil FAISS sama dengan hitungan numpy biasa; FAISS baru terasa gunanya pada data besar.
06_vektor_chroma.py
# Bab 60 - Basis data vektor lokal dengan Chroma (disimpan di folder _tmp)
import shutil
from pathlib import Path

import chromadb

from pustaka.dokumen import DOKUMEN
from pustaka.pencari import Pencari

folder = Path(__file__).parent / "_tmp" / "chroma"
shutil.rmtree(folder, ignore_errors=True)

pencari = Pencari(DOKUMEN)
klien = chromadb.PersistentClient(path=str(folder))
koleksi = klien.create_collection("sop", embedding_function=None, metadata={"hnsw:space": "cosine"})
koleksi.add(
    ids=[d["id"] for d in DOKUMEN],
    embeddings=pencari.matriks.tolist(),
    documents=[d["isi"] for d in DOKUMEN],
    metadatas=[{"sektor": d["sektor"]} for d in DOKUMEN],
)
print("Jumlah dokumen di koleksi:", koleksi.count())

q = pencari.vektor("Kapan ayam pedaging dipanen?").tolist()
hasil = koleksi.query(query_embeddings=[q], n_results=2)
print("Tanpa filter :", hasil["ids"][0])

hasil = koleksi.query(query_embeddings=[q], n_results=2, where={"sektor": "perikanan"})
print("Filter perikanan:", hasil["ids"][0])
Jumlah dokumen di koleksi: 12
Tanpa filter : ['TERNAK-03', 'IKAN-03']
Filter perikanan: ['IKAN-03', 'IKAN-02']Chroma bisa menyaring dengan metadata. Pertanyaan “Kapan ayam pedaging dipanen?” tanpa filter menemukan SOP ayam (TERNAK-03) lebih dulu. Dengan filter sektor = perikanan, hanya dokumen perikanan yang dicari, jadi hasilnya IKAN-03 dan IKAN-02, yang tentu tidak relevan, tetapi itulah arti filter: ia membatasi ruang pencarian. Berguna bila asisten Anda melayani beberapa unit dan tiap unit hanya boleh melihat dokumennya.
Kita memberi embedding_function=None supaya Chroma memakai vektor TF-IDF buatan kita sendiri. Bila dibiarkan bawaan, Chroma akan mengunduh model embedding, dan itu tidak kita inginkan di sini. Basis datanya disimpan di folder _tmp/chroma.
RAG dasar: cari dulu, baru jawab
Sekarang semua bagian disatukan. Untuk tiap pertanyaan: (1) cari 2 potongan paling mirip, (2) susun prompt berisi aturan, konteks bernomor, dan pertanyaan, (3) kirim ke LLM (di sini tiruan).
07_rag_dasar.py
# Bab 60 - RAG dasar: cari dulu, baru jawab
from pustaka.dokumen import DOKUMEN
from pustaka.pencari import Pencari, bangun_prompt
from pustaka.tiruan import LLMTiruan

pencari = Pencari(DOKUMEN)
llm = LLMTiruan()


def tanya(pertanyaan, k=2):
    potongan = pencari.cari(pertanyaan, k=k)
    prompt = bangun_prompt(pertanyaan, potongan)
    return prompt, llm.jawab(prompt), [d["id"] for d, _ in potongan]


prompt, jawaban, sumber = tanya("Berapa jarak tanam jati?")
print(prompt)
print("-" * 40)
print("Jawaban:", jawaban)
print("Dokumen yang ditemukan:", sumber)

print()
_, jawaban, _ = tanya("Berapa harga pasar kakao hari ini?")
print("Pertanyaan di luar dokumen ->", jawaban)
print("Tanpa RAG, LLM tiruan  ->", llm.jawab("Berapa jarak tanam jati?"))
Jawab hanya berdasarkan KONTEKS. Bila tidak ada, katakan tidak tahu.
KONTEKS:
[1] Penanaman jati dilakukan pada awal musim hujan dengan jarak tanam 3 x 3 meter. Lubang tanam berukuran 30 x 30 x 30 sentimeter. Penyulaman bibit yang mati dilakukan paling lambat 30 hari setelah tanam.
[2] Padi ditanam dengan jarak 25 x 25 sentimeter. Pemupukan dasar diberikan sebelum tanam, dan pemupukan susulan pada umur 21 hari setelah tanam. Dosis pupuk dalam dokumen ini hanya angka contoh.
PERTANYAAN: Berapa jarak tanam jati?
----------------------------------------
Jawaban: Penanaman jati dilakukan pada awal musim hujan dengan jarak tanam 3 x 3 meter. [1]
Dokumen yang ditemukan: ['HUTAN-01', 'TANI-01']
Pertanyaan di luar dokumen -> Maaf, jawabannya tidak ada di dokumen yang diberikan.
Tanpa RAG, LLM tiruan -> Jarak tanam jati yang paling baik adalah 5 x 5 meter.Baca prompt yang tercetak: itulah yang sebenarnya dilihat model. Instruksi pertama (“jawab hanya berdasarkan KONTEKS”) adalah pagar agar model tidak mengarang. Dua potongan ditemukan, yaitu SOP jati [1] dan SOP padi [2] (sama-sama soal jarak tanam). Jawaban mengutip [1] dan kita tahu sumbernya (HUTAN-01); kemampuan menunjukkan sumber adalah kekuatan RAG dibanding model yang menjawab dari ingatan.
Dua baris terakhir memperlihatkan perbedaannya. Pertanyaan tentang harga kakao tidak ada di dokumen, dan sistem menolak. Tanpa RAG, LLM tiruan mengarang “5 x 5 meter” untuk jati.
Mengevaluasi sistem LLM
“Sepertinya bagus” bukan evaluasi. Kita perlu kumpulan pertanyaan uji dengan jawaban yang sudah diketahui, lalu menghitung angka. Ada dua tahap yang dinilai terpisah:
- Pencarian: apakah dokumen yang benar ditemukan? Metriknya hit@1 (dokumen benar di peringkat 1), hit@3 (ada di tiga teratas), dan MRR (mean reciprocal rank: rata-rata dari 1 dibagi peringkat dokumen benar; 1,0 = selalu peringkat 1).
- Jawaban: apakah kutipan menunjuk dokumen yang benar, dan apakah pertanyaan di luar dokumen ditolak?
08_evaluasi_rag.py
# Bab 60 - Mengevaluasi RAG dengan metrik yang bisa dihitung
from pustaka.dokumen import DOKUMEN, PERTANYAAN_UJI
from pustaka.pencari import Pencari, bangun_prompt
from pustaka.tiruan import LLMTiruan

llm = LLMTiruan()
bisa_dijawab = [(p, d) for p, d in PERTANYAAN_UJI if d is not None]


def evaluasi_pencarian(jenis):
    pencari = Pencari(DOKUMEN, jenis=jenis)
    hit1 = hit3 = 0
    mrr = 0.0
    salah = []
    for pertanyaan, benar in bisa_dijawab:
        id_urut = [d["id"] for d, _ in pencari.cari(pertanyaan, k=3)]
        hit1 += id_urut[:1] == [benar]
        if id_urut[:1] != [benar]:
            salah.append(pertanyaan)
        hit3 += benar in id_urut
        if benar in id_urut:
            mrr += 1 / (id_urut.index(benar) + 1)
    n = len(bisa_dijawab)
    return hit1 / n, hit3 / n, mrr / n, salah


print(f"{'vektor':<10} {'hit@1':>6} {'hit@3':>6} {'MRR':>6}")
for jenis in ("kata", "karakter"):
    h1, h3, mrr, salah = evaluasi_pencarian(jenis)
    print(f"{jenis:<10} {h1:>6.2f} {h3:>6.2f} {mrr:>6.2f}")
    for pertanyaan in salah:
        print(f"           peringkat 1 salah: {pertanyaan}")

# Evaluasi jawaban: apakah kutipan [n] menunjuk dokumen yang benar, dan apakah pertanyaan
# di luar dokumen ditolak dengan sopan?
pencari = Pencari(DOKUMEN)
benar_kutipan = ditolak_tepat = 0
for pertanyaan, benar in PERTANYAAN_UJI:
    potongan = pencari.cari(pertanyaan, k=2)
    jawaban = llm.jawab(bangun_prompt(pertanyaan, potongan))
    if benar is None:
        ditolak_tepat += jawaban.startswith("Maaf")
    else:
        nomor = int(jawaban.rsplit("[", 1)[1].rstrip("]")) if jawaban.endswith("]") else 0
        benar_kutipan += nomor > 0 and potongan[nomor - 1][0]["id"] == benar
print()
print(f"Kutipan menunjuk dokumen benar: {benar_kutipan} dari {len(bisa_dijawab)}")
print(f"Pertanyaan di luar dokumen ditolak: {ditolak_tepat} dari 1")
vektor hit@1 hit@3 MRR
kata 1.00 1.00 1.00
karakter 0.91 1.00 0.94
peringkat 1 salah: Seberapa sering penimbangan sapi dilakukan?
Kutipan menunjuk dokumen benar: 9 dari 11
Pertanyaan di luar dokumen ditolak: 1 dari 1Kita punya 11 pertanyaan yang jawabannya ada, ditambah 1 yang memang tidak ada. Hasilnya:
- Vektor per kata menemukan dokumen benar di peringkat 1 untuk semua pertanyaan (hit@1 = 1,00).
- Vektor per potongan huruf salah pada satu pertanyaan (“Seberapa sering penimbangan sapi dilakukan?”): kata umum seperti “dilakukan” muncul di banyak dokumen sehingga mengacaukan skor. Dokumen yang benar tetap masuk tiga teratas (hit@3 = 1,00), tetapi MRR turun ke 0,94. Pelajarannya: tidak ada metode yang selalu menang. Itu sebabnya kita mengukur, bukan menebak.
- Pada jawaban, kutipan hanya benar 9 dari 11. Dua kegagalan bukan salah pencarian: untuk “Bagaimana cara memanen kopi?” dokumen yang benar ditemukan, tetapi LLM tiruan menolak menjawab karena kata “memanen” tidak dianggap mirip “dipanen”. Untuk pertanyaan penimbangan sapi, dokumen yang salah berada di peringkat 1. Memisahkan evaluasi pencarian dari evaluasi jawaban membantu Anda tahu bagian mana yang harus diperbaiki.
- Pertanyaan di luar dokumen ditolak (1 dari 1).
Kumpulan uji yang kecil (12 pertanyaan) hanya cukup untuk belajar. Untuk sistem sungguhan, kumpulkan puluhan sampai ratusan pertanyaan nyata dari pengguna, dan jalankan evaluasi setiap kali Anda mengubah potongan, embedding, atau prompt. Ini seperti uji unit (Bab 18) untuk sistem AI. Pada LLM sungguhan, penilaian jawaban lebih sulit (jawabannya kalimat bebas), dan orang kadang memakai LLM lain sebagai penilai; itu pun harus dicek manusia.
Observability dan biaya
Sistem yang berjalan harus bisa diamati (observability): berapa panggilan, berapa lama, berapa biaya, dan mengapa jawabannya begitu. Cara paling sederhana: bungkus setiap panggilan LLM dengan pencatat yang menulis satu baris JSON.
Biaya LLM umumnya dihitung per token (potongan kecil teks; kita bahas di Bab 61), dengan tarif berbeda untuk token masuk (prompt) dan keluar (jawaban). Skrip berikut memakai tarif tiruan karangan penulis, bukan tarif penyedia mana pun, dan hitungan token yang kasar (kata dan tanda baca). Tokenizer sungguhan menghasilkan angka berbeda; di sistem nyata pakai angka usage yang dikirim penyedia.
09_biaya_observability.py
# Bab 60 - Menghitung token, biaya (tarif TIRUAN), dan mencatat setiap panggilan
import json
import re

from pustaka.dokumen import DOKUMEN
from pustaka.pencari import Pencari, bangun_prompt
from pustaka.tiruan import LLMTiruan

# Tarif karangan penulis, BUKAN tarif penyedia mana pun (Rupiah per 1 juta token)
TARIF_MASUK, TARIF_KELUAR = 5000, 15000


def hitung_token(teks):
    """Hitungan kasar: kata + tanda baca. Tokenizer sungguhan berbeda; pakai angka usage dari penyedia."""
    return len(re.findall(r"\w+|[^\w\s]", teks))


class PencatatPanggilan:
    def __init__(self, llm):
        self.llm, self.catatan = llm, []

    def jawab(self, prompt, tag):
        jawaban = self.llm.jawab(prompt)
        t_masuk, t_keluar = hitung_token(prompt), hitung_token(jawaban)
        biaya = (t_masuk * TARIF_MASUK + t_keluar * TARIF_KELUAR) / 1_000_000
        self.catatan.append({
            "no": len(self.catatan) + 1, "tag": tag,
            "token_masuk": t_masuk, "token_keluar": t_keluar,
            "biaya_rp": round(biaya, 4),
            "latensi_ms_simulasi": 200 + 2 * t_masuk,     # simulasi; latensi nyata diukur dengan jam
        })
        return jawaban


pencari = Pencari(DOKUMEN)
llm = PencatatPanggilan(LLMTiruan())
for tag, pertanyaan in [("padi", "Kapan pemupukan susulan padi diberikan?"),
                        ("lele", "Berapa padat tebar benih lele?"),
                        ("sapi", "Seberapa sering sapi potong ditimbang?")]:
    llm.jawab(bangun_prompt(pertanyaan, pencari.cari(pertanyaan, k=2)), tag)

for baris in llm.catatan:
    print(json.dumps(baris, ensure_ascii=False))

total = sum(b["biaya_rp"] for b in llm.catatan)
print(f"\nTotal biaya 3 panggilan: Rp {total:.4f}")
perkiraan = f"{total / 3 * 10000:,.0f}".replace(",", ".")
print(f"Perkiraan 10.000 pertanyaan per bulan: Rp {perkiraan}")
{"no": 1, "tag": "padi", "token_masuk": 91, "token_keluar": 19, "biaya_rp": 0.74, "latensi_ms_simulasi": 382}
{"no": 2, "tag": "lele", "token_masuk": 78, "token_keluar": 21, "biaya_rp": 0.705, "latensi_ms_simulasi": 356}
{"no": 3, "tag": "sapi", "token_masuk": 77, "token_keluar": 9, "biaya_rp": 0.52, "latensi_ms_simulasi": 354}
Total biaya 3 panggilan: Rp 1.9650
Perkiraan 10.000 pertanyaan per bulan: Rp 6.550Tiap baris adalah satu panggilan: nomor, label, token masuk dan keluar, biaya, dan latensi. Perhatikan bahwa prompt (77 sampai 91 token) jauh lebih besar daripada jawaban (9 sampai 21 token). Pada RAG, biaya sebagian besar datang dari konteks yang dikirim, bukan dari jawaban. Maka memilih jumlah potongan k yang pas langsung memengaruhi tagihan. Dengan tarif tiruan, tiga panggilan menghabiskan Rp 1,965; proyeksi 10.000 pertanyaan per bulan Rp 6.550. Latensi di sini disimulasikan (rumus sederhana) karena LLM tiruan seketika; di sistem nyata ukur dengan jam, dan catat juga jumlah panggilan gagal.
MLOps untuk aplikasi LLM
MLOps adalah kebiasaan merawat sistem ML/AI tetap sehat setelah jadi (Bab 58 membahasnya untuk model prediksi). Untuk aplikasi LLM, daftar periksanya kira-kira:
| Hal | Pertanyaan yang dijaga |
|---|---|
| Versi | Prompt, model, ukuran potongan, dan dokumen mana yang dipakai? Simpan di Git |
| Evaluasi | Apakah skor uji turun setelah perubahan? |
| Catatan | Setiap panggilan: masukan, sumber, token, biaya, latensi |
| Biaya | Ada batas harian? Ada peringatan lonjakan? |
| Keamanan | Kunci di variabel lingkungan; data pribadi tidak ikut terkirim |
| Pembaruan | Dokumen baru masuk indeks, dokumen kedaluwarsa dibuang |
Menyajikan asisten sebagai layanan web
Agar orang lain bisa memakai asisten, bungkus dalam layanan web seperti di Bab 36 dan Bab 48. Kita memakai FastAPI dan TestClient yang menguji aplikasi tanpa membuka port jaringan sungguhan:
10_penyajian_api.py
# Bab 60 - Menyajikan asisten sebagai layanan web (FastAPI), diuji tanpa membuka port
from fastapi import FastAPI
from fastapi.testclient import TestClient
from pydantic import BaseModel

from pustaka.dokumen import DOKUMEN
from pustaka.pencari import Pencari, bangun_prompt
from pustaka.tiruan import LLMTiruan

app = FastAPI(title="Asisten SOP")
pencari, llm = Pencari(DOKUMEN), LLMTiruan()


class Pertanyaan(BaseModel):
    teks: str
    k: int = 2


@app.get("/kesehatan")
def kesehatan():
    return {"status": "ok", "model": llm.nama, "jumlah_dokumen": len(DOKUMEN)}


@app.post("/tanya")
def tanya(p: Pertanyaan):
    potongan = pencari.cari(p.teks, k=p.k)
    return {
        "jawaban": llm.jawab(bangun_prompt(p.teks, potongan)),
        "sumber": [d["id"] for d, _ in potongan],
    }


klien = TestClient(app)
print(klien.get("/kesehatan").json())
r = klien.post("/tanya", json={"teks": "Berapa padat tebar benih lele?"})
print(r.status_code, r.json())
r = klien.post("/tanya", json={"k": 2})
print(r.status_code, "-> permintaan tanpa 'teks' ditolak otomatis oleh Pydantic")

# Untuk menjalankannya sungguhan di komputer Anda (tidak dilakukan di sini):
#   uvicorn 10_penyajian_api:app --port 8000
{'status': 'ok', 'model': 'llm-tiruan-1', 'jumlah_dokumen': 12}
200 {'jawaban': 'Kolam lele diisi benih berukuran 7 sampai 9 sentimeter dengan padat tebar 100 ekor per meter persegi. [1]', 'sumber': ['IKAN-01', 'TERNAK-03']}
422 -> permintaan tanpa 'teks' ditolak otomatis oleh PydanticGET /kesehatan (health check) memberi tahu sistem pemantau bahwa layanan hidup. POST /tanya menerima pertanyaan dan mengembalikan jawaban beserta daftar sumber. Model Pydantic Pertanyaan (Bab 34) memvalidasi masukan: permintaan tanpa teks ditolak otomatis dengan kode 422. Menjalankannya sungguhan memakai uvicorn, seperti tertulis di komentar; itu tidak kita lakukan di sini.
Proyek Bersambung A4: asisten tanya-jawab dokumen
Proyek A4 dimulai. Kita rakit asisten untuk dokumen kehutanan, pertanian, perikanan, dan peternakan. Tambahannya: asisten menebak sektor dari kata kunci pertanyaan, lalu mencari di Chroma dengan filter sektor itu (bila sektor tidak jelas, cari di semua).
11_proyek_asisten.py
# Bab 60 - Proyek A4: asisten tanya-jawab dokumen kehutanan, pertanian, perikanan, peternakan
import shutil
from pathlib import Path

import chromadb

from pustaka.dokumen import DOKUMEN
from pustaka.pencari import Pencari, bangun_prompt
from pustaka.tiruan import LLMTiruan

folder = Path(__file__).parent / "_tmp" / "asisten"
shutil.rmtree(folder, ignore_errors=True)

pencari = Pencari(DOKUMEN)
koleksi = chromadb.PersistentClient(path=str(folder)).create_collection(
    "sop", embedding_function=None, metadata={"hnsw:space": "cosine"})
koleksi.add(ids=[d["id"] for d in DOKUMEN], embeddings=pencari.matriks.tolist(),
            documents=[d["isi"] for d in DOKUMEN], metadatas=[{"sektor": d["sektor"]} for d in DOKUMEN])

KATA_SEKTOR = {
    "kehutanan": ["jati", "pohon", "hutan", "diameter"],
    "pertanian": ["padi", "kopi", "wereng", "pupuk"],
    "perikanan": ["lele", "nila", "kolam", "ikan"],
    "peternakan": ["sapi", "ayam", "kandang", "ternak"],
}


def tebak_sektor(pertanyaan):
    kecil = pertanyaan.lower()
    for sektor, kata in KATA_SEKTOR.items():
        if any(k in kecil for k in kata):
            return sektor
    return None


llm = LLMTiruan()


def asisten(pertanyaan):
    sektor = tebak_sektor(pertanyaan)
    q = pencari.vektor(pertanyaan).tolist()
    hasil = koleksi.query(query_embeddings=[q], n_results=2, where={"sektor": sektor} if sektor else None)
    potongan = [({"id": i, "isi": isi}, 0.0) for i, isi in zip(hasil["ids"][0], hasil["documents"][0])]
    return sektor, llm.jawab(bangun_prompt(pertanyaan, potongan)), hasil["ids"][0]


for tanya in ["Berapa jarak tanam padi?",
              "Kapan ikan nila dipanen?",
              "Berapa persen pakan hijauan untuk sapi?",
              "Berapa lebar sekat bakar?",
              "Siapa presiden pertama?"]:
    sektor, jawaban, sumber = asisten(tanya)
    print(f"T: {tanya}\n   sektor={sektor} sumber={sumber}\n   J: {jawaban}\n")
T: Berapa jarak tanam padi?
sektor=pertanian sumber=['TANI-01', 'TANI-02']
J: Padi ditanam dengan jarak 25 x 25 sentimeter. [1]
T: Kapan ikan nila dipanen?
sektor=perikanan sumber=['IKAN-03', 'IKAN-02']
J: Ikan dipanen saat bobot rata-rata mencapai 500 gram. [1]
T: Berapa persen pakan hijauan untuk sapi?
sektor=peternakan sumber=['TERNAK-01', 'TERNAK-03']
J: Pakan hijauan diberikan sekitar 10 persen dari bobot badan per hari, ditambah konsentrat. [1]
T: Berapa lebar sekat bakar?
sektor=None sumber=['HUTAN-03', 'IKAN-01']
J: Sekat bakar selebar 5 meter dipelihara di sekeliling petak. [1]
T: Siapa presiden pertama?
sektor=None sumber=['TERNAK-01', 'TANI-03']
J: Maaf, jawabannya tidak ada di dokumen yang diberikan.Lima pertanyaan, lima jenis kejadian: tiga pertanyaan dengan sektor jelas dijawab dari dokumen yang benar (padi, nila, sapi); “Berapa lebar sekat bakar?” tidak mengandung kata sektor dalam daftar kita, jadi dicari di semua dokumen dan tetap ketemu SOP patroli kebakaran; “Siapa presiden pertama?” di luar topik dan ditolak. Perhatikan pertanyaan nila: “Kapan ikan nila dipanen?” dijawab dengan SOP panen ikan (500 gram), bukan SOP kualitas air; itulah jawaban yang tepat. Pada bab-bab berikut asisten ini diberi kemampuan baru: Bab 62 menjadikannya agent yang memanggil alat.
Ingat batasannya: LLM-nya tiruan, embedding-nya TF-IDF, dokumennya fiktif. Untuk sistem sungguhan ganti tiga hal itu (model bahasa, model embedding, dokumen resmi), pertahankan kerangka, evaluasi, pencatatan, dan layanannya.
Latihan
- Ubah
07_rag_dasar.pyagar memakaik=1, laluk=3. Ajukan pertanyaan “Berapa jarak tanam jati?”. Bagaimana panjang prompt dan jawabannya berubah? - Tambahkan dua SOP baru (kehutanan dan perikanan) ke
pustaka/dokumen.py, lalu tambahkan dua pertanyaan uji untuknya diPERTANYAAN_UJI. Jalankan08_evaluasi_rag.py: apakah hit@1 berubah? - Di
09_biaya_observability.py, ubah tarif keluar menjadi dua kali lipat. Apakah total biaya tiga panggilan naik dua kali? Mengapa tidak? - Tantangan: tambahkan ke
11_proyek_asisten.pybatas biaya harian: bila total biaya (hitung seperti Bab ini) melewati Rp 5, asisten menjawab “batas harian tercapai” tanpa memanggil LLM.
Ringkasan Bab
- LLM lewat API = mengirim pertanyaan lewat HTTP; kunci disimpan di variabel lingkungan, tidak di kode. Kode API di bab ini tidak dijalankan.
- LLM tiruan (buatan sendiri) membuat alur RAG bisa diuji tanpa akun; ia bukan model bahasa sungguhan.
- RAG = cari potongan dokumen yang relevan, masukkan ke prompt, lalu jawab dengan mengutip sumber. Ini mengurangi halusinasi.
- Embedding mengubah teks menjadi vektor; kemiripan diukur dengan kosinus. TF-IDF dipakai sebagai pengganti yang jujur; FAISS dan Chroma menyimpan dan mencari vektor.
- Evaluasi memisahkan pencarian (hit@k, MRR) dari jawaban (kutipan, penolakan).
- Token dan biaya: prompt RAG biasanya lebih mahal daripada jawabannya; catat setiap panggilan.
- Layanan web memberi
GET /kesehatandanPOST /tanyadengan validasi Pydantic.
Selanjutnya, di Bab 61: apa yang sebenarnya terjadi di dalam model bahasa, yaitu transformer dan attention, tokenisasi, LoRA di GPU kita, serta hitungan VRAM.