%%{init: {"flowchart": {"diagramPadding": 40}}}%%
flowchart LR
S["Sumber<br/>logger, CSV, API"] --> E["Extract<br/>ambil"]
E --> T1["Transform<br/>di Python"]
T1 --> L1["Load<br/>simpan bersih"]
E --> L2["Load<br/>simpan mentah"]
L2 --> T2["Transform<br/>dengan SQL"]
Bab 50 — Rekayasa Data Modern: Dari Berkas Berantakan ke Pipeline Rapi
Seri A2 — Data Skala Besar dan Geospasial Lanjut
Semua skrip bab ini ada di folder kode/bab50/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip). Skrip buat_data.py hanya modul bantu pembuat data tiruan (fiktif); skrip bernomor yang dijalankan berurutan.
Di Seri A1, aplikasi Anda sudah siap produksi. Tetapi datanya masih kecil: puluhan baris yang muat di satu berkas CSV. Sekarang bayangkan sensor di kebun, kolam, dan kandang mengirim satu bacaan tiap menit selama bertahun-tahun. Itu jutaan baris. Membukanya di Excel akan membuat komputer menyerah, dan membacanya dengan pandas.read_csv berulang-ulang membuang waktu.
Rekayasa data (data engineering) adalah pekerjaan membangun “saluran air” untuk data: mengambilnya dari sumber, membersihkannya, menyimpannya dengan cara yang efisien, lalu mengalirkannya ke yang membutuhkan. Seperti irigasi sawah: bukan menyiram satu tanaman, tetapi menata saluran supaya air sampai ke semua petak, tepat waktu, dan tidak bocor.
Parquet dan Arrow: menyimpan per kolom
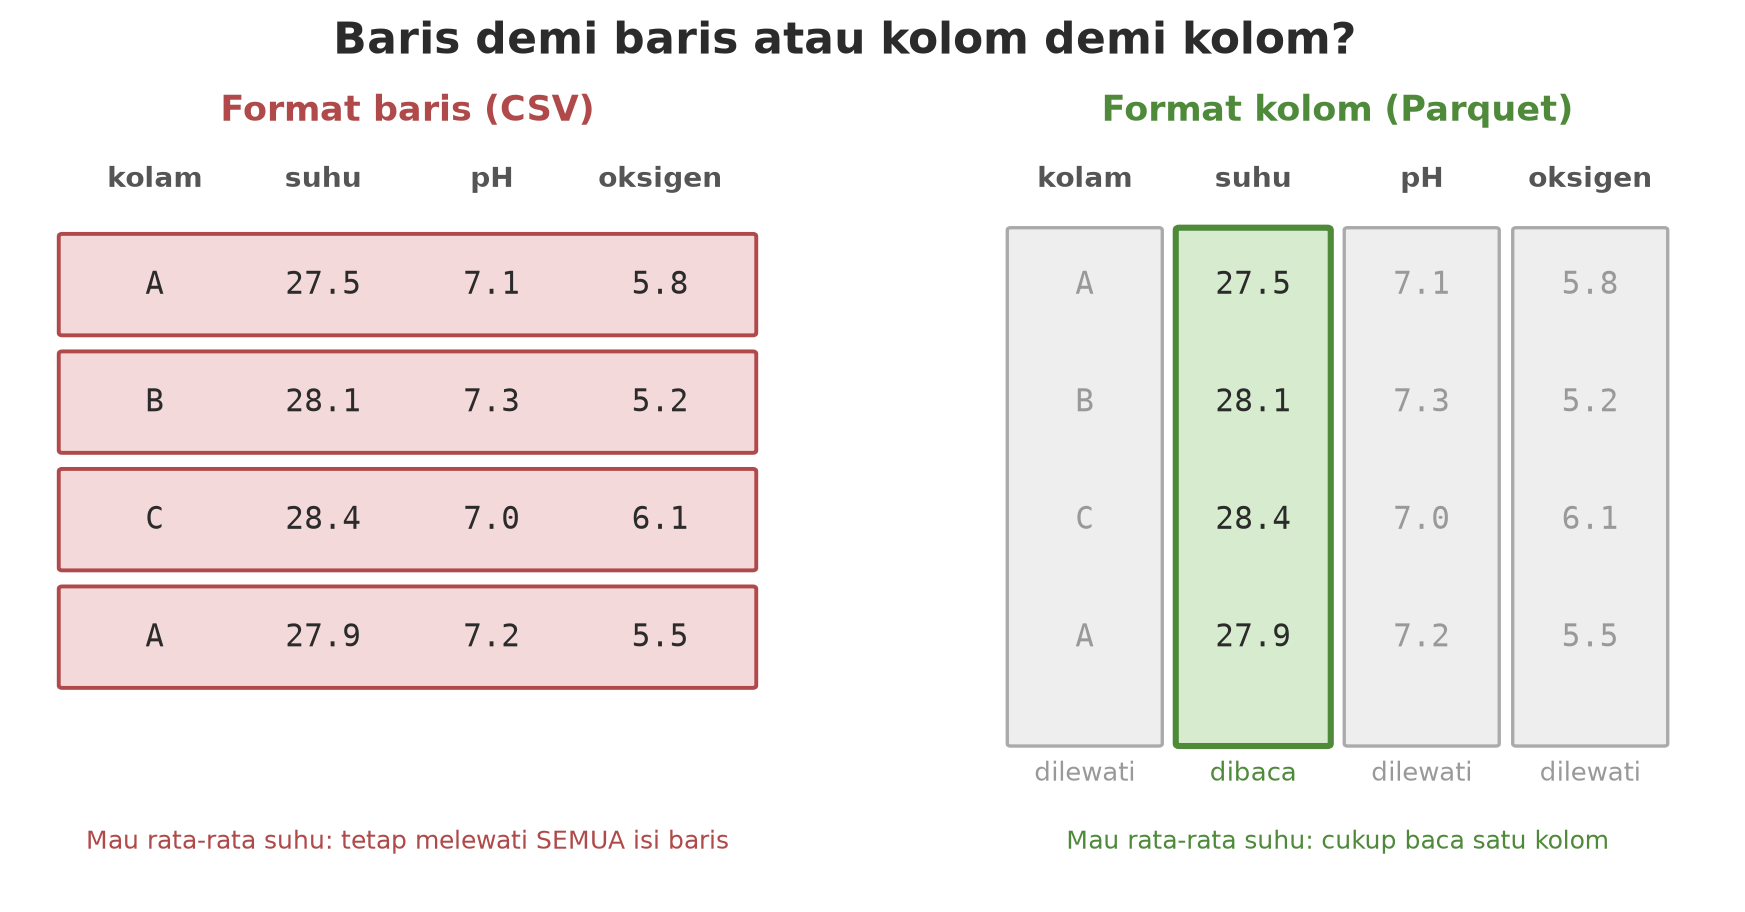
CSV menyimpan data baris demi baris dalam teks. Untuk menghitung rata-rata suhu saja, program tetap harus membaca semua kolom di setiap baris. Parquet menyimpan data kolom demi kolom dalam bentuk biner terkompresi. Untuk rata-rata suhu, ia cukup membuka satu kolom.
Arrow adalah format tabel di memori yang kolumnar juga. Pustaka pyarrow menjadi “bahasa bersama”: Polars, DuckDB, pandas, dan banyak alat lain bisa bertukar tabel Arrow tanpa menyalin data.
01_parquet_arrow.py
# Bab 50 - Tabel Arrow, berkas Parquet, dan membaca sebagian kolom
from pathlib import Path

import numpy as np
import pyarrow as pa
import pyarrow.csv as pcsv
import pyarrow.parquet as pq

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)

# Data tiruan (fiktif): 20.000 bacaan sensor kolam, tiga kolam
rng = np.random.default_rng(42)
n = 20_000
tabel = pa.table({
    "kolam": pa.array(rng.choice(["A", "B", "C"], n)),
    "menit": pa.array(np.arange(n, dtype="int32")),
    "suhu_c": pa.array(rng.normal(28.5, 1.2, n).round(2)),
    "ph": pa.array(rng.normal(7.2, 0.3, n).round(2)),
    "oksigen_mgl": pa.array(rng.normal(5.8, 0.8, n).round(2)),
})
print("Skema Arrow:")
print(tabel.schema)
print("Jumlah baris:", tabel.num_rows)

# Tulis dua format: CSV (teks, per baris) dan Parquet (biner, per kolom)
pcsv.write_csv(tabel, tmp / "kolam.csv")
pq.write_table(tabel, tmp / "kolam.parquet", compression="zstd", row_group_size=5_000)
ukuran_csv = (tmp / "kolam.csv").stat().st_size
ukuran_pq = (tmp / "kolam.parquet").stat().st_size
print("Parquet lebih kecil dari CSV:", ukuran_pq < ukuran_csv)

# Parquet menyimpan skema dan statistik di dalam berkasnya
meta = pq.ParquetFile(tmp / "kolam.parquet").metadata
print("Grup baris (row group):", meta.num_row_groups)
kol = meta.row_group(0).column(2)
print("Statistik suhu di grup 0 -> min:", kol.statistics.min, "maks:", kol.statistics.max)

# Membaca HANYA dua kolom: kolom lain tidak disentuh
sebagian = pq.read_table(tmp / "kolam.parquet", columns=["kolam", "suhu_c"])
print("Kolom terbaca:", sebagian.column_names)
Skema Arrow:
kolam: string
menit: int32
suhu_c: double
ph: double
oksigen_mgl: double
Jumlah baris: 20000
Parquet lebih kecil dari CSV: True
Grup baris (row group): 4
Statistik suhu di grup 0 -> min: 23.83 maks: 33.48
Kolom terbaca: ['kolam', 'suhu_c']Telusuri hasilnya:
- Skema Arrow mencatat nama dan tipe tiap kolom. Parquet menyimpan skema yang sama di dalam berkasnya, jadi tipe data tidak hilang seperti pada CSV.
- Berkas Parquet lebih kecil daripada CSV (
True). Kolom berisi nilai sejenis jauh lebih mudah dikompres. - Berkas dipecah menjadi grup baris (row group): 20.000 baris dibagi 5.000 per grup menjadi 4 grup. Tiap grup menyimpan statistik (nilai minimum dan maksimum). Pembaca yang pintar bisa melewati grup yang pasti tidak berisi data yang dicari.
columns=["kolam", "suhu_c"]membaca hanya dua kolom; tiga kolom lainnya tidak disentuh.
CatatanINGAT
Parquet bagus untuk menganalisis (membaca banyak baris, sedikit kolom). Untuk menambah satu baris demi satu baris terus-menerus, gunakan basis data atau tulis dalam bentuk kelompok (batch) lalu simpan sebagai berkas Parquet baru.
Polars: tabel cepat dengan mode malas
Polars adalah pustaka tabel (mirip pandas) yang ditulis dengan Rust, memakai banyak inti CPU, dan punya mode malas (lazy): Anda menyusun rencana kerja dulu, Polars mengoptimalkannya, baru menjalankannya saat collect() dipanggil.
02_polars.py
# Bab 50 - Polars: ekspresi, mode malas (lazy), dan agregasi
import re

import polars as pl

from buat_data import siapkan_parquet

jalur = siapkan_parquet()

# scan_parquet tidak membaca apa-apa dulu: ia hanya membuat RENCANA kerja
rencana = (
    pl.scan_parquet(jalur)
    .filter(pl.col("oksigen_mgl") < 4.5)          # hanya bacaan oksigen rendah
    .group_by("kolam")
    .agg(
        pl.len().alias("jumlah_rendah"),
        pl.col("suhu_c").mean().round(2).alias("suhu_rata"),
    )
    .sort("kolam")
)
print("Rencana kerja (sebelum dijalankan):")
teks = rencana.explain()
print(re.sub(r"\[[^\]]*kolam\.parquet\]", "[kolam.parquet]", teks))  # sembunyikan jalur lokal

# collect() menjalankan rencana
hasil = rencana.collect()
print()
print(hasil)

# Mode bersemangat (eager) untuk tabel yang sudah di memori
df = pl.read_parquet(jalur, columns=["kolam", "suhu_c"])
print()
print("Suhu tertinggi per kolam:")
print(df.group_by("kolam").agg(pl.col("suhu_c").max()).sort("kolam"))
Rencana kerja (sebelum dijalankan):
SORT BY [col("kolam")]
AGGREGATE[maintain_order: false]
[len().alias("jumlah_rendah"), col("suhu_c").mean().round().alias("suhu_rata")] BY [col("kolam")]
FROM
simple π 2/2 ["kolam", "suhu_c"]
Parquet SCAN [kolam.parquet]
PROJECT 3/5 COLUMNS
SELECTION: col("oksigen_mgl") < 4.5
ESTIMATED ROWS: 20000
shape: (3, 3)
┌───────┬───────────────┬───────────┐
│ kolam ┆ jumlah_rendah ┆ suhu_rata │
│ --- ┆ --- ┆ --- │
│ str ┆ u32 ┆ f64 │
╞═══════╪═══════════════╪═══════════╡
│ A ┆ 342 ┆ 28.61 │
│ B ┆ 349 ┆ 28.39 │
│ C ┆ 344 ┆ 28.59 │
└───────┴───────────────┴───────────┘
Suhu tertinggi per kolam:
shape: (3, 2)
┌───────┬────────┐
│ kolam ┆ suhu_c │
│ --- ┆ --- │
│ str ┆ f64 │
╞═══════╪════════╡
│ A ┆ 33.48 │
│ B ┆ 32.77 │
│ C ┆ 32.47 │
└───────┴────────┘Perhatikan rencana kerjanya. Baris PROJECT 3/5 COLUMNS berarti dari 5 kolom di berkas, hanya 3 yang dibaca (kolam, suhu, oksigen). Baris SELECTION berarti filter oksigen_mgl < 4.5 dilakukan saat membaca, bukan sesudahnya. Polars menyusun ulang pekerjaan Anda agar hemat, seperti petani yang merencanakan rute panen sebelum turun ke kebun.
Hasilnya: kolam A punya 342 bacaan oksigen rendah, B 349, C 344. Tabel kedua memakai mode bersemangat (eager) read_parquet untuk tabel yang memang sudah di memori.
DuckDB: SQL langsung atas berkas
Bila Anda sudah mengenal SQL (Bab 24), DuckDB akan terasa seperti hadiah: ia menjalankan SQL langsung atas berkas Parquet dan CSV tanpa server dan tanpa langkah “impor”.
03_duckdb.py
# Bab 50 - DuckDB: SQL langsung atas berkas Parquet dan CSV
import duckdb

from buat_data import TMP, siapkan_parquet

jalur = siapkan_parquet()

# Tabel kecil pendamping (CSV): keterangan tiap kolam
(TMP / "info_kolam.csv").write_text(
    "kolam,jenis,luas_m2\nA,lele,400\nB,nila,350\nC,nila,500\n", encoding="utf-8"
)

# Tidak ada langkah "impor": FROM 'berkas' langsung membaca
sql = f"""
    SELECT b.kolam, i.jenis, i.luas_m2,
           COUNT(*)                   AS bacaan,
           ROUND(AVG(b.ph), 3)        AS ph_rata,
           ROUND(MIN(b.oksigen_mgl), 2) AS oksigen_min
    FROM '{jalur.as_posix()}' AS b
    JOIN '{(TMP / "info_kolam.csv").as_posix()}' AS i USING (kolam)
    WHERE b.menit < 10000
    GROUP BY b.kolam, i.jenis, i.luas_m2
    ORDER BY b.kolam
"""
print(duckdb.sql(sql))

# Hasilnya bisa diambil sebagai tabel Arrow atau Polars
hasil = duckdb.sql(sql).pl()
print("Tipe hasil:", type(hasil).__module__)
print("Kolam dengan oksigen minimum terendah:",
      hasil.sort("oksigen_min").row(0, named=True)["kolam"])

# EXPLAIN menunjukkan: kolom dan filter didorong ke dalam pembaca Parquet
rencana = duckdb.sql(f"EXPLAIN SELECT kolam FROM '{jalur.as_posix()}' WHERE menit < 100").fetchall()
print(rencana[0][1])
┌─────────┬─────────┬─────────┬────────┬─────────┬─────────────┐
│ kolam │ jenis │ luas_m2 │ bacaan │ ph_rata │ oksigen_min │
│ varchar │ varchar │ int64 │ int64 │ double │ double │
├─────────┼─────────┼─────────┼────────┼─────────┼─────────────┤
│ A │ lele │ 400 │ 3399 │ 7.194 │ 3.15 │
│ B │ nila │ 350 │ 3333 │ 7.208 │ 3.06 │
│ C │ nila │ 500 │ 3268 │ 7.191 │ 2.67 │
└─────────┴─────────┴─────────┴────────┴─────────┴─────────────┘
Tipe hasil: polars.dataframe.frame
Kolam dengan oksigen minimum terendah: C
┌───────────────────────────┐
│ PARQUET_SCAN │
│ ──────────────────── │
│ Function: │
│ PARQUET_SCAN │
│ │
│ Projections: kolam │
│ Filters: menit<100 │
│ │
│ ~4,000 rows │
└───────────────────────────┘FROM '.../kolam.parquet'membaca berkas Parquet;JOIN '.../info_kolam.csv'menggabungkannya dengan CSV kecil. Dua format berbeda, satu pertanyaan SQL.- Dari 10.000 menit pertama, kolam A punya 3.399 bacaan, B 3.333, dan C 3.268. Oksigen terendah ada di kolam C (2,67 mg/L).
.pl()mengubah hasil menjadi tabel Polars (ada juga.arrow()dan.df()). Itulah kekuatan Arrow sebagai bahasa bersama.- Keluaran
EXPLAINmenampilkanProjections: kolamdanFilters: menit<100di dalamPARQUET_SCAN: kolom dan filter didorong ke pembaca berkas, sehingga yang dibaca hanya yang perlu.
TipTIPS
Polars atau DuckDB? Keduanya hebat dan bisa dipakai bergantian. Pilih DuckDB bila pertanyaannya enak ditulis dalam SQL (gabungan banyak tabel, agregasi). Pilih Polars bila Anda ingin langkah-langkah transformasi berantai di Python. Karena keduanya memahami Arrow, Anda tidak perlu memilih satu selamanya.
ETL dan ELT: urutan kerja pipeline
Hampir semua pipeline data punya tiga langkah: Extract (ambil dari sumber), Transform (bersihkan dan ubah), Load (simpan di tujuan). Urutannya bisa dua macam:
- ETL: ubah dulu di Python (atau alat lain), baru simpan hasil bersihnya.
- ELT: simpan data mentah apa adanya ke basis data, lalu ubah dengan SQL di dalamnya. Data mentah tetap ada, jadi bila aturan pembersihan berubah, Anda tinggal mengulang tahap T.
Contoh berikut memakai data mentah dari logger kandang yang sengaja dibuat berantakan: ada baris dobel, pembacaan rusak (ERR), satu suhu dalam Fahrenheit, dan satu kelembapan yang hilang.
04_etl_elt.py
# Bab 50 - ETL (ubah dulu, baru simpan) dan ELT (simpan mentah dulu, ubah di basis data)
from pathlib import Path

import duckdb
import polars as pl

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)

# Data mentah tiruan dari logger kandang: ada nilai rusak, duplikat, dan suhu dalam Fahrenheit
mentah = tmp / "kandang_mentah.csv"
mentah.write_text(
    "kandang,waktu,suhu,satuan,kelembapan\n"
    "K1,2026-03-01 06:00,27.5,C,78\n"
    "K1,2026-03-01 06:00,27.5,C,78\n"       # duplikat
    "K1,2026-03-01 07:00,ERR,C,80\n"        # pembacaan rusak
    "K2,2026-03-01 06:00,82.4,F,75\n"       # Fahrenheit
    "K2,2026-03-01 07:00,29.1,C,\n"         # kelembapan hilang
    "K2,2026-03-01 08:00,30.2,C,71\n",
    encoding="utf-8",
)


def etl(jalur):
    """E-T-L: ambil (extract), ubah di Python (transform), simpan hasil bersih (load)."""
    df = pl.read_csv(jalur, schema_overrides={"suhu": pl.String, "kelembapan": pl.Float64})
    df = (
        df.unique(maintain_order=True)
        .with_columns(pl.col("suhu").cast(pl.Float64, strict=False))     # 'ERR' -> null
        .drop_nulls("suhu")
        .with_columns(
            pl.when(pl.col("satuan") == "F")
            .then(((pl.col("suhu") - 32) / 1.8).round(1))
            .otherwise(pl.col("suhu"))
            .alias("suhu_c"),
            pl.col("waktu").str.to_datetime("%Y-%m-%d %H:%M"),
        )
        .select("kandang", "waktu", "suhu_c", "kelembapan")
    )
    df.write_parquet(tmp / "kandang_etl.parquet")
    return df


def elt(jalur):
    """E-L-T: muat mentah apa adanya, lalu ubah dengan SQL di dalam basis data."""
    con = duckdb.connect()
    con.execute(f"CREATE TABLE mentah AS SELECT * FROM read_csv('{jalur.as_posix()}', all_varchar=true)")
    con.execute("""
        CREATE TABLE bersih AS
        SELECT DISTINCT kandang,
               CAST(waktu AS TIMESTAMP) AS waktu,
               CASE WHEN satuan = 'F' THEN ROUND((CAST(suhu AS DOUBLE) - 32) / 1.8, 1)
                    ELSE CAST(suhu AS DOUBLE) END AS suhu_c,
               TRY_CAST(NULLIF(kelembapan, '') AS DOUBLE) AS kelembapan
        FROM mentah
        WHERE TRY_CAST(suhu AS DOUBLE) IS NOT NULL
    """)
    return con.sql("SELECT * FROM bersih ORDER BY kandang, waktu").pl()


hasil_etl = etl(mentah)
print("ETL:")
print(hasil_etl)

hasil_elt = elt(mentah)
print()
print("ELT sama dengan ETL:", hasil_elt.equals(hasil_etl.sort("kandang", "waktu")))
print("Baris mentah:", pl.read_csv(mentah).height, "-> baris bersih:", hasil_elt.height)
ETL:
shape: (4, 4)
┌─────────┬─────────────────────┬────────┬────────────┐
│ kandang ┆ waktu ┆ suhu_c ┆ kelembapan │
│ --- ┆ --- ┆ --- ┆ --- │
│ str ┆ datetime[μs] ┆ f64 ┆ f64 │
╞═════════╪═════════════════════╪════════╪════════════╡
│ K1 ┆ 2026-03-01 06:00:00 ┆ 27.5 ┆ 78.0 │
│ K2 ┆ 2026-03-01 06:00:00 ┆ 28.0 ┆ 75.0 │
│ K2 ┆ 2026-03-01 07:00:00 ┆ 29.1 ┆ null │
│ K2 ┆ 2026-03-01 08:00:00 ┆ 30.2 ┆ 71.0 │
└─────────┴─────────────────────┴────────┴────────────┘
ELT sama dengan ETL: True
Baris mentah: 6 -> baris bersih: 4Dari 6 baris mentah, 4 baris bersih yang tersisa: satu duplikat dibuang, satu baris ERR dibuang, suhu 82,4 °F diubah menjadi 28,0 °C, dan kelembapan yang hilang tetap null (kita tidak mengarang angka). Cara ETL (Polars) dan cara ELT (SQL DuckDB) menghasilkan tabel yang sama persis: True.
Kualitas data: jangan percaya data begitu saja
Pipeline yang rajin tetapi menelan data rusak adalah pipeline berbahaya: laporan bulan depan akan salah dan tak seorang pun tahu sebabnya. Karena itu pipeline perlu pemeriksaan kualitas. Ada dua pendekatan.
1. Skema dengan pustaka pandera. Anda menuliskan “kontrak”: kolom apa yang harus ada, tipe apa, rentang nilai apa. Pandera mendukung tabel Polars (pandera.polars) dan bisa dipasang untuk Python 3.14.
05_kualitas_pandera.py
# Bab 50 - Kualitas data: skema pandera untuk tabel Polars
import pandera.polars as pa
import polars as pl

# Skema = "kontrak" tentang bentuk data yang boleh masuk
skema = pa.DataFrameSchema({
    "kolam": pa.Column(pl.String, pa.Check.isin(["A", "B", "C"])),
    "suhu_c": pa.Column(pl.Float64, pa.Check.in_range(15, 40)),     # angka contoh
    "ph": pa.Column(pl.Float64, pa.Check.in_range(4, 10), nullable=False),
})

# Tiga baris bermasalah sengaja dimasukkan: kolam 'Z', suhu 55, pH kosong
bacaan = pl.DataFrame({
    "kolam": ["A", "B", "Z"],
    "suhu_c": [28.0, 55.0, 27.0],
    "ph": [7.1, None, 7.3],
})

try:
    skema.validate(bacaan, lazy=True)       # lazy=True: kumpulkan SEMUA masalah dulu
except pa.errors.SchemaErrors as galat:
    print("Validasi gagal. Daftar masalah:")
    print(galat.failure_cases.select("column", "check", "failure_case", "index"))

# Data yang lolos dikembalikan apa adanya
print()
print("Baris pertama lolos:", skema.validate(bacaan.head(1)).height, "baris")
Validasi gagal. Daftar masalah:
shape: (3, 4)
┌────────┬───────────────────────┬──────────────┬───────┐
│ column ┆ check ┆ failure_case ┆ index │
│ --- ┆ --- ┆ --- ┆ --- │
│ str ┆ str ┆ str ┆ i32 │
╞════════╪═══════════════════════╪══════════════╪═══════╡
│ kolam ┆ isin(['A', 'B', 'C']) ┆ Z ┆ 2 │
│ suhu_c ┆ in_range(15, 40) ┆ 55.0 ┆ 1 │
│ ph ┆ not_nullable ┆ null ┆ 1 │
└────────┴───────────────────────┴──────────────┴───────┘
Baris pertama lolos: 1 barisDengan lazy=True, pandera mengumpulkan semua masalah sekaligus: kolam Z yang tak dikenal (baris 2), suhu 55 di luar rentang 15 sampai 40 (baris 1), dan pH kosong (baris 1). Rentang 15-40 dan 4-10 adalah angka contoh, bukan anjuran budidaya. Data yang lolos dikembalikan apa adanya.
2. Pemeriksaan buatan sendiri. Kadang pustaka tambahan tidak perlu. Fungsi kecil yang mengembalikan daftar (nama, lolos, keterangan) sudah cukup dan mudah dibaca siapa pun.
06_kualitas_sendiri.py
# Bab 50 - Pemeriksaan kualitas buatan sendiri: tanpa pustaka tambahan
import polars as pl

from buat_data import siapkan_parquet


def periksa(df):
    """Mengembalikan daftar (nama pemeriksaan, lolos?, keterangan)."""
    hasil = []
    n = df.height
    hasil.append(("tidak kosong", n > 0, f"{n} baris"))

    kosong = df.null_count().row(0)
    hasil.append(("tanpa nilai kosong", sum(kosong) == 0, f"{sum(kosong)} sel kosong"))

    ganda = n - df.select("kolam", "menit").unique().height
    hasil.append(("kunci (kolam, menit) unik", ganda == 0, f"{ganda} duplikat"))

    luar = df.filter(~pl.col("ph").is_between(6.0, 8.5)).height      # ambang contoh
    persen = 100 * luar / n
    hasil.append(("pH di luar 6,0-8,5 kurang dari 1%", persen < 1, f"{persen:.2f}% di luar"))
    return hasil


bersih = pl.read_parquet(siapkan_parquet())
print("Data asli:")
for nama, lolos, ket in periksa(bersih):
    print(f"  [{'OK ' if lolos else 'GAGAL'}] {nama}: {ket}")

# Sisipkan kerusakan: satu baris dobel dan satu pH kosong
rusak = pl.concat([bersih, bersih.head(1)]).with_columns(
    pl.when(pl.col("menit") == 5).then(None).otherwise(pl.col("ph")).alias("ph")
)
print("Data dirusak:")
for nama, lolos, ket in periksa(rusak):
    print(f"  [{'OK ' if lolos else 'GAGAL'}] {nama}: {ket}")
Data asli:
[OK ] tidak kosong: 20000 baris
[OK ] tanpa nilai kosong: 0 sel kosong
[OK ] kunci (kolam, menit) unik: 0 duplikat
[OK ] pH di luar 6,0-8,5 kurang dari 1%: 0.01% di luar
Data dirusak:
[OK ] tidak kosong: 20001 baris
[GAGAL] tanpa nilai kosong: 1 sel kosong
[GAGAL] kunci (kolam, menit) unik: 1 duplikat
[OK ] pH di luar 6,0-8,5 kurang dari 1%: 0.01% di luarData asli lolos semua pemeriksaan (hanya 0,01% pH di luar 6,0-8,5, di bawah batas contoh 1%). Setelah kita sengaja merusaknya dengan satu baris dobel dan satu pH kosong, dua pemeriksaan GAGAL dan menyebutkan jumlahnya. Dalam pipeline sungguhan, kegagalan seperti ini menghentikan alur atau mengirim peringatan.
PeringatanAWAS
Pemeriksaan kualitas harus dijalankan di dalam pipeline, sebelum data dipakai. Memeriksanya “kalau sempat” sama saja tidak memeriksa.
Orkestrasi: siapa yang mengatur urutan dan mengulang bila gagal?
Pipeline nyata terdiri dari banyak tugas yang saling bergantung: ambil, periksa, ringkas, simpan. Sebuah orkestrator (orchestrator) bertugas menjalankannya berurutan, mengulang tugas yang gagal, mencatat riwayatnya, dan menjalankannya sesuai jadwal. Ada tiga nama besar:
| Alat | Cara berpikirnya | Catatan untuk komputer penulis (Windows, Python 3.14) |
|---|---|---|
| Prefect | Fungsi Python biasa diberi @flow dan @task |
Terpasang dan dijalankan di bab ini |
| Dagster | Berpusat pada “aset data” yang dihasilkan | Dicoba lewat simulasi pemasangan (dry run) di lingkungan terpisah: dapat dipasang untuk Python 3.14; tidak dijalankan di bab ini |
| Apache Airflow | Alur (DAG) dengan penjadwal dan server sendiri | Dokumentasinya menyebut Windows hanya lewat WSL2 atau kontainer Linux; tidak dijalankan di bab ini |
Mengapa Prefect yang dipilih untuk dijalankan? Karena paling sedikit syarat: alur Anda adalah fungsi Python biasa, jalan langsung di Windows dengan Python 3.14, dan tidak butuh server yang dipasang terpisah untuk contoh kecil. Dagster dan Airflow bagus, terutama untuk tim besar, tetapi Airflow memang dirancang untuk lingkungan Linux, dan Dagster lebih cocok dipelajari lewat proyek utuhnya. Bila Anda bekerja di tim yang sudah memakai salah satunya, konsepnya mirip: tugas, ketergantungan, ulang, jadwal, dan pemantauan.
07_prefect_alur.py
# Bab 50 - Orkestrasi dengan Prefect: tugas (task), alur (flow), ulang otomatis
import os
from pathlib import Path

# Rumah data Prefect diarahkan ke folder _tmp dan log dimatikan supaya keluaran bersih
tmp = Path(__file__).parent / "_tmp"
os.environ["PREFECT_HOME"] = str(tmp / "prefect")
os.environ["PREFECT_LOGGING_LEVEL"] = "CRITICAL"
os.environ["PREFECT_SERVER_ANALYTICS_ENABLED"] = "false"

from prefect import flow, task  # noqa: E402  (diimpor setelah variabel lingkungan diatur)

percobaan = {"ambil": 0, "ringkas": 0}


@task(retries=2, retry_delay_seconds=0)
def ambil():
    """Mengambil bacaan dari 'sensor'; dua percobaan pertama gagal (jaringan lapangan putus-putus)."""
    percobaan["ambil"] += 1
    if percobaan["ambil"] < 3:
        raise ConnectionError("sensor belum menjawab")
    return [7.1, 7.3, 6.9, 7.2]


@task
def periksa(ph):
    if any(not 4 <= x <= 10 for x in ph):
        raise ValueError("ada pH di luar rentang 4-10")
    return ph


@task
def ringkas(ph):
    percobaan["ringkas"] += 1
    return {"jumlah": len(ph), "rata_rata": round(sum(ph) / len(ph), 2)}


@flow
def alur_ph():
    return ringkas(periksa(ambil()))


# Jalan 1: tugas pertama dicoba tiga kali, lalu berhasil
status = alur_ph(return_state=True)
print("Alur selesai:", status.is_completed(), "| hasil:", status.result())
print("Percobaan 'ambil':", percobaan["ambil"])


# Jalan 2: data rusak -> 'periksa' gagal, 'ringkas' tidak pernah dijalankan
@task
def ambil_rusak():
    return [7.1, 99.0]


@flow
def alur_rusak():
    return ringkas(periksa(ambil_rusak()))


status2 = alur_rusak(return_state=True)
print("Alur data rusak gagal:", status2.is_failed())
print("Tugas ringkas dijalankan (total):", percobaan["ringkas"])
Alur selesai: True | hasil: {'jumlah': 4, 'rata_rata': 7.12}
Percobaan 'ambil': 3
Alur data rusak gagal: True
Tugas ringkas dijalankan (total): 1Penjelasannya:
@task(retries=2, retry_delay_seconds=0): bila tugas melempar error, Prefect mengulanginya sampai 2 kali lagi. Tugasambilsengaja gagal dua kali; percobaan ketiga berhasil (Percobaan 'ambil': 3). Itulah ketahanan terhadap jaringan lapangan yang putus-putus.@flowmembungkus tugas-tugas menjadi satu alur. HasilnyaCompleteddan rata-rata pH 7,12.- Pada jalan kedua, data berisi pH 99. Tugas
periksagagal, alur berstatus gagal (True), dan tugasringkastidak pernah dijalankan (totalnya tetap 1, dari jalan pertama). Data rusak berhenti di pintu, tidak mengalir ke laporan.
BahayaBAGIAN TEKNIS (boleh dilewati)
Skrip ini mengatur beberapa variabel lingkungan sebelum mengimpor Prefect: PREFECT_HOME diarahkan ke folder _tmp (supaya basis data kecil milik Prefect tidak mengotori folder pengguna), PREFECT_LOGGING_LEVEL=CRITICAL (supaya keluaran bersih), dan analitik dimatikan. Saat alur dijalankan tanpa server terpisah, Prefect menyalakan server sementara di komputer Anda, sehingga skrip ini butuh sekitar setengah menit. Nama variabel dan versi bisa berubah; periksa dokumentasi Prefect versi Anda.
Penjadwalan: menjalankan otomatis tiap hari
Pipeline jarang dijalankan dengan tangan. Prefect menyediakan flow.serve(...) yang membuat deployment dengan jadwal cron: lima kolom menit jam tanggal bulan hari-minggu. Misalnya 0 6 * * * berarti “menit 0, jam 6, setiap hari”.
08_jadwal_prefect.py
# Bab 50 - Menjadwalkan alur dengan Prefect (dibaca, tidak dijalankan)
from prefect import flow


@flow(log_prints=True)
def laporan_harian():
    print("menjalankan pipeline sensor...")


if __name__ == "__main__":
    # Membuat 'deployment' bernama harian-06 dan menjalankan alur setiap hari pukul 06:00.
    # Proses ini harus tetap hidup supaya jadwalnya dikerjakan.
    laporan_harian.serve(name="harian-06", cron="0 6 * * *")
Kode ini tidak dijalankan saat buku dibuat karena flow.serve() berjalan terus (menunggu jadwal) dan butuh proses yang dibiarkan hidup, jadi keluarannya tidak ditampilkan. Dokumentasi Prefect menyebut serve membuat deployment dan menjalankan runner yang memantau pekerjaan terjadwal. Di server, proses seperti ini biasanya dijaga oleh layanan sistem (misalnya systemd) atau dijalankan di kontainer (Bab 48).
Alternatif tanpa orkestrator: cron di Linux atau Penjadwal Tugas (Task Scheduler) di Windows. Itu cukup untuk satu skrip sederhana; orkestrator berguna saat ada banyak tugas bergantungan yang perlu diulang dan dipantau.
Memantau pipeline
Pipeline yang berjalan diam-diam bisa gagal diam-diam. Dua hal yang wajib dipantau: apakah tiap jalan berhasil dan seberapa segar datanya. Anda tidak selalu butuh alat besar; tabel catatan kecil sudah memulai kebiasaan yang benar.
09_pemantauan.py
# Bab 50 - Memantau pipeline: catatan tiap jalan (run log) dan pemeriksaan kesegaran data
from datetime import date

import duckdb

con = duckdb.connect()   # basis data sementara di memori
con.execute("""
    CREATE TABLE catatan_jalan (
        nomor INTEGER, tahap VARCHAR, status VARCHAR, baris INTEGER, tanggal_data DATE
    )
""")
nomor = 0


def catat(tahap, fungsi, tanggal_data):
    """Menjalankan satu tahap dan mencatat berhasil/gagal beserta jumlah barisnya."""
    global nomor
    nomor += 1
    try:
        baris = fungsi()
        con.execute("INSERT INTO catatan_jalan VALUES (?, ?, 'berhasil', ?, ?)",
                    [nomor, tahap, baris, tanggal_data])
    except Exception as galat:
        con.execute("INSERT INTO catatan_jalan VALUES (?, ?, ?, 0, ?)",
                    [nomor, tahap, f"gagal: {type(galat).__name__}", tanggal_data])


def sumber_normal():
    return 1440


def sumber_putus():
    raise TimeoutError("logger tidak menjawab")


catat("ambil", sumber_normal, date(2026, 3, 1))
catat("ambil", sumber_normal, date(2026, 3, 2))
catat("ambil", sumber_putus, date(2026, 3, 3))
catat("ambil", sumber_normal, date(2026, 3, 4))

print(con.sql("SELECT * FROM catatan_jalan ORDER BY nomor"))

# Pemeriksaan kesegaran: hari terakhir yang BERHASIL vs 'hari ini' (ditetapkan tetap agar keluaran stabil)
hari_ini = date(2026, 3, 6)
terakhir = con.sql("SELECT MAX(tanggal_data) FROM catatan_jalan WHERE status = 'berhasil'").fetchone()[0]
usia = (hari_ini - terakhir).days
print(f"Data terakhir berhasil: {terakhir}; usia {usia} hari")
if usia > 1:
    print("PERINGATAN: data basi, kirim pemberitahuan ke petugas")

gagal = con.sql("SELECT COUNT(*) FROM catatan_jalan WHERE status LIKE 'gagal%'").fetchone()[0]
print("Jumlah jalan gagal:", gagal)
┌───────┬─────────┬─────────────────────┬───────┬──────────────┐
│ nomor │ tahap │ status │ baris │ tanggal_data │
│ int32 │ varchar │ varchar │ int32 │ date │
├───────┼─────────┼─────────────────────┼───────┼──────────────┤
│ 1 │ ambil │ berhasil │ 1440 │ 2026-03-01 │
│ 2 │ ambil │ berhasil │ 1440 │ 2026-03-02 │
│ 3 │ ambil │ gagal: TimeoutError │ 0 │ 2026-03-03 │
│ 4 │ ambil │ berhasil │ 1440 │ 2026-03-04 │
└───────┴─────────┴─────────────────────┴───────┴──────────────┘
Data terakhir berhasil: 2026-03-04; usia 2 hari
PERINGATAN: data basi, kirim pemberitahuan ke petugas
Jumlah jalan gagal: 1Empat jalan dicatat; jalan ke-3 gagal (TimeoutError) dan tercatat dengan jumlah baris 0. Pemeriksaan kesegaran membandingkan hari terakhir yang berhasil (4 Maret) dengan “hari ini” (6 Maret, sengaja dibuat tetap supaya keluaran stabil): usianya 2 hari, jadi program mencetak peringatan. Dalam sistem nyata, peringatan dikirim ke petugas lewat pesan atau surel.
Proyek Bersambung A2: gudang data sensor kebun, kolam, dan kandang
Proyek Seri A2 mengumpulkan data dari seluruh unit usaha. Langkah pertama: menyimpan bacaan sensor (nanti dikirim oleh perangkat di Bab 52) ke gudang Parquet berpartisi, satu subfolder per unit, lalu menanyainya dengan DuckDB dan Polars.
10_proyek_sensor.py
# Bab 50 - Proyek bersambung A2: data sensor kebun, kolam, dan kandang -> Parquet -> Polars/DuckDB
import shutil
from datetime import datetime, timedelta
from pathlib import Path

import duckdb
import numpy as np
import polars as pl
import pyarrow.dataset as ds

tmp = Path(__file__).parent / "_tmp"
gudang = tmp / "gudang_sensor"
shutil.rmtree(gudang, ignore_errors=True)

# 1. Data tiruan (fiktif): 3 hari, satu bacaan per jam, tiga unit usaha
rng = np.random.default_rng(7)
jam = [datetime(2026, 3, 1) + timedelta(hours=h) for h in range(72)]
unit_besaran = {
    "kebun": [("suhu_c", 26.0, 2.5), ("kelembapan_tanah_pct", 38.0, 4.0)],
    "kolam": [("suhu_c", 28.5, 1.0), ("oksigen_mgl", 5.6, 0.9)],
    "kandang": [("suhu_c", 29.0, 1.8), ("kelembapan_pct", 72.0, 6.0)],
}
baris = []
for unit, daftar in unit_besaran.items():
    for besaran, rata, simpang in daftar:
        nilai = rng.normal(rata, simpang, len(jam)).round(2)
        baris += [(unit, besaran, w, float(v)) for w, v in zip(jam, nilai)]
df = pl.DataFrame(baris, schema=["unit", "besaran", "waktu", "nilai"], orient="row")
print("Baris data:", df.height)

# 2. Simpan sebagai Parquet berpartisi: satu subfolder per unit (gaya Hive: unit=kebun/)
ds.write_dataset(df.to_arrow(), gudang, format="parquet",
                 partitioning=["unit"], partitioning_flavor="hive")
print("Partisi:", sorted(p.name for p in gudang.iterdir()))

# 3. DuckDB: ringkasan harian per unit dan besaran, langsung dari folder
pola = (gudang / "*" / "*.parquet").as_posix()
harian = duckdb.sql(f"""
    SELECT unit, besaran, CAST(waktu AS DATE) AS hari,
           ROUND(AVG(nilai), 2) AS rata, ROUND(MIN(nilai), 2) AS minimum
    FROM read_parquet('{pola}', hive_partitioning = true)
    WHERE unit = 'kolam' AND besaran = 'oksigen_mgl'
    GROUP BY ALL ORDER BY hari
""")
print(harian)

# 4. Polars: jam-jam oksigen kolam di bawah ambang (angka contoh 4 mg/L, bukan anjuran)
rendah = (
    pl.scan_parquet(pola, hive_partitioning=True)
    .filter((pl.col("unit") == "kolam") & (pl.col("besaran") == "oksigen_mgl") & (pl.col("nilai") < 4.0))
    .sort("waktu")
    .collect()
)
print("Jam oksigen kolam di bawah 4 mg/L:", rendah.height)
print(rendah.select("waktu", "nilai").head(3))
Baris data: 432
Partisi: ['unit=kandang', 'unit=kebun', 'unit=kolam']
┌─────────┬─────────────┬────────────┬────────┬─────────┐
│ unit │ besaran │ hari │ rata │ minimum │
│ varchar │ varchar │ date │ double │ double │
├─────────┼─────────────┼────────────┼────────┼─────────┤
│ kolam │ oksigen_mgl │ 2026-03-01 │ 5.3 │ 4.12 │
│ kolam │ oksigen_mgl │ 2026-03-02 │ 5.4 │ 2.67 │
│ kolam │ oksigen_mgl │ 2026-03-03 │ 5.61 │ 3.25 │
└─────────┴─────────────┴────────────┴────────┴─────────┘
Jam oksigen kolam di bawah 4 mg/L: 4
shape: (3, 2)
┌─────────────────────┬───────┐
│ waktu ┆ nilai │
│ --- ┆ --- │
│ datetime[μs] ┆ f64 │
╞═════════════════════╪═══════╡
│ 2026-03-02 07:00:00 ┆ 3.62 │
│ 2026-03-02 09:00:00 ┆ 3.83 │
│ 2026-03-02 10:00:00 ┆ 2.67 │
└─────────────────────┴───────┘- 3 unit x 2 besaran x 72 jam = 432 baris, disimpan dalam tiga partisi bergaya Hive (
unit=kebun/,unit=kolam/,unit=kandang/). Nama folder itu sendiri menjadi kolomunitsaat dibaca (hive_partitioning). - Query DuckDB hanya menyentuh folder
unit=kolam: partisi lain dilewati. Itulah keuntungan partisi: memangkas data yang tidak diperlukan. - Oksigen kolam rata-rata 5,3 sampai 5,61 mg/L per hari, dengan minimum 2,67 mg/L pada 2 Maret. Polars menemukan 4 jam yang di bawah ambang contoh 4 mg/L. (Angka ambang ini hanya contoh, bukan anjuran budidaya.)
Latihan
- Ubah
02_polars.pyagar menyaringph < 7.0dan menghitung rata-rata oksigen per kolam. Baca rencana kerjanya: berapa kolom yang dibaca sekarang? - Tulis query DuckDB yang menghitung jumlah bacaan per kolam per blok 5.000 menit (petunjuk:
menit // 5000). - Tambahkan satu pemeriksaan ke
06_kualitas_sendiri.py: “suhu antara 15 dan 40” (angka contoh). Rusak datanya sengaja dan pastikan pemeriksaan itu GAGAL. - Tantangan: buat alur Prefect dengan tiga tugas (baca CSV dari
04_etl_elt.py, bersihkan dengan fungsietl, simpan Parquet). Beriretries=1pada tugas baca, lalu coba menghapus berkas CSV dan lihat alurnya gagal dengan rapi.
Ringkasan Bab
- Parquet menyimpan data per kolom, terkompresi, dengan skema dan statistik; membaca sebagian kolom itu murah. Arrow adalah “bahasa bersama” antaralat.
- Polars (mode malas,
scan_lalucollect()) dan DuckDB (SQL langsung atas berkas) mengolah data besar di satu komputer. - ETL mengubah sebelum menyimpan; ELT menyimpan mentah lalu mengubah di basis data.
- Kualitas data diperiksa di dalam pipeline: skema pandera atau fungsi pemeriksaan sendiri.
- Orkestrator (Prefect, Dagster, Airflow) mengatur urutan, ulang otomatis, jadwal, dan riwayat. Prefect dijalankan di bab ini; Dagster dan Airflow hanya dibahas dari dokumentasi.
- Pantau keberhasilan tiap jalan dan kesegaran data.
Selanjutnya, di Bab 51: data bumi yang besar tidak cukup disimpan rapi; ia harus bisa dibaca sebagian saja dari jauh. Kita belajar format cloud-native (COG, GeoParquet, Zarr), katalog STAC, dan LiDAR.