Bab 57 — Optimisasi dan Komputasi Evolusioner: Mencari Pilihan Terbaik
Seri A3 — Machine Learning untuk Sumber Daya Alam
Semua skrip bab ini ada di folder kode/bab57/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Di Bab 54-56 Anda melatih model supaya menebak. Sekarang kita memakai kemampuan komputer untuk memilih: dari jutaan kemungkinan rencana tanam atau campuran pakan, mana yang terbaik? Seorang pengelola kebun tahu persoalannya: tanaman yang paling untung biasanya juga yang paling mahal modalnya dan paling haus air. Tidak ada satu jawaban “terbaik”; yang ada kompromi. Bab ini mengajarkan cara mencarinya secara sistematis.
Semua angka biaya, pendapatan, gizi, dan pertumbuhan di bab ini adalah angka contoh untuk belajar teknik optimisasi. Bukan anjuran budidaya, harga pasar, atau formulasi pakan. Ransum dan rencana tanam nyata harus disusun bersama penyuluh atau ahli nutrisi ternak.
Algoritma genetika dari nol
Algoritma genetika (GA) meniru evolusi. Sekumpulan calon jawaban (populasi) saling bersaing. Yang lebih baik (nilai fitness lebih tinggi) lebih sering menjadi “orang tua”; dua orang tua disilangkan (crossover) menghasilkan anak; sedikit perubahan acak (mutasi) menjaga keragaman; yang terbaik dibawa langsung ke generasi berikut (elitisme). Ulangi puluhan generasi.
Contoh kita: menanam 30 petak dengan salah satu dari 4 tanaman, dengan anggaran terbatas. Satu calon jawaban (individu) adalah daftar 30 angka 0-3 (satu angka per petak, disebut gen).
01_ga_manual.py
# Bab 57 - Algoritma genetika dari nol: memilih tanaman untuk 30 petak (angka contoh, bukan anjuran budidaya)
import random

random.seed(42)
TANAMAN = ["padi", "jagung", "kopi", "kakao"]
BIAYA = {"padi": 6.0, "jagung": 4.5, "kopi": 9.0, "kakao": 8.0}            # juta rupiah per petak (contoh)
UNTUNG = {"padi": 11.0, "jagung": 8.0, "kopi": 16.0, "kakao": 13.5}        # juta rupiah per petak (contoh)
ANGGARAN = 190.0                                                           # juta rupiah untuk 30 petak
JUMLAH_PETAK = 30


def fitness(individu):
    """Individu = daftar 30 gen; tiap gen = nomor tanaman 0..3. Nilai tinggi = bagus; melanggar anggaran dihukum."""
    biaya = sum(BIAYA[TANAMAN[g]] for g in individu)
    untung = sum(UNTUNG[TANAMAN[g]] for g in individu)
    return untung - 10 * max(0, biaya - ANGGARAN)                          # hukuman bila lewat anggaran


def turnamen(populasi, k=3):
    return max(random.sample(populasi, k), key=fitness)                    # pilih yang terbaik dari 3 calon acak


def silang(a, b):
    titik = random.randint(1, JUMLAH_PETAK - 1)                            # potong di satu titik, tukar ekor
    return a[:titik] + b[titik:], b[:titik] + a[titik:]


def mutasi(individu, peluang=0.05):
    return [random.randrange(4) if random.random() < peluang else g for g in individu]


populasi = [[random.randrange(4) for _ in range(JUMLAH_PETAK)] for _ in range(40)]
for generasi in range(61):
    if generasi in (0, 10, 30, 60):
        terbaik = max(populasi, key=fitness)
        print(f"generasi {generasi:2d}: fitness terbaik = {fitness(terbaik):5.1f}")
    anak = [max(populasi, key=fitness)]                                    # elitisme: yang terbaik langsung lolos
    while len(anak) < len(populasi):
        a, b = silang(turnamen(populasi), turnamen(populasi))
        anak += [mutasi(a), mutasi(b)]
    populasi = anak[:len(populasi)]

terbaik = max(populasi, key=fitness)
print("\nRencana terbaik:", [TANAMAN[g] for g in terbaik])
print("Biaya :", sum(BIAYA[TANAMAN[g]] for g in terbaik), "juta | anggaran:", ANGGARAN)
print("Untung:", sum(UNTUNG[TANAMAN[g]] for g in terbaik), "juta")

# Pembanding: jawaban EKSAK lewat pemrograman dinamis (biaya dikali 2 agar menjadi bilangan bulat)
sisa = int(ANGGARAN * 2)
terbaik_dp = [[0.0] + [-1e9] * sisa for _ in range(JUMLAH_PETAK + 1)]
for n in range(1, JUMLAH_PETAK + 1):
    for b in range(sisa + 1):
        terbaik_dp[n][b] = max(terbaik_dp[n - 1][b - int(BIAYA[t] * 2)] + UNTUNG[t]
                               for t in TANAMAN if b >= int(BIAYA[t] * 2)) if b >= 9 else -1e9
print("Optimum eksak (pemrograman dinamis):", max(terbaik_dp[JUMLAH_PETAK]))
generasi 0: fitness terbaik = 339.0
generasi 10: fitness terbaik = 339.0
generasi 30: fitness terbaik = 341.5
generasi 60: fitness terbaik = 342.0
Rencana terbaik: ['kopi', 'padi', 'padi', 'kopi', 'padi', 'padi', 'kopi', 'jagung', 'padi', 'kakao', 'padi', 'jagung', 'padi', 'kakao', 'padi', 'padi', 'jagung', 'jagung', 'padi', 'padi', 'padi', 'jagung', 'kopi', 'padi', 'padi', 'padi', 'jagung', 'padi', 'kopi', 'padi']
Biaya : 190.0 juta | anggaran: 190.0
Untung: 342.0 juta
Optimum eksak (pemrograman dinamis): 345.0- Fitness = untung dikurangi hukuman besar bila biaya melebihi anggaran. Hukuman ini cara sederhana menangani batasan.
- Untung terbaik naik dari 339,0 (generasi 0, sudah lumayan karena populasi 40 calon acak) menjadi 342,0 (generasi 60), dengan biaya tepat 190,0 juta (habis anggaran).
- Untuk masalah sekecil ini kita bisa menghitung jawaban eksak dengan pemrograman dinamis: 345,0. GA menemukan 342,0, yaitu sekitar 99% dari optimum, tanpa jaminan mencapainya. Itulah sifat metode evolusioner: jawabannya bagus, tidak dijamin terbaik, tetapi bisa dipakai pada masalah yang tak punya rumus eksak.
GA dengan DEAP
Menulis operator sendiri bagus untuk belajar, tetapi untuk pekerjaan nyata ada pustaka DEAP yang menyediakan operator siap pakai.
02_deap_ga.py
# Bab 57 - Masalah yang sama dengan pustaka DEAP: operator genetika sudah tersedia
import random

from deap import algorithms, base, creator, tools

random.seed(42)
BIAYA = [6.0, 4.5, 9.0, 8.0]
UNTUNG = [11.0, 8.0, 16.0, 13.5]
ANGGARAN, JUMLAH_PETAK = 190.0, 30

creator.create("Maks", base.Fitness, weights=(1.0,))                      # weights positif = memaksimalkan
creator.create("Individu", list, fitness=creator.Maks)

kotak = base.Toolbox()
kotak.register("gen", random.randrange, 4)
kotak.register("individu", tools.initRepeat, creator.Individu, kotak.gen, n=JUMLAH_PETAK)
kotak.register("populasi", tools.initRepeat, list, kotak.individu)


def evaluasi(ind):
    biaya = sum(BIAYA[g] for g in ind)
    return (sum(UNTUNG[g] for g in ind) - 10 * max(0, biaya - ANGGARAN),)  # DEAP: fitness berupa tuple


kotak.register("evaluate", evaluasi)
kotak.register("mate", tools.cxOnePoint)
kotak.register("mutate", tools.mutUniformInt, low=0, up=3, indpb=0.05)
kotak.register("select", tools.selTournament, tournsize=3)

pop = kotak.populasi(n=40)
hof = tools.HallOfFame(1)
pop, catatan = algorithms.eaSimple(pop, kotak, cxpb=0.8, mutpb=0.3, ngen=60, halloffame=hof, verbose=False)
print("Fitness terbaik (DEAP):", hof[0].fitness.values[0])
print("Rencana:", list(hof[0]))
print("Jumlah generasi tercatat:", len(catatan) - 1)
Fitness terbaik (DEAP): 341.0
Rencana: [1, 2, 2, 3, 0, 0, 2, 0, 0, 0, 0, 1, 1, 0, 1, 0, 1, 3, 0, 0, 1, 0, 2, 1, 0, 2, 1, 0, 2, 0]
Jumlah generasi tercatat: 60DEAP memakai creator untuk membuat tipe fitness dan individu, dan toolbox untuk mendaftarkan operator (mate, mutate, select). Perhatikan dua kebiasaan DEAP: bobot weights=(1.0,) positif berarti memaksimalkan, dan fungsi evaluasi harus mengembalikan tuple (itu sebabnya ada koma di (... ,)). Hasilnya 341,0: berbeda sedikit dari versi manual karena operator dan parameternya tidak identik, dan tetap mendekati optimum 345,0.
GA butuh benih acak tetap (random.seed) agar hasil bisa diulang, dan dijalankan beberapa kali dengan benih berbeda sebelum Anda percaya pada satu hasil.
Dua tujuan sekaligus: dominasi dan front Pareto
Kini bayangkan dua tujuan yang bertentangan: biaya sekecil mungkin dan untung sebesar mungkin. Rencana A bisa lebih murah, rencana D lebih untung; tidak ada yang “terbaik mutlak”. Kita memakai konsep dominasi:
Rencana a mendominasi b bila a tidak lebih buruk di semua tujuan dan lebih baik di setidaknya satu.
Rencana yang tidak didominasi siapa pun membentuk front Pareto (dinamai ekonom Vilfredo Pareto): kumpulan kompromi terbaik. Kita hitung dengan tangan:
03_pareto_dasar.py
# Bab 57 - Dominasi dan front Pareto dihitung dengan tangan (dua tujuan: biaya kecil, untung besar)
import numpy as np

# Lima rencana: (biaya, untung) dalam juta rupiah (angka contoh)
rencana = {"A": (50, 70), "B": (60, 100), "C": (60, 80), "D": (80, 110), "E": (75, 105)}


def mendominasi(a, b):
    """a mendominasi b bila a tidak lebih buruk di semua tujuan dan lebih baik di setidaknya satu."""
    biaya_a, untung_a = a
    biaya_b, untung_b = b
    tidak_lebih_buruk = biaya_a <= biaya_b and untung_a >= untung_b
    lebih_baik = biaya_a < biaya_b or untung_a > untung_b
    return tidak_lebih_buruk and lebih_baik


for nama, nilai in rencana.items():
    pendominasi = [n for n, v in rencana.items() if n != nama and mendominasi(v, nilai)]
    print(f"{nama} {nilai}: didominasi oleh {pendominasi if pendominasi else 'tak seorang pun -> di front Pareto'}")

front = [n for n, v in rencana.items() if not any(mendominasi(w, v) for m, w in rencana.items() if m != n)]
print("\nFront Pareto:", front)

# Peringkat non-dominated sorting (inti NSGA-II): lepas front 1, cari front 2 dari sisanya, dst.
sisa, peringkat = dict(rencana), {}
nomor = 1
while sisa:
    f = [n for n, v in sisa.items() if not any(mendominasi(w, v) for m, w in sisa.items() if m != n)]
    for n in f:
        peringkat[n] = nomor
        del sisa[n]
    nomor += 1
print("Peringkat front:", peringkat)

# Crowding distance pada front 1: seberapa 'sepi' sebuah solusi dari tetangganya (makin besar makin dipertahankan)
f1 = sorted(front, key=lambda n: rencana[n][0])
nilai = np.array([rencana[n] for n in f1], dtype=float)
jarak = np.zeros(len(f1))
for k in range(2):
    urut = np.argsort(nilai[:, k])
    jarak[urut[0]] = jarak[urut[-1]] = np.inf                                # ujung selalu dipertahankan
    rentang = nilai[:, k].max() - nilai[:, k].min()
    for i in range(1, len(f1) - 1):
        jarak[urut[i]] += (nilai[urut[i + 1], k] - nilai[urut[i - 1], k]) / rentang
print("Crowding distance:", {n: round(float(j), 2) for n, j in zip(f1, jarak)})
A (50, 70): didominasi oleh tak seorang pun -> di front Pareto
B (60, 100): didominasi oleh tak seorang pun -> di front Pareto
C (60, 80): didominasi oleh ['B']
D (80, 110): didominasi oleh tak seorang pun -> di front Pareto
E (75, 105): didominasi oleh tak seorang pun -> di front Pareto
Front Pareto: ['A', 'B', 'D', 'E']
Peringkat front: {'A': 1, 'B': 1, 'D': 1, 'E': 1, 'C': 2}
Crowding distance: {'A': inf, 'B': 1.71, 'E': 0.92, 'D': inf}- C (biaya 60, untung 80) didominasi B (biaya sama 60, untung lebih tinggi 100). Ia tersingkir.
- A, B, D, E tidak saling mendominasi: setiap kali satu lebih murah, yang lain lebih untung. Mereka front Pareto (peringkat 1); C di front 2.
- Crowding distance mengukur seberapa “sepi” sebuah solusi di front: ujung front (A dan D) mendapat tak hingga supaya selalu dipertahankan; B (1,71) lebih sepi daripada E (0,92), jadi lebih dipertahankan saat harus memilih.
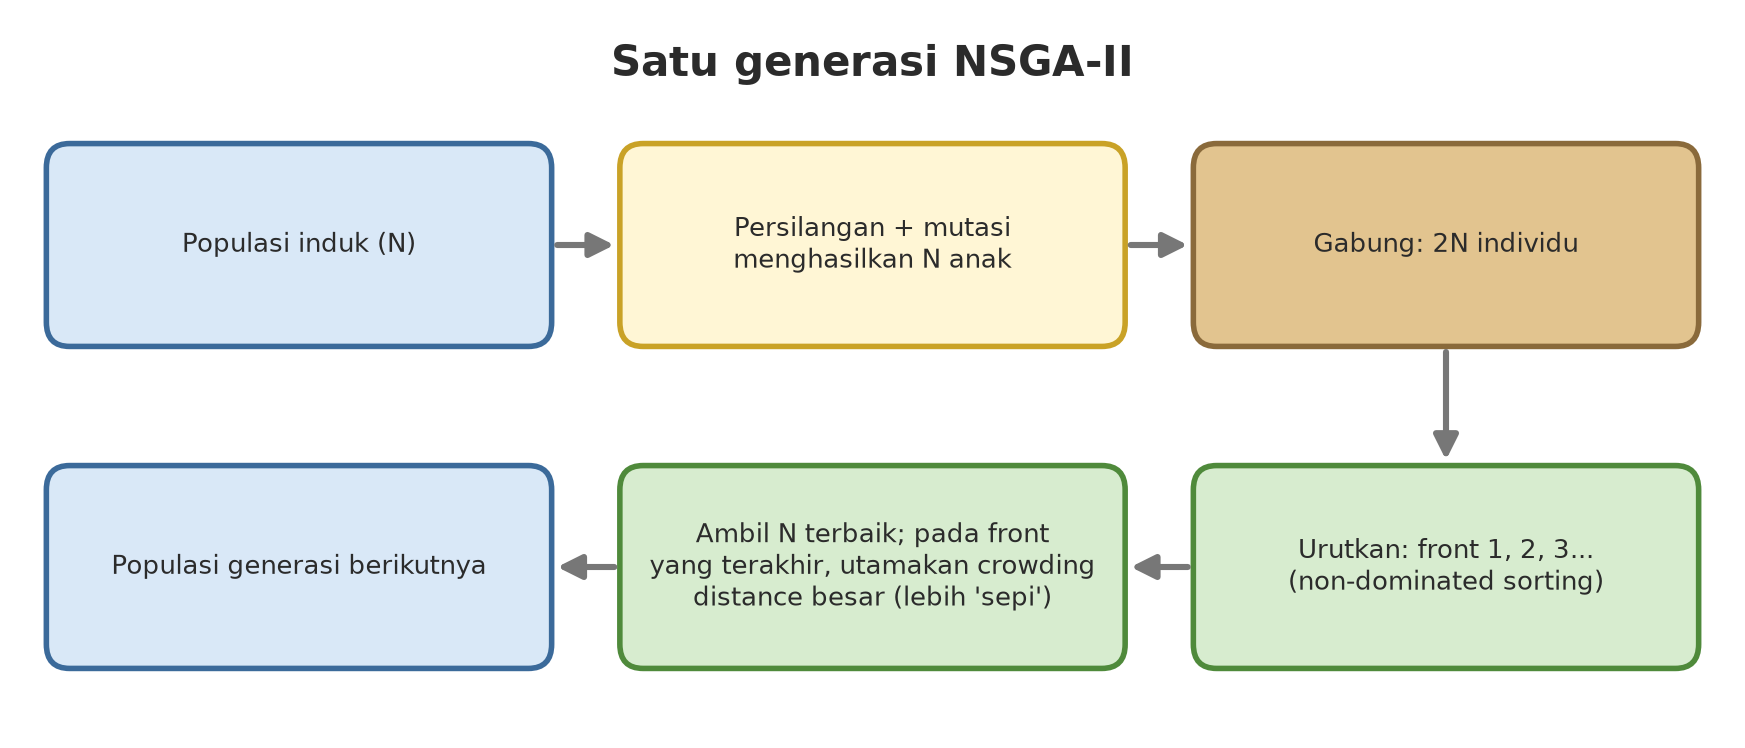
Dua hal itu, non-dominated sorting (mengurutkan menjadi front 1, 2, 3…) dan crowding distance, adalah jantung NSGA-II (Non-dominated Sorting Genetic Algorithm II). Dokumentasi pymoo (https://pymoo.org/algorithms/moo/nsga2.html, dibaca 2026-10-10) menjelaskan: individu dipilih front demi front; bila satu front hanya muat sebagian, sisa tempat diisi berdasarkan crowding distance, dan titik ujung berjarak tak hingga agar selalu bertahan.
NSGA-II dengan pymoo: rencana tanam
pymoo adalah pustaka optimisasi multi-objektif. Anda mendefinisikan sebuah kelas Problem: jumlah variabel, jumlah tujuan, jumlah batasan, lalu rumus tujuan di _evaluate. Dua kebiasaan pymoo yang harus diingat: semua tujuan diminimalkan (untung dibalik tandanya), dan batasan ditulis sebagai G <= 0 berarti terpenuhi (skrip memeriksanya di baris terakhir).
Masalah: 20 hektare, 4 tanaman, dua tujuan (biaya minimum, pendapatan maksimum), dengan dua batasan (air tersedia, padi minimal 4 ha untuk pangan). Variabel 0..1 diubah menjadi hektare dengan membagi jumlahnya, sehingga total selalu 20 ha.
04_nsga2_tanam.py
# Bab 57 - NSGA-II (pymoo): rencana tanam 20 ha, dua tujuan yang saling bertentangan (angka contoh)
import numpy as np
from pymoo.algorithms.moo.nsga2 import NSGA2
from pymoo.core.problem import ElementwiseProblem
from pymoo.optimize import minimize

TANAMAN = ["padi", "jagung", "kopi", "kakao"]
BIAYA = np.array([12.0, 9.0, 18.0, 16.0])        # juta rupiah per ha (contoh)
PENDAPATAN = np.array([22.0, 16.0, 34.0, 30.0])  # juta rupiah per ha (contoh)
AIR = np.array([9.0, 4.0, 3.0, 3.5])             # ribu m3 per ha (contoh)
LUAS_TOTAL, AIR_TERSEDIA, PADI_MINIMAL = 20.0, 100.0, 4.0


def luas(x):
    return LUAS_TOTAL * x / x.sum()               # nilai 0..1 diubah menjadi hektare yang jumlahnya selalu 20


class RencanaTanam(ElementwiseProblem):
    def __init__(self):
        super().__init__(n_var=4, n_obj=2, n_ieq_constr=2, xl=0.0, xu=1.0)

    def _evaluate(self, x, out, *args, **kwargs):
        ha = luas(np.maximum(x, 1e-9))
        biaya, pendapatan = BIAYA @ ha, PENDAPATAN @ ha
        out["F"] = [biaya, -pendapatan]                                   # pymoo MEMINIMALKAN; untung dibalik tandanya
        out["G"] = [AIR @ ha - AIR_TERSEDIA,                              # G <= 0 artinya syarat terpenuhi
                    PADI_MINIMAL - ha[0]]


hasil = minimize(RencanaTanam(), NSGA2(pop_size=60), ("n_gen", 80), seed=1, verbose=False)
F = hasil.F
print("Jumlah solusi di front Pareto:", len(F))
urut = np.argsort(F[:, 0])
for nama, i in [("termurah", urut[0]), ("tengah", urut[len(urut) // 2]), ("termahal", urut[-1])]:
    ha = luas(hasil.X[i])
    print(f"{nama:9s}: biaya = {F[i, 0]:6.1f} | pendapatan = {-F[i, 1]:6.1f} | ha = "
          + ", ".join(f"{t} {h:.1f}" for t, h in zip(TANAMAN, ha)))
print("Semua solusi memenuhi batas air dan padi minimal:", bool((hasil.G <= 1e-6).all()))
Jumlah solusi di front Pareto: 60
termurah : biaya = 196.4 | pendapatan = 352.8 | ha = padi 4.0, jagung 15.5, kopi 0.5, kakao 0.0
tengah : biaya = 262.8 | pendapatan = 485.5 | ha = padi 4.5, jagung 7.8, kopi 7.6, kakao 0.1
termahal : biaya = 335.5 | pendapatan = 631.0 | ha = padi 4.1, jagung 0.0, kopi 15.9, kakao 0.0
Semua solusi memenuhi batas air dan padi minimal: TrueFront punya 60 solusi (ukuran populasi). Tiga contoh: yang termurah (biaya 196,4 juta, pendapatan 352,8 juta; banyak jagung), yang tengah (biaya 262,8; pendapatan 485,5; jagung dan kopi berimbang), dan yang termahal (biaya 335,5; pendapatan 631,0; hampir semuanya kopi). Padi tetap sekitar 4 ha karena itulah batas minimalnya. Semua solusi memenuhi batasan air dan padi. Tugas pengelola bukan lagi mencari satu jawaban, tetapi memilih titik di front sesuai modal dan risiko yang bisa ditanggung.
NSGA-II untuk ransum pakan
Masalah yang sama bentuknya, di kandang: campuran 4 bahan pakan; tujuan: biaya per ekor per hari minimum dan pertumbuhan harian maksimum, dengan syarat protein minimal 12% dan serat minimal 15%. Pertumbuhan dihitung model tiruan yang jenuh (hasil menurun): menambah protein dan energi makin lama makin sedikit manfaatnya.
05_nsga2_ransum.py
# Bab 57 - NSGA-II untuk ransum pakan sapi: biaya vs pertumbuhan harian (angka contoh, BUKAN anjuran pakan)
import numpy as np
from pymoo.algorithms.moo.nsga2 import NSGA2
from pymoo.core.problem import ElementwiseProblem
from pymoo.optimize import minimize

BAHAN = ["rumput", "dedak", "bungkil", "jagung_giling"]
HARGA = np.array([800.0, 3500.0, 6500.0, 5000.0])    # rupiah per kg bahan (contoh)
PROTEIN = np.array([0.08, 0.12, 0.40, 0.09])         # fraksi protein kasar (contoh)
ENERGI = np.array([1.8, 2.6, 3.0, 3.4])              # Mkal per kg (contoh)
SERAT = np.array([0.30, 0.12, 0.10, 0.03])           # fraksi serat (contoh)
BAHAN_KERING_KG = 10.0                               # jatah per ekor per hari


def komposisi(x):
    return x / x.sum()


def pertumbuhan_kg_per_hari(frak):
    """Model tiruan: tumbuh naik dengan energi dan protein, tetapi jenuh (hasil menurun)."""
    energi = (ENERGI @ frak) * BAHAN_KERING_KG
    protein = (PROTEIN @ frak) * BAHAN_KERING_KG
    return 1.1 * (1 - np.exp(-energi / 20)) * (1 - np.exp(-protein / 0.9))


class Ransum(ElementwiseProblem):
    def __init__(self):
        super().__init__(n_var=4, n_obj=2, n_ieq_constr=2, xl=0.0, xu=1.0)

    def _evaluate(self, x, out, *args, **kwargs):
        f = komposisi(np.maximum(x, 1e-9))
        biaya = HARGA @ f * BAHAN_KERING_KG
        out["F"] = [biaya, -pertumbuhan_kg_per_hari(f)]
        out["G"] = [0.12 - PROTEIN @ f,              # protein minimal 12%
                    0.15 - SERAT @ f]                # serat minimal 15% (kesehatan rumen)


hasil = minimize(Ransum(), NSGA2(pop_size=60), ("n_gen", 100), seed=1, verbose=False)
F = hasil.F
urut = np.argsort(F[:, 0])
print("Solusi di front Pareto:", len(F))
print("biaya/ekor/hari (Rp) | pertumbuhan (kg/hari) | komposisi")
for i in urut[:: max(1, len(urut) // 5)]:
    f = komposisi(hasil.X[i])
    print(f"{F[i, 0]:12,.0f} | {-F[i, 1]:9.2f} | " + ", ".join(f"{b} {p:.0%}" for b, p in zip(BAHAN, f)))
Solusi di front Pareto: 60
biaya/ekor/hari (Rp) | pertumbuhan (kg/hari) | komposisi
15,128 | 0.50 | rumput 87%, dedak 0%, bungkil 13%, jagung_giling 0%
21,847 | 0.59 | rumput 76%, dedak 0%, bungkil 24%, jagung_giling 0%
28,606 | 0.66 | rumput 64%, dedak 0%, bungkil 36%, jagung_giling 0%
35,788 | 0.71 | rumput 51%, dedak 0%, bungkil 49%, jagung_giling 0%
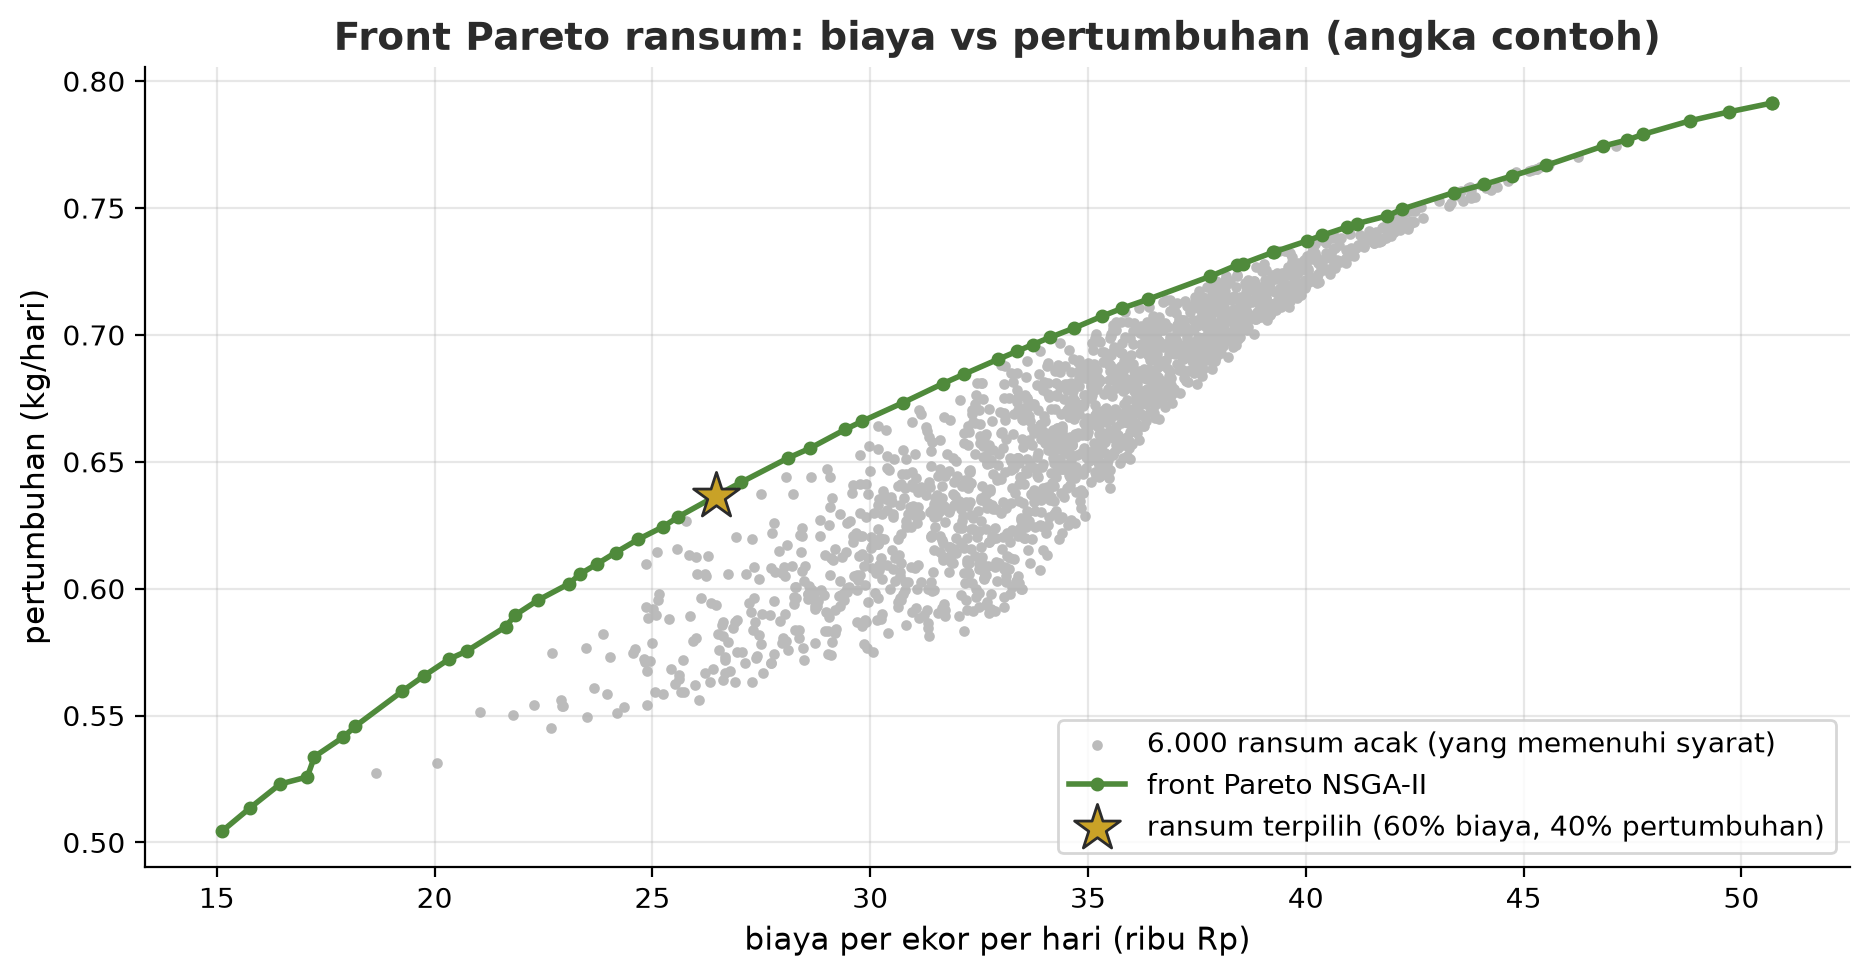
42,216 | 0.75 | rumput 40%, dedak 1%, bungkil 60%, jagung_giling 0%Dari front: ransum Rp15.128 per hari menghasilkan 0,50 kg/hari (87% rumput); untuk 0,75 kg/hari biaya naik ke Rp42.216 (60% bungkil). Perhatikan hasil menurun: dari 0,50 ke 0,59 kg butuh tambahan Rp6.719, sedangkan dari 0,71 ke 0,75 kg butuh tambahan Rp6.428 untuk hanya 0,04 kg. Informasi seperti ini membantu peternak memutuskan sampai di mana tambahan pakan masih layak.
NSGA-III: bila tujuannya tiga atau lebih
Dengan banyak tujuan (biasanya lebih dari tiga), crowding distance kurang efektif. NSGA-III menggantinya dengan arah acuan (reference directions): titik-titik yang disebar merata di ruang tujuan, dan solusi dipilih agar tiap arah punya wakil. Dokumentasi pymoo (https://pymoo.org/algorithms/moo/nsga3.html, dibaca 2026-10-10) menyebut pembuatannya dengan get_reference_directions("das-dennis", jumlah_tujuan, n_partitions=...) lalu NSGA3(pop_size=..., ref_dirs=...).
Kita tambah tujuan ketiga: nitrogen terbuang (protein berlebih akhirnya keluar lewat kotoran; model tiruan).
06_nsga3_tiga_tujuan.py
# Bab 57 - NSGA-III (pymoo): tiga tujuan sekaligus untuk ransum (biaya, pertumbuhan, nitrogen terbuang)
import numpy as np
from pymoo.algorithms.moo.nsga3 import NSGA3
from pymoo.core.problem import ElementwiseProblem
from pymoo.optimize import minimize
from pymoo.util.ref_dirs import get_reference_directions

HARGA = np.array([800.0, 3500.0, 6500.0, 5000.0])    # rupiah per kg (contoh)
PROTEIN = np.array([0.08, 0.12, 0.40, 0.09])
ENERGI = np.array([1.8, 2.6, 3.0, 3.4])
SERAT = np.array([0.30, 0.12, 0.10, 0.03])
KG = 10.0


class RansumTigaTujuan(ElementwiseProblem):
    def __init__(self):
        super().__init__(n_var=4, n_obj=3, n_ieq_constr=2, xl=0.0, xu=1.0)

    def _evaluate(self, x, out, *args, **kwargs):
        f = np.maximum(x, 1e-9)
        f = f / f.sum()
        energi, protein = (ENERGI @ f) * KG, (PROTEIN @ f) * KG
        tumbuh = 1.1 * (1 - np.exp(-energi / 20)) * (1 - np.exp(-protein / 0.9))
        biaya = HARGA @ f * KG
        nitrogen = max(0.0, protein - 0.16 * tumbuh * 2.0)       # protein kelebihan dibuang lewat kotoran (model tiruan)
        out["F"] = [biaya / 1000, -tumbuh * 10, nitrogen]       # semua diminimalkan; skala dibuat sebanding
        out["G"] = [0.12 - PROTEIN @ f, 0.15 - SERAT @ f]


# Titik acuan tersebar rata di segitiga tujuan; jumlahnya (n_partitions=8, 3 tujuan) = C(10,2) = 45
ref_dirs = get_reference_directions("das-dennis", 3, n_partitions=8)
print("Jumlah arah acuan:", len(ref_dirs))
hasil = minimize(RansumTigaTujuan(), NSGA3(pop_size=len(ref_dirs), ref_dirs=ref_dirs),
                 ("n_gen", 150), seed=1, verbose=False)
F = hasil.F
print("Solusi akhir:", len(F))
print("Rentang tiap tujuan (min - maks):")
for nama, k in [("biaya (ribu Rp)", 0), ("-pertumbuhan x10", 1), ("nitrogen terbuang", 2)]:
    print(f"  {nama:20s} {F[:, k].min():8.2f} - {F[:, k].max():8.2f}")
Jumlah arah acuan: 45
Solusi akhir: 21
Rentang tiap tujuan (min - maks):
biaya (ribu Rp) 15.15 - 49.97
-pertumbuhan x10 -7.88 - -5.05
nitrogen terbuang 1.02 - 2.90Dengan 3 tujuan dan n_partitions=8 terbentuk 45 arah acuan (jumlahnya C(10,2) = 45). Dari 45 individu, 21 tersisa sebagai solusi tak terdominasi akhir. Rentang tujuan memperlihatkan seberapa lebar pilihannya: biaya 15,15 sampai 49,97 ribu rupiah, pertumbuhan (dikali 10) 5,05 sampai 7,88, nitrogen terbuang 1,02 sampai 2,90.
PSO dan simulated annealing
Dua metode lain, keduanya untuk satu tujuan, tanpa turunan:
- PSO (particle swarm optimization): kawanan partikel terbang di peta pencarian, masing-masing tertarik ke rekor terbaik pribadinya dan rekor terbaik kawanan, seperti kawanan burung mencari makan.
- Simulated annealing (penyepuhan simulasi): berjalan acak menuju titik lebih baik, tetapi dengan peluang menerima langkah lebih buruk yang mengecil seiring “suhu” turun, seperti logam yang didinginkan perlahan. Ini membantu lolos dari jebakan lokal.
Soal: menaruh gudang pupuk agar jumlah jarak ke 8 kebun minimum (koordinat contoh).
07_pso_sa.py
# Bab 57 - PSO (kawanan partikel) dan simulated annealing: menaruh gudang pupuk agar jarak ke 8 kebun minimum
import math
import random

import numpy as np

random.seed(1)
rng = np.random.default_rng(1)
KEBUN = np.array([[1, 1], [2, 8], [4, 5], [6, 2], [7, 7], [8, 4], [9, 9], [3, 3]], dtype=float)   # km (contoh)


def total_jarak(titik):
    return float(np.sqrt(((KEBUN - titik) ** 2).sum(axis=1)).sum())


# --- PSO: 20 partikel terbang di peta; tiap partikel tertarik ke rekor pribadinya dan rekor kawanan
posisi = rng.uniform(0, 10, (20, 2))
kecepatan = np.zeros((20, 2))
rekor_pribadi = posisi.copy()
nilai_pribadi = np.array([total_jarak(p) for p in posisi])
rekor_kawanan = rekor_pribadi[nilai_pribadi.argmin()].copy()
for _ in range(60):
    r1, r2 = rng.random((20, 2)), rng.random((20, 2))
    kecepatan = 0.7 * kecepatan + 1.5 * r1 * (rekor_pribadi - posisi) + 1.5 * r2 * (rekor_kawanan - posisi)
    posisi = np.clip(posisi + kecepatan, 0, 10)
    nilai = np.array([total_jarak(p) for p in posisi])
    lebih_baik = nilai < nilai_pribadi
    rekor_pribadi[lebih_baik], nilai_pribadi[lebih_baik] = posisi[lebih_baik], nilai[lebih_baik]
    rekor_kawanan = rekor_pribadi[nilai_pribadi.argmin()].copy()
print("PSO               : titik =", rekor_kawanan.round(2).tolist(), "| total jarak =", round(total_jarak(rekor_kawanan), 3))

# --- Simulated annealing: boleh menerima langkah yang lebih buruk, terutama saat "suhu" tinggi
titik = np.array([random.uniform(0, 10), random.uniform(0, 10)])
terbaik, nilai_terbaik = titik.copy(), total_jarak(titik)
suhu = 5.0
for langkah in range(3000):
    calon = np.clip(titik + np.array([random.gauss(0, 0.5), random.gauss(0, 0.5)]), 0, 10)
    selisih = total_jarak(calon) - total_jarak(titik)
    if selisih < 0 or random.random() < math.exp(-selisih / suhu):    # peluang menerima langkah buruk
        titik = calon
        if total_jarak(titik) < nilai_terbaik:
            terbaik, nilai_terbaik = titik.copy(), total_jarak(titik)
    suhu *= 0.998                                                    # didinginkan perlahan
print("Simulated annealing: titik =", terbaik.round(2).tolist(), "| total jarak =", round(nilai_terbaik, 3))

# Pembanding: pencarian kasar pada grid 0,05 km
grid = [(x, y) for x in np.arange(0, 10.01, 0.05) for y in np.arange(0, 10.01, 0.05)]
terbaik_grid = min(grid, key=lambda p: total_jarak(np.array(p)))
print("Pembanding grid    : titik =", [round(float(v), 2) for v in terbaik_grid], "| total jarak =", round(total_jarak(np.array(terbaik_grid)), 3))
PSO : titik = [4.57, 4.74] | total jarak = 28.356
Simulated annealing: titik = [4.56, 4.74] | total jarak = 28.356
Pembanding grid : titik = [4.55, 4.75] | total jarak = 28.356Ketiganya sepakat pada total jarak 28,356 km di sekitar (4,56; 4,74). PSO dan simulated annealing menemukan titik yang praktis sama dengan pencarian kasar pada grid 0,05 km. Pembanding grid hanya mungkin di masalah 2 dimensi; pada masalah dengan puluhan variabel, itulah gunanya metode ini.
Bayesian optimization dan Optuna
Melatih model itu mahal, jadi mencoba ratusan kombinasi hiperparameter secara buta boros. Bayesian optimization membangun model dari percobaan sebelumnya untuk menebak kombinasi mana yang layak dicoba berikutnya. Optuna adalah pustaka populer untuk ini. Sampler bawaannya TPESampler (Tree-structured Parzen Estimator; dokumentasi Optuna, dibaca 2026-10-10, menyebut anjuran 100-1000 percobaan, dan kita hanya memakai 25-40 supaya cepat).
Skrip memakai data lahan Bab 54 dengan validasi silang blok. Pertama satu tujuan (akurasi), lalu dua tujuan (akurasi vs ukuran model; “ukuran” = jumlah pohon x kedalaman, pengganti waktu prediksi yang stabil):
08_optuna.py
# Bab 57 - Optuna: mencari hiperparameter dengan Bayesian optimization (TPE), satu dan dua tujuan
import optuna
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GroupKFold, cross_val_score

from buat_data import FITUR, buat_lahan   # modul bantu: salinan dari Bab 54, ada di folder yang sama

optuna.logging.set_verbosity(optuna.logging.WARNING)
df = buat_lahan()
X, y, kelompok = df[FITUR], df["kelas"], df["blok"]


def akurasi(pohon, kedalaman, maks_fitur):
    model = RandomForestClassifier(n_estimators=pohon, max_depth=kedalaman, max_features=maks_fitur,
                                   random_state=42, n_jobs=1)
    return cross_val_score(model, X, y, groups=kelompok, cv=GroupKFold(n_splits=4)).mean()


# 1) Satu tujuan: akurasi setinggi mungkin (validasi silang blok dari Bab 54)
def tujuan_tunggal(trial):
    return akurasi(trial.suggest_int("n_estimators", 20, 200, step=20),
                   trial.suggest_int("max_depth", 2, 12),
                   trial.suggest_float("max_features", 0.25, 1.0))


studi = optuna.create_study(direction="maximize", sampler=optuna.samplers.TPESampler(seed=42))
studi.optimize(tujuan_tunggal, n_trials=25)
print("Satu tujuan  - akurasi terbaik:", round(studi.best_value, 3))
print("               hiperparameter  :", {k: (round(v, 2) if isinstance(v, float) else v) for k, v in studi.best_params.items()})


# 2) Dua tujuan: akurasi (maks) vs ukuran model (min). Ukuran = pohon x kedalaman, proksi waktu prediksi yang stabil
def dua_tujuan(trial):
    pohon = trial.suggest_int("n_estimators", 20, 200, step=20)
    kedalaman = trial.suggest_int("max_depth", 2, 12)
    return akurasi(pohon, kedalaman, 0.75), pohon * kedalaman


studi2 = optuna.create_study(directions=["maximize", "minimize"], sampler=optuna.samplers.NSGAIISampler(seed=42))
studi2.optimize(dua_tujuan, n_trials=40)
front = sorted(studi2.best_trials, key=lambda t: t.values[1])
print("\nDua tujuan   - jumlah solusi Pareto:", len(front))
print("ukuran (pohon x kedalaman) | akurasi")
for t in front:
    print(f"{t.values[1]:14.0f}             | {t.values[0]:.3f}")
Satu tujuan - akurasi terbaik: 0.889
hiperparameter : {'n_estimators': 200, 'max_depth': 12, 'max_features': 0.55}
Dua tujuan - jumlah solusi Pareto: 6
ukuran (pohon x kedalaman) | akurasi
80 | 0.868
100 | 0.876
280 | 0.881
280 | 0.881
540 | 0.885
1280 | 0.885- Satu tujuan: akurasi terbaik 0,889 dengan 200 pohon, kedalaman 12, dan 55% fitur per pemisahan.
- Dua tujuan: 6 solusi Pareto. Model berukuran 80 (misalnya 20 pohon kedalaman 4) sudah mencapai 0,868; model 16 kali lebih besar (1280) hanya naik ke 0,885. Dua tujuan memperlihatkan bahwa tambahan akurasi terakhir sangat mahal, informasi yang hilang bila kita hanya mengejar akurasi.
- Dua baris dengan ukuran 280 memiliki nilai sama: dua kombinasi berbeda yang menghasilkan hal serupa.
Hal yang sama dapat dilakukan untuk hiperparameter YOLO (akurasi mAP vs kecepatan inferensi): trial.suggest_* lalu melatih YOLO di dalam fungsi tujuan. Kami tidak menjalankannya di buku karena satu percobaan memakan 2 sampai 3 menit di GPU (Bab 56), sehingga puluhan percobaan terlalu lama untuk dibangun otomatis. Pola kodenya sama dengan skrip di atas.
Proyek Bersambung A3: memilih satu ransum dan membuktikan nilai NSGA-II
Dua pertanyaan tersisa: (1) bagaimana memilih satu titik dari front? (2) apakah NSGA-II benar-benar lebih baik daripada mencoba acak dengan jumlah evaluasi sama? Jawaban (2) memakai hypervolume: luas ruang tujuan yang “dikuasai” front terhadap sebuah titik acuan terburuk (makin besar makin baik).
09_proyek_pilih_solusi.py
# Bab 57 - Proyek A3: memilih satu ransum dari front Pareto, dan membuktikan NSGA-II lebih baik daripada coba-coba acak
import numpy as np
from pymoo.algorithms.moo.nsga2 import NSGA2
from pymoo.core.problem import ElementwiseProblem
from pymoo.indicators.hv import HV
from pymoo.mcdm.pseudo_weights import PseudoWeights
from pymoo.optimize import minimize

BAHAN = ["rumput", "dedak", "bungkil", "jagung_giling"]
HARGA = np.array([800.0, 3500.0, 6500.0, 5000.0])
PROTEIN = np.array([0.08, 0.12, 0.40, 0.09])
ENERGI = np.array([1.8, 2.6, 3.0, 3.4])
SERAT = np.array([0.30, 0.12, 0.10, 0.03])
KG = 10.0


def hitung(x):
    f = np.maximum(x, 1e-9)
    f = f / f.sum()
    tumbuh = 1.1 * (1 - np.exp(-(ENERGI @ f) * KG / 20)) * (1 - np.exp(-(PROTEIN @ f) * KG / 0.9))
    return f, HARGA @ f * KG, tumbuh, [0.12 - PROTEIN @ f, 0.15 - SERAT @ f]


class Ransum(ElementwiseProblem):
    def __init__(self):
        super().__init__(n_var=4, n_obj=2, n_ieq_constr=2, xl=0.0, xu=1.0)

    def _evaluate(self, x, out, *args, **kwargs):
        _, biaya, tumbuh, g = hitung(x)
        out["F"], out["G"] = [biaya / 1000, -tumbuh], g          # biaya dalam ribu rupiah


masalah = Ransum()
hasil = minimize(masalah, NSGA2(pop_size=60), ("n_gen", 100), seed=1, verbose=False)   # 60 x 100 = 6.000 evaluasi

# Pembanding: 6.000 ransum acak yang memenuhi syarat
rng = np.random.default_rng(1)
acak = []
for _ in range(6000):
    x = rng.random(4)
    _, biaya, tumbuh, g = hitung(x)
    if max(g) <= 0:
        acak.append([biaya / 1000, -tumbuh])
acak = np.array(acak)
patokan = np.array([60.0, 0.0])                                  # titik acuan hypervolume: biaya 60 ribu, pertumbuhan 0
hv = HV(ref_point=patokan)
print("Ransum acak yang memenuhi syarat:", len(acak), "dari 6000")
print("Hypervolume NSGA-II :", round(float(hv(hasil.F)), 2))
print("Hypervolume acak    :", round(float(hv(acak)), 2), "(lebih besar = front lebih baik)")

# Memilih satu solusi: bobot preferensi pengambil keputusan (60% biaya, 40% pertumbuhan)
i = PseudoWeights(np.array([0.6, 0.4])).do(hasil.F)
f, biaya, tumbuh, _ = hitung(hasil.X[i])
print("\nRansum terpilih (preferensi 60% hemat biaya, 40% pertumbuhan):")
print("  komposisi:", ", ".join(f"{b} {p:.0%}" for b, p in zip(BAHAN, f)))
print(f"  biaya {biaya:,.0f} Rp/ekor/hari | pertumbuhan {tumbuh:.2f} kg/hari")
print("  Catatan: model tiruan; ransum nyata disusun bersama ahli nutrisi ternak.")
Ransum acak yang memenuhi syarat: 1677 dari 6000
Hypervolume NSGA-II : 31.32
Hypervolume acak : 29.01 (lebih besar = front lebih baik)
Ransum terpilih (preferensi 60% hemat biaya, 40% pertumbuhan):
komposisi: rumput 68%, dedak 0%, bungkil 32%, jagung_giling 0%
biaya 26,454 Rp/ekor/hari | pertumbuhan 0.64 kg/hari
Catatan: model tiruan; ransum nyata disusun bersama ahli nutrisi ternak.- Dari 6.000 ransum acak, hanya 1.677 memenuhi syarat protein dan serat; sisanya melanggar. Hypervolume acak 29,01, NSGA-II 31,32 dengan jumlah evaluasi sama (60 x 100 = 6.000): NSGA-II lebih baik, karena ia memusatkan pencarian pada daerah menjanjikan.
- PseudoWeights menerima bobot preferensi pengambil keputusan (di sini 60% penting hemat biaya, 40% penting pertumbuhan) dan memilih solusi di front yang paling sesuai: 68% rumput + 32% bungkil, biaya Rp26.454 per ekor per hari, pertumbuhan 0,64 kg/hari (bintang di gambar). Pengambil keputusan manusia tetap menentukan bobotnya.
Hasil proyek ini berlanjut ke Bab 59, di mana rencana tanam dan ransum menjadi bagian dari sistem informasi pertanian.
Latihan
- Di
01_ga_manual.py, ubah peluang mutasi dari 0,05 menjadi 0,0 dan 0,3. Bagaimana fitness akhir berubah, dan mengapa? - Di
04_nsga2_tanam.py, naikkanPADI_MINIMALmenjadi 10 ha. Bagaimana front bergeser? Apakah masih ada solusi yang memenuhi batas air? - Di
08_optuna.py, ubahn_trialspada studi satu tujuan menjadi 10 dan 60. Apakah akurasi terbaik selalu naik? - Tantangan: tambahkan tujuan ketiga pada
04_nsga2_tanam.py: kebutuhan air total (diminimalkan), pindahkan batasan air menjadi tujuan, lalu jalankan NSGA-III seperti di skrip 06.
Ringkasan Bab
- Algoritma genetika: populasi, seleksi, silang, mutasi, elitisme; jawabannya bagus tetapi tidak dijamin optimum (GA 342,0 vs eksak 345,0).
- Dominasi dan front Pareto: kumpulan kompromi terbaik bila tujuan saling bertentangan.
- NSGA-II: urutkan menjadi front (non-dominated sorting) dan jaga keragaman dengan crowding distance; NSGA-III: arah acuan untuk tiga tujuan atau lebih.
- pymoo meminimalkan semua tujuan dan memakai
G <= 0untuk batasan; DEAP memakai tuple fitness dan bobot. - PSO, simulated annealing, dan Optuna (TPE) untuk satu tujuan; Optuna juga mendukung multi-objektif.
- Memilih satu solusi dari front adalah keputusan manusia (preferensi, pseudo-weights), dan hypervolume membuktikan kualitas front.
Selanjutnya, di Bab 58: model sudah pintar dan pilihan sudah optimal, tetapi bisakah kita menjelaskan dan memercayainya? Bab 58 membahas SHAP, MLflow, pemantauan drift, dan AI yang bertanggung jawab.