Bab 56 — Computer Vision: Mengajari Komputer Melihat Pohon
Seri A3 — Machine Learning untuk Sumber Daya Alam
Semua skrip bab ini ada di folder kode/bab56/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Seorang petugas kehutanan yang menghitung pohon dari foto udara melakukannya dengan mata dan jari: tunjuk, hitung, catat. Untuk ratusan hektare itu berminggu-minggu. Computer vision mengajari komputer melakukan hal yang sama dalam detik. Bab 55 sudah menyiapkan GPU dan PyTorch; sekarang kita memakainya untuk melihat.
Semua citra di bab ini tiruan: tajuk pohon digambar skrip sebagai lingkaran hijau pada latar tanah berderau (buat_dataset.py). Tugas ini jauh lebih mudah daripada foto drone sungguhan (bayangan, jenis pohon campur, awan, tajuk menyatu). Angka mAP tinggi di bab ini bukan janji untuk data nyata.
Citra digital: sebuah grid angka
Citra berwarna adalah larik tiga dimensi: tinggi x lebar x saluran warna. Tiap angka 0 sampai 255 (tipe uint8) menyatakan terang satu saluran. Dua pustaka yang paling sering dipakai: Pillow (PIL, urutan saluran RGB) dan OpenCV (cv2, urutan BGR).
01_citra_digital.py
# Bab 56 - Citra digital: grid angka. OpenCV (urutan BGR) vs Pillow (urutan RGB)
import cv2
import numpy as np
from PIL import Image

from buat_dataset import TMP

TMP.mkdir(exist_ok=True)

# Citra 4 x 4 piksel, 3 saluran: kiri hijau (daun), kanan cokelat (tanah)
kecil = np.zeros((4, 4, 3), dtype=np.uint8)
kecil[:, :2] = (40, 160, 60)         # (R, G, B) hijau
kecil[:, 2:] = (130, 90, 50)         # (R, G, B) cokelat
print("Bentuk (tinggi, lebar, saluran):", kecil.shape, "| tipe:", kecil.dtype)
print("Piksel kiri atas  (R,G,B):", kecil[0, 0].tolist())

# Pillow menyimpan sesuai urutan RGB; OpenCV mengira array berurutan BGR
Image.fromarray(kecil).resize((200, 200), Image.NEAREST).save(TMP / "kecil_pillow.png")
cv2.imwrite(str(TMP / "kecil_cv_salah.png"), kecil)                                # JEBAKAN: warna tertukar
cv2.imwrite(str(TMP / "kecil_cv_benar.png"), cv2.cvtColor(kecil, cv2.COLOR_RGB2BGR))

dibaca_pillow = np.array(Image.open(TMP / "kecil_pillow.png").convert("RGB"))
dibaca_cv = cv2.imread(str(TMP / "kecil_cv_salah.png"))                            # OpenCV membaca sebagai BGR
print("\nPiksel kiri atas, Pillow membaca (RGB):", dibaca_pillow[0, 0].tolist())
print("Piksel kiri atas, file 'salah' dibaca kembali oleh OpenCV (BGR, cocok dengan array asal):", dibaca_cv[0, 0].tolist())
print("Pillow membuka file 'salah' (R,G,B):", np.array(Image.open(TMP / "kecil_cv_salah.png").convert("RGB"))[0, 0].tolist(),
      "<- merah dan biru tertukar")

# Indeks hijau sederhana (ExG = 2G - R - B), awal dari "indeks vegetasi" di Bab 59
r, g, b = (kecil[..., i].astype(int) for i in range(3))
exg = 2 * g - r - b
print("\nIndeks hijau ExG kolom daun   :", exg[0, 0], "| kolom tanah:", exg[0, 3])
Bentuk (tinggi, lebar, saluran): (4, 4, 3) | tipe: uint8
Piksel kiri atas (R,G,B): [40, 160, 60]
Piksel kiri atas, Pillow membaca (RGB): [40, 160, 60]
Piksel kiri atas, file 'salah' dibaca kembali oleh OpenCV (BGR, cocok dengan array asal): [40, 160, 60]
Pillow membuka file 'salah' (R,G,B): [60, 160, 40] <- merah dan biru tertukar
Indeks hijau ExG kolom daun : 220 | kolom tanah: 0Piksel hijau daun kita (R=40, G=160, B=60). Perhatikan baris terakhir: file yang ditulis OpenCV dari larik RGB, lalu dibuka Pillow, menampilkan (60, 160, 40): merah dan biru tertukar. Di layar, daun hijau tetap tampak hijau karena hijau ada di tengah, tetapi tanah cokelat berubah menjadi kebiruan. Selalu ingat: Pillow RGB, OpenCV BGR; ubah dengan cv2.cvtColor(..., cv2.COLOR_RGB2BGR). ExG (2G - R - B) adalah indeks hijau sederhana yang memberi 220 pada daun dan 0 pada tanah: cikal bakal NDVI di Bab 59.
Klasifikasi, deteksi, segmentasi
| Tugas | Pertanyaan | Keluaran | Contoh kehutanan |
|---|---|---|---|
| Klasifikasi | “Citra ini apa?” | Satu label per citra | Daun sehat atau bercak (Bab 55) |
| Deteksi objek | “Ada apa saja, dan di mana?” | Kotak + kelas + skor | Menghitung dan menempatkan tajuk pohon |
| Segmentasi | “Piksel mana yang milik apa?” | Label per piksel | Luas tajuk, batas hutan dan lahan terbuka |
Deteksi menjawab “berapa dan di mana”; segmentasi menjawab “seluas apa”. Segmentasi semantik menandai kelas tiap piksel; segmentasi instans (Mask R-CNN) juga membedakan pohon satu dari pohon lainnya.
Mengukur detektor: IoU dan mAP
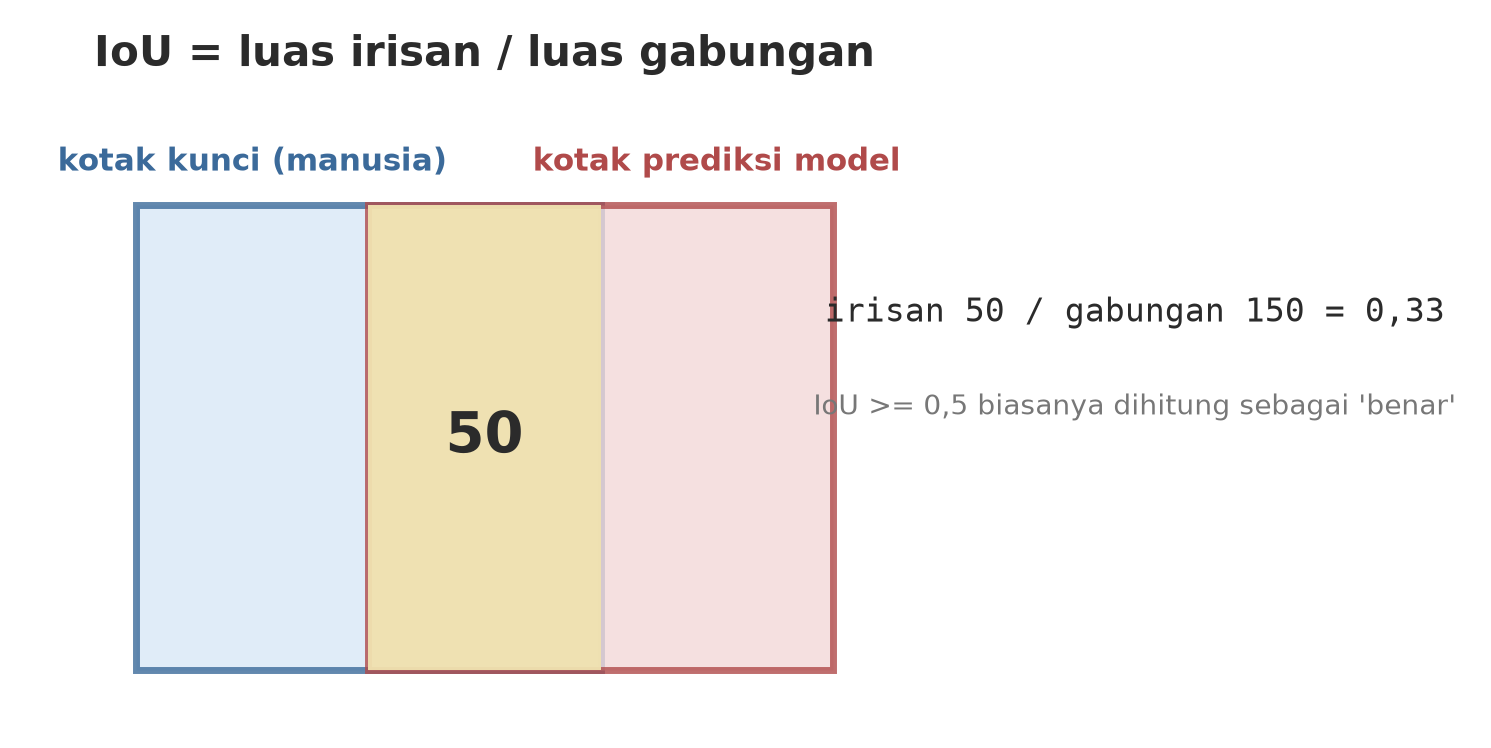
Sebelum melatih apa pun, kita perlu cara menilai kotak. IoU (Intersection over Union) adalah luas irisan dibagi luas gabungan dua kotak: 1 berarti pas, 0 berarti terpisah.
02_iou_map.py
# Bab 56 - Metrik deteksi: IoU, pencocokan, presisi-recall, dan AP dihitung dengan tangan


def iou(a, b):
    """a dan b = (x1, y1, x2, y2). IoU = luas irisan / luas gabungan."""
    ix1, iy1 = max(a[0], b[0]), max(a[1], b[1])
    ix2, iy2 = min(a[2], b[2]), min(a[3], b[3])
    irisan = max(0, ix2 - ix1) * max(0, iy2 - iy1)
    luas_a = (a[2] - a[0]) * (a[3] - a[1])
    luas_b = (b[2] - b[0]) * (b[3] - b[1])
    return irisan / (luas_a + luas_b - irisan)


# Dua kotak 10 x 10: tumpang tindih 5 x 10 = 50; gabungan = 100 + 100 - 50 = 150; IoU = 1/3
print("IoU dua kotak setengah tumpang tindih:", round(iou((0, 0, 10, 10), (5, 0, 15, 10)), 3))
print("IoU kotak identik                     :", iou((0, 0, 10, 10), (0, 0, 10, 10)))
print("IoU kotak terpisah                    :", iou((0, 0, 10, 10), (20, 20, 30, 30)))

# Kebenaran lapangan: 4 pohon. Prediksi model: 5 kotak dengan skor keyakinan.
benar = [(0, 0, 10, 10), (20, 0, 30, 10), (40, 0, 50, 10), (60, 0, 70, 10)]
prediksi = [  # (kotak, skor)
    ((1, 1, 11, 11), 0.95),      # cocok pohon 1
    ((21, 0, 31, 10), 0.90),     # cocok pohon 2
    ((80, 0, 90, 10), 0.80),     # salah: tidak ada pohon di sana
    ((41, 1, 51, 11), 0.70),     # cocok pohon 3
    ((62, 2, 72, 12), 0.40),     # cocok pohon 4
]
prediksi.sort(key=lambda p: -p[1])                           # urutkan dari skor tertinggi
terpakai, tp_fp = set(), []
for kotak, skor in prediksi:
    terbaik, nilai = None, 0.0
    for i, g in enumerate(benar):
        v = iou(kotak, g)
        if i not in terpakai and v > nilai:
            terbaik, nilai = i, v
    if terbaik is not None and nilai >= 0.5:                 # ambang IoU 0,5
        terpakai.add(terbaik)
        tp_fp.append(1)
    else:
        tp_fp.append(0)

print("\nUrutan skor -> benar(1)/salah(0):", tp_fp)
tp = fp = 0
titik = []
for hasil in tp_fp:
    tp, fp = tp + hasil, fp + (1 - hasil)
    titik.append((tp / (tp + fp), tp / len(benar)))          # (presisi, recall)
for (p, r) in titik:
    print(f"  presisi = {p:.2f}   recall = {r:.2f}")

# AP = luas di bawah kurva presisi-recall (versi "semua titik"): presisi dibuat tidak naik, lalu dijumlah
presisi = [p for p, _ in titik]
recall = [r for _, r in titik]
for i in range(len(presisi) - 2, -1, -1):
    presisi[i] = max(presisi[i], presisi[i + 1])
ap, r_lalu = 0.0, 0.0
for p, r in zip(presisi, recall):
    ap += (r - r_lalu) * p
    r_lalu = r
print("AP pada IoU 0,5 (AP50) untuk kelas ini:", round(ap, 3))
IoU dua kotak setengah tumpang tindih: 0.333
IoU kotak identik : 1.0
IoU kotak terpisah : 0.0
Urutan skor -> benar(1)/salah(0): [1, 1, 0, 1, 0]
presisi = 1.00 recall = 0.25
presisi = 1.00 recall = 0.50
presisi = 0.67 recall = 0.50
presisi = 0.75 recall = 0.75
presisi = 0.60 recall = 0.75
AP pada IoU 0,5 (AP50) untuk kelas ini: 0.688Telusuri hasilnya:
- IoU kotak setengah tumpang tindih = 0,333, persis seperti gambar. Kotak identik = 1; terpisah = 0.
- Ada 4 pohon sebenarnya dan 5 prediksi. Prediksi diurutkan dari skor tertinggi. Satu prediksi disebut benar (true positive) bila IoU-nya dengan pohon yang belum terambil minimal 0,5. Urutannya: benar, benar, salah (kotak di tempat kosong), benar, salah (skor 0,40; IoU dengan pohon ke-4 di bawah 0,5 karena kotaknya bergeser).
- Tiap baris “presisi/recall” adalah nilai setelah menerima prediksi sampai skor itu. Presisi = dari yang dikatakan pohon, berapa yang benar. Recall = dari semua pohon, berapa yang tertangkap.
- AP (average precision) adalah luas di bawah kurva presisi-recall: 0,688 untuk kelas ini. Untuk banyak kelas, rata-rata AP semua kelas disebut mAP.
mAP50memakai ambang IoU 0,5;mAP50-95merata-ratakan ambang 0,5 sampai 0,95 (lebih ketat, menuntut kotak yang benar-benar pas). Pustaka berbeda memakai cara interpolasi yang sedikit berbeda, jadi angka AP antar-pustaka bisa selisih tipis.
Anotasi dan augmentasi
Anotasi adalah pekerjaan manusia menggambar kotak dan memberi nama kelas pada foto latih. Hasilnya disimpan sesuai format yang diminta pustaka. Format YOLO (dari dokumentasi Ultralytics, dibaca 2026-10-10): satu berkas .txt per citra, satu baris per objek, kelas x_pusat y_pusat lebar tinggi, semuanya dinormalkan (dibagi ukuran citra, jadi 0 sampai 1) dan kelas dimulai dari 0. Berkas data.yaml menunjuk folder latih dan validasi serta nama kelas. Nama alat anotasi di internet banyak (mis. CVAT dan Label Studio); buku ini tidak menjalankan atau membandingkannya, jadi periksa dokumentasinya sebelum memilih.
04_buat_dataset.py
# Bab 56 - Dataset deteksi format YOLO: citra + berkas label per citra + data.yaml (semua dibuat skrip)
from buat_dataset import buat_dataset

data_yaml = buat_dataset()
akar = data_yaml.parent
for bagian in ("train", "val"):
    gambar = sorted((akar / "images" / bagian).glob("*.png"))
    label = sorted((akar / "labels" / bagian).glob("*.txt"))
    objek = sum(len(b.read_text().splitlines()) for b in label)
    print(f"{bagian:5s}: {len(gambar)} citra, {len(label)} berkas label, {objek} tajuk")

print("\nIsi data.yaml (jalur dipersingkat):")
for baris in data_yaml.read_text().splitlines():
    print("  " + (baris if not baris.startswith("path") else "path: .../dataset_tajuk"))

print("\nLima baris pertama label citra val/0000.txt (kelas pusat_x pusat_y lebar tinggi, semua 0..1):")
for baris in (akar / "labels" / "val" / "0000.txt").read_text().splitlines()[:5]:
    print(" ", baris)
train: 200 citra, 200 berkas label, 2716 tajuk
val : 40 citra, 40 berkas label, 540 tajuk
Isi data.yaml (jalur dipersingkat):
path: .../dataset_tajuk
train: images/train
val: images/val
names:
0: tajuk
Lima baris pertama label citra val/0000.txt (kelas pusat_x pusat_y lebar tinggi, semua 0..1):
0 0.090625 0.462500 0.137500 0.137500
0 0.103125 0.837500 0.062500 0.062500
0 0.396875 0.615625 0.068750 0.068750
0 0.837500 0.156250 0.081250 0.081250
0 0.256250 0.540625 0.100000 0.100000Skrip membuat 200 citra latih (2.716 tajuk) dan 40 citra validasi (540 tajuk). Baris label pertama 0 0.090625 0.462500 0.137500 0.137500 berarti kelas 0 (tajuk), pusat di 9% lebar dan 46% tinggi, kotak setinggi dan selebar 13,75% citra (44 px dari 320).
Augmentasi memperbanyak data dengan memodifikasi citra yang ada: dibalik, diputar, diubah kecerahannya. Jebakannya: kotaknya harus ikut berubah, kalau tidak, label menunjuk tempat yang salah.
03_augmentasi.py
# Bab 56 - Augmentasi: memperbanyak data dengan membalik dan mengubah kecerahan; kotak ikut dibalik
import numpy as np

from buat_dataset import buat_citra

rng = np.random.default_rng(1)
citra, kotak = buat_citra(rng)
tinggi, lebar = citra.shape[:2]


def balik_horizontal(citra, kotak):
    lebar = citra.shape[1]
    baru = [(lebar - x2, y1, lebar - x1, y2) for x1, y1, x2, y2 in kotak]    # x dicerminkan; y tetap
    return citra[:, ::-1].copy(), baru


def ubah_kecerahan(citra, faktor):
    return np.clip(citra.astype(np.float32) * faktor, 0, 255).astype(np.uint8)


citra2, kotak2 = balik_horizontal(citra, kotak)
print("Kotak pertama asli  :", kotak[0])
print("Kotak pertama dibalik:", kotak2[0])

# Pemeriksaan: pusat kotak asli (cx, cy) harus kini berada di (lebar - cx, cy), dan di sana pikselnya sama
x1, y1, x2, y2 = kotak[0]
cx, cy = (x1 + x2) // 2, (y1 + y2) // 2
print("Piksel pusat asli   :", citra[cy, cx].tolist())
print("Piksel pusat dibalik:", citra2[cy, lebar - 1 - cx].tolist())
print("Sama persis:", bool((citra[cy, cx] == citra2[cy, lebar - 1 - cx]).all()))

terang = ubah_kecerahan(citra, 1.3)
print("Rata-rata kecerahan asli -> lebih terang:", round(float(citra.mean()), 1), "->", round(float(terang.mean()), 1))
print("Jumlah kotak tidak berubah:", len(kotak) == len(kotak2))
Kotak pertama asli : (141, 51, 173, 83)
Kotak pertama dibalik: (147, 51, 179, 83)
Piksel pusat asli : [30, 126, 40]
Piksel pusat dibalik: [30, 126, 40]
Sama persis: True
Rata-rata kecerahan asli -> lebih terang: 114.2 -> 148.0
Jumlah kotak tidak berubah: TrueSetelah dibalik, kotak pertama bergeser dari (141, 51, 173, 83) ke (147, 51, 179, 83) (x dicerminkan, y tetap). Pemeriksaan membuktikannya: piksel di pusat kotak lama sama persis dengan piksel di pusat kotak baru pada citra terbalik. Kecerahan 1,3x menaikkan rata-rata dari 114,2 ke 148,0 tanpa mengubah kotak. YOLO melakukan augmentasi sendiri saat melatih; contoh ini untuk memahami prinsipnya.
Keluarga detektor: R-CNN, SSD, dan YOLO
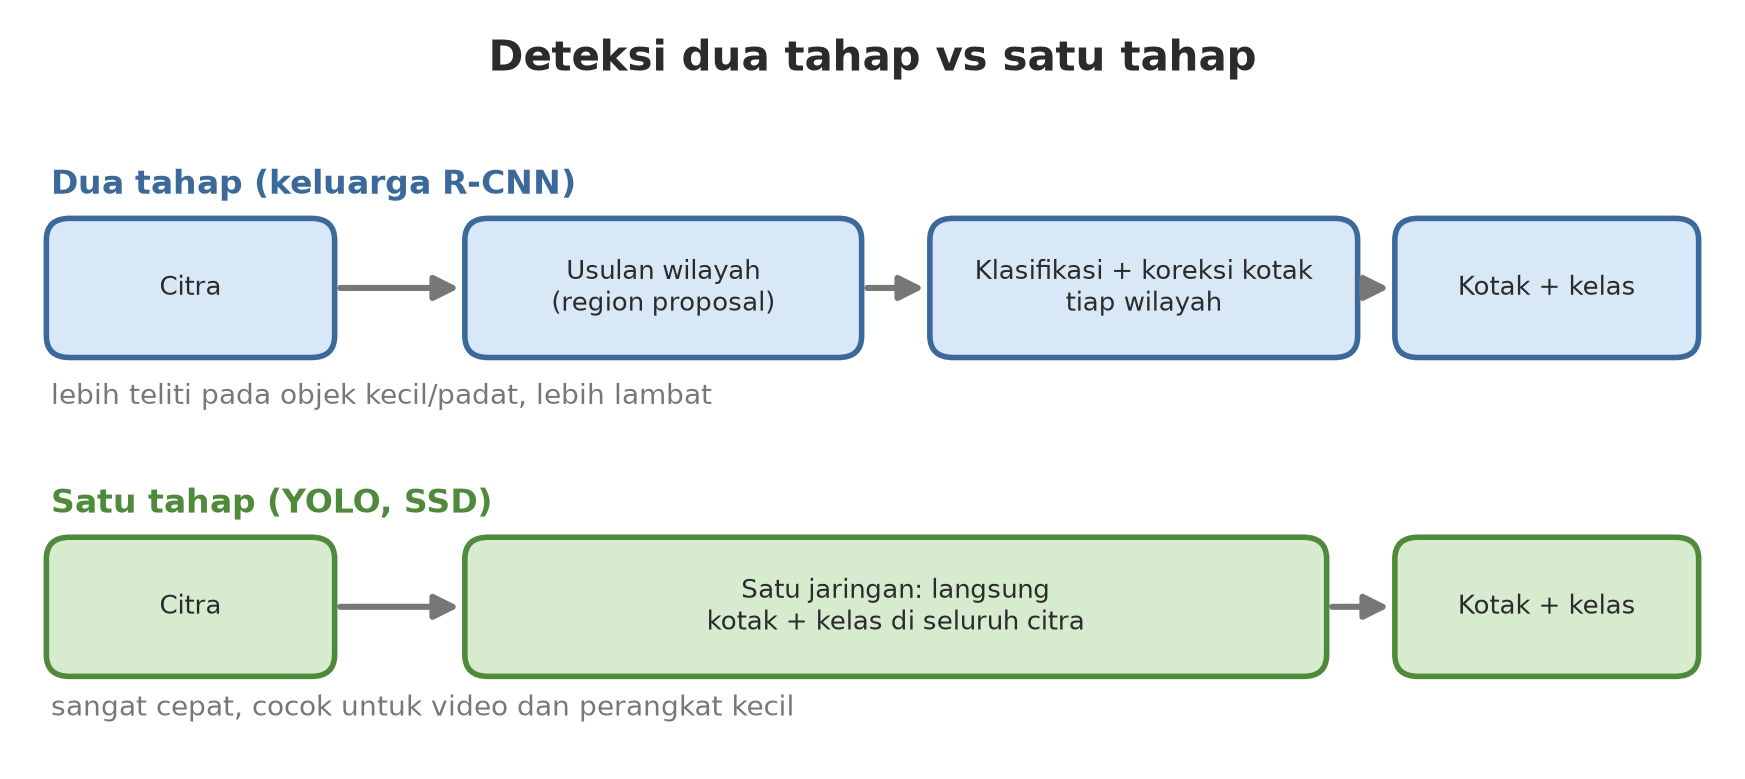
- Keluarga R-CNN (R-CNN, Fast R-CNN, Faster R-CNN, Mask R-CNN): detektor dua tahap. Tahap satu mengusulkan wilayah yang mungkin berisi objek (region proposal; pada Faster R-CNN dikerjakan jaringan sendiri), tahap dua mengklasifikasi tiap wilayah dan memperhalus kotaknya. Mask R-CNN menambah cabang yang menggambar topeng per objek. Cenderung teliti, lebih lambat.
- SSD dan YOLO: detektor satu tahap. Satu jaringan langsung menebak kotak dan kelas untuk seluruh citra dalam sekali jalan. Sangat cepat, cocok untuk video dan perangkat kecil.
- Versi YOLO terus bertambah. Dokumentasi Ultralytics (dibaca 2026-10-10) menyebut YOLO26 sebagai versi terbaru dan direkomendasikan untuk proyek baru, dengan YOLO11 sebagai alternatif mapan. Pustaka
ultralyticsberlisensi AGPL-3.0 (dari metadata paket yang terpasang): untuk produk tertutup periksa syarat lisensinya.
Kita lihat antarmuka tiga detektor di torchvision dengan bobot acak (tanpa unduhan):
07_rcnn_ssd_torchvision.py
# Bab 56 - Tiga keluarga detektor di torchvision (bobot acak, tanpa unduhan): bentuk keluaran dan ukuran
import torch
from torchvision.models.detection import (fasterrcnn_mobilenet_v3_large_320_fpn, maskrcnn_resnet50_fpn,
                                          ssdlite320_mobilenet_v3_large)

torch.manual_seed(0)
semua = {
    "Faster R-CNN (dua tahap, MobileNetV3)": fasterrcnn_mobilenet_v3_large_320_fpn(
        weights=None, weights_backbone=None, num_classes=2),
    "Mask R-CNN (dua tahap + topeng, ResNet-50)": maskrcnn_resnet50_fpn(
        weights=None, weights_backbone=None, num_classes=2),
    "SSDlite (satu tahap, MobileNetV3)": ssdlite320_mobilenet_v3_large(
        weights=None, weights_backbone=None, num_classes=2),
}
citra = [torch.rand(3, 320, 320)]                    # citra acak: hasilnya tentu tidak bermakna
for nama, model in semua.items():
    jumlah = sum(p.numel() for p in model.parameters())
    model.eval()
    with torch.no_grad():
        keluar = model(citra)[0]
    print(f"{nama}")
    print(f"   parameter: {jumlah / 1e6:.1f} juta | kunci keluaran: {sorted(keluar.keys())}")
print("\nKarena bobotnya acak, kotak yang keluar tidak bermakna; ini hanya memperlihatkan bentuk antarmukanya.")
Faster R-CNN (dua tahap, MobileNetV3)
parameter: 19.0 juta | kunci keluaran: ['boxes', 'labels', 'scores']
Mask R-CNN (dua tahap + topeng, ResNet-50)
parameter: 44.0 juta | kunci keluaran: ['boxes', 'labels', 'masks', 'scores']
SSDlite (satu tahap, MobileNetV3)
parameter: 2.2 juta | kunci keluaran: ['boxes', 'labels', 'scores']
Karena bobotnya acak, kotak yang keluar tidak bermakna; ini hanya memperlihatkan bentuk antarmukanya.Ketiganya mengembalikan kamus boxes, labels, scores (Mask R-CNN menambah masks). Ukurannya sangat beda: SSDlite 2,2 juta parameter, Faster R-CNN versi MobileNet 19,0 juta, Mask R-CNN ResNet-50 44,0 juta. Karena bobotnya acak, hasil deteksinya tidak bermakna; skrip ini hanya memperlihatkan bentuknya. Kami tidak melatih atau membandingkan akurasi ketiganya di data tiruan ini, jadi buku ini tidak mengklaim siapa yang lebih akurat. Pedoman umum: mulai dari YOLO (cepat, mudah dilatih); coba dua tahap bila objek sangat kecil dan padat.
Melatih YOLO di GPU
Kita memakai bobot YOLO26 nano pra-latih (yolo26n.pt, 5,3 MB, diunduh otomatis dari rilis resmi Ultralytics saat skrip dijalankan pertama kali). Memulai dari bobot pra-latih (transfer learning) hampir selalu lebih baik daripada mulai dari nol, karena model sudah paham tepi dan bentuk.
05_latih_yolo.py
# Bab 56 - Melatih YOLO (versi nano) di GPU untuk mendeteksi tajuk pohon pada citra tiruan
import logging
import os
import shutil
from pathlib import Path

import torch
from ultralytics import YOLO
from ultralytics.utils import LOGGER

from buat_dataset import TMP, buat_dataset

LOGGER.setLevel(logging.ERROR)                                # log pelatihan sangat panjang; kita hanya tampilkan ringkasan
data_yaml = buat_dataset()                                    # 200 citra latih + 40 citra validasi, dibuat skrip
bobot = TMP / "bobot"
bobot.mkdir(parents=True, exist_ok=True)
os.chdir(bobot)                                               # bobot pra-latih (5 MB) diunduh ke sini bila belum ada
model = YOLO("yolo26n.pt")                                    # model nano pra-latih (transfer learning)

hasil_dir = TMP / "runs"
shutil.rmtree(hasil_dir, ignore_errors=True)
hasil = model.train(
    data=str(data_yaml), epochs=25, imgsz=320, batch=16,
    device=0 if torch.cuda.is_available() else "cpu",
    workers=0, seed=0, deterministic=True,
    project=str(hasil_dir), name="tajuk", exist_ok=True,
    plots=False, verbose=False, amp=False,
)
metrik = hasil.results_dict
print("Hasil validasi (data yang tidak dipakai melatih):")
print("  presisi  :", round(metrik["metrics/precision(B)"], 2))
print("  recall   :", round(metrik["metrics/recall(B)"], 2))
print("  mAP50    :", round(metrik["metrics/mAP50(B)"], 2))
print("  mAP50-95 :", round(metrik["metrics/mAP50-95(B)"], 2))
print("Bobot terbaik tersimpan:", Path(hasil.save_dir, "weights", "best.pt").exists())
Hasil validasi (data yang tidak dipakai melatih):
presisi : 0.99
recall : 0.97
mAP50 : 0.98
mAP50-95 : 0.93
Bobot terbaik tersimpan: True- Pelatihan memakai GPU (
device=0), 25 epoch, batch 16, citra 320 px. Di komputer penulis ini memakan sekitar dua sampai tiga menit. - Presisi 0,99 dan recall 0,97 diukur pada 40 citra validasi yang tidak dipakai melatih. mAP50 = 0,98; mAP50-95 = 0,93.
- Skor setinggi ini wajar untuk lingkaran hijau di tanah polos. Pada foto drone sungguhan, jangan kaget bila mAP50 hanya 0,5 sampai 0,8.
amp=Falsemematikan mixed precision. Kami mematikannya supaya pelatihan sederhana dan hasilnya mudah diulang; manfaat mixed precision sudah dibahas di Bab 55.seed=0dandeterministic=Truemembuat dua kali jalan di komputer penulis menghasilkan angka sama; di komputer Anda angka bisa sedikit beda.
Inferensi: memakai model pada citra baru
Inferensi adalah memakai model yang sudah dilatih. Citra uji dibuat dengan benih yang berbeda dari data latih dan validasi.
06_inferensi_yolo.py
# Bab 56 - Inferensi: memakai model YOLO yang sudah dilatih pada citra baru, lalu mencocokkan dengan kunci jawaban
import logging

import numpy as np
from ultralytics import YOLO
from ultralytics.utils import LOGGER

from buat_dataset import TMP, buat_citra

LOGGER.setLevel(logging.ERROR)
model = YOLO(TMP / "runs" / "tajuk" / "weights" / "best.pt")

# Citra BARU (benih berbeda dari data latih dan validasi)
rng = np.random.default_rng(2025)
citra, kunci = buat_citra(rng)
hasil = model.predict(citra, conf=0.25, imgsz=320, device=0, verbose=False)[0]
kotak = hasil.boxes.xyxy.cpu().numpy()
skor = hasil.boxes.conf.cpu().numpy()
print("Jumlah tajuk sebenarnya (kunci):", len(kunci))
print("Jumlah tajuk terdeteksi        :", len(kotak))
print("Skor tertinggi dan terendah    :", round(float(skor.max()), 2), "dan", round(float(skor.min()), 2))


def iou(a, b):
    ix = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    iy = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    irisan = ix * iy
    return irisan / ((a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - irisan)


cocok = sum(1 for g in kunci if max(iou(g, k) for k in kotak) >= 0.5)
print("Tajuk sebenarnya yang tertangkap (IoU >= 0,5):", cocok, "dari", len(kunci))
print("Kolom hasil .boxes:", [n for n in ("xyxy", "conf", "cls") if hasattr(hasil.boxes, n)])
Jumlah tajuk sebenarnya (kunci): 18
Jumlah tajuk terdeteksi : 20
Skor tertinggi dan terendah : 0.97 dan 0.32
Tajuk sebenarnya yang tertangkap (IoU >= 0,5): 17 dari 18
Kolom hasil .boxes: ['xyxy', 'conf', 'cls']Ada 18 tajuk sebenarnya; model mendeteksi 20 kotak (skor 0,97 sampai 0,32) dan menangkap 17 dari 18 tajuk dengan IoU >= 0,5. Jadi ada kotak berlebih (conf=0.25 agak longgar) dan satu pohon terlewat, kemungkinan karena tajuk yang menumpuk. Menaikkan conf mengurangi kotak berlebih tetapi menambah pohon terlewat: kompromi presisi vs recall.
Segmentasi: U-Net
U-Net adalah jaringan segmentasi berbentuk huruf U: jalur turun mengecilkan citra untuk menangkap konteks, jalur naik membesarkannya kembali, dan sambungan lompat (skip connection) membawa detail halus dari jalur turun ke jalur naik. Keluarannya satu angka per piksel. Skrip ini membangun U-Net mini sendiri dan melatihnya di GPU pada citra 128 x 128 untuk menandai piksel tajuk.
08_unet_segmentasi.py
# Bab 56 - Segmentasi dengan U-Net mini: setiap PIKSEL diberi label (tajuk atau bukan), di GPU
import os
os.environ["CUBLAS_WORKSPACE_CONFIG"] = ":4096:8"
import numpy as np
import torch
from torch import nn

from buat_dataset import buat_citra

torch.manual_seed(0)
torch.use_deterministic_algorithms(True)
perangkat = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# Data: citra tiruan 128 x 128 dan topeng piksel (1 = di dalam lingkaran tajuk). Topeng dibuat dari kotak ke lingkaran.
rng = np.random.default_rng(5)
citra, topeng = [], []
yy, xx = np.mgrid[0:128, 0:128]
for _ in range(160):
    c, kotak = buat_citra(rng, ukuran=128, maks_pohon=8)
    t = np.zeros((128, 128), dtype=np.float32)
    for x1, y1, x2, y2 in kotak:
        t[((xx - (x1 + x2) / 2) ** 2 + (yy - (y1 + y2) / 2) ** 2) <= ((x2 - x1) / 2) ** 2] = 1
    citra.append(c[..., ::-1].transpose(2, 0, 1) / 255.0)
    topeng.append(t[None])
X = torch.tensor(np.stack(citra), dtype=torch.float32, device=perangkat)
Y = torch.tensor(np.stack(topeng), dtype=torch.float32, device=perangkat)


def blok(masuk, keluar):
    return nn.Sequential(nn.Conv2d(masuk, keluar, 3, padding=1), nn.ReLU(), nn.Conv2d(keluar, keluar, 3, padding=1), nn.ReLU())


class UNetMini(nn.Module):
    """Jalur turun (mengecilkan, menangkap konteks), jalur naik (membesarkan), dan sambungan lompat (skip)."""
    def __init__(self):
        super().__init__()
        self.t1, self.t2, self.dasar = blok(3, 16), blok(16, 32), blok(32, 64)
        self.turun = nn.MaxPool2d(2)
        self.naik2, self.n2 = nn.ConvTranspose2d(64, 32, 2, stride=2), blok(64, 32)
        self.naik1, self.n1 = nn.ConvTranspose2d(32, 16, 2, stride=2), blok(32, 16)
        self.keluar = nn.Conv2d(16, 1, 1)

    def forward(self, x):
        a = self.t1(x)
        b = self.t2(self.turun(a))
        d = self.dasar(self.turun(b))
        b = self.n2(torch.cat([self.naik2(d), b], dim=1))      # sambungan lompat: gabungkan detail halus
        a = self.n1(torch.cat([self.naik1(b), a], dim=1))
        return self.keluar(a)


model = UNetMini().to(perangkat)
print("Parameter U-Net mini:", sum(p.numel() for p in model.parameters()))
optimiser = torch.optim.Adam(model.parameters(), lr=0.003)
latih, uji = slice(0, 128), slice(128, 160)

for epoch in range(1, 31):
    urutan = torch.randperm(128, device=perangkat)
    for awal in range(0, 128, 16):
        idx = urutan[awal:awal + 16]
        optimiser.zero_grad()
        loss = nn.functional.binary_cross_entropy_with_logits(model(X[latih][idx]), Y[latih][idx])
        loss.backward()
        optimiser.step()
    if epoch in (1, 10, 30):
        print(f"epoch {epoch:2d}: loss = {loss.item():.3f}")

model.eval()
with torch.no_grad():
    tebak = (torch.sigmoid(model(X[uji])) > 0.5).float()
irisan = (tebak * Y[uji]).sum().item()
gabungan = ((tebak + Y[uji]) > 0).float().sum().item()
print("IoU piksel pada data uji (irisan / gabungan):", round(irisan / gabungan, 2))
Parameter U-Net mini: 117041
epoch 1: loss = 0.624
epoch 10: loss = 0.022
epoch 30: loss = 0.009
IoU piksel pada data uji (irisan / gabungan): 0.99Loss turun dari 0,624 ke 0,009. Pada 32 citra uji, IoU piksel (irisan/gabungan topeng) 0,99. Mudah karena lingkaran jelas; pada citra nyata U-Net biasanya dilatih dengan ribuan topeng yang digambar manual, yang jauh lebih mahal daripada kotak.
Vision Transformer (konsep)
Vision Transformer (ViT) memperlakukan citra seperti kalimat: citra dipotong menjadi potongan kecil (patch), tiap patch menjadi satu “kata”, lalu arsitektur transformer (Bab 61) yang dipakai model bahasa memproses urutan itu.
09_vit_potongan.py
# Bab 56 - Vision Transformer (konsep): citra dipotong menjadi "kata" berupa patch 16 x 16
import torch

citra = torch.arange(3 * 224 * 224, dtype=torch.float32).reshape(1, 3, 224, 224)   # citra 224 x 224, 3 saluran
ukuran_patch = 16
# unfold memotong tinggi dan lebar menjadi petak 16 x 16 yang tidak tumpang tindih
potongan = citra.unfold(2, ukuran_patch, ukuran_patch).unfold(3, ukuran_patch, ukuran_patch)
print("Bentuk setelah dipotong:", tuple(potongan.shape), "= (batch, saluran, 14 baris, 14 kolom, 16, 16)")
urutan = potongan.permute(0, 2, 3, 1, 4, 5).reshape(1, 14 * 14, 3 * ukuran_patch * ukuran_patch)
print("Urutan 'kata':", urutan.shape[1], "patch, masing-masing vektor", urutan.shape[2], "angka")
print("Setiap patch lalu diproyeksikan ke vektor embedding dan diberi nomor posisi, seperti kata dalam kalimat.")

# Biaya atensi: setiap patch memperhatikan semua patch lain -> jumlah pasangan tumbuh kuadrat
for n in (196, 784):
    print(f"{n} patch -> {n * n:,} pasangan atensi per lapisan")
Bentuk setelah dipotong: (1, 3, 14, 14, 16, 16) = (batch, saluran, 14 baris, 14 kolom, 16, 16)
Urutan 'kata': 196 patch, masing-masing vektor 768 angka
Setiap patch lalu diproyeksikan ke vektor embedding dan diberi nomor posisi, seperti kata dalam kalimat.
196 patch -> 38,416 pasangan atensi per lapisan
784 patch -> 614,656 pasangan atensi per lapisanCitra 224 x 224 menjadi 196 patch, masing-masing 768 angka (3 saluran x 16 x 16). Karena tiap patch memperhatikan semua patch lain, jumlah pasangan tumbuh kuadrat: 196 patch menghasilkan 38.416 pasangan, 784 patch menghasilkan 614.656. Itu sebabnya citra beresolusi tinggi mahal untuk ViT. Kami tidak melatih ViT di buku ini; torchvision menyediakan kelas VisionTransformer (dari daftar model dokumentasi torchvision, dibaca 2026-10-10).
Ekspor ONNX
ONNX adalah format berkas bersama untuk model, agar model dilatih di satu pustaka dan dijalankan di tempat lain (mis. di peranti tepi). Dokumentasi Ultralytics (dibaca 2026-10-10) menyebut ekspor lewat model.export(format="onnx"), dan bahwa paket tambahan dipasang otomatis bila belum ada; skrip kita mematikannya dengan YOLO_AUTOINSTALL=False dan paket onnx dipasang sendiri.
11_ekspor_onnx.py
# Bab 56 - Ekspor model ke ONNX (format pertukaran) lalu memeriksa berkasnya
import logging
import os
os.environ["YOLO_AUTOINSTALL"] = "False"                  # jangan memasang paket diam-diam saat ekspor

import onnx
from ultralytics import YOLO
from ultralytics.utils import LOGGER

from buat_dataset import TMP

LOGGER.setLevel(logging.ERROR)
model = YOLO(TMP / "runs" / "tajuk" / "weights" / "best.pt")
berkas = model.export(format="onnx", imgsz=320, simplify=False, verbose=False)
print("Berkas ONNX ada:", os.path.exists(berkas), "| ukuran (MB, dibulatkan):", round(os.path.getsize(berkas) / 1e6))

graf = onnx.load(berkas)
onnx.checker.check_model(graf)                             # melempar error bila struktur rusak
masuk = graf.graph.input[0]
bentuk = [d.dim_value for d in masuk.type.tensor_type.shape.dim]
print("Pemeriksaan struktur ONNX: lolos")
print("Masukan:", masuk.name, bentuk)
print("Jumlah simpul (operasi) di graf:", len(graf.graph.node))
Berkas ONNX ada: True | ukuran (MB, dibulatkan): 10
Pemeriksaan struktur ONNX: lolos
Masukan: images [1, 3, 320, 320]
Jumlah simpul (operasi) di graf: 405Berkas ONNX berukuran sekitar 10 MB, strukturnya lolos onnx.checker, dan masukannya berbentuk [1, 3, 320, 320]. Menjalankan hasil ekspor dengan runtime ONNX tidak dicoba di buku ini.
Proyek Bersambung A3: deteksi pohon dari citra drone tiruan
Foto drone sungguhan bisa berukuran puluhan ribu piksel; model kita hanya mengenal ubin 320 x 320. Alurnya: potong menjadi ubin saling tumpang tindih, deteksi per ubin, geser kotak ke koordinat mozaik, buang kotak ganda dengan NMS (non-maximum suppression), lalu ubah piksel menjadi koordinat peta.
10_proyek_deteksi_pohon.py
# Bab 56 - Proyek A3: deteksi pohon pada "foto drone" besar: potong per ubin, gabungkan, beri koordinat peta
import logging

import geopandas as gpd
import numpy as np
import torch
from shapely.geometry import box
from torchvision.ops import nms
from ultralytics import YOLO
from ultralytics.utils import LOGGER

from buat_dataset import TMP, buat_citra

LOGGER.setLevel(logging.ERROR)
model = YOLO(TMP / "runs" / "tajuk" / "weights" / "best.pt")

# 1) Orthomosaik tiruan 960 x 960 piksel berisi puluhan tajuk (benih khusus, bukan data latih)
rng = np.random.default_rng(772)
mozaik, kunci = buat_citra(rng, ukuran=960, maks_pohon=200)
print("Tajuk sebenarnya di mozaik:", len(kunci))

# 2) Model dilatih pada citra 320 x 320, jadi mozaik dipotong ubin 320 x 320 yang saling tumpang tindih 64 piksel
ubin, langkah = 320, 256
kotak_semua, skor_semua = [], []
posisi = list(range(0, 960 - ubin, langkah)) + [960 - ubin]      # ubin terakhir dirapatkan ke tepi agar tak ada strip terlewat
print("Posisi awal ubin:", posisi, "-> jumlah ubin:", len(posisi) ** 2)
for y0 in posisi:
    for x0 in posisi:
        potong = np.ascontiguousarray(mozaik[y0:y0 + ubin, x0:x0 + ubin])
        r = model.predict(potong, conf=0.25, imgsz=320, device=0, verbose=False)[0]
        k = r.boxes.xyxy.cpu().numpy() + np.array([x0, y0, x0, y0])         # ke koordinat mozaik
        kotak_semua.append(k)
        skor_semua.append(r.boxes.conf.cpu().numpy())
kotak = np.concatenate(kotak_semua)
skor = np.concatenate(skor_semua)
print("Deteksi mentah (sebelum digabung):", len(kotak))

# 3) NMS: buang kotak ganda untuk pohon yang sama di ubin yang tumpang tindih
simpan = nms(torch.tensor(kotak, dtype=torch.float32), torch.tensor(skor, dtype=torch.float32), iou_threshold=0.5).numpy()
kotak = kotak[simpan]
print("Setelah NMS:", len(kotak))


def iou(a, b):
    ix = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    iy = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    irisan = ix * iy
    return irisan / ((a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - irisan)


tp = sum(1 for k in kotak if max(iou(k, g) for g in kunci) >= 0.5)
recall = sum(1 for g in kunci if max(iou(g, k) for k in kotak) >= 0.5)
print(f"Presisi = {tp / len(kotak):.2f}   recall = {recall / len(kunci):.2f}")

# 4) Dari piksel ke peta: 1 piksel = 0,25 m (angka contoh), sudut kiri atas mozaik di koordinat UTM fiktif
ukuran_piksel, asal_x, asal_y = 0.25, 500_000.0, 9_200_000.0
poligon = [box(asal_x + x1 * ukuran_piksel, asal_y - y2 * ukuran_piksel,
               asal_x + x2 * ukuran_piksel, asal_y - y1 * ukuran_piksel) for x1, y1, x2, y2 in kotak]
gdf = gpd.GeoDataFrame({"id": range(len(poligon))}, geometry=poligon, crs="EPSG:32748")
gdf["luas_tajuk_m2"] = gdf.area.round(1)
luas_ha = (960 * ukuran_piksel) ** 2 / 10_000
print(f"\nLuas mozaik: {luas_ha:.1f} ha | pohon terdeteksi per ha: {len(gdf) / luas_ha:.0f}")
print("Luas tajuk rata-rata (m2):", round(gdf["luas_tajuk_m2"].mean(), 1))
gdf.to_file(TMP / "tajuk_terdeteksi.geojson", driver="GeoJSON")
print("GeoJSON ditulis; jumlah fitur:", len(gpd.read_file(TMP / "tajuk_terdeteksi.geojson")))
Tajuk sebenarnya di mozaik: 119
Posisi awal ubin: [0, 256, 512, 640] -> jumlah ubin: 16
Deteksi mentah (sebelum digabung): 245
Setelah NMS: 137
Presisi = 0.87 recall = 0.99
Luas mozaik: 5.8 ha | pohon terdeteksi per ha: 24
Luas tajuk rata-rata (m2): 73.5
GeoJSON ditulis; jumlah fitur: 137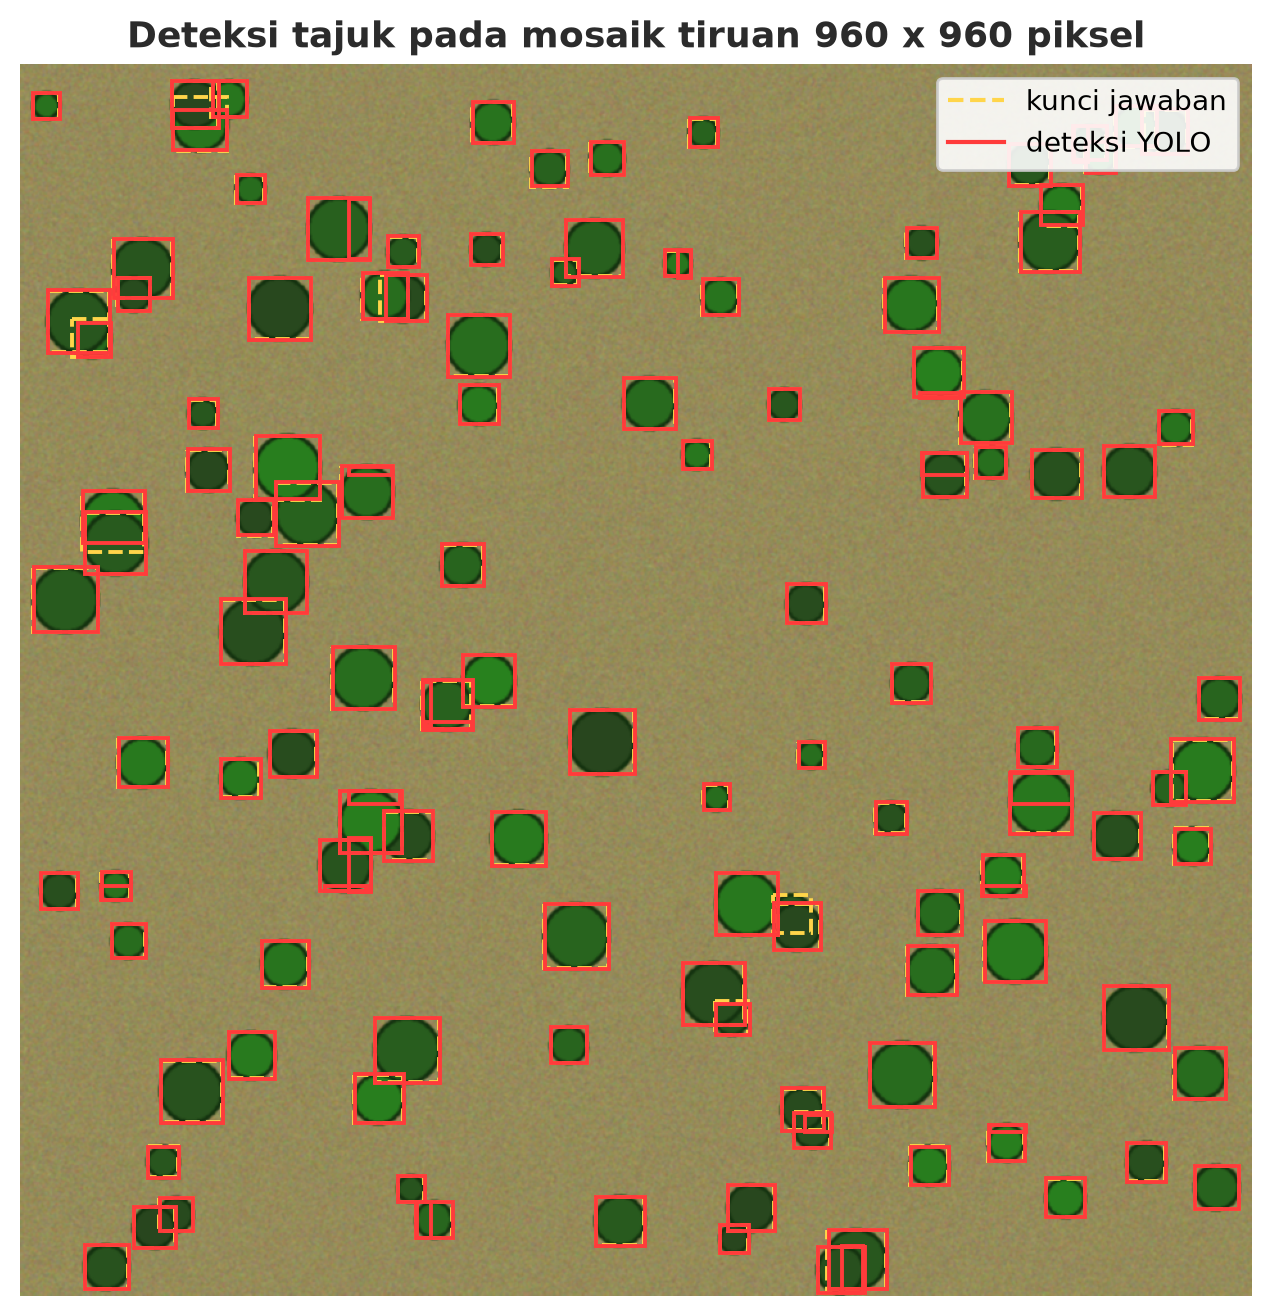
- Kunci: 119 tajuk. Deteksi mentah 245 kotak, setelah NMS 137. Recall 0,99 (hampir semua tajuk tertangkap), tetapi presisi 0,87 dan jumlah 137 melebihi 119: kemungkinan penyebabnya tajuk yang terpotong di tepi ubin dikenali sebagai dua kotak parsial yang IoU-nya terlalu kecil untuk dibuang NMS (terlihat pada gambar; penyebab pastinya tidak diselidiki lebih jauh). Menghitung pohon dengan cara ini akan melebih-lebihkan sekitar 15%. Perbaikan umum: buang kotak yang menempel tepi ubin, atau gabungkan kotak dengan aturan lain.
- Skrip
posisimemastikan ubin terakhir dirapatkan ke tepi mozaik. Versi pertama kami lupa itu dan strip 128 piksel di kanan dan bawah tidak pernah diperiksa: recall turun ke 0,74 tanpa pesan error. Selalu periksa bahwa seluruh citra tercakup. - Piksel menjadi peta: dengan 1 piksel = 0,25 m (angka contoh) mozaik seluas 5,8 ha, kepadatan 24 pohon/ha hasil deteksi, luas tajuk rata-rata 73,5 m².
geopandasmenulis kotak sebagai poligon GeoJSON di CRSEPSG:32748(UTM zona 48 selatan, dipilih sebagai contoh) dengan asal koordinat fiktif.
Detektor yang dilatih pada citra 320 px dengan ukuran tajuk tertentu tidak otomatis bekerja pada resolusi, musim, atau sensor lain. Selalu uji pada sebagian kecil data dari wilayah dan waktu yang akan dipakai, dan simpan hasil validasi manusia sebagai pembanding (lihat spatial CV di Bab 54).
Pustaka DetecTree (deteksi pohon dari citra udara dengan klasifikasi piksel) dibahas di Bab 59.
Latihan
- Di
02_iou_map.py, geser kotak prediksi kedua dari(21, 0, 31, 10)menjadi(25, 0, 35, 10). Berapa IoU-nya? Apakah masih dihitung benar pada ambang 0,5? - Di
06_inferensi_yolo.py, ubahconfmenjadi 0.1 dan 0.6. Catat jumlah kotak dan jumlah tajuk yang tertangkap. - Di
10_proyek_deteksi_pohon.py, ubahlangkahmenjadi 160 (tumpang tindih lebih besar). Apa yang terjadi pada jumlah deteksi mentah dan hasil akhir? - Tantangan: tambahkan aturan “buang kotak yang menyentuh tepi ubin” sebelum NMS (kecuali ubin itu di tepi mozaik) dan lihat apakah jumlah akhir mendekati 119.
Ringkasan Bab
- Citra = larik angka; Pillow RGB, OpenCV BGR.
- Klasifikasi (apa), deteksi (apa dan di mana), segmentasi (piksel mana).
- IoU menilai satu kotak; AP/mAP menilai detektor lewat presisi dan recall.
- YOLO (satu tahap) cepat dan mudah dilatih; keluarga R-CNN (dua tahap) lebih teliti untuk objek kecil dan padat.
- Mulai dari bobot pra-latih; dataset YOLO = citra + label ternormalisasi +
data.yaml. - Untuk citra besar: potong ubin tumpang tindih, deteksi, NMS, lalu georeferensi. Periksa cakupan dan kotak ganda di tepi ubin.
Selanjutnya, di Bab 57: kita beralih dari “melihat” ke “memilih”: algoritma genetika, optimisasi multi-objektif, dan NSGA-II untuk rencana tanam dan ransum pakan.