%%{init: {"flowchart": {"diagramPadding": 40}}}%%
flowchart TD
A["Bab 21: ambil data cuaca dan harga lewat API"] --> B["Bab 22: bersihkan catatan lapangan dengan regex"]
B --> C["Bab 23: gabungkan lima sektor, cuaca, harga di pandas"]
C --> D["Bab 24: simpan di basis data (SQLite)"]
D --> E["Bab 25: baca, analisis, dan gambar"]
Bab 25 — Data Science dan Analisis: Dari Tabel Menjadi Gambar dan Dugaan
Seri I2 — Data dan Internet
Semua skrip bab ini ada di folder kode/bab25/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Data sudah masuk (Bab 21), bersih (22), tertata (23), dan tersimpan (24). Sekarang ada pertanyaan khas ilmuwan data: “Apa yang bisa kita lihat dan duga dari data ini?” Bayangkan Anda mandor kebun yang menyimpan catatan hujan dan panen kopi dua bulan. Mandor yang baik melakukan empat hal: memeriksa (ringkasan angka), menggambar (grafik), menduga (model), dan mengujinya (apakah dugaan itu masih benar untuk data baru?). Bab ini mencoba keempatnya. Semua data di sini fiktif, dibuat dengan bilangan acak berbenih tetap (default_rng(42)) agar hasilnya selalu sama; karena itu, rumus pembuatnya diketahui dan kita bisa memeriksa apakah model menemukannya kembali.
pandas lanjut: kolom turunan dan kategori
01_pandas_lanjut.py
# Bab 25 - pandas lanjut: kolom baru, kategori, dan ringkasan
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)                        # benih tetap: hasil selalu sama
n = 60
data = pd.DataFrame({
    "tanggal": pd.date_range("2026-01-01", periods=n),
    "hujan_mm": rng.gamma(shape=1.2, scale=8.0, size=n).round(1),
})
data["hasil_kopi_kg"] = (200 + 1.5 * data["hujan_mm"].clip(upper=30) + rng.normal(0, 8, n)).round(1)

# pd.cut: mengubah angka menjadi kategori berdasarkan batas
data["kategori"] = pd.cut(data["hujan_mm"], bins=[-0.1, 5, 15, 1000], labels=["kering", "sedang", "lebat"])
print(data.head(5))
print(data["kategori"].value_counts())

ringkas = data.groupby("kategori", observed=True)["hasil_kopi_kg"].agg(["count", "mean", "max"]).round(1)
print(ringkas)

data["di_atas_rata"] = data["hasil_kopi_kg"] > data["hasil_kopi_kg"].mean()   # kolom benar/salah
print("Hari di atas rata-rata:", int(data["di_atas_rata"].sum()), "dari", n)
print(data.nlargest(3, "hasil_kopi_kg")[["tanggal", "hujan_mm", "hasil_kopi_kg"]])
tanggal hujan_mm hasil_kopi_kg kategori
0 2026-01-01 9.5 220.9 sedang
1 2026-01-02 14.2 224.2 sedang
2 2026-01-03 7.9 223.6 sedang
3 2026-01-04 6.8 200.7 sedang
4 2026-01-05 15.8 218.6 lebat
kategori
sedang 29
kering 24
lebat 7
Name: count, dtype: int64
count mean max
kategori
kering 24 201.5 221.7
sedang 29 216.5 242.2
lebat 7 227.7 242.3
Hari di atas rata-rata: 30 dari 60
tanggal hujan_mm hasil_kopi_kg
57 2026-02-27 27.0 242.3
15 2026-01-16 12.6 242.2
38 2026-02-08 12.7 236.1- Kolom baru dibuat dengan menugaskan hasil rumus:
data["hasil_kopi_kg"] = .... pd.cutmengubah angka menjadi kategori lewat batas: hujan 0 sampai 5 mm = kering, sampai 15 = sedang, di atasnya = lebat. Dari 60 hari: 24 kering, 29 sedang, 7 lebat.groupby(...).agg(...)memberi hasil kopi rata-rata per kategori: 201,5 kg (kering), 216,5 kg (sedang), dan 227,7 kg (lebat). Pola naik terlihat jelas.nlargest(3, ...)mengambil tiga hari panen terbanyak;.sum()pada kolomTrue/Falsemenghitung jumlahTrue(30 hari di atas rata-rata).
Data berurutan waktu
02_deret_waktu.py
# Bab 25 - Data berurutan waktu: indeks tanggal, resample, rolling
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)
hujan = pd.Series(rng.gamma(1.2, 8.0, 28).round(1), index=pd.date_range("2026-01-01", periods=28), name="hujan_mm")

print(hujan.loc["2026-01-03":"2026-01-05"])             # memilih lewat rentang tanggal
mingguan = hujan.resample("W").sum().round(1)           # jumlah per minggu (minggu berakhir hari Minggu)
print(mingguan)

rata_geser = hujan.rolling(window=7).mean().round(2)    # rata-rata 7 hari terakhir
print(rata_geser.iloc[[5, 6, 7, 27]])                   # 6 hari pertama masih kosong (NaN)
print("Selisih dari kemarin, 3 hari pertama:", hujan.diff().iloc[1:4].round(1).tolist())
2026-01-03 7.9
2026-01-04 6.8
2026-01-05 15.8
Freq: D, Name: hujan_mm, dtype: float64
2026-01-04 38.4
2026-01-11 86.2
2026-01-18 51.3
2026-01-25 64.7
2026-02-01 9.9
Freq: W-SUN, Name: hujan_mm, dtype: float64
2026-01-06 NaN
2026-01-07 10.37
2026-01-08 10.46
2026-01-28 8.00
Name: hujan_mm, dtype: float64
Selisih dari kemarin, 3 hari pertama: [4.7, -6.3, -1.1]Bila indeks berupa tanggal, Anda bisa memotong menurut rentang tanggal (loc["2026-01-03":"2026-01-05"]), meringkas per periode (resample("W") = per minggu), dan menghitung rata-rata bergeser (rolling(7).mean()). Enam hari pertama kosong (NaN) karena belum ada tujuh hari yang bisa dirata-ratakan; hari ke-7 (7 Januari) bernilai 10,37. Perhatikan minggu pertama (4 hari) dan minggu terakhir (berakhir 1 Februari, hanya 3 hari data) tidak penuh; jumlah minggu terakhir kecil (9,9 mm) karena itu. Periode yang tidak lengkap bisa menyesatkan.
numpy lanjut
03_numpy_lanjut.py
# Bab 25 - numpy lanjut: statistik, np.where, dan broadcasting
import numpy as np

rng = np.random.default_rng(42)
hujan = rng.gamma(1.2, 8.0, 30).round(1)
suhu = (28 + 0.05 * hujan + rng.normal(0, 1, 30)).round(1)

print("persentil 25/50/75:", np.percentile(hujan, [25, 50, 75]).round(2))
print("hari paling basah: hari ke-", int(hujan.argmax()) + 1, "dengan", hujan.max(), "mm")
print("korelasi hujan-suhu:", np.corrcoef(hujan, suhu)[0, 1].round(3))

label = np.where(hujan > 10, "basah", "kering")         # if-else untuk satu array penuh
print("jumlah hari basah:", int((label == "basah").sum()), "dari", label.size)

kumulatif = np.cumsum(hujan)                            # jumlah berjalan
print("hujan kumulatif hari ke-30:", kumulatif[-1].round(1))

# Broadcasting: array 2 dimensi dikurangi array 1 dimensi (per kolom), tanpa perulangan
tabel = np.column_stack([hujan, suhu])
z = (tabel - tabel.mean(axis=0)) / tabel.std(axis=0)    # standarisasi: rata-rata 0, sebaran 1
print("rata-rata setelah standarisasi:", z.mean(axis=0).round(6), "| sebaran:", z.std(axis=0).round(6))
persentil 25/50/75: [ 4.05 7.85 12.38]
hari paling basah: hari ke- 11 dengan 20.6 mm
korelasi hujan-suhu: 0.233
jumlah hari basah: 12 dari 30
hujan kumulatif hari ke-30: 253.2
rata-rata setelah standarisasi: [-0. -0.] | sebaran: [1. 1.]np.percentilememberi nilai batas: separuh hari punya hujan di bawah 7,85 mm (median).argmax()memberi posisi nilai terbesar (hari ke-11, 20,6 mm); karena posisi mulai dari 0, kita tambah 1 untuk nomor hari.np.corrcoefmenghitung korelasi (0,233: lemah). Korelasi hanya mengukur seberapa searah dua angka; ia bukan bukti sebab-akibat. Seri I3 membahasnya dalam.np.where(syarat, a, b)adalahif-elseuntuk satu array penuh. 12 dari 30 hari “basah”.- Broadcasting:
tabel - tabel.mean(axis=0)mengurangkan rata-rata tiap kolom dari kolomnya sendiri tanpa perulangan. Setelah standarisasi, rata-rata menjadi 0 dan sebaran 1 (nilai-0.hanyalah nol negatif yang sangat kecil dari pembulatan).
matplotlib: menggambar
matplotlib (pip install matplotlib) adalah pustaka grafik paling dasar di Python. Dua gagasan: figure (kanvas) dan axes (satu bidang gambar di kanvas itu).
04_matplotlib.py
# Bab 25 - matplotlib: grafik garis dan batang
from pathlib import Path
import matplotlib
matplotlib.use("Agg")                                   # menggambar ke berkas, tanpa jendela
import matplotlib.pyplot as plt
import numpy as np

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)

rng = np.random.default_rng(42)
hari = np.arange(1, 31)
hujan = rng.gamma(1.2, 8.0, 30).round(1)

fig, (atas, bawah) = plt.subplots(2, 1, figsize=(8, 6), sharex=True)
atas.plot(hari, hujan, marker="o", color="tab:blue")
atas.set_ylabel("Hujan (mm)")
atas.set_title("Hujan harian, Januari 2026 (data fiktif)")
bawah.bar(hari, np.cumsum(hujan), color="tab:green")
bawah.set_ylabel("Hujan kumulatif (mm)")
bawah.set_xlabel("Hari ke-")
fig.tight_layout()
fig.savefig(tmp / "hujan.png", dpi=100)
plt.close(fig)

print("Gambar tersimpan:", (tmp / "hujan.png").exists())
print("Jumlah sumbu (axes):", len(fig.axes))
Gambar tersimpan: True
Jumlah sumbu (axes): 2matplotlib.use("Agg") membuat matplotlib menggambar ke berkas tanpa membuka jendela (cocok untuk skrip otomatis). Grafik tersimpan di _tmp/hujan.png; skrip hanya mencetak bahwa berkas ada dan bahwa figure punya 2 axes. Bentuk umum: plot (garis), bar (batang), scatter (titik), lalu beri title, xlabel, ylabel, dan savefig.
TipTIPS
Setiap grafik harus menjawab satu pertanyaan, dan sumbu serta judulnya harus menyebut satuan. Grafik tanpa satuan membuat pembaca menebak. Beri pula catatan “data fiktif” bila memang fiktif.
05_scatter_garis.py
# Bab 25 - Diagram sebar dan garis kecenderungan
from pathlib import Path
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)

rng = np.random.default_rng(42)
hujan = rng.uniform(0, 30, 40)
hasil = 200 + 1.5 * hujan + rng.normal(0, 8, 40)       # hubungan sebenarnya: +1,5 kg per mm (kita tahu karena kita yang membuatnya)

kemiringan, titik_potong = np.polyfit(hujan, hasil, deg=1)   # garis lurus terbaik
print(f"garis: hasil = {titik_potong:.1f} + {kemiringan:.2f} x hujan")

plt.figure(figsize=(6, 4))
plt.scatter(hujan, hasil, alpha=0.7)
garis_x = np.array([0, 30])
plt.plot(garis_x, titik_potong + kemiringan * garis_x, color="tab:red")
plt.xlabel("Hujan (mm)")
plt.ylabel("Hasil kopi (kg)")
plt.title("Hujan dan hasil kopi (data fiktif)")
plt.tight_layout()
plt.savefig(tmp / "sebar.png", dpi=100)
plt.close()
print("Gambar tersimpan:", (tmp / "sebar.png").exists())
garis: hasil = 202.6 + 1.34 x hujan
Gambar tersimpan: TrueDiagram sebar (scatter) memperlihatkan hubungan dua angka. np.polyfit(..., deg=1) mencari garis lurus terbaik: hasil = 202,6 + 1,34 x hujan. Padahal aturan pembuat data sebenarnya 200 + 1,5 x hujan. Selisihnya wajar karena hanya 40 titik yang diberi derau (noise); makin banyak data, makin dekat. Ini pelajaran penting: hasil dari sampel kecil hanya perkiraan.
scikit-learn: model pertama
scikit-learn (pip install scikit-learn; di kode ditulis sklearn) adalah pustaka pembelajaran mesin (machine learning) klasik. Prosesnya selalu mirip: bagi data menjadi data latih dan data uji, latih model (fit), lalu uji pada data yang belum pernah dilihat (predict).
Regresi (memprediksi angka):
06_sklearn_regresi.py
# Bab 25 - scikit-learn: model regresi pertama (memprediksi angka)
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, r2_score
from sklearn.model_selection import train_test_split

rng = np.random.default_rng(42)
hujan = rng.uniform(0, 30, 80)
hasil = 200 + 1.5 * hujan + rng.normal(0, 8, 80)

X = hujan.reshape(-1, 1)                                # scikit-learn minta fitur berbentuk tabel (baris x kolom)
y = hasil
X_latih, X_uji, y_latih, y_uji = train_test_split(X, y, test_size=0.25, random_state=42)
print("data latih:", len(X_latih), "| data uji:", len(X_uji))

model = LinearRegression()
model.fit(X_latih, y_latih)                             # "belajar" dari data latih
print(f"model: hasil = {model.intercept_:.1f} + {model.coef_[0]:.2f} x hujan")

prediksi = model.predict(X_uji)                         # ujian: data yang belum pernah dilihat
print("R2 pada data uji:", round(r2_score(y_uji, prediksi), 3))
print("Rata-rata selisih mutlak (kg):", round(mean_absolute_error(y_uji, prediksi), 2))
print("Prediksi untuk hujan 10 mm dan 25 mm:", model.predict([[10], [25]]).round(1))
data latih: 60 | data uji: 20
model: hasil = 196.6 + 1.63 x hujan
R2 pada data uji: 0.709
Rata-rata selisih mutlak (kg): 7.42
Prediksi untuk hujan 10 mm dan 25 mm: [212.9 237.4]Dari 80 data, 60 dipakai melatih dan 20 untuk ujian. Model menemukan hasil = 196,6 + 1,63 x hujan. R2 pada data uji 0,709 artinya model menjelaskan kira-kira 71% variasi hasil; rata-rata meleset sekitar 7,42 kg. Prediksi untuk hujan 10 mm dan 25 mm: 212,9 dan 237,4 kg.
CatatanINGAT
Selalu uji model dengan data yang tidak ikut dipakai melatih. Model yang hanya diuji dengan data latihnya itu seperti murid yang diuji dengan soal yang sudah ia hafal jawabannya.
Klasifikasi (memprediksi kategori), yaitu pohon sehat atau sakit:
07_sklearn_klasifikasi.py
# Bab 25 - scikit-learn: klasifikasi (memprediksi kategori) pohon sehat atau sakit
import numpy as np
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

rng = np.random.default_rng(42)
n = 120
diameter = rng.uniform(15, 55, n)
tinggi = diameter * 0.55 + rng.normal(0, 2, n)
# aturan fiktif untuk membuat data: pohon langsing (tinggi besar, diameter kecil) lebih sering sakit
peluang_sakit = 1 / (1 + np.exp(-(tinggi / diameter - 0.62) * 25))
sakit = rng.uniform(size=n) < peluang_sakit

X = np.column_stack([diameter, tinggi])
X_latih, X_uji, y_latih, y_uji = train_test_split(X, sakit, test_size=0.3, random_state=42, stratify=sakit)

pohon = DecisionTreeClassifier(max_depth=3, random_state=42).fit(X_latih, y_latih)
print("Akurasi data latih:", round(accuracy_score(y_latih, pohon.predict(X_latih)), 3))
print("Akurasi data uji  :", round(accuracy_score(y_uji, pohon.predict(X_uji)), 3))
print("Pembanding (selalu menebak 'tidak sakit'):", round(float((~y_uji).mean()), 3))
print("Pentingnya fitur (diameter, tinggi):", pohon.feature_importances_.round(2))
print("Prediksi pohon 20 cm/16 m dan 40 cm/22 m:", pohon.predict([[20, 16], [40, 22]]))
Akurasi data latih: 0.893
Akurasi data uji : 0.694
Pembanding (selalu menebak 'tidak sakit'): 0.778
Pentingnya fitur (diameter, tinggi): [0.42 0.58]
Prediksi pohon 20 cm/16 m dan 40 cm/22 m: [False True]Hasilnya mengajarkan sesuatu yang jujur. Akurasi data latih 0,893, tetapi data uji hanya 0,694, lebih rendah daripada tebakan bodoh “selalu bilang tidak sakit” (0,778). Model menghafal data latih (overfitting) dan belum berguna pada data baru. Dengan hanya 120 pohon dan model sebebas pohon keputusan, ini wajar. Cara memperbaikinya (data lebih banyak, model lebih sederhana, validasi silang, ukuran lain selain akurasi) adalah bahan Seri I3 dan Seri A3. Yang penting sekarang: selalu bandingkan model dengan pembanding sederhana.
Jupyter Notebook dan Anaconda
Jupyter Notebook adalah “buku catatan” interaktif: sel teks (Markdown) dan sel kode berselang-seling, hasil (angka, tabel, grafik) tampil tepat di bawah sel kodenya. Sangat populer untuk eksplorasi data karena Anda bisa mencoba, melihat, dan menjelaskan di satu tempat. Berkasnya berekstensi .ipynb, sebenarnya JSON biasa.
Anaconda adalah paket “semua dalam satu” yang membawa Python, pengelola paket conda, Jupyter, dan banyak pustaka ilmu data (pemasangan dan perbandingannya dengan venv dibahas di Bab 17). Di komputer penulis, perintah conda tidak ditemukan, jadi Anaconda tidak dijalankan di buku ini. Notebook di bab ini dijalankan dengan Jupyter yang terpasang di environment proyek (pip), yang cara kerjanya sama. Anda bisa memakai keduanya: Anaconda Navigator bila ingin antarmuka klik-klik, atau pip install jupyterlab lalu jupyter lab.
Skrip berikut membuat notebook lewat kode (nbformat), menjalankan semua selnya (nbconvert), lalu mencetak keluarannya, seperti menekan “Run All”.
08_jupyter_notebook.py
# Bab 25 - Membuat dan menjalankan Jupyter Notebook lewat kode
import os
from pathlib import Path
import nbformat
from nbconvert.preprocessors import ExecutePreprocessor

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)

buku = nbformat.v4.new_notebook()
buku.cells = [
    nbformat.v4.new_markdown_cell("# Catatan hujan\nNotebook kecil: teks dan kode berselang-seling."),
    nbformat.v4.new_code_cell("import pandas as pd\nhujan = pd.Series([12.5, 0.0, 8.2, 25.4, 3.1])\nhujan.sum()"),
    nbformat.v4.new_code_cell("print('Rata-rata:', hujan.mean())\nhujan.describe().round(2)"),
]
nbformat.write(buku, tmp / "catatan_hujan.ipynb")

# Menjalankan semua sel, seperti menekan "Run All" di Jupyter
# (Peringatan teknis kernel di layar kita sembunyikan sementara: isinya soal sambungan lokal, bukan galat.)
layar_galat = os.dup(2)
os.dup2(os.open(os.devnull, os.O_WRONLY), 2)
try:
    ExecutePreprocessor(timeout=120, kernel_name="python3").preprocess(buku, {"metadata": {"path": str(tmp)}})
finally:
    os.dup2(layar_galat, 2)

for nomor, sel in enumerate(buku.cells, start=1):
    if sel.cell_type != "code":
        continue
    print(f"--- sel {nomor} ---")
    for keluar in sel.outputs:
        if keluar.output_type == "stream":
            print(keluar.text.rstrip())
        elif keluar.output_type == "execute_result":
            print(keluar.data["text/plain"])
--- sel 2 ---
np.float64(49.199999999999996)
--- sel 3 ---
Rata-rata: 9.84
count 5.00
mean 9.84
std 9.93
min 0.00
25% 3.10
50% 8.20
75% 12.50
max 25.40
dtype: float64Sel 2 menjumlahkan hujan: np.float64(49.199999999999996). Itulah isi nyata hasil sel; angka desimal komputer memang tidak selalu tepat (Bab 5), dan numpy 2 menampilkan jenisnya. Sel 3 mencetak rata-rata 9,84 lalu hasil describe() (hasil ekspresi terakhir sel otomatis ditampilkan, tanpa print). Berkas notebook yang dibuat ada di _tmp/catatan_hujan.ipynb; bukalah dengan JupyterLab untuk melihat tampilannya.
BahayaBAGIAN TEKNIS (boleh dilewati)
Notebook menyimpan keadaan kernel (urutan eksekusi sel). Sel yang dijalankan tidak berurutan bisa membuat hasil yang tidak bisa diulang dari nol. Kebiasaan baik: sebelum membagikan notebook, pilih “Restart kernel and run all” dan pastikan semua sel tetap berjalan. Untuk laporan yang bisa direproduksi, Bab 29 membahas Quarto dan cara lain.
Proyek Bersambung I2: dari basis data ke grafik
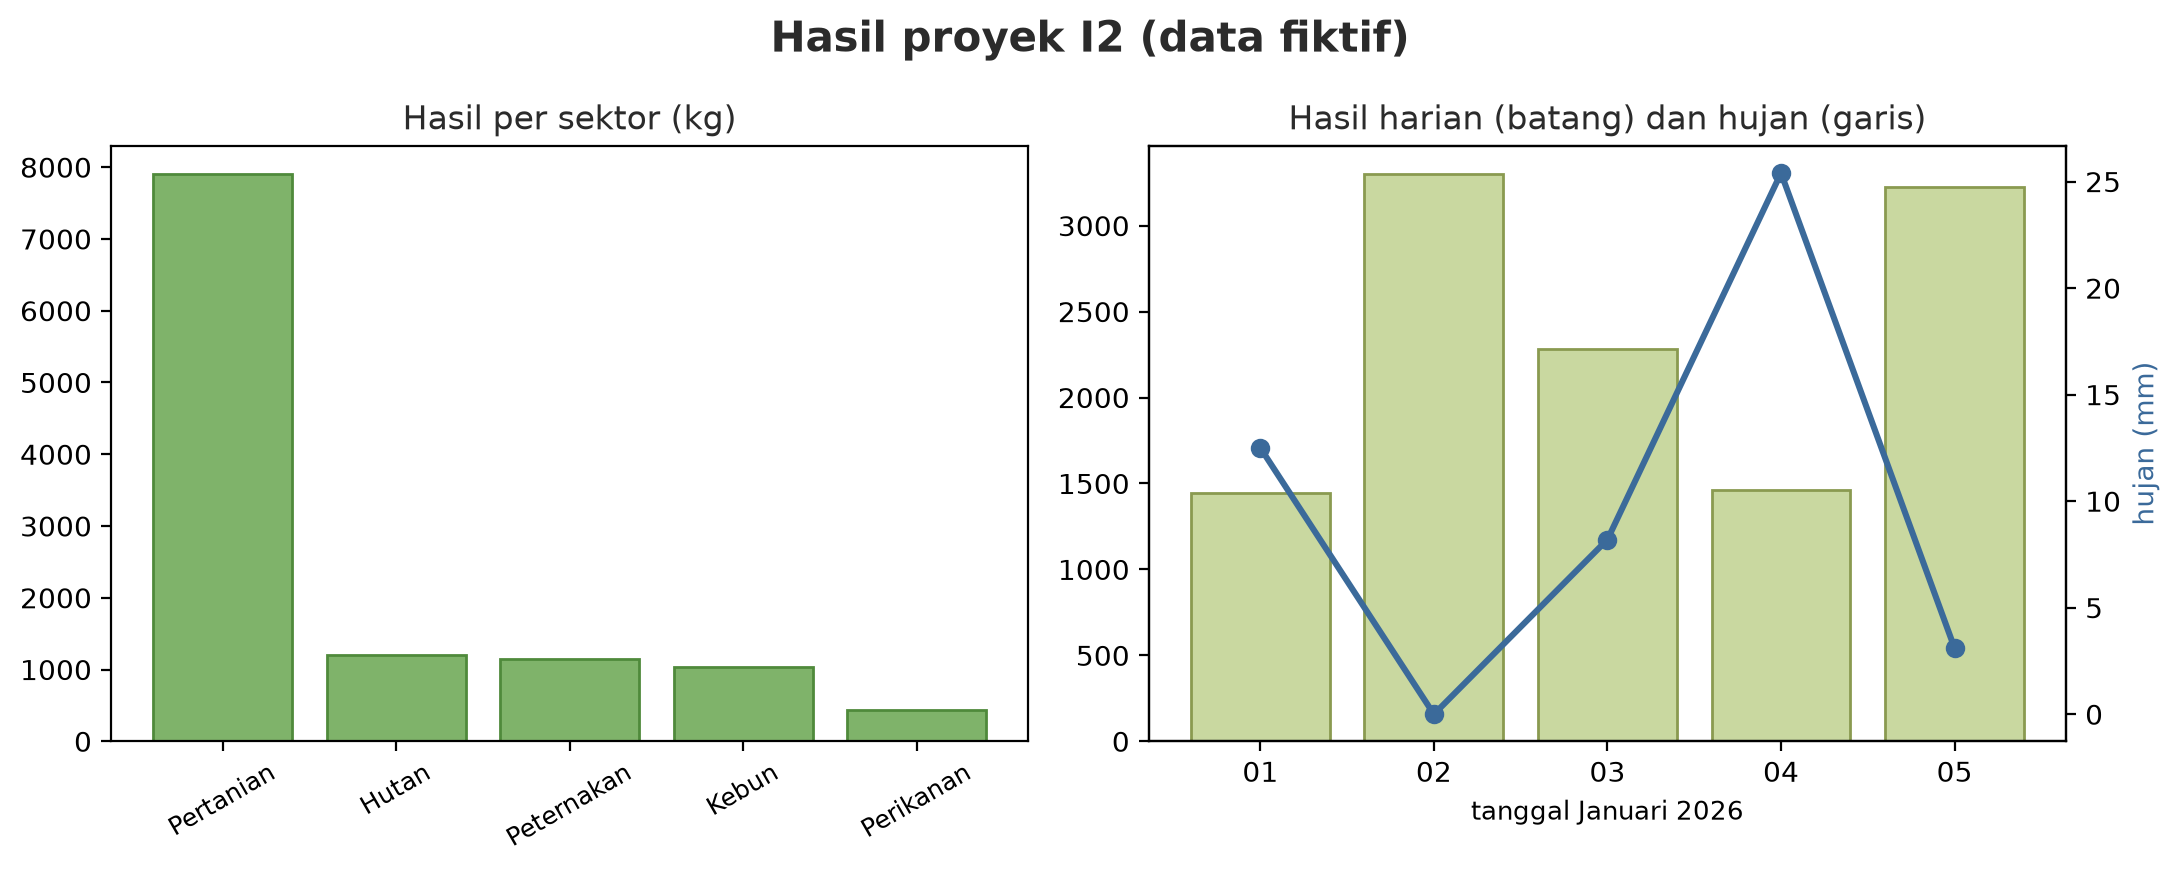
Penutup Proyek I2. Skrip menyimpan data fiktif ke SQLite (ringkasan Bab 21-24), membacanya kembali dengan satu pertanyaan SQL, menganalisis dengan pandas, dan menggambar dua grafik.
09_proyek_penutup.py
# Bab 25 - Proyek bersambung I2, langkah akhir: dari basis data ke grafik
from pathlib import Path
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd
from sqlalchemy import create_engine

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)
berkas = tmp / "penutup_i2.db"
berkas.unlink(missing_ok=True)
engine = create_engine(f"sqlite:///{berkas.as_posix()}")

# Langkah 1-4 (Bab 21-24) diringkas: data fiktif disimpan ke basis data
panen = pd.DataFrame(
    [("2026-01-01", "Hutan", "jati", 1200.0), ("2026-01-01", "Kebun", "kopi", 245.5),
     ("2026-01-02", "Kebun", "kakao", 198.5), ("2026-01-02", "Pertanian", "padi", 3100.0),
     ("2026-01-03", "Pertanian", "jagung", 1850.0), ("2026-01-03", "Perikanan", "lele", 432.4),
     ("2026-01-04", "Peternakan", "sapi", 1151.5), ("2026-01-04", "Kebun", "kopi", 310.0),
     ("2026-01-05", "Pertanian", "padi", 2950.0), ("2026-01-05", "Kebun", "kakao", 276.0)],
    columns=["tanggal", "sektor", "komoditas", "hasil_kg"])
tanggal = ["2026-01-01", "2026-01-02", "2026-01-03", "2026-01-04", "2026-01-05"]
cuaca = pd.DataFrame({"tanggal": tanggal, "hujan_mm": [12.5, 0.0, 8.2, 25.4, 3.1]})
daftar = {"padi": [6200, 6250, 6180, 6300, 6270], "jagung": [5100, 5150, 5200, 5120, 5180],
          "kopi": [58000, 58500, 59000, 57500, 58200], "kakao": [62000, 61500, 62500, 63000, 62800]}
harga = pd.DataFrame([(t, k, h) for k, v in daftar.items() for t, h in zip(tanggal, v)],
                     columns=["tanggal", "komoditas", "harga_per_kg"])
panen.to_sql("panen", engine, index=False)
cuaca.to_sql("cuaca", engine, index=False)
harga.to_sql("harga", engine, index=False)

# Langkah 5 (bab ini): baca kembali dari basis data, gabungkan, analisis, gambar
df = pd.read_sql_query("""
    SELECT p.tanggal, p.sektor, p.hasil_kg, c.hujan_mm, p.hasil_kg * h.harga_per_kg AS pendapatan_rp
    FROM panen p
    LEFT JOIN cuaca c ON c.tanggal = p.tanggal
    LEFT JOIN harga h ON h.tanggal = p.tanggal AND h.komoditas = p.komoditas
""", engine)
engine.dispose()

per_sektor = df.groupby("sektor")["hasil_kg"].sum().sort_values(ascending=False)
per_hari = df.groupby("tanggal").agg(hasil_kg=("hasil_kg", "sum"), hujan_mm=("hujan_mm", "first"))
print(per_sektor)
print(per_hari)
print("Korelasi hujan dan total hasil harian (hanya 5 hari, jangan dipercaya):",
      round(per_hari["hujan_mm"].corr(per_hari["hasil_kg"]), 2))
print("Pendapatan tercatat (Rp):", f"{df['pendapatan_rp'].sum():,.0f}")

fig, (kiri, kanan) = plt.subplots(1, 2, figsize=(10, 4))
per_sektor.plot.bar(ax=kiri, color="tab:green", rot=30)
kiri.set_title("Hasil per sektor (kg)")
kanan.bar(per_hari.index.str[-2:], per_hari["hasil_kg"], color="tab:olive")
kanan2 = kanan.twinx()
kanan2.plot(per_hari.index.str[-2:], per_hari["hujan_mm"], color="tab:blue", marker="o")
kanan.set_title("Hasil harian (batang) dan hujan (garis)")
fig.tight_layout()
fig.savefig(tmp / "proyek_i2.png", dpi=100)
print("Grafik tersimpan:", (tmp / "proyek_i2.png").exists())
sektor
Pertanian 7900.0
Hutan 1200.0
Peternakan 1151.5
Kebun 1030.0
Perikanan 432.4
Name: hasil_kg, dtype: float64
hasil_kg hujan_mm
tanggal
2026-01-01 1445.5 12.5
2026-01-02 3298.5 0.0
2026-01-03 2282.4 8.2
2026-01-04 1461.5 25.4
2026-01-05 3226.0 3.1
Korelasi hujan dan total hasil harian (hanya 5 hari, jangan dipercaya): -0.87
Pendapatan tercatat (Rp): 109,096,050
Grafik tersimpan: TrueHasilnya, Pertanian terbesar (7900,0 kg), disusul Hutan (1200,0), Peternakan (1151,5), Kebun (1030,0), dan Perikanan (432,4). Pendapatan tercatat Rp 109.096.050 adalah jumlah Kebun dan Pertanian saja (61.604.550 + 47.491.500), karena hanya itu yang punya harga. Korelasi hujan dan total hasil harian -0,87 terlihat kuat, tetapi hanya dari 5 hari; itu kebetulan yang menarik, bukan bukti bahwa hujan menurunkan panen. Mengukur seberapa yakin kita pada angka seperti itulah pekerjaan statistika (Seri I3).
Latihan
- Di
01_pandas_lanjut.py, ubah batas kategori hujan menjadi 0-10 (kering), 10-20 (sedang), lebih dari 20 (lebat). Bagaimana jumlah hari tiap kategori berubah? - Di
02_deret_waktu.py, gantiresample("W")denganresample("D")lalurolling(window=3). Apa bedanya dengan rolling 7 hari? - Di
06_sklearn_regresi.py, ubahtest_sizemenjadi 0,5. Apakah R2 berubah? Mengapa? - Tantangan: di
07_sklearn_klasifikasi.py, ubahmax_depthmenjadi 1, lalu 6. Bandingkan akurasi latih dan uji. Model mana paling jujur?
Ringkasan Bab
- pandas lanjut: kolom turunan,
pd.cutuntuk kategori,groupby().agg(), indeks tanggal denganresampledanrolling. - numpy:
percentile,corrcoef,where,cumsum, dan broadcasting tanpa perulangan. - matplotlib: figure dan axes;
plot,bar,scatter; beri judul, sumbu, dan satuan. - scikit-learn: bagi data latih/uji,
fit,predict, nilai R2 atau akurasi; bandingkan dengan pembanding sederhana. - Hasil dari sampel kecil hanya perkiraan; korelasi bukan sebab-akibat.
- Jupyter Notebook menggabungkan teks, kode, dan hasil; Anaconda membawa Jupyter dan pustaka ilmu data (tidak dijalankan di sini).
Penutup Seri I2
Selamat! Anda sudah menempuh perjalanan data lengkap: mengambil data lewat API, membersihkannya dengan regex, mengolahnya di numpy dan pandas, menyimpannya di basis data, dan menggambar serta menduganya dengan matplotlib dan scikit-learn. Kelima sektor, cuaca, dan harga kini hidup dalam satu alur kerja yang bisa Anda ulang.
Tetapi data yang sudah rapi segera memunculkan pertanyaan yang lebih sulit: apa artinya? Apakah beda rata-rata dua plot itu nyata atau kebetulan? Seberapa yakin kita bahwa hujan memengaruhi panen? Seri I3 menjawabnya dengan statistik dan pemodelan.
Selanjutnya, di Bab 26: statistika dengan Python, dari rata-rata dan sebaran sampai uji hipotesis dan cara menafsirkan p-value dengan benar.