Bab 24 — Database: Lemari Arsip yang Tidak Pernah Lupa
Seri I2 — Data dan Internet
Semua skrip bab ini ada di folder kode/bab24/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
File CSV (Bab 23) itu seperti tumpukan kertas catatan: mudah dibuat, tetapi sulit dicari, dan bisa kacau bila dua orang menulis bersamaan. Basis data adalah lemari arsip berlaci: tiap laci (tabel) punya kolom yang tetap, tiap kertas (baris) mengikuti aturan, dan petugas arsip (SQL, Structured Query Language) menjawab pertanyaan seperti “berapa total panen kebun?” tanpa Anda membongkar semua kertas. Ia juga menjaga agar penyimpanan aman: perubahan yang setengah jalan bisa dibatalkan.
SQLite: basis data dalam satu berkas
SQLite adalah mesin basis data yang hidup sebagai satu berkas dan sudah dibawa Python (modul sqlite3), jadi tanpa pemasangan dan tanpa server. Cocok untuk belajar, aplikasi kecil, dan data yang bisa dibawa-bawa.
01_sqlite_dasar.py
# Bab 24 - SQLite dengan modul sqlite3 (bawaan Python)
import sqlite3
from pathlib import Path

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)
berkas = tmp / "lapangan.db"
berkas.unlink(missing_ok=True)                 # mulai dari basis data kosong agar hasilnya sama

koneksi = sqlite3.connect(berkas)              # berkas dibuat bila belum ada
koneksi.execute("""
    CREATE TABLE pohon (
        id INTEGER PRIMARY KEY,
        jenis TEXT NOT NULL,
        plot TEXT NOT NULL,
        diameter_cm REAL
    )
""")
data = [("Jati", "A", 32.5), ("Meranti", "A", 45.2), ("Mahoni", "B", 28.0), ("Jati", "B", 36.1)]
koneksi.executemany("INSERT INTO pohon (jenis, plot, diameter_cm) VALUES (?, ?, ?)", data)
koneksi.commit()                               # tanpa commit, perubahan tidak disimpan permanen

for baris in koneksi.execute("SELECT id, jenis, plot, diameter_cm FROM pohon ORDER BY diameter_cm DESC"):
    print(baris)

jumlah = koneksi.execute("SELECT COUNT(*) FROM pohon").fetchone()[0]
print("Jumlah pohon:", jumlah)
koneksi.close()
(2, 'Meranti', 'A', 45.2)
(4, 'Jati', 'B', 36.1)
(1, 'Jati', 'A', 32.5)
(3, 'Mahoni', 'B', 28.0)
Jumlah pohon: 4CREATE TABLEmendefinisikan kolom dan jenisnya;PRIMARY KEY= nomor unik tiap baris;NOT NULL= wajib diisi.?adalah tempat nilai (placeholder); nilainya diberikan terpisah.executemanymemasukkan banyak baris sekaligus.commit()menyimpan perubahan secara permanen. Tanpa commit, perubahan bisa hilang.ORDER BY diameter_cm DESCmengurutkan dari besar ke kecil: Meranti 45,2 paling atas.
Jangan menempel teks pengguna ke SQL
02_parameter_aman.py
# Bab 24 - Parameter (?) melawan SQL injection
import sqlite3

koneksi = sqlite3.connect(":memory:")          # basis data sementara di memori
koneksi.execute("CREATE TABLE petugas (nama TEXT, wilayah TEXT)")
koneksi.executemany("INSERT INTO petugas VALUES (?, ?)", [("Sari", "Plot A"), ("Budi", "Plot B")])

masukan = "x' OR '1'='1"                        # ketikan jahil seorang pengguna

# CARA SALAH: menempelkan teks pengguna langsung ke SQL (f-string)
sql_salah = f"SELECT nama FROM petugas WHERE nama = '{masukan}'"
print("SQL yang terbentuk:", sql_salah)
print("Hasil cara salah  :", koneksi.execute(sql_salah).fetchall())      # bocor: semua baris keluar!

# CARA BENAR: tanda tanya + nilai terpisah; teks diperlakukan sebagai DATA, bukan perintah
print("Hasil cara benar  :", koneksi.execute("SELECT nama FROM petugas WHERE nama = ?", (masukan,)).fetchall())
SQL yang terbentuk: SELECT nama FROM petugas WHERE nama = 'x' OR '1'='1'
Hasil cara salah : [('Sari',), ('Budi',)]
Hasil cara benar : []Pada cara salah, ketikan jahil x' OR '1'='1 ikut menjadi bagian perintah SQL dan membuat syarat selalu benar, sehingga semua baris bocor. Ini disebut SQL injection, salah satu serangan paling umum di dunia. Cara benar: selalu pakai tanda ? (atau :nama) dan berikan nilainya terpisah; teks diperlakukan sebagai data, tidak pernah sebagai perintah. Hasilnya: tidak ada baris yang cocok.
Mengubah, menghapus, dan transaksi
03_ubah_hapus_transaksi.py
# Bab 24 - UPDATE, DELETE, dan transaksi (commit / rollback)
import sqlite3

koneksi = sqlite3.connect(":memory:")
koneksi.execute("CREATE TABLE kolam (nama TEXT PRIMARY KEY, ikan INTEGER CHECK (ikan >= 0))")
koneksi.executemany("INSERT INTO kolam VALUES (?, ?)", [("A", 800), ("B", 650), ("C", 400)])
koneksi.commit()

koneksi.execute("UPDATE kolam SET ikan = ikan - 50 WHERE nama = 'A'")     # 50 ikan dipanen
koneksi.execute("DELETE FROM kolam WHERE nama = 'C'")                     # kolam C dibongkar
print(koneksi.execute("SELECT * FROM kolam ORDER BY nama").fetchall())
koneksi.commit()                                    # simpan dulu: titik aman sebelum percobaan berikut

# Transaksi: semua langkah berhasil bersama, atau batal bersama
try:
    with koneksi:                                   # commit otomatis; rollback bila ada galat
        koneksi.execute("UPDATE kolam SET ikan = ikan - 100 WHERE nama = 'B'")
        koneksi.execute("UPDATE kolam SET ikan = ikan - 900 WHERE nama = 'A'")   # melanggar CHECK
except sqlite3.IntegrityError as galat:
    print("Dibatalkan:", galat)

print("Setelah rollback:", koneksi.execute("SELECT * FROM kolam ORDER BY nama").fetchall())
[('A', 750), ('B', 650)]
Dibatalkan: CHECK constraint failed: ikan >= 0
Setelah rollback: [('A', 750), ('B', 650)]Setelah panen 50 ikan, kolam A tinggal 750; kolam C dibongkar. Lalu datang transaksi: dua perubahan yang harus berhasil bersama. Perubahan kedua (kurangi 900 ikan dari A) melanggar aturan CHECK (ikan >= 0), sehingga SQLite menolak dengan IntegrityError, dan blok with koneksi: membatalkan kedua perubahan (rollback): kolam B tetap 650, bukan 550. Itulah gunanya transaksi: tidak ada keadaan setengah jadi.
Basis data bisa menjaga aturan data untuk Anda lewat batasan (NOT NULL, UNIQUE, CHECK, PRIMARY KEY, FOREIGN KEY). Biarkan basis data menolak data buruk, jangan hanya mengandalkan kode Python.
Dua tabel: JOIN dan GROUP BY
04_join_agregasi.py
# Bab 24 - Dua tabel: JOIN dan GROUP BY
import sqlite3

koneksi = sqlite3.connect(":memory:")
koneksi.executescript("""
    CREATE TABLE sektor (id INTEGER PRIMARY KEY, nama TEXT);
    CREATE TABLE panen (id INTEGER PRIMARY KEY, sektor_id INTEGER REFERENCES sektor(id),
                        komoditas TEXT, hasil_kg REAL);
    INSERT INTO sektor VALUES (1, 'Kebun'), (2, 'Pertanian'), (3, 'Perikanan');
    INSERT INTO panen (sektor_id, komoditas, hasil_kg) VALUES
        (1, 'kopi', 245.5), (1, 'kakao', 198.5), (1, 'kopi', 310.0),
        (2, 'padi', 3100.0), (2, 'jagung', 1850.0), (3, 'lele', 432.4);
""")

sql = """
    SELECT sektor.nama AS sektor, COUNT(*) AS jumlah_panen, ROUND(SUM(panen.hasil_kg), 1) AS total_kg
    FROM panen
    JOIN sektor ON sektor.id = panen.sektor_id
    GROUP BY sektor.nama
    HAVING SUM(panen.hasil_kg) > 500
    ORDER BY total_kg DESC
"""
for baris in koneksi.execute(sql):
    print(baris)
('Pertanian', 2, 4950.0)
('Kebun', 3, 754.0)JOIN menyambung baris dua tabel yang sektor_id-nya sama dengan id sektor, sehingga nama sektor ikut tampil. GROUP BY mengelompokkan dan SUM/COUNT meringkas, persis seperti groupby pandas di Bab 23. HAVING menyaring setelah pengelompokan (hanya sektor dengan total di atas 500 kg), sedangkan WHERE menyaring sebelumnya. Pertanian: 2 panen, 4950,0 kg (3100 + 1850); Kebun: 3 panen, 754,0 kg; Perikanan dibuang oleh HAVING karena hanya 432,4 kg.
pandas dan SQL
05_pandas_dan_sql.py
# Bab 24 - pandas dan SQL saling bertukar data
import sqlite3
import pandas as pd

koneksi = sqlite3.connect(":memory:")

kolam = pd.DataFrame({"kolam": ["A", "B", "C"], "jenis": ["lele", "nila", "lele"],
                      "ikan": [800, 650, 400], "bobot_g": [540.5, 320.0, 480.0]})
kolam.to_sql("kolam", koneksi, index=False)               # DataFrame -> tabel SQL

hasil = pd.read_sql_query(
    "SELECT jenis, SUM(ikan) AS total_ikan, ROUND(AVG(bobot_g), 1) AS bobot_rata_g FROM kolam GROUP BY jenis",
    koneksi,
)                                                         # hasil SQL -> DataFrame
print(hasil)

berat = pd.read_sql_query("SELECT * FROM kolam WHERE bobot_g > ?", koneksi, params=(450,))
print(berat)
jenis total_ikan bobot_rata_g
0 lele 1200 510.3
1 nila 650 320.0
kolam jenis ikan bobot_g
0 A lele 800 540.5
1 C lele 400 480.0to_sql mengubah DataFrame menjadi tabel; read_sql_query mengubah hasil SELECT menjadi DataFrame. Dua alat itu bersahabat: SQL bagus untuk memilah data besar di basis data, pandas bagus untuk menganalisis hasilnya.
SQLAlchemy: satu cara untuk banyak basis data
Menulis SQL langsung terikat pada satu merek basis data. SQLAlchemy adalah pustaka (pip install sqlalchemy) yang menjadi penerjemah: kode yang sama bisa berjalan di SQLite maupun PostgreSQL, cukup mengganti alamat sambungan (URL) pada create_engine. Ia punya dua lapisan.
Core: Anda tetap menulis SQL, tetapi dengan parameter bernama :nama yang aman dan pengelolaan sambungan yang rapi (engine.begin() = commit otomatis di akhir blok):
06_sqlalchemy_core.py
# Bab 24 - SQLAlchemy: engine dan text() (lapisan "Core")
from pathlib import Path
from sqlalchemy import create_engine, text

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)
berkas = tmp / "sqlalchemy_core.db"
berkas.unlink(missing_ok=True)

engine = create_engine(f"sqlite:///{berkas.as_posix()}")       # URL: jenis_basis_data:///jalur

with engine.begin() as koneksi:                                  # begin(): commit otomatis di akhir blok
    koneksi.execute(text("CREATE TABLE ternak (kandang TEXT, jenis TEXT, bobot_kg REAL)"))
    koneksi.execute(
        text("INSERT INTO ternak VALUES (:kandang, :jenis, :bobot)"),     # :nama = parameter bernama
        [{"kandang": "K1", "jenis": "sapi", "bobot": 350.0},
         {"kandang": "K1", "jenis": "sapi", "bobot": 412.5},
         {"kandang": "K2", "jenis": "sapi", "bobot": 389.0}],
    )

with engine.connect() as koneksi:
    hasil = koneksi.execute(text("SELECT kandang, AVG(bobot_kg) AS rata FROM ternak GROUP BY kandang"))
    for baris in hasil:
        print(baris.kandang, round(baris.rata, 2))

print("dialek:", engine.dialect.name)
engine.dispose()                                                  # lepaskan berkas
K1 381.25
K2 389.0
dialek: sqliteORM (Object-Relational Mapper): tabel ditulis sebagai kelas Python (ingat OOP, Bab 16), baris menjadi objek, dan hubungan antartabel menjadi atribut:
07_sqlalchemy_orm.py
# Bab 24 - SQLAlchemy ORM: tabel sebagai kelas Python
from pathlib import Path
from sqlalchemy import ForeignKey, create_engine, func, select
from sqlalchemy.orm import DeclarativeBase, Mapped, Session, mapped_column, relationship

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)
berkas = tmp / "sqlalchemy_orm.db"
berkas.unlink(missing_ok=True)


class Dasar(DeclarativeBase):
    pass


class Sektor(Dasar):
    __tablename__ = "sektor"
    id: Mapped[int] = mapped_column(primary_key=True)
    nama: Mapped[str]
    panen: Mapped[list["Panen"]] = relationship(back_populates="sektor")


class Panen(Dasar):
    __tablename__ = "panen"
    id: Mapped[int] = mapped_column(primary_key=True)
    komoditas: Mapped[str]
    hasil_kg: Mapped[float]
    sektor_id: Mapped[int] = mapped_column(ForeignKey("sektor.id"))
    sektor: Mapped[Sektor] = relationship(back_populates="panen")


engine = create_engine(f"sqlite:///{berkas.as_posix()}")
Dasar.metadata.create_all(engine)                   # membuat tabel dari definisi kelas

with Session(engine) as sesi:
    kebun = Sektor(nama="Kebun", panen=[Panen(komoditas="kopi", hasil_kg=245.5),
                                         Panen(komoditas="kakao", hasil_kg=198.5)])
    sawah = Sektor(nama="Pertanian", panen=[Panen(komoditas="padi", hasil_kg=3100.0)])
    sesi.add_all([kebun, sawah])
    sesi.commit()

with Session(engine) as sesi:
    for sektor in sesi.scalars(select(Sektor).order_by(Sektor.nama)):
        print(sektor.nama, "->", [p.komoditas for p in sektor.panen])        # relasi otomatis

    terbesar = sesi.scalars(select(Panen).order_by(Panen.hasil_kg.desc())).first()
    print("Panen terbesar:", terbesar.komoditas, terbesar.hasil_kg, "kg dari", terbesar.sektor.nama)
    print("Total kg:", sesi.scalar(select(func.sum(Panen.hasil_kg))))
engine.dispose()
Kebun -> ['kopi', 'kakao']
Pertanian -> ['padi']
Panen terbesar: padi 3100.0 kg dari Pertanian
Total kg: 3544.0Sektor.panen berisi daftar objek Panen tanpa Anda menulis JOIN; sebaliknya terbesar.sektor.nama menelusuri ke atas. Total 3544,0 kg = 245,5 + 198,5 + 3100,0.
PostgreSQL: basis data tingkat server
PostgreSQL adalah basis data berupa server yang dipakai banyak orang bersamaan, dengan fitur yang jauh lebih lengkap (pengguna dan hak akses, kapasitas besar, ekstensi seperti PostGIS untuk peta di Seri A2). Dengan SQLAlchemy, perbedaan terbesar hanyalah alamat sambungannya, berbentuk postgresql+psycopg://PENGGUNA:KATA_SANDI@SERVER:5432/NAMA_BASIS_DATA, yang memakai pustaka psycopg versi 3 (pip install "psycopg[binary]").
08_postgresql.py
# Bab 24 - Menyambung ke PostgreSQL (server sementara yang dinyalakan alat pembangun buku)
import os
from sqlalchemy import create_engine, text

# Alamat sambungan dibaca dari variabel lingkungan, jadi kata sandi tidak tertulis di kode.
# Bentuk alamat di server milik Anda:
#   postgresql://PENGGUNA:KATA_SANDI@SERVER:5432/NAMA_BASIS_DATA
# Contoh nilai variabel (kata sandi disamarkan):
#   DATABASE_URL = postgresql://petugas:[disamarkan]@localhost:5432/hutan_kebun
alamat = os.environ["DATABASE_URL"]

# SQLAlchemy memilih driver dari awalan alamat; "+psycopg" meminta psycopg versi 3.
alamat = alamat.replace("postgresql://", "postgresql+psycopg://", 1)
engine = create_engine(alamat)

with engine.begin() as koneksi:
    koneksi.execute(text("""
        CREATE TABLE IF NOT EXISTS panen (
            id SERIAL PRIMARY KEY,
            komoditas TEXT NOT NULL,
            hasil_kg NUMERIC(10, 1)
        )
    """))
    koneksi.execute(text("INSERT INTO panen (komoditas, hasil_kg) VALUES (:k, :h)"), {"k": "kopi", "h": 245.5})

with engine.connect() as koneksi:
    print(koneksi.execute(text("SELECT komoditas, hasil_kg FROM panen")).fetchall())
[('kopi', Decimal('245.5'))]Kode ini dijalankan sungguhan saat buku dibuat, pada PostgreSQL 14.5 sementara yang dinyalakan alat pembangun buku: server itu hanya hidup selama buku dibuat, hanya bisa dihubungi dari komputer penulis, tanpa kata sandi, lalu dihapus. Server milik pembaca atau kantor biasanya memakai nama pengguna dan kata sandi; bagian itu tidak diuji di sini. Perhatikan dua hal pada keluarannya. Pertama, kolom NUMERIC kembali sebagai Decimal('245.5'), bukan float seperti di SQLite. Kedua, baris alamat.replace(...) menambahkan +psycopg pada awalan alamat supaya SQLAlchemy memakai driver psycopg 3.
Untuk mencobanya di komputer Anda, atur dulu variabel lingkungannya (contoh di PowerShell, kata sandi disamarkan): $env:DATABASE_URL = "postgresql://petugas:[disamarkan]@localhost:5432/hutan_kebun". Perhatikan dua kebiasaan aman: alamat dibaca dari variabel lingkungan DATABASE_URL (kata sandi tidak ada di kode), dan contoh nilainya ditulis [disamarkan].
Beda SQLite dan PostgreSQL yang akan Anda temui: PostgreSQL ketat pada jenis kolom (kolom NUMERIC kembali sebagai Decimal, bukan float; ini terbukti dari keluaran di atas), memakai SERIAL atau GENERATED ... AS IDENTITY untuk nomor otomatis (SERIAL dipakai dan berjalan di contoh), dan sebuah tabel yang dibuat dalam transaksi baru terlihat orang lain setelah commit. SQLite lebih longgar soal jenis kolom. Itulah alasan menguji di mesin yang akan dipakai sungguhan. (Butir tentang GENERATED ... AS IDENTITY dan visibilitas transaksi adalah pengetahuan umum yang belum diuji di buku ini.)
Proyek Bersambung I2: menyimpan data gabungan
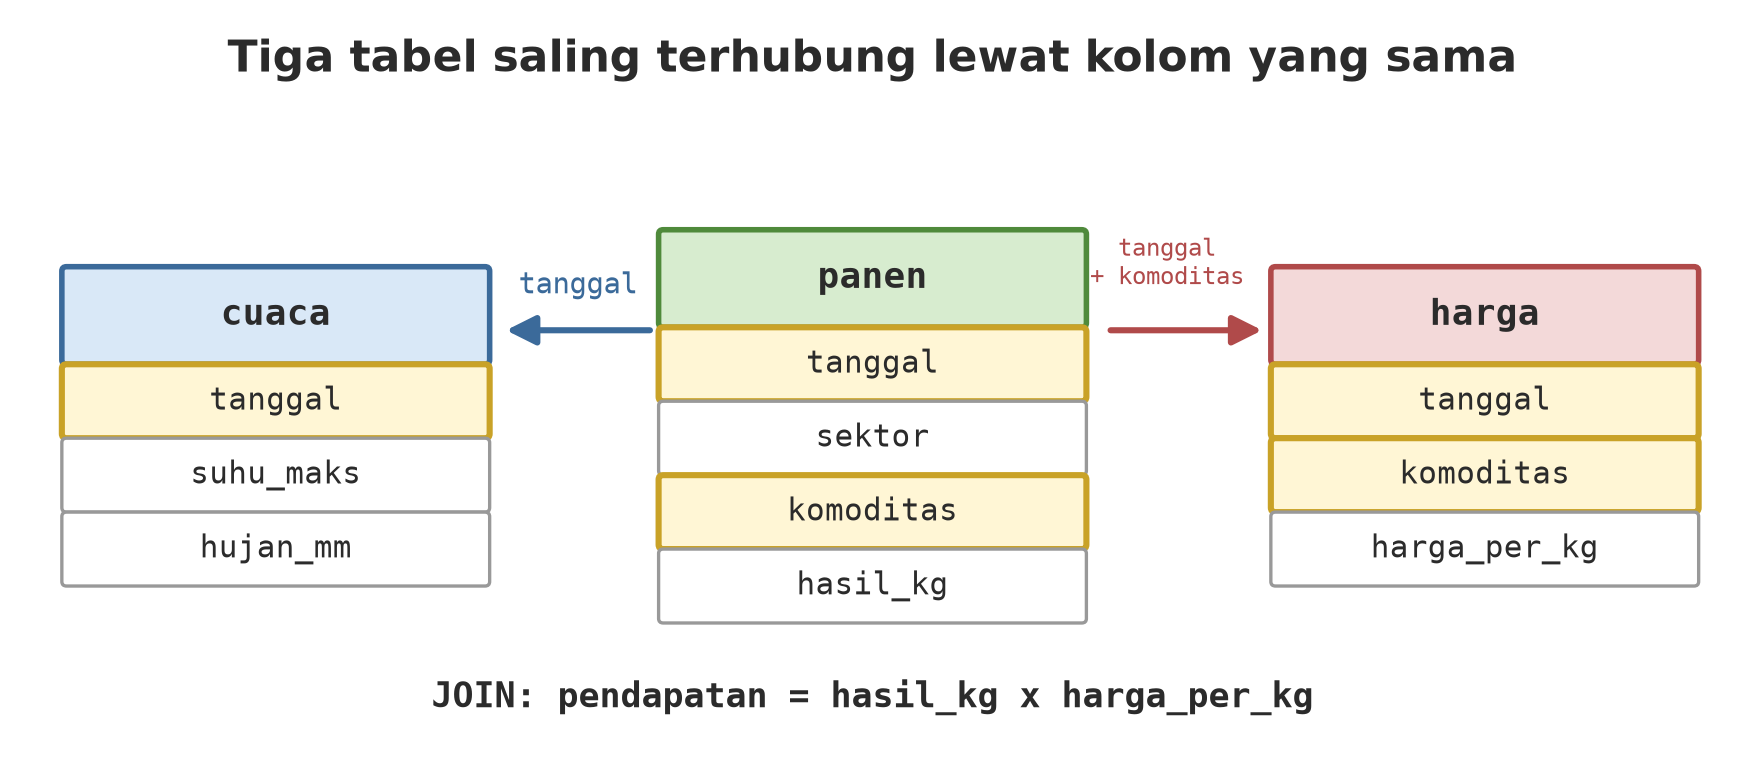
Langkah 4: data fiktif disimpan sebagai tiga tabel terpisah (panen, cuaca, harga) di berkas SQLite, seperti basis data sungguhan, lalu satu pertanyaan SQL dengan dua LEFT JOIN menghitung total hasil, pendapatan, dan hujan rata-rata per sektor.
09_proyek_simpan_db.py
# Bab 24 - Proyek bersambung I2, langkah 4: menyimpan data gabungan ke basis data
from pathlib import Path
import pandas as pd
from sqlalchemy import create_engine, text

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)
berkas = tmp / "proyek_i2.db"
berkas.unlink(missing_ok=True)

# Data (fiktif) disalin supaya skrip berdiri sendiri; bentuknya sama dengan Bab 21 dan 23.
panen = pd.DataFrame(
    [("2026-01-01", "Hutan", "Plot A", "jati", 1200.0), ("2026-01-01", "Kebun", "Blok A", "kopi", 245.5),
     ("2026-01-02", "Kebun", "Blok B", "kakao", 198.5), ("2026-01-02", "Pertanian", "Sawah 1", "padi", 3100.0),
     ("2026-01-03", "Pertanian", "Sawah 2", "jagung", 1850.0), ("2026-01-03", "Perikanan", "Kolam A", "lele", 432.4),
     ("2026-01-04", "Peternakan", "Kandang 1", "sapi", 1151.5), ("2026-01-04", "Kebun", "Blok C", "kopi", 310.0),
     ("2026-01-05", "Pertanian", "Sawah 1", "padi", 2950.0), ("2026-01-05", "Kebun", "Blok D", "kakao", 276.0)],
    columns=["tanggal", "sektor", "unit", "komoditas", "hasil_kg"])
tanggal = ["2026-01-01", "2026-01-02", "2026-01-03", "2026-01-04", "2026-01-05"]
cuaca = pd.DataFrame({"tanggal": tanggal, "suhu_maks": [30.1, 31.4, 29.8, 28.9, 30.6],
                      "hujan_mm": [12.5, 0.0, 8.2, 25.4, 3.1]})
daftar_harga = {"padi": [6200, 6250, 6180, 6300, 6270], "jagung": [5100, 5150, 5200, 5120, 5180],
                "kopi": [58000, 58500, 59000, 57500, 58200], "kakao": [62000, 61500, 62500, 63000, 62800]}
harga = pd.DataFrame([(t, k, h) for k, v in daftar_harga.items() for t, h in zip(tanggal, v)],
                     columns=["tanggal", "komoditas", "harga_per_kg"])

engine = create_engine(f"sqlite:///{berkas.as_posix()}")
panen.to_sql("panen", engine, index=False)         # tiga tabel terpisah, seperti basis data sungguhan
cuaca.to_sql("cuaca", engine, index=False)
harga.to_sql("harga", engine, index=False)

sql = text("""
    SELECT p.sektor,
           ROUND(SUM(p.hasil_kg), 1) AS hasil_kg,
           ROUND(SUM(p.hasil_kg * h.harga_per_kg), 0) AS pendapatan_rp,
           ROUND(AVG(c.hujan_mm), 1) AS hujan_rata_mm
    FROM panen p
    LEFT JOIN harga h ON h.tanggal = p.tanggal AND h.komoditas = p.komoditas
    LEFT JOIN cuaca c ON c.tanggal = p.tanggal
    GROUP BY p.sektor
    ORDER BY p.sektor
""")
with engine.connect() as koneksi:
    for tabel in ["panen", "cuaca", "harga"]:
        n = koneksi.execute(text(f"SELECT COUNT(*) FROM {tabel}")).scalar()
        print(f"tabel {tabel:6}: {n} baris")
    print(pd.read_sql_query(sql, koneksi).to_string(index=False))
engine.dispose()
tabel panen : 10 baris
tabel cuaca : 5 baris
tabel harga : 20 baris
sektor hasil_kg pendapatan_rp hujan_rata_mm
Hutan 1200.0 NaN 12.5
Kebun 1030.0 61604550.0 10.3
Perikanan 432.4 NaN 8.2
Pertanian 7900.0 47491500.0 3.8
Peternakan 1151.5 NaN 25.4Hasilnya cocok dengan pandas di Bab 23: Kebun 1030,0 kg dan Rp 61.604.550; Pertanian 7900,0 kg dan Rp 47.491.500. Sektor tanpa harga menunjukkan NaN pada pendapatan karena SUM atas nilai kosong tetap kosong. Beda dengan pandas yang menjumlahkan kosong menjadi 0. Hujan rata-rata per sektor adalah rata-rata hujan pada hari-hari panen sektor itu (bukan hujan sebulan), jadi tafsirkan dengan hati-hati.
Latihan
- Di
01_sqlite_dasar.py, tambahkan satu pohon baru, lalu cetak hanya pohon denganplot = 'B'(pakaiWHERE plot = ?). - Di
03_ubah_hapus_transaksi.py, ubah pengurangan A menjadi 100 sehingga tidak melanggar aturan. Apa yang terjadi pada seluruh transaksi? - Di
04_join_agregasi.py, hapusHAVINGdan tambahkanORDER BY sektor.nama. Sektor apa saja yang tampil? - Tantangan: di
07_sqlalchemy_orm.py, tambahkan sektor “Perikanan” dengan satu panen “lele” 432,4 kg, lalu cetak total hasil per sektor denganfunc.sumdangroup_by.
Ringkasan Bab
- Basis data = lemari arsip berlaci: tabel, baris, kolom; SQL = bahasa untuk bertanya dan mengubahnya.
- SQLite = satu berkas, bawaan Python (
sqlite3); simpan perubahan dengancommit(). - Selalu pakai parameter (
?,:nama), jangan menempel teks pengguna ke SQL (SQL injection). - Transaksi membuat sekelompok perubahan berhasil bersama atau batal bersama; batasan (
CHECK,NOT NULL, …) menjaga mutu data. JOINmenyambung tabel;GROUP BY+SUM/COUNTmeringkas;WHEREmenyaring sebelum,HAVINGsesudah pengelompokan.- SQLAlchemy (Core dan ORM) menyatukan akses ke banyak basis data; PostgreSQL cukup mengganti alamat sambungan, dan bagian itu dijalankan di buku ini pada server sementara (server milik Anda tetap butuh pengguna dan kata sandi).
Selanjutnya, di Bab 25: data tersimpan rapi. Saatnya menganalisisnya: pandas lanjut, numpy, matplotlib, scikit-learn, dan Jupyter Notebook, lalu menutup Seri I2.