Bab 23 — Pengantar numpy dan pandas: Tabel Pintar untuk Data Lapangan
Seri I2 — Data dan Internet
Semua skrip bab ini ada di folder kode/bab23/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Bayangkan buku catatan lapangan dengan ribuan baris. Menghitung rata-rata diameter dengan for itu bisa, tetapi lambat dan panjang. numpy adalah ibarat karung seragam: semua isinya satu jenis (misalnya angka desimal), sehingga bisa ditimbang, dikali, dan dijumlahkan sekaligus. pandas adalah lembar kerja berlabel (mirip Excel) yang dibangun di atas numpy: setiap kolom punya nama, setiap baris punya nomor, dan Anda bisa menyaring serta meringkasnya dengan satu-dua baris kode. (Pemasangan: pip install numpy pandas; keduanya sudah ada di environment proyek ini.)
numpy: array
01_array_dasar.py
# Bab 23 - Array numpy: daftar angka yang cepat dan seragam
import numpy as np

diameter = np.array([32.5, 45.2, 28.0, 19.8, 36.1, 51.5])
print(diameter)
print("tipe:", diameter.dtype, "| bentuk:", diameter.shape, "| jumlah:", diameter.size)

print(np.arange(0, 10, 2))               # seperti range(), tetapi menghasilkan array
print(np.linspace(0, 1, 5))              # 5 angka rata antara 0 dan 1
print(np.zeros((2, 3)))                  # tabel 2 baris x 3 kolom berisi nol

tabel = np.array([[32.5, 18.0], [45.2, 25.5], [28.0, 15.0]])   # diameter, tinggi
print(tabel.shape, "->", tabel.shape[0], "baris,", tabel.shape[1], "kolom")
print(tabel[1, 0], "|", tabel[:, 1], "|", tabel[0])             # [baris, kolom]
[32.5 45.2 28. 19.8 36.1 51.5]
tipe: float64 | bentuk: (6,) | jumlah: 6
[0 2 4 6 8]
[0. 0.25 0.5 0.75 1. ]
[[0. 0. 0.]
[0. 0. 0.]]
(3, 2) -> 3 baris, 2 kolom
45.2 | [18. 25.5 15. ] | [32.5 18. ]np.array([...])membuat array.dtype: float64berarti semua isinya desimal 64-bit;shape: (6,)berarti satu dimensi, enam elemen.np.arangemiriprange(Bab 8);np.linspace(0, 1, 5)membagi rata 0 sampai 1 menjadi 5 titik;np.zeros((2, 3))membuat tabel nol 2 baris x 3 kolom.- Pada array dua dimensi, penulisan
[baris, kolom]:tabel[1, 0]= 45,2 (baris ke-1, kolom ke-0),tabel[:, 1]= seluruh kolom ke-1 (tinggi).
Operasi sekaligus
02_operasi_array.py
# Bab 23 - Operasi sekaligus (vektor), irisan logika, dan sumbu
import numpy as np

diameter_cm = np.array([32.5, 45.2, 28.0, 19.8, 36.1, 51.5])

jari_m = diameter_cm / 2 / 100           # satu rumus untuk SEMUA elemen, tanpa perulangan
print("jari-jari (m):", jari_m)
luas_m2 = 3.14159 * jari_m ** 2
print("luas penampang (m2):", luas_m2.round(3))

besar = diameter_cm >= 30                # hasilnya array True/False
print("besar?   ", besar)
print("yang besar:", diameter_cm[besar])  # memilih lewat topeng True/False
print("rata-rata:", diameter_cm.mean().round(2), "| terbesar:", diameter_cm.max(), "| simpangan baku:",
      diameter_cm.std().round(2))

tabel = np.array([[32.5, 18.0], [45.2, 25.5], [28.0, 15.0]])
print("rata-rata tiap kolom (axis=0):", tabel.mean(axis=0))
print("jumlah tiap baris  (axis=1):", tabel.sum(axis=1))
jari-jari (m): [0.1625 0.226 0.14 0.099 0.1805 0.2575]
luas penampang (m2): [0.083 0.16 0.062 0.031 0.102 0.208]
besar? [ True True False False True True]
yang besar: [32.5 45.2 36.1 51.5]
rata-rata: 35.52 | terbesar: 51.5 | simpangan baku: 10.51
rata-rata tiap kolom (axis=0): [35.23333333 19.5 ]
jumlah tiap baris (axis=1): [50.5 70.7 43. ]Tidak ada for: diameter_cm / 2 / 100 dikerjakan pada keenam elemen sekaligus (vektorisasi). Perbandingan diameter_cm >= 30 menghasilkan array True/False, dan array itu bisa dipakai sebagai topeng untuk memilih elemen (diameter_cm[besar]).
axis menentukan arah: axis=0 meringkas ke bawah per kolom (rata-rata diameter 35,23 dan tinggi 19,5), axis=1 meringkas ke samping per baris (50,5; 70,7; 43,0).
Simpangan baku numpy (std()) bernilai 10,51, tetapi describe() pandas di bagian DataFrame di bawah menunjukkan 11,51 untuk data yang sama. Bukan salah hitung: numpy membagi dengan n (populasi) secara bawaan, pandas membagi dengan n-1 (sampel). Seri I3 menjelaskan alasannya; untuk sekarang, ingat bahwa dua pustaka bisa punya bawaan berbeda.
pandas: DataFrame
03_dataframe_dasar.py
# Bab 23 - DataFrame: tabel dengan nama kolom
import pandas as pd

pohon = pd.DataFrame({
    "jenis": ["Jati", "Meranti", "Mahoni", "Sengon", "Jati", "Meranti"],
    "plot": ["A", "A", "B", "C", "B", "C"],
    "diameter_cm": [32.5, 45.2, 28.0, 19.8, 36.1, 51.5],
    "tinggi_m": [18.0, 25.5, 15.0, 12.0, 20.5, 28.0],
    "sehat": [True, False, True, True, False, True],
})
print(pohon)
print()
print("bentuk (baris, kolom):", pohon.shape)
print(pohon.dtypes)
print()
print(pohon["diameter_cm"].mean())        # satu kolom = Series
print(pohon.describe().round(2))          # ringkasan statistik kolom angka
jenis plot diameter_cm tinggi_m sehat
0 Jati A 32.5 18.0 True
1 Meranti A 45.2 25.5 False
2 Mahoni B 28.0 15.0 True
3 Sengon C 19.8 12.0 True
4 Jati B 36.1 20.5 False
5 Meranti C 51.5 28.0 True
bentuk (baris, kolom): (6, 5)
jenis str
plot str
diameter_cm float64
tinggi_m float64
sehat bool
dtype: object
35.516666666666666
diameter_cm tinggi_m
count 6.00 6.00
mean 35.52 19.83
std 11.51 6.12
min 19.80 12.00
25% 29.12 15.75
50% 34.30 19.25
75% 42.92 24.25
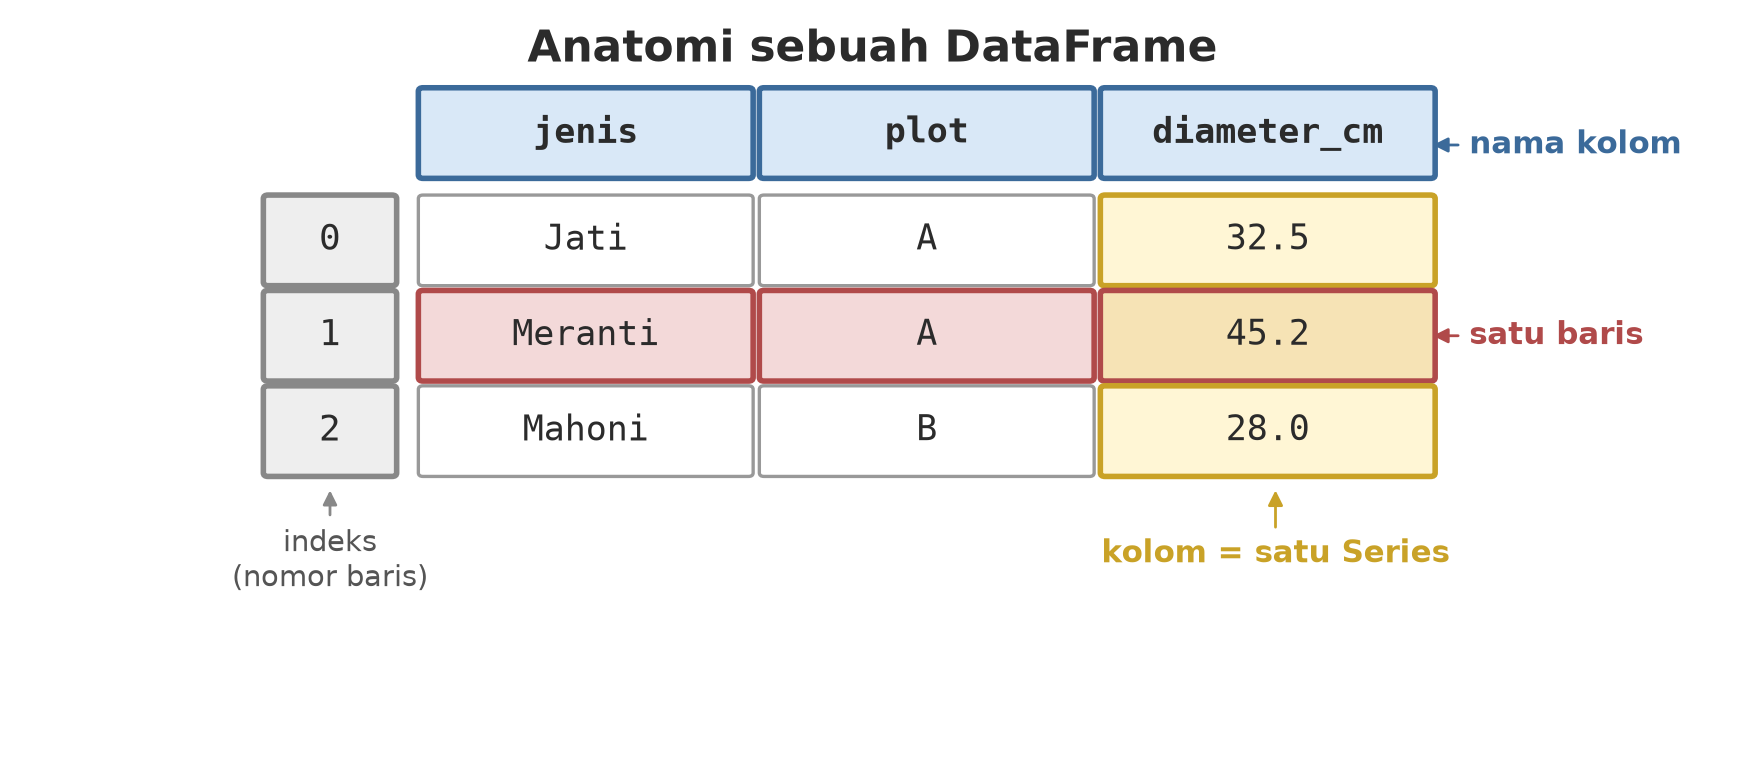
max 51.50 28.00Kolom-kolom di DataFrame boleh berbeda jenis: teks (str), desimal (float64), benar/salah (bool). Satu kolom, misalnya pohon["diameter_cm"], disebut Series. describe() merangkum kolom angka: banyaknya, rata-rata (35,52), terkecil (19,8), kuartil, terbesar (51,5).
Memilih dan menyaring
05_pilih_dan_filter.py
# Bab 23 - Memilih kolom/baris dan menyaring (filter)
import pandas as pd

pohon = pd.DataFrame({
    "jenis": ["Jati", "Meranti", "Mahoni", "Sengon", "Jati", "Meranti"],
    "plot": ["A", "A", "B", "C", "B", "C"],
    "diameter_cm": [32.5, 45.2, 28.0, 19.8, 36.1, 51.5],
    "sehat": [True, False, True, True, False, True],
})

print(pohon[["jenis", "diameter_cm"]].head(2))            # beberapa kolom
print(pohon.iloc[0])                                       # baris ke-0 menurut urutan
print(pohon.loc[2, "jenis"])                               # baris berlabel 2, kolom "jenis"

besar = pohon[pohon["diameter_cm"] >= 30]                  # saring dengan syarat
print(besar)

sakit_besar = pohon[(pohon["diameter_cm"] >= 30) & (~pohon["sehat"])]   # & = DAN, ~ = BUKAN
print(sakit_besar)
print(pohon.query("plot == 'A' or jenis == 'Jati'"))       # cara lain, mirip kalimat
print(pohon.sort_values("diameter_cm", ascending=False).head(3))
jenis diameter_cm
0 Jati 32.5
1 Meranti 45.2
jenis Jati
plot A
diameter_cm 32.5
sehat True
Name: 0, dtype: object
Mahoni
jenis plot diameter_cm sehat
0 Jati A 32.5 True
1 Meranti A 45.2 False
4 Jati B 36.1 False
5 Meranti C 51.5 True
jenis plot diameter_cm sehat
1 Meranti A 45.2 False
4 Jati B 36.1 False
jenis plot diameter_cm sehat
0 Jati A 32.5 True
1 Meranti A 45.2 False
4 Jati B 36.1 False
jenis plot diameter_cm sehat
5 Meranti C 51.5 True
1 Meranti A 45.2 False
4 Jati B 36.1 Falsedf[["a", "b"]]memilih kolom;ilocmemilih menurut urutan,locmenurut label.df[df["diameter_cm"] >= 30]menyaring baris dengan syarat. Untuk menggabungkan syarat pakai&(dan),|(atau),~(bukan), masing-masing syarat diberi kurung.query("plot == 'A' or jenis == 'Jati'")adalah cara yang lebih mirip kalimat.sort_values(..., ascending=False)mengurutkan dari terbesar.
Agregasi: meringkas per kelompok
06_agregasi.py
# Bab 23 - Agregasi: groupby, value_counts, pivot_table
import pandas as pd

pohon = pd.DataFrame({
    "jenis": ["Jati", "Meranti", "Mahoni", "Sengon", "Jati", "Meranti"],
    "plot": ["A", "A", "B", "C", "B", "C"],
    "diameter_cm": [32.5, 45.2, 28.0, 19.8, 36.1, 51.5],
    "tinggi_m": [18.0, 25.5, 15.0, 12.0, 20.5, 28.0],
})

print(pohon["jenis"].value_counts())                       # berapa pohon per jenis
print(pohon.groupby("jenis")["diameter_cm"].mean().round(2))

rekap = pohon.groupby("plot").agg(
    jumlah=("jenis", "count"),
    diameter_rata=("diameter_cm", "mean"),
    tinggi_maks=("tinggi_m", "max"),
)
print(rekap.round(2))

print(pohon.pivot_table(index="plot", columns="jenis", values="diameter_cm", aggfunc="mean"))
jenis
Jati 2
Meranti 2
Mahoni 1
Sengon 1
Name: count, dtype: int64
jenis
Jati 34.30
Mahoni 28.00
Meranti 48.35
Sengon 19.80
Name: diameter_cm, dtype: float64
jumlah diameter_rata tinggi_maks
plot
A 2 38.85 25.5
B 2 32.05 20.5
C 2 35.65 28.0
jenis Jati Mahoni Meranti Sengon
plot
A 32.5 NaN 45.2 NaN
B 36.1 28.0 NaN NaN
C NaN NaN 51.5 19.8groupby bekerja seperti memilah karung per jenis lalu menimbang tiap tumpukan: pola pecah, hitung, gabung. Rata-rata diameter Jati 34,30 (dari 32,5 dan 36,1), Meranti 48,35. agg memungkinkan beberapa ringkasan sekaligus dengan nama kolom hasil sendiri. pivot_table membuat tabel silang plot x jenis; sel yang tidak punya data diisi NaN (“bukan angka” = kosong).
Menggabung tabel dan data kosong
07_gabung_dan_kosong.py
# Bab 23 - Menggabung tabel (merge, concat) dan data kosong (NaN)
import pandas as pd

panen = pd.DataFrame({"komoditas": ["kopi", "padi", "lele"], "hasil_kg": [245.5, 3100.0, 432.4]})
harga = pd.DataFrame({"komoditas": ["kopi", "padi", "jagung"], "harga_per_kg": [58000, 6200, 5100]})

# how="left": semua baris panen dipertahankan; yang tak punya pasangan harga diisi NaN
gabung = panen.merge(harga, on="komoditas", how="left")
print(gabung)
print("Baris kosong harga:", gabung["harga_per_kg"].isna().sum())

gabung["pendapatan"] = gabung["hasil_kg"] * gabung["harga_per_kg"]
print(gabung)
print(gabung.fillna({"harga_per_kg": 0, "pendapatan": 0}))   # isi kosong dengan 0
print(gabung.dropna())                                       # buang baris yang ada kosongnya

tambahan = pd.DataFrame({"komoditas": ["sapi"], "hasil_kg": [1151.5]})
print(pd.concat([panen, tambahan], ignore_index=True))        # menumpuk baris ke bawah
komoditas hasil_kg harga_per_kg
0 kopi 245.5 58000.0
1 padi 3100.0 6200.0
2 lele 432.4 NaN
Baris kosong harga: 1
komoditas hasil_kg harga_per_kg pendapatan
0 kopi 245.5 58000.0 14239000.0
1 padi 3100.0 6200.0 19220000.0
2 lele 432.4 NaN NaN
komoditas hasil_kg harga_per_kg pendapatan
0 kopi 245.5 58000.0 14239000.0
1 padi 3100.0 6200.0 19220000.0
2 lele 432.4 0.0 0.0
komoditas hasil_kg harga_per_kg pendapatan
0 kopi 245.5 58000.0 14239000.0
1 padi 3100.0 6200.0 19220000.0
komoditas hasil_kg
0 kopi 245.5
1 padi 3100.0
2 lele 432.4
3 sapi 1151.5merge menyambung dua tabel lewat kolom bersama, seperti JOIN di basis data (Bab 24). Dengan how="left", semua baris panen dipertahankan; lele tidak punya harga sehingga NaN, dan pendapatan-nya ikut kosong. Ada tiga cara menangani kosong: dibiarkan, fillna (isi nilai pengganti), atau dropna (buang barisnya). Pilih sesuai makna data: mengisi harga lele dengan 0 berarti “gratis”, yang belum tentu benar.
Setelah merge, selalu cek isna().sum(). Baris tak berpasangan hampir selalu tanda ada nama yang tidak cocok (misalnya kopi lawan Kopi) atau memang data yang belum ada.
Proyek Bersambung I2: menggabungkan lima sektor, cuaca, dan harga
Langkah 3: sepuluh catatan panen dari lima sektor (hutan, kebun, pertanian, perikanan, peternakan), cuaca Bogor, dan harga digabung menjadi satu tabel. (Data fiktif; disalin di skrip agar berdiri sendiri, bentuknya sama dengan hasil Bab 21.)
08_proyek_gabung.py
# Bab 23 - Proyek bersambung I2, langkah 3: menggabungkan lima sektor, cuaca, dan harga
import pandas as pd

# Data lima sektor (fiktif). Disalin di sini supaya skrip berdiri sendiri.
panen = pd.DataFrame(
    [("2026-01-01", "Hutan", "Plot A", "jati", 1200.0),
     ("2026-01-01", "Kebun", "Blok A", "kopi", 245.5),
     ("2026-01-02", "Kebun", "Blok B", "kakao", 198.5),
     ("2026-01-02", "Pertanian", "Sawah 1", "padi", 3100.0),
     ("2026-01-03", "Pertanian", "Sawah 2", "jagung", 1850.0),
     ("2026-01-03", "Perikanan", "Kolam A", "lele", 432.4),
     ("2026-01-04", "Peternakan", "Kandang 1", "sapi", 1151.5),
     ("2026-01-04", "Kebun", "Blok C", "kopi", 310.0),
     ("2026-01-05", "Pertanian", "Sawah 1", "padi", 2950.0),
     ("2026-01-05", "Kebun", "Blok D", "kakao", 276.0)],
    columns=["tanggal", "sektor", "unit", "komoditas", "hasil_kg"],
)
# Cuaca Bogor dan harga: bentuknya sama dengan data dari server tiruan di Bab 21 (fiktif)
cuaca = pd.DataFrame({
    "tanggal": ["2026-01-01", "2026-01-02", "2026-01-03", "2026-01-04", "2026-01-05"],
    "suhu_maks": [30.1, 31.4, 29.8, 28.9, 30.6],
    "hujan_mm": [12.5, 0.0, 8.2, 25.4, 3.1],
})
harga = pd.DataFrame(
    [(t, k, h) for k, daftar in {
        "padi": [6200, 6250, 6180, 6300, 6270],
        "jagung": [5100, 5150, 5200, 5120, 5180],
        "kopi": [58000, 58500, 59000, 57500, 58200],
        "kakao": [62000, 61500, 62500, 63000, 62800]}.items()
     for t, h in zip(cuaca["tanggal"], daftar)],
    columns=["tanggal", "komoditas", "harga_per_kg"],
)

gabung = (panen
          .merge(cuaca, on="tanggal", how="left")
          .merge(harga, on=["tanggal", "komoditas"], how="left"))
gabung["pendapatan_rp"] = gabung["hasil_kg"] * gabung["harga_per_kg"]

print(gabung.drop(columns=["tanggal"]).to_string(index=False))
print()
print("Baris tanpa harga (hutan, ikan, ternak):", int(gabung["harga_per_kg"].isna().sum()))
per_sektor = gabung.groupby("sektor").agg(hasil_kg=("hasil_kg", "sum"), pendapatan_rp=("pendapatan_rp", "sum"))
print(per_sektor.round(0))
sektor unit komoditas hasil_kg suhu_maks hujan_mm harga_per_kg pendapatan_rp
Hutan Plot A jati 1200.0 30.1 12.5 NaN NaN
Kebun Blok A kopi 245.5 30.1 12.5 58000.0 14239000.0
Kebun Blok B kakao 198.5 31.4 0.0 61500.0 12207750.0
Pertanian Sawah 1 padi 3100.0 31.4 0.0 6250.0 19375000.0
Pertanian Sawah 2 jagung 1850.0 29.8 8.2 5200.0 9620000.0
Perikanan Kolam A lele 432.4 29.8 8.2 NaN NaN
Peternakan Kandang 1 sapi 1151.5 28.9 25.4 NaN NaN
Kebun Blok C kopi 310.0 28.9 25.4 57500.0 17825000.0
Pertanian Sawah 1 padi 2950.0 30.6 3.1 6270.0 18496500.0
Kebun Blok D kakao 276.0 30.6 3.1 62800.0 17332800.0
Baris tanpa harga (hutan, ikan, ternak): 3
hasil_kg pendapatan_rp
sektor
Hutan 1200.0 0.0
Kebun 1030.0 61604550.0
Perikanan 432.0 0.0
Pertanian 7900.0 47491500.0
Peternakan 1152.0 0.0Telusuri hasilnya:
- Tiap catatan panen menerima suhu dan hujan hari yang sama (
mergepadatanggal) dan harga komoditas dan hari yang sama (mergepada dua kolom). - 3 baris tanpa harga: kayu jati, lele, sapi, karena API harga hanya memuat padi, jagung, kopi, kakao.
pendapatan_rpuntuk baris ituNaN. - Ringkasan per sektor: Kebun 1030,0 kg dengan pendapatan Rp 61.604.550; Pertanian 7900,0 kg dengan Rp 47.491.500. Sektor Hutan, Perikanan, dan Peternakan tercatat 0 pendapatan hanya karena
summengabaikanNaN, bukan karena benar-benar tidak ada nilainya. Keterbatasan data seperti ini harus dikatakan terus terang saat melaporkan.
Latihan
- Dari array
np.array([480, 500, 510, 520, 530]), hitung bobot rata-rata dan pilih yang berbobot di atas 505 dengan topeng. - Buat DataFrame ikan dengan kolom
kolam,jenis,jumlah,bobot_rata_g, lalu hitung biomassa tiap baris (jumlah * bobot_rata_g / 1000) sebagai kolom baru. - Di
06_agregasi.py, tambahkan agregasi jumlah pohon dan diameter terkecil per jenis. - Tantangan: di
08_proyek_gabung.py, hitung pendapatan rata-rata per sektor hanya dari baris yang punya harga, dan hitung berapa persen baris yang tidak punya harga.
Ringkasan Bab
- numpy array: isi satu jenis, operasi sekaligus tanpa
for;axis=0per kolom,axis=1per baris. - DataFrame = tabel berlabel; satu kolom = Series.
head,describe,dtypes,shapeuntuk mengenalinya. - Baca/tulis:
read_csv,read_excel,to_json, dan kawan-kawan;index=Falseuntuk menghindari kolom nomor. - Saring dengan syarat (
&,|,~, masing-masing berkurung) atauquery; urutkan dengansort_values. groupby+aggmeringkas per kelompok;mergemenyambung tabel; waspadaiNaNsetelah penggabungan.- Pustaka bisa berbeda bawaan (simpangan baku numpy vs pandas).
Selanjutnya, di Bab 24: data gabungan itu hilang begitu program ditutup. Kita simpan di basis data: SQLite, SQLAlchemy, dan PostgreSQL.