Bab 61 — Transformer dan AI Generatif: Mengintip Isi Mesin Bahasa
Seri A4 — AI Generatif dan Agent AI
Semua skrip bab ini ada di folder kode/bab61/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Di Bab 60, model bahasa kita kotak hitam: pertanyaan masuk, jawaban keluar. Sekarang kita buka tutupnya. Bayangkan seorang mandor membaca kalimat “Pohon jati itu tinggi”. Untuk paham kata “itu”, ia menoleh ke kata “jati”; untuk paham “tinggi”, ia melihat kata “pohon”. Setiap kata dipahami dengan melirik kata-kata lain. Itulah ide inti transformer, arsitektur di balik hampir semua model bahasa besar masa kini.
Seperti Bab 60, bab ini jujur soal batas komputer penulis: GPU GTX 1660 SUPER 6 GB. Model besar (7B parameter dan lebih), model difusi, dan model multimodal tidak dijalankan di sini; kita membahasnya dari dokumentasi dan hitungan. Yang dijalankan adalah model uji kecil buatan sendiri dengan bobot acak (39.168 parameter). Model itu tidak pintar dan tidak menghasilkan kalimat bermakna; ia ada agar mekanismenya (memuat, melatih LoRA, menyimpan adapter, kuantisasi 4-bit) bisa dibuktikan dengan keluaran asli.
Attention: tiap kata melirik kata lain
Cara kerjanya, dari tiap kata dibuat tiga vektor: Query (apa yang sedang saya cari), Key (apa yang saya tawarkan), dan Value (isi yang saya bawa). Kecocokan Query satu kata dengan Key kata lain menjadi skor; skor diubah menjadi persentase dengan softmax (jumlahnya 1); lalu Value dicampur sesuai persentase itu. Rumus ringkasnya, dari makalah “Attention Is All You Need” (Vaswani dkk., Juni 2017, arXiv:1706.03762): softmax(Q·Kᵀ / √d) · V.
01_attention_numpy.py
# Bab 61 - Attention dari nol dengan numpy
import numpy as np

rng = np.random.default_rng(42)
kata = ["pohon", "jati", "itu", "tinggi"]
d = 4                                     # panjang vektor tiap kata (dimensi)
X = rng.normal(size=(len(kata), d))       # embedding tiap kata (acak, hanya untuk demo)

# Tiga matriks bobot: dari tiap kata dibuat Query (apa yang dicari), Key (apa yang ditawarkan), Value (isinya)
Wq, Wk, Wv = (rng.normal(size=(d, d)) for _ in range(3))
Q, K, V = X @ Wq, X @ Wk, X @ Wv


def softmax(a):
    e = np.exp(a - a.max(axis=-1, keepdims=True))
    return e / e.sum(axis=-1, keepdims=True)


skor = Q @ K.T / np.sqrt(d)               # seberapa cocok tiap Query dengan tiap Key
bobot = softmax(skor)                     # jadikan persentase (tiap baris berjumlah 1)
hasil = bobot @ V                         # campur Value sesuai bobot

print("Bobot attention (baris = kata yang bertanya):")
for nama, baris in zip(kata, bobot):
    print(f"  {nama:<7}", np.round(baris, 2))
print("Tiap baris berjumlah 1:", np.allclose(bobot.sum(axis=1), 1))
print("Bentuk hasil:", hasil.shape)

# Model pembuat teks tidak boleh mengintip kata di depan: tutup bagian atas segitiga dengan masker
masker = np.triu(np.ones((len(kata), len(kata)), dtype=bool), k=1)
bobot_kausal = softmax(np.where(masker, -np.inf, skor))
print("\nDengan masker kausal:")
for nama, baris in zip(kata, bobot_kausal):
    print(f"  {nama:<7}", np.round(baris, 2))
Bobot attention (baris = kata yang bertanya):
pohon [0.46 0.19 0.33 0.02]
jati [0.01 0.61 0.02 0.36]
itu [0.43 0.21 0.33 0.04]
tinggi [0.1 0.02 0.09 0.79]
Tiap baris berjumlah 1: True
Bentuk hasil: (4, 4)
Dengan masker kausal:
pohon [1. 0. 0. 0.]
jati [0.01 0.99 0. 0. ]
itu [0.45 0.21 0.34 0. ]
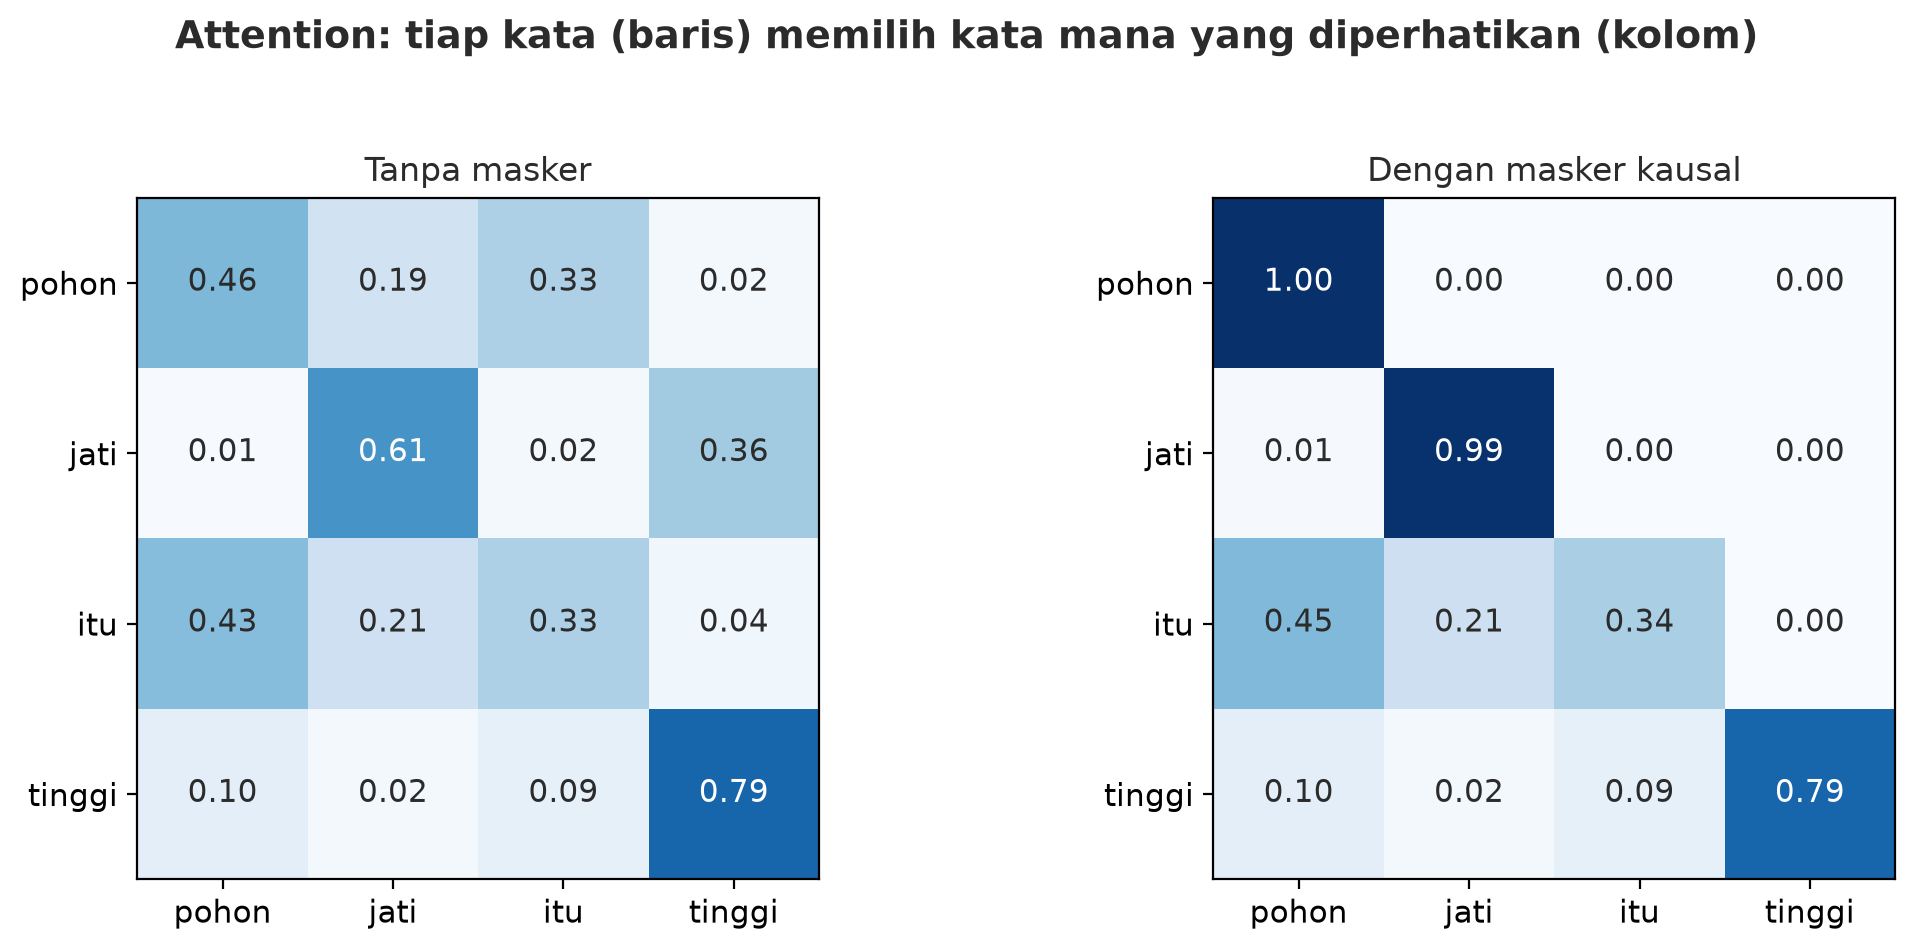
tinggi [0.1 0.02 0.09 0.79]Telusuri hasilnya. Tiap baris adalah satu kata yang “bertanya”, tiap kolom kata yang dilirik, dan tiap baris berjumlah 1 (terbukti True). Baris tinggi memberi 0,79 pada dirinya sendiri; baris jati memberi 0,61 pada dirinya dan 0,36 pada tinggi. Karena embedding dan bobotnya acak, angka-angka ini tidak bermakna bahasa; yang penting adalah mekanismenya. Pada model terlatih, bobot-bobot ini belajar menyorot hubungan yang berguna.
Bagian bawah keluaran memakai masker kausal: model pembuat teks tidak boleh mengintip kata yang belum ditulis. Skor di segitiga atas diganti -inf sehingga setelah softmax menjadi 0. Lihat baris pohon: ia hanya boleh melirik dirinya (1,00). Baris tinggi (kata terakhir) tidak berubah karena ia memang boleh melihat semuanya.
PyTorch sudah menyediakan fungsi yang sama, dan model nyata memakai banyak kepala (multi-head): beberapa attention paralel dengan bobot berbeda, lalu hasilnya digabung.
02_attention_torch.py
# Bab 61 - Attention di PyTorch: ditulis sendiri vs fungsi bawaan, dengan banyak kepala
import math

from pustaka import senyap  # noqa: F401
import torch
import torch.nn.functional as F

torch.manual_seed(0)
perangkat = "cuda" if torch.cuda.is_available() else "cpu"
batch, kepala, panjang, dim = 2, 4, 6, 8       # 2 kalimat, 4 kepala attention, 6 token, 8 dimensi per kepala

q, k, v = (torch.randn(batch, kepala, panjang, dim, device=perangkat) for _ in range(3))


def attention_manual(q, k, v):
    skor = q @ k.transpose(-2, -1) / math.sqrt(q.shape[-1])
    masker = torch.triu(torch.ones(q.shape[-2], k.shape[-2], dtype=torch.bool, device=q.device), diagonal=1)
    skor = skor.masked_fill(masker, float("-inf"))
    return torch.softmax(skor, dim=-1) @ v


buatan_sendiri = attention_manual(q, k, v)
bawaan = F.scaled_dot_product_attention(q, k, v, is_causal=True)

print("Bentuk keluaran:", tuple(bawaan.shape))
print("Hasil sama dengan fungsi bawaan PyTorch:", torch.allclose(buatan_sendiri, bawaan, atol=1e-5))
print("Berjalan di GPU:", perangkat == "cuda", "(di komputer tanpa GPU NVIDIA, bernilai False dan tetap benar)")

# Banyak kepala = banyak "sudut pandang" sekaligus; kepala digabung kembali menjadi satu vektor
gabungan = bawaan.transpose(1, 2).reshape(batch, panjang, kepala * dim)
print("Setelah kepala digabung:", tuple(gabungan.shape))
Bentuk keluaran: (2, 4, 6, 8)
Hasil sama dengan fungsi bawaan PyTorch: True
Berjalan di GPU: True (di komputer tanpa GPU NVIDIA, bernilai False dan tetap benar)
Setelah kepala digabung: (2, 6, 32)Fungsi tulisan tangan dan F.scaled_dot_product_attention memberi hasil yang sama (True, dengan toleransi 1e-5 karena bilangan desimal). Bentuk (2, 4, 6, 8) artinya 2 kalimat, 4 kepala, 6 token, 8 dimensi per kepala; setelah digabung menjadi (2, 6, 32) (4 kepala x 8 dimensi). Baris “Berjalan di GPU: True” menunjukkan perhitungan memang dikerjakan GTX 1660 SUPER milik penulis; di komputer tanpa GPU NVIDIA nilainya False dan hasilnya tetap benar. Sebuah transformer penuh menumpuk puluhan blok attention seperti ini, masing-masing diselingi lapisan jaringan saraf biasa.
Tokenisasi: teks dipotong menjadi token
Model tidak membaca huruf atau kata, tetapi token: potongan teks yang kadang satu kata, kadang sepotong kata. BPE (byte-pair encoding) membuat kamus potongan dengan menggabungkan pasangan huruf yang sering berdampingan. Kamus (kosakata) dilatih dari teks yang besar.
Model uji kita punya tokenizer BPE mungil yang dilatih dari 10 kalimat SOP (lihat kode/bab61/pustaka/model_uji.py; kosakatanya hanya 300 token).
03_tokenisasi.py
# Bab 61 - Tokenisasi: teks dipecah menjadi token
from pustaka.model_uji import muat

tokenizer, _ = muat()          # tokenizer BPE kecil yang dilatih dari teks SOP (lihat pustaka/model_uji.py)

print("Ukuran kosakata:", tokenizer.vocab_size)

for teks in ["Hutan jati", "Hutan jati tumbuh subur di plot A", "pohon"]:
    token = tokenizer.tokenize(teks)
    nomor = tokenizer(teks)["input_ids"]
    print(f"\n{teks!r}")
    print("  token :", token)
    print("  nomor :", nomor)
    print("  kembali ke teks:", tokenizer.decode(nomor) == teks)

print("\nJumlah token per kalimat (kalimat yang sama, makin panjang, makin banyak):")
for teks in ["jati", "jati tumbuh", "jati tumbuh subur", "jati tumbuh subur di plot A"]:
    print(f"  {len(tokenizer(teks)['input_ids']):>2} token  <-  {teks}")
Ukuran kosakata: 300
'Hutan jati'
token : ['H', 'u', 'tan', 'Ġjati']
nomor : [42, 87, 287, 292]
kembali ke teks: True
'Hutan jati tumbuh subur di plot A'
token : ['H', 'u', 'tan', 'Ġjati', 'Ġ', 't', 'u', 'm', 'b', 'u', 'h', 'Ġs', 'u', 'b', 'u', 'r', 'Ġdi', 'Ġp', 'l', 'ot', 'Ġ', 'A']
nomor : [42, 87, 287, 292, 223, 86, 87, 79, 68, 87, 74, 264, 87, 68, 87, 84, 261, 276, 78, 285, 223, 35]
kembali ke teks: True
'pohon'
token : ['p', 'o', 'h', 'on']
nomor : [82, 81, 74, 284]
kembali ke teks: True
Jumlah token per kalimat (kalimat yang sama, makin panjang, makin banyak):
2 token <- jati
9 token <- jati tumbuh
14 token <- jati tumbuh subur
20 token <- jati tumbuh subur di plot A“Hutan jati” menjadi 4 token: H, u, tan, dan Ġjati. Huruf Ġ adalah cara tokenizer menulis spasi di depan kata, sehingga jati (dengan spasi) berbeda dari jati. Kata “jati” muncul beberapa kali di teks latih sehingga menjadi satu token utuh; kata “tumbuh” dan “subur” hanya muncul sekali dan kosakatanya cuma 300 token, jadi keduanya pecah menjadi huruf-huruf (t, u, m, b, u, h). Itu sifat penting: kata yang jarang terpecah menjadi banyak token. Tabel di bagian bawah menunjukkan “jati tumbuh subur di plot A” memakai 20 token. Pada tokenizer sungguhan, kata umum bahasa Indonesia lebih sering utuh, tetapi tetap ada kata (nama, istilah teknis, bahasa daerah) yang terpecah. Itu penting karena biaya API dan batas panjang diukur dalam token, bukan kata (lihat hitungan biaya di Bab 60).
Embedding: token menjadi vektor
Tiap nomor token punya satu baris dalam tabel embedding: sebuah vektor berisi angka yang dipelajari. Selain itu ada tabel embedding posisi, supaya model tahu urutan (tanpa itu, “sapi makan rumput” dan “rumput makan sapi” tampak sama).
04_embedding.py
# Bab 61 - Embedding: kata menjadi vektor, kemiripan menjadi sudut
import numpy as np

from pustaka.model_uji import muat

# 1) Embedding buatan tangan, 3 dimensi: [tanaman, hewan, air]. Angkanya karangan penulis untuk belajar.
kata = {
    "jati":  np.array([0.9, 0.0, 0.1]),
    "padi":  np.array([0.8, 0.0, 0.5]),
    "sapi":  np.array([0.1, 0.9, 0.2]),
    "kambing": np.array([0.1, 0.8, 0.1]),
    "nila":  np.array([0.0, 0.3, 0.9]),
}


def kosinus(a, b):
    return float(a @ b / (np.linalg.norm(a) * np.linalg.norm(b)))


pasangan = [("jati", "padi"), ("sapi", "kambing"), ("jati", "sapi"), ("padi", "nila")]
for a, b in pasangan:
    print(f"kemiripan {a:<8}-{b:<8}: {kosinus(kata[a], kata[b]):.2f}")

# 2) Tabel embedding sungguhan di model uji (isinya acak, jadi hanya bentuknya yang bermakna)
_, model = muat()
tabel_kata = model.get_input_embeddings().weight
tabel_posisi = model.transformer.wpe.weight
print("\nTabel embedding kata    :", tuple(tabel_kata.shape), "(kosakata x dimensi)")
print("Tabel embedding posisi  :", tuple(tabel_posisi.shape), "(posisi maksimum x dimensi)")
print("Vektor token nomor 40   :", tuple(tabel_kata[40].shape), "-> satu baris tabel")
kemiripan jati -padi : 0.90
kemiripan sapi -kambing : 1.00
kemiripan jati -sapi : 0.13
kemiripan padi -nila : 0.50
Tabel embedding kata : (300, 32) (kosakata x dimensi)
Tabel embedding posisi : (128, 32) (posisi maksimum x dimensi)
Vektor token nomor 40 : (32,) -> satu baris tabelBagian pertama memakai embedding buatan tangan tiga dimensi [tanaman, hewan, air] untuk memperlihatkan arti “dekat”: kemiripan kosinus jati-padi 0,90 (sama-sama tanaman), sapi-kambing 1,00, jati-sapi hanya 0,13. Angka-angkanya karangan penulis untuk belajar. Bagian kedua menunjukkan tabel sungguhan di model uji: 300 baris (kosakata) x 32 dimensi, dan 128 posisi x 32 dimensi. Isinya acak, jadi hanya bentuknya yang bermakna. Pada model terlatih, embedding itulah yang dipakai juga untuk pencarian dokumen seperti di Bab 60.
Memuat model terbuka
Hugging Face Hub adalah gudang model terbuka; pustaka transformers memuatnya dengan from_pretrained. Cara memuat model dari Hub sama persis dengan cara memuat dari folder lokal:
# Contoh bentuk pemanggilan (tidak dijalankan di bab ini)
from transformers import AutoModelForCausalLM, AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained("nama-organisasi/nama-model")
model = AutoModelForCausalLM.from_pretrained("nama-organisasi/nama-model")
Kode di atas tidak dijalankan saat buku dibuat karena mengunduh bobot model dari internet (dan model nyata biasanya jauh di atas batas 50 MB yang kita tetapkan), jadi keluarannya tidak ditampilkan. Yang kita jalankan adalah model uji lokal, dimuat dengan from_pretrained yang sama.
Cerita jujur dari penulisan bab ini. Awalnya penulis mengunduh model uji acak hf-internal-testing/tiny-random-gpt2 (sekitar 0,45 MB). Saat meninjau lisensi (Bab 63), ternyata halaman model itu tidak mencantumkan lisensi. Karena belum jelas boleh tidaknya dibagikan ulang, model itu dibuang dan diganti model buatan sendiri dari konfigurasi. Selalu periksa lisensi model sebelum memakainya, apalagi sebelum membagikannya.
05_model_terbuka.py
# Bab 61 - Memuat dan menjalankan model terbuka (model uji acak yang sangat kecil)
from pustaka import senyap  # noqa: F401
import torch

from pustaka.model_uji import muat

tokenizer, model = muat()      # dimuat dengan from_pretrained dari folder lokal, sama seperti dari Hugging Face Hub
model.eval()

jumlah = sum(p.numel() for p in model.parameters())
print("Jumlah parameter:", f"{jumlah:,}".replace(",", "."))
print("Lapisan transformer:", model.config.n_layer, "| kepala attention:", model.config.n_head,
      "| dimensi:", model.config.n_embd)

masukan = tokenizer("Hutan jati", return_tensors="pt")
with torch.no_grad():
    keluar = model.generate(**masukan, max_new_tokens=8, do_sample=False, pad_token_id=tokenizer.eos_token_id)
print("\nToken hasil (greedy, 8 token baru):",tokenizer.convert_ids_to_tokens(keluar[0]))

with torch.no_grad():
    ulang = model.generate(**masukan, max_new_tokens=8, do_sample=False, pad_token_id=tokenizer.eos_token_id)
print("Diulang, sama persis:", torch.equal(keluar, ulang))
print("Bermakna?  Tidak: bobot model ini acak, jadi hasilnya hanya deretan token tanpa arti.")
Jumlah parameter: 39.168
Lapisan transformer: 2 | kepala attention: 4 | dimensi: 32
Token hasil (greedy, 8 token baru): ['H', 'u', 'tan', 'Ġjati', 'Ġjati', 'Ġjati', 'Ġjati', 'Ġjati', 'Ġjati', 'Ġjati', 'Ġjati', 'Ġjati']
Diulang, sama persis: True
Bermakna? Tidak: bobot model ini acak, jadi hasilnya hanya deretan token tanpa arti.Model uji punya 39.168 parameter, 2 lapisan transformer, 4 kepala attention, dan 32 dimensi. Bandingkan dengan model bahasa sungguhan yang berukuran miliaran parameter. Hasil generate dengan greedy (selalu pilih token berpeluang tertinggi) menghasilkan “Hutan jati” lalu mengulang Ġjati terus-menerus: ciri khas model acak yang tidak terlatih. Diulang, hasilnya sama persis (True), karena greedy tidak memakai angka acak. Model ini tidak bermakna dan memang tidak dimaksudkan begitu.
VRAM: muat atau tidak muat?
Di Bab 55 Anda belajar bahwa kecepatan AI bergantung pada GPU dan VRAM (memori GPU). Di sini kita menghitungnya. Aturan dasarnya:
memori bobot = jumlah parameter x byte per parameter
Byte per parameter: fp32 = 4, fp16/bf16 = 2, int8 = 1, int4 = 0,5. Untuk inferensi (memakai model), kita tambah kira-kira 20% untuk cache attention dan aktivasi; angka 20% ini asumsi penulis, bukan hukum, dan bisa jauh lebih besar pada teks yang panjang.
06_vram.py
# Bab 61 - Menghitung kebutuhan VRAM dengan aritmetika
from pustaka.model_uji import muat

GIB = 1024 ** 3
BYTE_PER_PARAMETER = {"fp32": 4, "fp16/bf16": 2, "int8": 1, "int4": 0.5}
VRAM_PENULIS_GIB = 6                      # GTX 1660 SUPER: 6 GB


def bobot_gib(miliar_parameter, byte_per_parameter):
    """Rumus: memori bobot = jumlah parameter x byte per parameter."""
    return miliar_parameter * 1e9 * byte_per_parameter / GIB


def inferensi_gib(miliar_parameter, byte_per_parameter, tambahan=0.20):
    """Perkiraan kasar: bobot + 20% untuk cache attention dan aktivasi (angka tambahan = asumsi penulis)."""
    return bobot_gib(miliar_parameter, byte_per_parameter) * (1 + tambahan)


def latih_penuh_gib(miliar_parameter):
    """Latih penuh, campuran fp16 + optimizer Adam: kira-kira 16 byte per parameter (lihat teks bab)."""
    return miliar_parameter * 1e9 * 16 / GIB


print(f"Inferensi (bobot + 20%), VRAM penulis = {VRAM_PENULIS_GIB} GiB")
print(f"{'model':>6} " + " ".join(f"{k:>10}" for k in BYTE_PER_PARAMETER))
for n in [1, 3, 7, 13, 70]:
    sel = []
    for b in BYTE_PER_PARAMETER.values():
        gib = inferensi_gib(n, b)
        sel.append(f"{gib:>6.1f}{'  ya' if gib <= VRAM_PENULIS_GIB else ' tdk'}")
    print(f"{n:>5}B " + " ".join(sel))

print("\nLatih penuh model 1B   :", f"{latih_penuh_gib(1):.1f} GiB", "-> tidak muat di 6 GiB")
print("Latih penuh model 7B   :", f"{latih_penuh_gib(7):.1f} GiB")

# Cek rumus pada model nyata (model uji kecil): bobot fp32 = parameter x 4 byte
_, model = muat()
jumlah = sum(p.numel() for p in model.parameters())
print("\nModel uji:", jumlah, "parameter x 4 byte =", jumlah * 4, "byte")
print("Dilaporkan PyTorch  :", model.get_memory_footprint(), "byte")
print("Rumus cocok:", jumlah * 4 == model.get_memory_footprint())
Inferensi (bobot + 20%), VRAM penulis = 6 GiB
model fp32 fp16/bf16 int8 int4
1B 4.5 ya 2.2 ya 1.1 ya 0.6 ya
3B 13.4 tdk 6.7 tdk 3.4 ya 1.7 ya
7B 31.3 tdk 15.6 tdk 7.8 tdk 3.9 ya
13B 58.1 tdk 29.1 tdk 14.5 tdk 7.3 tdk
70B 312.9 tdk 156.5 tdk 78.2 tdk 39.1 tdk
Latih penuh model 1B : 14.9 GiB -> tidak muat di 6 GiB
Latih penuh model 7B : 104.3 GiB
Model uji: 39168 parameter x 4 byte = 156672 byte
Dilaporkan PyTorch : 156672 byte
Rumus cocok: True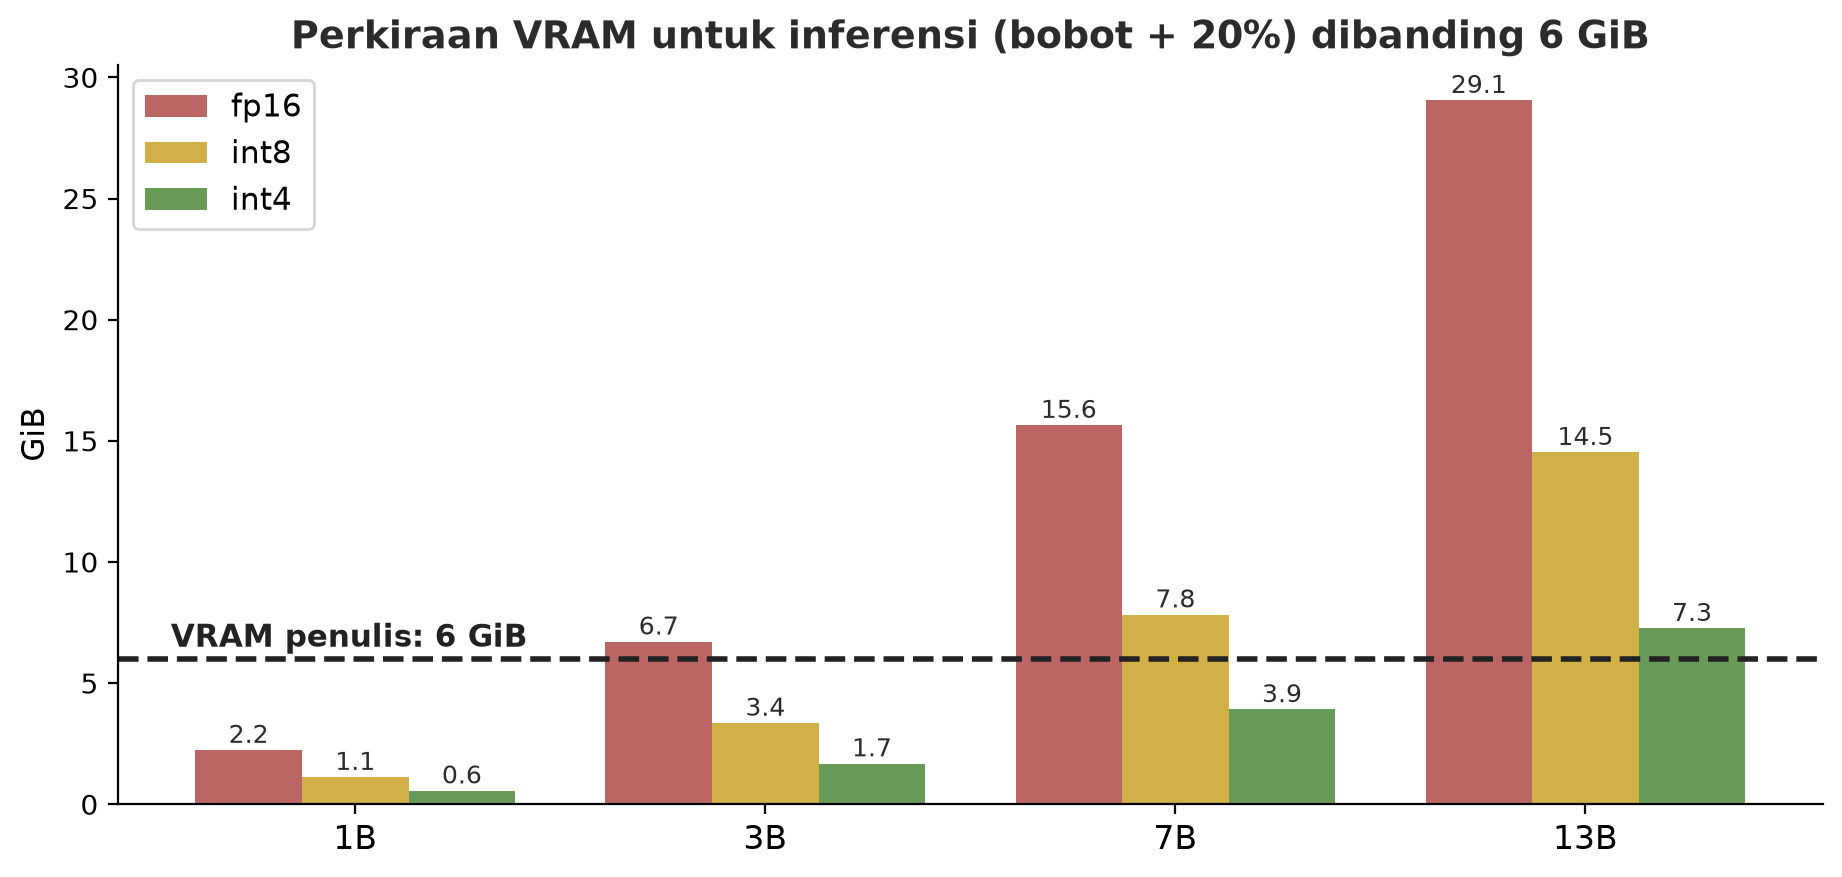
Cara membaca tabel (GPU penulis 6 GiB): model 1B muat di semua presisi; model 3B muat bila dikuantisasi ke int8 (3,4 GiB) atau int4 (1,7 GiB) tetapi tidak dalam fp16 (6,7 GiB, sedikit di atas 6); model 7B hanya muat dalam int4 (3,9 GiB), sedangkan int8 butuh 7,8 GiB. Model 13B tidak muat di presisi apa pun yang kita hitung, bahkan int4 (7,3 GiB). Jadi dengan GPU ini, model 7B 4-bit adalah batas atas yang realistis, dan itu hitungan, bukan hasil percobaan: model 7B tidak dijalankan di sini.
Melatih jauh lebih rakus daripada memakai. Pada pelatihan penuh dengan campuran presisi dan optimizer Adam, kira-kira dibutuhkan 2 byte (bobot fp16) + 2 (gradien) + 4 (salinan bobot fp32) + 4 + 4 (dua statistik Adam) = 16 byte per parameter. Penjabaran ini hitungan penulis dari komponennya (belum diverifikasi ke dokumentasi tertentu), tetapi dipakai luas sebagai aturan praktis. Hasilnya: melatih model 1B penuh butuh sekitar 14,9 GiB, jauh di atas 6 GiB, dan model 7B sekitar 104,3 GiB. Karena itu pelatihan penuh model besar tidak mungkin di komputer penulis, dan kita memakai LoRA.
Baris terakhir keluaran memeriksa rumus pada model nyata kita: 39.168 parameter x 4 byte = 156.672 byte, sama persis dengan yang dilaporkan PyTorch (True).
LoRA: melatih sedikit, hasilnya terasa
LoRA (Low-Rank Adaptation; Hu dkk., Juni 2021, arXiv:2106.09685) membekukan bobot asli dan hanya melatih dua matriks kecil per lapisan yang hasil kalinya seukuran matriks asli. Ukuran matriks kecil itu ditentukan rank r; makin kecil r, makin sedikit parameter yang dilatih (dokumentasi peft). Setelah dilatih, adapter bisa digabung ke model asli dengan merge_and_unload() sehingga tidak ada lapisan tambahan saat dipakai.
07_lora_peft.py
# Bab 61 - LoRA: melatih sebagian kecil parameter dengan pustaka peft (di GPU bila ada)
from pustaka import senyap  # noqa: F401
import torch
from peft import LoraConfig, get_peft_model

from pustaka.model_uji import muat

# 1) Hitung penghematan: satu matriks bobot 4096 x 4096 vs dua matriks LoRA berpangkat (rank) 8
d, r = 4096, 8
penuh, lora = d * d, d * r + r * d
print(f"Satu matriks {d}x{d}: {penuh:,} parameter; LoRA r={r}: {lora:,} ({100 * lora / penuh:.2f}%)")

# 2) LoRA pada model uji
torch.manual_seed(0)
perangkat = "cuda" if torch.cuda.is_available() else "cpu"
tokenizer, dasar = muat()
konfigurasi = LoraConfig(r=4, lora_alpha=8, target_modules=["c_attn"], fan_in_fan_out=True, task_type="CAUSAL_LM")
model = get_peft_model(dasar, konfigurasi).to(perangkat)
dilatih = sum(p.numel() for p in model.parameters() if p.requires_grad)
semua = sum(p.numel() for p in model.parameters())
print(f"Parameter dilatih: {dilatih:,} dari {semua:,} ({100 * dilatih / semua:.1f}%)")

teks = tokenizer("hutan jati tumbuh subur di plot a", return_tensors="pt").to(perangkat)
pengoptimal = torch.optim.AdamW([p for p in model.parameters() if p.requires_grad], lr=1e-2)
awal = model(**teks, labels=teks["input_ids"]).loss.item()
for _ in range(40):
    kerugian = model(**teks, labels=teks["input_ids"]).loss
    kerugian.backward()
    pengoptimal.step()
    pengoptimal.zero_grad()
akhir = model(**teks, labels=teks["input_ids"]).loss.item()
print("Kerugian (loss) turun setelah 40 langkah:", akhir < awal)

# 3) Gabungkan adapter ke model dasar: hasilnya setara, tanpa tambahan lapisan saat dipakai
model.eval()
with torch.no_grad():
    sebelum = model(**teks).logits
    gabung = model.merge_and_unload()
    sesudah = gabung(**teks).logits
print("Setelah digabung, keluaran sama:", torch.allclose(sebelum, sesudah, atol=1e-4))
Satu matriks 4096x4096: 16,777,216 parameter; LoRA r=8: 65,536 (0.39%)
Parameter dilatih: 1,024 dari 40,192 (2.5%)
Kerugian (loss) turun setelah 40 langkah: True
Setelah digabung, keluaran sama: TrueBagian pertama: satu matriks 4096 x 4096 punya 16.777.216 parameter, sedangkan LoRA dengan r=8 hanya 65.536, yaitu 0,39%. Bagian kedua pada model uji: 1.024 parameter dilatih dari total 40.192 (2,5%), dan kerugian (loss, ukuran kesalahan; makin kecil makin baik) turun setelah 40 langkah (True), dilakukan di GPU. Bagian ketiga membuktikan penggabungan adapter tidak mengubah keluaran (True).
Kuantisasi dan QLoRA
Kuantisasi menyimpan bobot dengan bit lebih sedikit, misalnya dari 32 bit menjadi 8 atau 4 bit. Harganya sedikit ketelitian.
08_kuantisasi.py
# Bab 61 - Kuantisasi: menyimpan bobot dengan lebih sedikit bit
import numpy as np

from pustaka.model_uji import FOLDER, muat

# 1) Kuantisasi int8 "absmax" buatan sendiri pada satu matriks bobot
rng = np.random.default_rng(42)
bobot = rng.normal(0, 0.05, size=(256, 256)).astype("float32")
skala = np.abs(bobot).max() / 127                 # 127 = nilai int8 terbesar
kuantum = np.round(bobot / skala).astype("int8")  # simpan sebagai bilangan bulat -127..127
pulih = kuantum.astype("float32") * skala         # dikembalikan saat dipakai
print("Ukuran float32:", bobot.nbytes, "byte | int8:", kuantum.nbytes, "byte (4x lebih kecil)")
print("Rata-rata selisih mutlak:", f"{np.abs(bobot - pulih).mean():.5f}", "(bobot bernilai sekitar 0,05)")

# 2) Pemuatan 4-bit (NF4) lewat bitsandbytes, dicoba pada model uji
try:
    import torch
    from transformers import AutoModelForCausalLM, BitsAndBytesConfig

    _, asli = muat()
    konfigurasi = BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_quant_type="nf4",
                                     bnb_4bit_compute_dtype=torch.float16)
    ringkas = AutoModelForCausalLM.from_pretrained(FOLDER, quantization_config=konfigurasi, device_map={"": 0})
    print("\nModel uji float32:", asli.get_memory_footprint(), "byte")
    print("Model uji 4-bit  :", ringkas.get_memory_footprint(), "byte")
except Exception as galat:
    print("\n4-bit tidak bisa dicoba di komputer ini:", type(galat).__name__)
Ukuran float32: 262144 byte | int8: 65536 byte (4x lebih kecil)
Rata-rata selisih mutlak: 0.00049 (bobot bernilai sekitar 0,05)
Model uji float32: 156672 byte
Model uji 4-bit : 70656 byteDi bagian pertama kita membuat kuantisasi int8 absmax sendiri: nilai dibagi skala = nilai mutlak terbesar / 127, dibulatkan, lalu disimpan sebagai bilangan bulat. Ukuran turun dari 262.144 menjadi 65.536 byte (4 kali lebih kecil), dengan selisih rata-rata hanya 0,00049 untuk bobot yang bernilai sekitar 0,05.
Bagian kedua memakai bitsandbytes: model uji dimuat dalam 4-bit (format NF4) dan memorinya turun dari 156.672 menjadi 70.656 byte. Penghematannya tidak 8 kali karena pada model sekecil ini sebagian bagian (kemungkinan tabel embedding dan lapisan normalisasi) tidak ikut dikuantisasi; rincian itu belum diperiksa penulis. Yang terbukti: pemuatan 4-bit berjalan di Windows dengan GTX 1660 SUPER. Dokumentasi bitsandbytes (dibaca 2026-10-10) menyatakan NF4/FP4 butuh compute capability 6.0 ke atas, LLM.int8() butuh 7.5 ke atas, dan menyediakan paket untuk Windows x86-64. QLoRA (Dettmers dkk., Mei 2023, arXiv:2305.14314) menggabungkan keduanya: model dasar dibekukan dalam 4-bit dan LoRA dilatih di atasnya; makalahnya melaporkan fine-tuning model 65B di satu GPU 48 GB. Menerapkan QLoRA pada model 7B di GPU 6 GB tidak kita coba di sini; hitungan VRAM menunjukkan bobotnya (3,9 GiB) mungkin muat, tetapi pelatihannya butuh memori tambahan untuk aktivasi, sehingga hasilnya harus diuji sendiri.
Model difusi dan multimodal (hanya dokumentasi)
Model difusi membuat citra dengan membalik proses pengotoran. Makalah DDPM (Ho dkk., Juni 2020, arXiv:2006.11239) menunjukkan citra bisa dihasilkan dengan mempelajari cara membuang derau sedikit demi sedikit. Kita tidak melatih model difusi (butuh GPU kuat dan data besar), tetapi bisa memeragakan proses majunya dengan numpy.
09_difusi_maju.py
# Bab 61 - Difusi: proses "mengotori" citra dengan derau, langkah demi langkah
import numpy as np

rng = np.random.default_rng(42)

# "Citra" kecil 8 x 8: gradien dari gelap ke terang, nilai -1..1 (mirip petak lahan yang makin subur ke kanan)
x0 = np.tile(np.linspace(-1, 1, 8), (8, 1))

T = 1000
beta = np.linspace(1e-4, 0.02, T)          # jadwal derau linear seperti pada makalah DDPM (Ho dkk., 2020)
alfa_bar = np.cumprod(1 - beta)           # berapa bagian citra asli yang masih tersisa setelah t langkah

print(f"{'langkah t':>9} {'bobot citra':>12} {'bobot derau':>12} {'korelasi dgn asli':>18}")
for t in [0, 100, 250, 500, 750, 999]:
    epsilon = rng.normal(size=x0.shape)
    xt = np.sqrt(alfa_bar[t]) * x0 + np.sqrt(1 - alfa_bar[t]) * epsilon     # satu rumus, loncat langsung ke langkah t
    korelasi = np.corrcoef(x0.ravel(), xt.ravel())[0, 1]
    print(f"{t:>9} {np.sqrt(alfa_bar[t]):>12.3f} {np.sqrt(1 - alfa_bar[t]):>12.3f} {korelasi:>18.2f}")

print("\nModel difusi dilatih untuk menebak derau epsilon dari xt, lalu menghilangkannya sedikit demi sedikit.")
print("Pembuatan citra = mulai dari derau murni (t=999) dan memutar proses ini mundur.")
langkah t bobot citra bobot derau korelasi dgn asli
0 1.000 0.010 1.00
100 0.946 0.324 0.93
250 0.722 0.692 0.51
500 0.279 0.960 -0.03
750 0.057 0.998 -0.05
999 0.006 1.000 -0.04
Model difusi dilatih untuk menebak derau epsilon dari xt, lalu menghilangkannya sedikit demi sedikit.
Pembuatan citra = mulai dari derau murni (t=999) dan memutar proses ini mundur.Citra 8 x 8 (gradien gelap ke terang) dikotori dengan rumus satu langkah x_t = akar(ᾱ_t)·x_0 + akar(1-ᾱ_t)·derau, dengan jadwal derau linear dari makalah DDPM. Lihat kolom korelasi dengan citra asli: 0,93 di langkah 100, 0,51 di langkah 250, dan nyaris 0 (di sekitar -0,03 sampai -0,05) di langkah 500 ke atas. Artinya pada langkah ke-500 dan seterusnya citra praktis sudah tenggelam dalam derau. Model difusi dilatih menebak deraunya; membuat citra berarti memulai dari derau murni dan memutar proses ke belakang. Karena dilatih dari banyak gambar, soal hak cipta data latih ikut muncul (lihat Bab 63). Foto dan gambar buatan AI tidak dipakai di buku ini.
Model multimodal menerima lebih dari satu jenis masukan (teks dan citra, misalnya “ada berapa pohon di foto ini?”). Idenya: citra dipotong menjadi petak, tiap petak diubah menjadi vektor mirip token, lalu transformer yang sama memprosesnya bersama teks. Kami tidak menjalankan model multimodal di sini; untuk memakainya baca dokumentasi model pilihan Anda, perhatikan syarat lisensi, dan hitung kebutuhan VRAM dengan rumus di atas.
Menjalankan model lokal, dan batasannya
Menjalankan model di komputer sendiri berarti data tidak keluar dari komputer, tidak ada tagihan per token, dan bisa bekerja tanpa internet. Imbalannya: Anda yang menanggung VRAM, kecepatan, dan pemeliharaan. Urutan praktisnya: (1) hitung VRAM dengan rumus di atas; (2) pilih ukuran dan presisi yang muat; (3) uji dulu pada contoh kecil; (4) ukur mutu pada pertanyaan Anda sendiri dengan cara Bab 60. Model yang sangat kecil bisa dijalankan di CPU, tetapi lambat.
Sekarang batasan terpenting: model hanya memilih token berikutnya berdasarkan peluang. Skrip berikut memeragakannya dengan skor karangan penulis untuk lanjutan kalimat “Jarak tanam jati: …”.
10_sampling_halusinasi.py
# Bab 61 - Mengapa model bisa mengarang: memilih kata berikutnya berdasarkan peluang
import numpy as np

pilihan = ["3 x 3 m", "2 x 2 m", "4 x 4 m", "5 x 5 m", "bunga mawar"]
logit = np.array([3.0, 1.5, 1.0, 0.3, -2.0])      # skor mentah karangan penulis untuk "Jarak tanam jati: ..."


def peluang(logit, suhu):
    z = logit / suhu
    e = np.exp(z - z.max())
    return e / e.sum()


for suhu in [0.2, 1.0, 2.0]:
    p = peluang(logit, suhu)
    print(f"suhu={suhu}: " + "  ".join(f"{nama}={nilai:.2f}" for nama, nilai in zip(pilihan, p)))

rng = np.random.default_rng(42)
print("\nMenarik 1000 kali pada suhu 1.0:")
tarikan = rng.choice(len(pilihan), size=1000, p=peluang(logit, 1.0))
for i, nama in enumerate(pilihan):
    print(f"  {nama:<12} {int((tarikan == i).sum()):>4}")

# top-k: hanya boleh memilih dari k pilihan teratas
k = 2
urut = np.argsort(-logit)[:k]
p_topk = np.zeros(len(pilihan))
p_topk[urut] = peluang(logit[urut], 1.0)
print(f"\nTop-{k}: hanya {[pilihan[i] for i in urut]} yang boleh dipilih")
print("Salah satunya benar menurut dokumen kita (3 x 3 m), yang lain terdengar masuk akal tetapi salah.")
suhu=0.2: 3 x 3 m=1.00 2 x 2 m=0.00 4 x 4 m=0.00 5 x 5 m=0.00 bunga mawar=0.00
suhu=1.0: 3 x 3 m=0.70 2 x 2 m=0.16 4 x 4 m=0.09 5 x 5 m=0.05 bunga mawar=0.00
suhu=2.0: 3 x 3 m=0.46 2 x 2 m=0.22 4 x 4 m=0.17 5 x 5 m=0.12 bunga mawar=0.04
Menarik 1000 kali pada suhu 1.0:
3 x 3 m 693
2 x 2 m 167
4 x 4 m 89
5 x 5 m 46
bunga mawar 5
Top-2: hanya ['3 x 3 m', '2 x 2 m'] yang boleh dipilih
Salah satunya benar menurut dokumen kita (3 x 3 m), yang lain terdengar masuk akal tetapi salah.Suhu (temperature) mengatur seberapa tajam peluang: pada suhu 0,2, pilihan teratas mendapat 1,00; pada 1,0 ia mendapat 0,70 dan sisanya terbagi; pada 2,0 hanya 0,46 sehingga pilihan aneh seperti “bunga mawar” pun punya peluang 0,04. Ketika ditarik 1000 kali pada suhu 1,0, “3 x 3 m” muncul 693 kali, tetapi “5 x 5 m” tetap muncul 46 kali dan “bunga mawar” 5 kali. Inilah akar halusinasi: model tidak “tahu” mana yang benar menurut dokumen Anda, ia hanya menimbang kelayakan kalimat. Jawaban salah terdengar sama meyakinkan dengan jawaban benar. Top-k hanya membatasi pilihan ke k teratas; itu mengurangi kata aneh tetapi tidak menjamin kebenaran (di sini “2 x 2 m” tetap lolos). Penangkalnya, seperti di Bab 60: berikan dokumen sumber (RAG), minta kutipan, evaluasi dengan kumpulan uji, dan biarkan manusia memeriksa keputusan penting.
Model bahasa bukan basis data dan bukan mesin pencari. Ia pandai merangkai kalimat yang masuk akal. Pada hal yang bisa membahayakan (dosis pakan, pestisida, keputusan hukum), jangan percaya jawabannya tanpa sumber yang bisa dicek.
Etika dan hak cipta
Dua pertanyaan sering muncul. Pertama, data latih: model dilatih dari teks dan gambar dalam jumlah besar yang pemiliknya mungkin tidak pernah diminta izin; status hukumnya berbeda antarnegara dan masih berkembang. Kedua, keluaran model: siapa pemilik hak ciptanya, dan apakah mirip dengan karya yang ada? Bab 63 membahas lisensi, privasi, UU PDP Indonesia, dan hak cipta dengan sumber resminya. Untuk sekarang pegang tiga kebiasaan: sebutkan bila Anda memakai AI, jangan memasukkan data pribadi ke layanan yang tidak Anda percayai, dan periksa lisensi model dan data sebelum membagikan.
Proyek Bersambung A4: fine-tuning model kecil
Kita latih LoRA pada enam kalimat SOP, ukur kerugian pada data latih dan pada dua kalimat yang tidak dilatih, simpan adapter, lalu muat ulang dan buktikan hasilnya sama.
11_proyek_finetuning.py
# Bab 61 - Proyek A4: fine-tuning LoRA model kecil pada kalimat SOP, lalu simpan dan muat adapter
import shutil
from pathlib import Path

from pustaka import senyap  # noqa: F401
import torch
from peft import LoraConfig, PeftModel, get_peft_model
from transformers import AutoModelForCausalLM

from pustaka.model_uji import FOLDER, muat

torch.manual_seed(0)
perangkat = "cuda" if torch.cuda.is_available() else "cpu"
simpan = Path(__file__).parent / "_tmp" / "adapter_sop"
shutil.rmtree(simpan, ignore_errors=True)

tokenizer, dasar = muat()
latih = [
    "Penanaman jati dilakukan pada awal musim hujan.",
    "Pohon dengan diameter di bawah 10 sentimeter tidak dicatat.",
    "Kolam lele diisi benih dan pakan diberikan dua kali sehari.",
    "Sapi potong ditimbang setiap bulan.",
    "Kualitas air kolam nila dipantau setiap hari.",
    "Padi ditanam dengan jarak 25 x 25 sentimeter.",
]
uji = ["Ikan dipanen saat bobot rata-rata mencapai 500 gram.", "Kopi dipanen secara selektif."]


def kerugian_rata(model, kalimat):
    total = 0.0
    for k in kalimat:
        x = tokenizer(k, return_tensors="pt").to(perangkat)
        with torch.no_grad():
            total += model(**x, labels=x["input_ids"]).loss.item()
    return total / len(kalimat)


konfigurasi = LoraConfig(r=8, lora_alpha=16, target_modules=["c_attn", "c_proj"], fan_in_fan_out=True,
                         task_type="CAUSAL_LM")
model = get_peft_model(dasar, konfigurasi).to(perangkat)
model.print_trainable_parameters()

sebelum_latih, sebelum_uji = kerugian_rata(model, latih), kerugian_rata(model, uji)
pengoptimal = torch.optim.AdamW([p for p in model.parameters() if p.requires_grad], lr=3e-3)
model.train()
for epoch in range(150):
    for k in latih:
        x = tokenizer(k, return_tensors="pt").to(perangkat)
        model(**x, labels=x["input_ids"]).loss.backward()
        pengoptimal.step()
        pengoptimal.zero_grad()
model.eval()
sesudah_latih, sesudah_uji = kerugian_rata(model, latih), kerugian_rata(model, uji)

print(f"Kerugian data latih : {sebelum_latih:.2f} -> {sesudah_latih:.2f}")
print(f"Kerugian data uji   : {sebelum_uji:.2f} -> {sesudah_uji:.2f}  (kalimat yang TIDAK dilatih)")

model.save_pretrained(simpan)
berkas = sum(f.stat().st_size for f in simpan.iterdir() if f.suffix == ".safetensors")
dasar_byte = (FOLDER / "model.safetensors").stat().st_size
print("Ukuran berkas adapter:", berkas, "byte | berkas model dasar:", dasar_byte, "byte")

# Muat ulang: model dasar baru + adapter dari disk harus memberi keluaran yang sama
baru = PeftModel.from_pretrained(AutoModelForCausalLM.from_pretrained(FOLDER).to(perangkat), simpan).eval()
x = tokenizer(uji[0], return_tensors="pt").to(perangkat)
with torch.no_grad():
    sama = torch.allclose(model(**x).logits, baru(**x).logits, atol=1e-4)
print("Adapter yang dimuat ulang memberi hasil sama:", sama)
trainable params: 5,632 || all params: 44,800 || trainable%: 12.5714
Kerugian data latih : 5.71 -> 5.27
Kerugian data uji : 5.70 -> 5.67 (kalimat yang TIDAK dilatih)
Ukuran berkas adapter: 24008 byte | berkas model dasar: 159272 byte
Adapter yang dimuat ulang memberi hasil sama: TruePelajari angkanya. Model acak dengan 300 token menebak hampir merata, sehingga kerugian awal sekitar ln(300) ≈ 5,70 (hasil: 5,71 pada data latih dan 5,70 pada data uji). Setelah 150 putaran, kerugian data latih turun ke 5,27: model menghafal sedikit kalimat latih. Tetapi kerugian pada kalimat yang tidak dilatih nyaris tidak berubah (5,70 menjadi 5,67). Itulah overfitting (terlalu pas pada data latih) dalam bentuk paling jelas, dan alasan mengapa data uji wajib dipisah. Adapter yang disimpan hanya 24.008 byte (dibandingkan 159.272 byte berkas model dasar), dan setelah dimuat ulang pada model dasar baru, keluarannya sama (True). Itulah keunggulan LoRA: satu model dasar, banyak adapter kecil untuk tugas berbeda (SOP kehutanan, SOP perikanan).
Pada proyek sungguhan, Anda memakai model dasar yang sudah pintar (yang muat di GPU Anda), ratusan sampai ribuan contoh bermutu, dan evaluasi yang ketat. Fine-tuning juga bukan satu-satunya jalan: untuk pengetahuan yang sering berubah, RAG (Bab 60) biasanya lebih murah dan lebih mudah diperbarui.
Latihan
- Ubah
01_attention_numpy.pyagar memakai kalimat lima kata dengan benih 7. Apakah tiap baris tetap berjumlah 1? - Di
06_vram.py, tambahkan baris untuk model 30B pada int4. Muatkah di 6 GiB? Tunjukkan hitungannya. - Di
07_lora_peft.py, gantir=4menjadir=16. Berapa parameter yang dilatih sekarang? Apakah sebanding dengan perubahan rank? - Tantangan: di
11_proyek_finetuning.py, tambahkan 6 kalimat SOP lagi ke data latih. Apakah kerugian data uji ikut turun? Jelaskan hasilnya dengan istilah overfitting.
Ringkasan Bab
- Attention = tiap kata melirik kata lain lewat Query, Key, Value; hasilnya persentase yang berjumlah 1. Masker kausal mencegah mengintip kata berikutnya.
- Token adalah potongan teks (BPE); kata jarang terpecah menjadi banyak token. Embedding mengubah token menjadi vektor.
- VRAM: bobot = parameter x byte; inferensi sekitar bobot + 20% (asumsi), pelatihan penuh sekitar 16 byte per parameter (hitungan penulis). Di 6 GiB, 7B hanya muat dalam int4 (hitungan).
- LoRA melatih sebagian kecil parameter (0,39% pada contoh matriks 4096); adapter bisa disimpan, dimuat ulang, dan digabung. Kuantisasi mengecilkan bobot; QLoRA menggabungkan keduanya.
- Model difusi dan multimodal dibahas dari dokumentasi; proses maju difusi diperagakan dengan numpy.
- Halusinasi lahir dari pemilihan token berdasarkan peluang; tangkal dengan sumber, evaluasi, dan pemeriksaan manusia.
- Model uji dibuat sendiri karena lisensi model unduhan tidak jelas.
Selanjutnya, di Bab 62: model yang tidak hanya menjawab, tetapi bertindak: agent AI, alat, MCP, LangGraph, dan keamanannya.