Bab 41 — Automasi dan Scripting: Biarkan Python Bekerja Sendiri
Seri I5 — Aplikasi Pertama: Web, Peta, dan Dasbor
Semua skrip bab ini ada di folder kode/bab41/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Di Bab 36 sampai 40, Anda membuat aplikasi web dan peta. Sekarang bayangkan pekerjaan yang berulang: setiap Senin pagi seseorang mengumpulkan angka dari tiap unit usaha, merapikannya, lalu menulis laporan. Itu seperti petugas yang tiap pekan keliling membawa buku catatan. Python bisa menjadi petugas yang tidak pernah lupa dan tidak pernah bosan. Pegangan sederhananya: bila Anda mengerjakan sesuatu yang sama untuk ketiga kalinya, tulislah skripnya.
Bab ini punya dua bagian besar. Pertama, automasi: menjalankan program, merapikan berkas, memeriksa layanan, dan menjadwalkan semuanya. Kedua, web scraping: membaca data dari halaman web. Untuk yang kedua ada aturan keras di buku ini: kita hanya berlatih pada situs buatan sendiri yang berjalan di komputer sendiri, dan kita membahas etikanya lebih dulu.
subprocess: memanggil program lain
Python punya modul subprocess untuk menjalankan program lain (disebut proses anak) lalu menunggu hasilnya. Ini seperti menyuruh asisten mengerjakan sesuatu dan melaporkan hasilnya.
01_subprocess_dasar.py
# Bab 41 - subprocess: menjalankan program lain dari Python
import subprocess
import sys

# sys.executable = jalur Python yang sedang kita pakai; "-c" = jalankan kode pendek
hasil = subprocess.run(
    [sys.executable, "-c", "print('halo dari proses anak')"],
    capture_output=True, text=True, encoding="utf-8",
)
print("kode keluar:", hasil.returncode)
print("stdout     :", hasil.stdout.strip())
print("stderr kosong:", hasil.stderr == "")

# Argumen dikirim sebagai LIST, satu butir per kata (tanpa shell)
perintah = [sys.executable, "-c", "import sys; print(' + '.join(sys.argv[1:]))", "padi", "jagung"]
hasil = subprocess.run(perintah, capture_output=True, text=True, encoding="utf-8")
print("argumen sampai :", hasil.stdout.strip())
kode keluar: 0
stdout : halo dari proses anak
stderr kosong: True
argumen sampai : padi + jagungsys.executableadalah jalur Python yang sedang dipakai, jadi proses anak memakai Python yang sama.-cberarti “jalankan kode pendek ini”.capture_output=Truemenangkap apa yang dicetak anak (stdout) dan keluhannya (stderr).text=Truemembuat hasilnya berupa teks, bukan bytes.- Kode keluar (
returncode) 0 berarti sukses. Angka lain berarti gagal. - Argumen dikirim sebagai list, satu butir per kata. Menurut dokumentasi resmi Python, dengan cara ini modul sendiri yang mengurus tanda kutip dan spasi pada nama berkas.
Jangan tergoda memakai shell=True dengan teks yang berasal dari pengguna atau dari berkas. Dokumentasi Python memperingatkan bahwa dengan shell=True Andalah yang harus mengamankan semua spasi dan tanda khusus, bila tidak, orang bisa menyisipkan perintah lain (shell injection). Dengan list, tanda khusus dikirim apa adanya kepada anak dan aman.
Program anak bisa gagal dengan tiga cara. Ketiganya bisa ditangani:
02_subprocess_galat.py
# Bab 41 - subprocess: tiga cara gagal dan cara menanganinya
import subprocess
import sys

# 1. Program anak berakhir dengan galat; check=True mengubahnya menjadi pengecualian
try:
    subprocess.run([sys.executable, "-c", "raise SystemExit(3)"], check=True)
except subprocess.CalledProcessError as e:
    print("1. kode keluar bukan 0:", e.returncode)

# 2. Program anak terlalu lama; timeout memutus penantian
try:
    subprocess.run([sys.executable, "-c", "import time; time.sleep(5)"], timeout=0.5)
except subprocess.TimeoutExpired:
    print("2. melewati batas waktu 0.5 detik, proses anak dihentikan")

# 3. Programnya tidak ada sama sekali
try:
    subprocess.run(["program-yang-tidak-ada-123"])
except FileNotFoundError:
    print("3. program tidak ditemukan")
1. kode keluar bukan 0: 3
2. melewati batas waktu 0.5 detik, proses anak dihentikan
3. program tidak ditemukancheck=True mengubah kode keluar bukan-0 menjadi pengecualian CalledProcessError. timeout menghentikan proses anak yang terlalu lama dan memunculkan TimeoutExpired. Program yang tidak ada menghasilkan FileNotFoundError. Skrip otomasi yang baik selalu memikirkan ketiganya, karena tidak ada orang yang melihat layar saat skrip berjalan pukul tiga pagi.
Otomasi berkas: merapikan folder
Tugas klasik: folder unduhan menumpuk berbagai jenis berkas. Skrip ini memindahkan tiap berkas ke folder menurut ekstensinya.
03_otomasi_berkas.py
# Bab 41 - Otomasi tugas harian: merapikan folder unduhan berdasarkan jenis berkas
import shutil
from pathlib import Path

kerja = Path(__file__).parent / "_tmp" / "unduhan"
shutil.rmtree(kerja, ignore_errors=True)
kerja.mkdir(parents=True)
for nama in ["panen_a.csv", "panen_b.csv", "peta_kolam.png", "laporan_mei.pdf", "catatan.txt", "foto_kebun.png"]:
    (kerja / nama).write_text("isi contoh", encoding="utf-8")

PETA_FOLDER = {".csv": "data", ".png": "gambar", ".pdf": "dokumen"}

dipindah = 0
for berkas in sorted(kerja.iterdir()):
    if not berkas.is_file():
        continue
    tujuan = kerja / PETA_FOLDER.get(berkas.suffix, "lainnya")
    tujuan.mkdir(exist_ok=True)
    shutil.move(str(berkas), str(tujuan / berkas.name))
    dipindah += 1

print("berkas dipindah:", dipindah)
for folder in sorted(p for p in kerja.iterdir() if p.is_dir()):
    print(f"{folder.name:8}", sorted(p.name for p in folder.iterdir()))
berkas dipindah: 6
data ['panen_a.csv', 'panen_b.csv']
dokumen ['laporan_mei.pdf']
gambar ['foto_kebun.png', 'peta_kolam.png']
lainnya ['catatan.txt']Perhatikan dua kebiasaan baik. Pertama, skrip bekerja di folder _tmp miliknya sendiri, bukan di folder asli Anda, supaya aman dicoba. Kedua, PETA_FOLDER.get(berkas.suffix, "lainnya") menyediakan folder cadangan untuk jenis yang tidak dikenal (catatan.txt masuk ke lainnya), jadi tidak ada berkas yang tertinggal.
Sebelum memindah atau menghapus berkas secara otomatis, jalankan dulu versi yang hanya mencetak apa yang akan dilakukan. Setelah daftarnya benar, barulah ganti dengan perintah yang sungguhan.
Otomasi infrastruktur: memeriksa layanan
Infrastruktur adalah semua “mesin di belakang layar” yang menjalankan aplikasi Anda: server, layanan web, basis data, ruang disk. Otomasi infrastruktur berarti membuat skrip yang memeriksa dan merawatnya. Contoh paling dasar adalah pemeriksa kesehatan (health check): minta halaman utama, lalu lihat apakah jawabannya sehat.
04_cek_kesehatan.py
# Bab 41 - Otomasi infrastruktur: pemeriksa kesehatan layanan (health check)
import shutil
import urllib.error
import urllib.request

from situs_lokal import SitusLokal


def periksa(alamat):
    """Mengembalikan teks status: 'sehat', 'galat HTTP <kode>', atau 'tidak terhubung'."""
    try:
        with urllib.request.urlopen(alamat, timeout=2) as jawaban:
            return "sehat" if jawaban.status == 200 else f"status {jawaban.status}"
    except urllib.error.HTTPError as e:
        return f"galat HTTP {e.code}"
    except urllib.error.URLError:
        return "tidak terhubung"


with SitusLokal() as situs:
    alamat = situs.url
    print("halaman utama     :", periksa(alamat + "/"))
    print("halaman tak ada   :", periksa(alamat + "/tidak-ada"))

# Setelah blok `with`, server dimatikan: pemeriksa harus menyadarinya
print("setelah dimatikan :", periksa(alamat + "/"))

# Cek lain yang sering diotomasi: sisa ruang disk (hanya dicetak benar/salah supaya stabil)
print("disk masih ada ruang:", shutil.disk_usage(".").free > 100 * 1024 * 1024)
halaman utama : sehat
halaman tak ada : galat HTTP 404
setelah dimatikan : tidak terhubung
disk masih ada ruang: TrueServer yang diperiksa di sini adalah server kecil buatan kita sendiri di komputer ini (modul bantu situs_lokal.py, lihat penjelasannya di bagian scraping). Tiga hasil berbeda patut dibedakan: sehat (kode 200), galat HTTP (server hidup tetapi halamannya tidak ada, 404), dan tidak terhubung (server mati). Dalam praktik, skrip seperti ini dijadwalkan tiap beberapa menit dan mengirim peringatan bila hasilnya bukan “sehat”. Mengirim peringatan (email atau pesan) tidak kita praktikkan di sini karena butuh layanan di luar komputer ini.
Menjadwalkan skrip
Skrip otomasi baru berguna bila berjalan sendiri pada waktunya. Python tidak menjadwalkan dirinya: tugas itu diserahkan ke penjadwal milik sistem operasi.
| Sistem | Penjadwal | Cara |
|---|---|---|
| Windows | Task Scheduler | perintah schtasks /create, atau aplikasi bergambar Task Scheduler |
| Linux dan macOS | cron | baris di berkas crontab (crontab -e) |
05_jadwal_teks.py
# Bab 41 - Menjadwalkan skrip: perintahnya HANYA dicetak, tidak dijalankan
from pathlib import Path

# Windows Task Scheduler: satu tugas = satu program, jadi kita bungkus dengan berkas .bat
bat = "\n".join([
    "@echo off",
    r"C:\proyek\.venv\Scripts\python.exe C:\proyek\laporan_mingguan.py",
    "",
])
tulis = Path(__file__).parent / "_tmp" / "jalankan_laporan.bat"
tulis.parent.mkdir(exist_ok=True)
tulis.write_text(bat, encoding="ascii")
print("isi jalankan_laporan.bat:")
print(bat)

print("Perintah Windows (jalankan sendiri di terminal Anda):")
print(r"schtasks /create /tn LaporanMingguan /tr C:\proyek\jalankan_laporan.bat /sc weekly /d MON /st 07:00")

# cron (Linux/macOS): lima kolom waktu, lalu perintah
cron = "0 7 * * 1 /home/anda/proyek/.venv/bin/python /home/anda/proyek/laporan_mingguan.py"
print("\nBaris crontab (tempel lewat `crontab -e`):")
print(cron)

BATAS = [("menit", 0, 59), ("jam", 0, 23), ("tanggal", 1, 31), ("bulan", 1, 12), ("hari", 0, 6)]


def periksa_cron(baris):
    """Pemeriksa sederhana: hanya '*' atau satu angka per kolom, dan angkanya dalam rentang."""
    kolom = baris.split()[:5]
    for isi, (nama, kecil, besar) in zip(kolom, BATAS):
        if isi != "*" and not (isi.isdigit() and kecil <= int(isi) <= besar):
            return f"kolom {nama} salah: {isi}"
    return "lima kolom waktu masuk akal"


print("\nPemeriksaan:", periksa_cron(cron))
print("Contoh salah:", periksa_cron("0 25 * * 1 perintah"))
isi jalankan_laporan.bat:
@echo off
C:\proyek\.venv\Scripts\python.exe C:\proyek\laporan_mingguan.py
Perintah Windows (jalankan sendiri di terminal Anda):
schtasks /create /tn LaporanMingguan /tr C:\proyek\jalankan_laporan.bat /sc weekly /d MON /st 07:00
Baris crontab (tempel lewat `crontab -e`):
0 7 * * 1 /home/anda/proyek/.venv/bin/python /home/anda/proyek/laporan_mingguan.py
Pemeriksaan: lima kolom waktu masuk akal
Contoh salah: kolom jam salah: 25Kode ini hanya mencetak perintahnya. Perintah penjadwalan tidak dijalankan di buku ini karena mengubah pengaturan komputer Anda. Anda menjalankannya sendiri bila siap. Keterangannya, menurut dokumentasi resmi:
- Windows (
schtasks):/tnmemberi nama tugas,/trmenentukan program yang dijalankan,/sc weeklyberarti mingguan,/d MONhari Senin,/st 07:00jam mulai (format 24 jam). Satu tugas hanya menjalankan satu program, sehingga dokumentasi menyarankan berkas batch (.bat) untuk menjalankan beberapa langkah. Itu sebabnya kita membungkus Python denganjalankan_laporan.bat. - cron: lima kolom waktu berurutan: menit (0-59), jam (0-23), tanggal (1-31), bulan (1-12), hari dalam pekan (0-6, dengan 0 = Minggu). Jadi
0 7 * * 1berarti pukul 07.00 setiap Senin. Tanda*berarti “semua nilai”.
Tiga kebiasaan penjadwalan yang menyelamatkan Anda: (1) pakai jalur lengkap ke Python dan ke skrip, karena penjadwal tidak berjalan dari folder Anda; (2) selalu tulis log ke berkas, karena tidak ada layar yang bisa dibaca; (3) coba dulu dengan tangan sebelum dijadwalkan.
Web scraping: etika dulu, kode kemudian
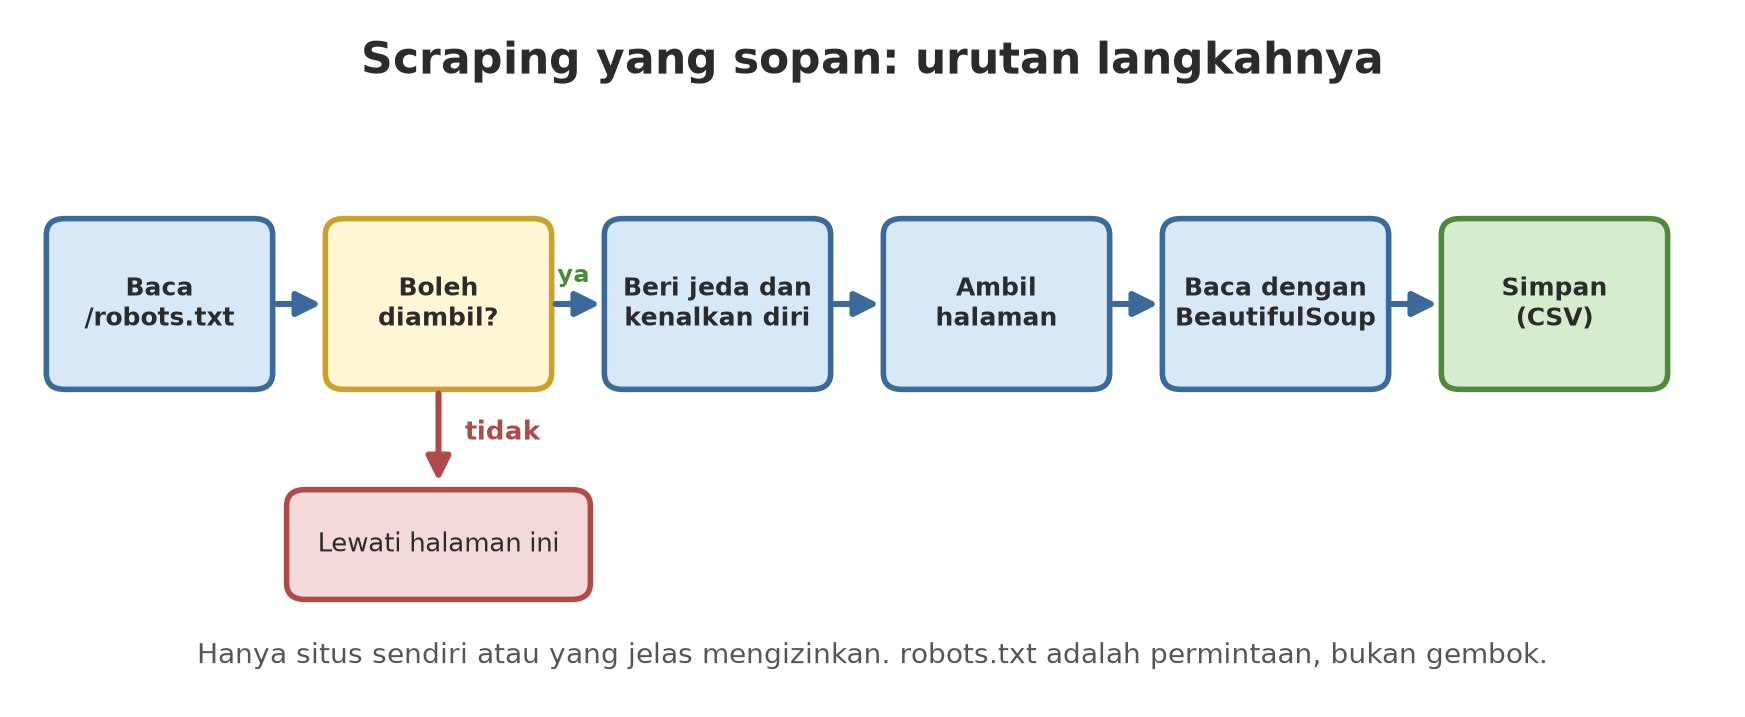
Web scraping adalah membaca halaman web dengan program, lalu mengambil bagian yang berguna (misalnya isi tabel). Tekniknya mudah. Yang sulit, dan yang lebih penting, adalah bersikap benar. Sebelum menulis satu baris pun, pegang aturan ini:
| Pertanyaan | Yang harus Anda lakukan |
|---|---|
| Adakah cara resmi? | Cari dulu API atau unduhan data resmi. Itu selalu lebih baik daripada scraping. |
Apa kata robots.txt? |
Baca /robots.txt di situs itu dan patuhi bagian yang melarang. |
| Apa kata syarat penggunaan? | Baca syarat penggunaan (terms of service) situs. Bila melarang scraping, jangan lakukan. |
| Seberapa sering saya meminta? | Beri jeda antar permintaan dan jangan membanjiri server (batas laju). |
| Siapa saya bagi server? | Perkenalkan diri lewat User-Agent yang jujur dan bisa dihubungi. |
| Datanya apa? | Hati-hati dengan data pribadi dan hak cipta. Data boleh dibaca belum tentu boleh disebarkan. |
robots.txt dijelaskan dalam standar RFC 9309 (Robots Exclusion Protocol). Standar itu menegaskan bahwa aturan di dalamnya bukan bentuk izin akses: ia adalah permintaan sopan yang dipatuhi oleh perayap yang baik, bukan gembok. Artinya, tidak ada yang menghentikan program Anda melanggarnya. Yang menghentikan adalah sikap Anda. Standar itu juga tidak mendefinisikan Crawl-delay; itu kebiasaan tambahan yang dipahami sebagian perayap.
Aturan buku ini: semua latihan scraping di sini berjalan terhadap halaman HTML buatan sendiri yang disajikan server di komputer Anda (127.0.0.1, alamat yang hanya bisa dijangkau komputer ini). Kita tidak mengambil halaman situs nyata mana pun. Itu sengaja: kita bisa berlatih penuh tanpa membebani siapa pun.
Situs latihannya dibuat oleh modul bantu situs_lokal.py (ada di folder skrip): satu halaman utama berisi daftar sektor, lima halaman sektor yang masing-masing memuat sebuah tabel unit usaha, satu halaman “internal” yang dilarang oleh robots.txt, dan berkas robots.txt itu sendiri. Datanya adalah data tiruan unit usaha kita, semua angka fiktif.
BeautifulSoup: membaca HTML
BeautifulSoup (paket beautifulsoup4) mengubah teks HTML menjadi pohon yang bisa ditelusuri. Pemilah (parser) bawaan Python bernama html.parser; ada juga lxml dan html5lib yang dipasang terpisah.
06_bs4_dasar.py
# Bab 41 - BeautifulSoup: membaca halaman HTML (situs buatan sendiri di komputer sendiri)
import urllib.request

from bs4 import BeautifulSoup

from situs_lokal import SitusLokal

with SitusLokal() as situs:
    with urllib.request.urlopen(situs.url + "/sektor/kolam.html", timeout=5) as r:
        html = r.read().decode("utf-8")

print("--- 8 baris pertama HTML ---")
print("\n".join(html.splitlines()[:8]))
print("...")

sup = BeautifulSoup(html, "html.parser")
print("\njudul halaman :", sup.title.get_text())
print("judul utama   :", sup.h1.get_text())

# Selektor CSS: cari semua baris tabel yang punya atribut data-id
total = 0.0
for tr in sup.select("table#unit tbody tr[data-id]"):
    sel = [td.get_text(strip=True) for td in tr.find_all("td")]
    print(tr["data-id"], sel, "lat =", tr["data-lat"])
    total += float(tr.select_one("td.nilai").get_text())
print("total nilai   :", total)

# Jebakan: find() mengembalikan None bila tidak ketemu
tabel = sup.find("table", id="tidak-ada")
print("\ntabel yang dicari:", tabel)
try:
    tabel.find_all("tr")
except AttributeError as e:
    print("galat:", e)
--- 8 baris pertama HTML ---
<!doctype html>
<html lang="id">
<head><meta charset="utf-8"><title>Sektor kolam</title></head>
<body>
<h1>Sektor kolam</h1>
<table id="unit">
<thead><tr><th>Unit</th><th>Jenis</th><th>Nilai</th><th>Satuan</th></tr></thead>
<tbody>
...
judul halaman : Sektor kolam
judul utama : Sektor kolam
L1 ['Kolam A', 'nila', '432.4', 'kg'] lat = -6.644
L2 ['Kolam B', 'lele', '380.0', 'kg'] lat = -6.6452
L3 ['Kolam C', 'nila', '295.5', 'kg'] lat = -6.6466
total nilai : 1107.9
tabel yang dicari: None
galat: 'NoneType' object has no attribute 'find_all'Telusuri hasilnya:
- Delapan baris pertama HTML menunjukkan bentuk halaman: ada
<table id="unit">dengan kepala tabel dan badan tabel. select("table#unit tbody tr[data-id]")memakai selektor CSS: “baris di dalam badan tabelunityang punya atributdata-id”.select()mengembalikan list semua yang cocok;select_one()hanya yang pertama.get_text(strip=True)mengambil teks tanpa spasi berlebih. Atribut sepertidata-latdibaca seperti kamus:tr["data-lat"].- Total tiga kolam adalah 432,4 + 380,0 + 295,5 = 1107,9 kg, cocok dengan keluaran.
- Jebakan: bila elemen yang dicari tidak ada,
find()mengembalikanNone(sedangkanfind_all()mengembalikan list kosong). Memanggil metode padaNonemenghasilkanAttributeError. Itulah sebabnya kode yang baik memeriksaNonedan berteriak jelas bila halaman berubah bentuk.
robots.txt di kode
Python punya pembaca robots.txt bawaan: urllib.robotparser.
07_robots_etika.py
# Bab 41 - robots.txt: membaca aturan situs sebelum mengambil halaman
import urllib.request
import urllib.robotparser

from situs_lokal import SitusLokal

AGEN = "BukuPythonBot/1.0"

with SitusLokal() as situs:
    with urllib.request.urlopen(situs.url + "/robots.txt", timeout=5) as r:
        isi = r.read().decode("utf-8")
    print("isi robots.txt:")
    print(isi)

    robot = urllib.robotparser.RobotFileParser()
    robot.parse(isi.splitlines())
    for path in ["/", "/sektor/kolam.html", "/privat/catatan.html"]:
        boleh = robot.can_fetch(AGEN, situs.url + path)
        print(f"{path:24} boleh diambil? {boleh}")
    print("Crawl-delay:", robot.crawl_delay(AGEN), "detik")

    # robots.txt hanyalah permintaan, bukan gembok: server tetap menjawab bila kita memaksa
    with urllib.request.urlopen(situs.url + "/privat/catatan.html", timeout=5) as r:
        print("\nkalau dipaksa, server menjawab:", r.status, "(tetap TIDAK boleh kita lakukan)")
isi robots.txt:
User-agent: *
Disallow: /privat/
Crawl-delay: 1
/ boleh diambil? True
/sektor/kolam.html boleh diambil? True
/privat/catatan.html boleh diambil? False
Crawl-delay: 1 detik
kalau dipaksa, server menjawab: 200 (tetap TIDAK boleh kita lakukan)can_fetch(agen, alamat) menjawab apakah agen kita boleh mengambil alamat itu. Halaman /privat/ dilarang (False). crawl_delay() mengembalikan jeda yang diminta situs (1 detik), atau None bila tidak ada. Perhatikan baris terakhir: server tetap menjawab 200 bila kita memaksa. Itu persis pesan RFC 9309 tadi: robots.txt bukan gembok, jadi kepatuhan sepenuhnya di tangan kita.
Scraper yang sopan
Kini kita gabungkan semuanya menjadi satu kelas: membaca robots.txt dulu, memberi jeda, dan memperkenalkan diri.
pengambil.py
# Bab 41 - Modul bantu: pengambil halaman yang sopan (patuh robots.txt, memberi jeda, memperkenalkan diri)
import time
import urllib.error
import urllib.request
import urllib.robotparser

from bs4 import BeautifulSoup

AGEN = "BukuPythonBot/1.0 (contoh belajar; situs lokal sendiri)"


def baca_tabel(html):
    """Membaca tabel unit dari satu halaman sektor menjadi daftar dict."""
    sup = BeautifulSoup(html, "html.parser")
    tabel = sup.find("table", id="unit")
    if tabel is None:                       # halaman berubah bentuk: jangan diam-diam salah
        raise ValueError("tabel #unit tidak ditemukan")
    hasil = []
    for tr in tabel.select("tbody tr"):
        sel = [td.get_text(strip=True) for td in tr.find_all("td")]
        hasil.append({
            "id": tr["data-id"], "unit": sel[0], "jenis": sel[1],
            "lat": float(tr["data-lat"]), "lon": float(tr["data-lon"]),
            "nilai": float(sel[2]), "satuan": sel[3],
        })
    return hasil


class PengambilSopan:
    def __init__(self, dasar, agen=AGEN, jeda_bawaan=1.0, batas_waktu=5):
        self.dasar, self.agen, self.batas_waktu = dasar, agen, batas_waktu
        self.ditolak = []                   # alamat yang tidak diambil karena robots.txt
        self._terakhir = 0.0
        self.robot = urllib.robotparser.RobotFileParser()
        teks = self._unduh("/robots.txt")
        self.robot.parse(teks.splitlines() if teks else [])
        # Jeda: ikuti Crawl-delay bila ada (itu kebiasaan, bukan bagian standar), kalau tidak pakai bawaan
        self.jeda = self.robot.crawl_delay(agen) or jeda_bawaan

    def _unduh(self, path):
        permintaan = urllib.request.Request(self.dasar + path, headers={"User-Agent": self.agen})
        try:
            with urllib.request.urlopen(permintaan, timeout=self.batas_waktu) as r:
                return r.read().decode("utf-8")
        except urllib.error.HTTPError:
            return ""

    def ambil(self, path):
        """Mengembalikan HTML, atau None bila robots.txt melarang."""
        if not self.robot.can_fetch(self.agen, self.dasar + path):
            self.ditolak.append(path)
            return None
        tunggu = self.jeda - (time.monotonic() - self._terakhir)
        if tunggu > 0:
            time.sleep(tunggu)
        try:
            return self._unduh(path)
        finally:
            self._terakhir = time.monotonic()
Hal penting di kelas ini:
- User-Agent jujur:
BukuPythonBot/1.0 (contoh belajar; situs lokal sendiri). Pada situs nyata, sertakan cara menghubungi Anda. self.jeda: memakaiCrawl-delaydari situs bila ada, bila tidak, 1 detik.ambil()menolak alamat yang dilarangrobots.txt(dicatat diditolak) dan menunggu sampai jeda terpenuhi sebelum meminta lagi.baca_tabel()melemparValueErrorbila tabel tidak ditemukan.
Skrip yang memakainya:
08_scraper_sopan.py
# Bab 41 - Scraper sopan: patuh robots.txt, memberi jeda, memperkenalkan diri
import csv
from pathlib import Path

from bs4 import BeautifulSoup

from data_unit import baca_unit
from pengambil import PengambilSopan, baca_tabel
from situs_lokal import SitusLokal

with SitusLokal() as situs:
    bot = PengambilSopan(situs.url)
    print("jeda yang dipakai:", bot.jeda, "detik")

    indeks = BeautifulSoup(bot.ambil("/"), "html.parser")
    tautan = [a["href"] for a in indeks.select("#menu a")]
    print("tautan di halaman utama:", len(tautan))

    semua = []
    for path in tautan:
        html = bot.ambil(path)
        if html is None:
            print("dilewati (robots.txt melarang):", path)
            continue
        semua += baca_tabel(html)
    catatan = list(situs.catatan)

keluar = Path(__file__).parent / "_tmp" / "unit_hasil_scrape.csv"
keluar.parent.mkdir(exist_ok=True)
with open(keluar, "w", encoding="utf-8", newline="") as f:
    tulis = csv.DictWriter(f, fieldnames=list(semua[0]))
    tulis.writeheader()
    tulis.writerows(semua)

print("baris hasil scraping:", len(semua))
print("sama dengan data sumber:", semua == [{k: u[k] for k in semua[0]} for u in baca_unit()])
print("permintaan yang masuk ke server:", len(catatan))
print("halaman terlarang yang diminta :", [p for p, _ in catatan if p.startswith("/privat")])
print("pengenal diri (User-Agent)     :", sorted({ua for _, ua in catatan}))
jeda yang dipakai: 1 detik
tautan di halaman utama: 6
dilewati (robots.txt melarang): /privat/catatan.html
baris hasil scraping: 15
sama dengan data sumber: True
permintaan yang masuk ke server: 7
halaman terlarang yang diminta : []
pengenal diri (User-Agent) : ['BukuPythonBot/1.0 (contoh belajar; situs lokal sendiri)']Mari periksa angkanya. Halaman utama punya 6 tautan: lima sektor dan satu halaman internal. Yang internal dilewati karena dilarang. Hasilnya 15 baris, sama persis dengan data sumber (True). Server menerima 7 permintaan: 1 untuk robots.txt, 1 untuk halaman utama, dan 5 untuk halaman sektor. Daftar halaman terlarang yang diminta kosong, dan pengenal diri kita tercatat jujur di server.
Skrip ini menunggu 1 detik sebelum tiap permintaan, jadi berjalan beberapa detik. Itu disengaja dan bukan kelambatan: itulah batas laju. Pada situs nyata, jeda yang wajar sering lebih lama, dan scraping skala besar sebaiknya diizinkan tertulis oleh pemilik situs.
Scrapy: kerangka kerja untuk scraping besar
Scrapy adalah kerangka kerja (framework) lengkap untuk perayapan: mengelola antrean alamat, jeda, konkurensi, kepatuhan robots.txt, dan penyimpanan hasil. Bila BeautifulSoup adalah pisau, Scrapy adalah pabrik kecil. Untuk satu-dua halaman, BeautifulSoup cukup; untuk ratusan halaman yang rutin, Scrapy lebih rapi.
| BeautifulSoup | Scrapy | |
|---|---|---|
| Sifat | pustaka pembaca HTML | kerangka kerja perayap penuh |
| Mengambil halaman? | tidak (pakai urllib atau httpx) |
ya |
Jeda dan robots.txt |
Anda yang menulis | pengaturan (DOWNLOAD_DELAY, ROBOTSTXT_OBEY) |
| Cocok untuk | tugas kecil | proyek perayapan besar dan berulang |
Scrapy 2.19.0 terpasang di komputer penulis lewat alat/pasang.py untuk Python 3.14, dan skrip di bawah berhasil berjalan. (Di komputer Anda, pemasangannya pip install scrapy.) Berikut sebuah spider (perayap) kecil:
09_scrapy_laba.py
# Bab 41 - Scrapy: kerangka kerja scraping, dijalankan terhadap situs lokal buatan sendiri
import json
from pathlib import Path

import scrapy
from scrapy.crawler import CrawlerProcess

from situs_lokal import SitusLokal

KELUAR = Path(__file__).parent / "_tmp" / "scrapy_unit.json"
KELUAR.parent.mkdir(exist_ok=True)


class LabaUnit(scrapy.Spider):
    name = "laba_unit"

    def __init__(self, dasar, **kw):
        super().__init__(**kw)
        self.dasar = dasar

    async def start(self):
        yield scrapy.Request(self.dasar + "/")

    def parse(self, response):
        # menu berisi 5 tautan sektor + 1 tautan internal yang dilarang robots.txt
        for a in response.css("#menu a"):
            yield response.follow(a, callback=self.parse_sektor)

    def parse_sektor(self, response):
        for tr in response.css("table#unit tbody tr"):
            yield {
                "id": tr.attrib["data-id"],
                "unit": tr.css("td:nth-child(1)::text").get(),
                "nilai": float(tr.css("td.nilai::text").get()),
            }


with SitusLokal() as situs:
    proses = CrawlerProcess(settings={
        "USER_AGENT": "BukuPythonBot/1.0 (contoh belajar; situs lokal sendiri)",
        "ROBOTSTXT_OBEY": True,
        "DOWNLOAD_DELAY": 1,
        "CONCURRENT_REQUESTS_PER_DOMAIN": 1,
        "LOG_LEVEL": "ERROR",
        "FEEDS": {str(KELUAR): {"format": "json", "overwrite": True}},
    })
    perayap = proses.create_crawler(LabaUnit)
    proses.crawl(perayap, dasar=situs.url)
    proses.start()
    statistik = perayap.stats.get_stats()

item = json.loads(KELUAR.read_text(encoding="utf-8"))
print("item terkumpul          :", len(item))
print("contoh item pertama     :", sorted(item, key=lambda x: x["id"])[0])
print("dilarang robots.txt     :", statistik.get("robotstxt/forbidden"))
print("halaman berhasil (200)  :", statistik.get("downloader/response_status_count/200"))
item terkumpul : 15
contoh item pertama : {'id': 'D1', 'unit': 'Kandang 1', 'nilai': 350.0}
dilarang robots.txt : 1
halaman berhasil (200) : 7Cara membacanya:
start()memberi alamat awal.parse()menerima halaman utama dan mengikuti tiap tautan di menu denganresponse.follow.parse_sektor()mengeluarkan satu item (kamus) untuk tiap baris tabel.- Pengaturan di
CrawlerProcessmemuat etika kita:ROBOTSTXT_OBEYmenyalakan kepatuhan padarobots.txt(dokumentasi Scrapy mencatat bahwa proyek hasilscrapy startprojectmenyalakannya, tetapi kita menuliskannya eksplisit),DOWNLOAD_DELAYmemberi jeda 1 detik,CONCURRENT_REQUESTS_PER_DOMAINmembatasi permintaan serentak ke satu situs, danUSER_AGENTmemperkenalkan diri. Dokumentasi Scrapy menganjurkan User-Agent yang menyebut proyek dan cara menghubungi Anda. - Hasilnya: 15 item, 1 permintaan ditolak oleh
robots.txt(halaman internal), dan 7 halaman berstatus 200:robots.txt, halaman utama, dan lima halaman sektor. Angka ini sama dengan hitungan scraper buatan sendiri tadi.
Scrapy punya jeda acak: secara bawaan jedanya digoyang sekitar setengah sampai satu setengah kali nilai DOWNLOAD_DELAY, supaya tidak terlalu seragam. Karena itu waktu proses tidak dicetak di buku ini, hanya jumlah yang stabil.
Proyek Bersambung I5: otomasi laporan mingguan
Sekarang semua bahan bergabung. Skrip proyek ini mengambil data semua sektor dari situs lokal dengan pengambil yang sopan, merangkum per sektor, membandingkannya dengan rata-rata minggu lalu, menulis laporan Markdown, dan mencatat log.
10_proyek_laporan_mingguan.py
# Bab 41 - Proyek bersambung I5: otomasi laporan mingguan (angka FIKTIF)
import logging
from pathlib import Path

from data_unit import ringkas_per_sektor
from pengambil import PengambilSopan, baca_tabel
from situs_lokal import SitusLokal

KELUAR = Path(__file__).parent / "_tmp"
KELUAR.mkdir(exist_ok=True)
logging.basicConfig(filename=KELUAR / "laporan.log", filemode="w", level=logging.INFO,
                    format="%(levelname)s %(message)s")

# Rata-rata minggu lalu (angka contoh) untuk dibandingkan
MINGGU_LALU = {"hutan": 34.8, "kebun": 250.0, "sawah": 1100.0, "kolam": 360.0, "kandang": 380.0}


def kumpulkan(dasar):
    bot = PengambilSopan(dasar)
    unit = []
    for sektor in MINGGU_LALU:
        html = bot.ambil(f"/sektor/{sektor}.html")
        if html is None:
            logging.warning("dilewati: %s", sektor)
            continue
        baris = [dict(u, sektor=sektor) for u in baca_tabel(html)]
        unit += baris
        logging.info("sektor %s: %d unit", sektor, len(baris))
    return unit


def susun_laporan(unit):
    baris = ["# Laporan mingguan (data fiktif)", "",
             "| Sektor | Unit | Rata-rata | Satuan | Beda dari minggu lalu |", "|---|---|---|---|---|"]
    for sektor, r in ringkas_per_sektor(unit).items():
        beda = (r["rata"] - MINGGU_LALU[sektor]) / MINGGU_LALU[sektor] * 100
        baris.append(f"| {sektor} | {r['jumlah']} | {r['rata']:.1f} | {r['satuan']} | {beda:+.1f}% |")
    return "\n".join(baris) + "\n"


def main():
    with SitusLokal() as situs:
        unit = kumpulkan(situs.url)
    teks = susun_laporan(unit)
    (KELUAR / "laporan_mingguan.md").write_text(teks, encoding="utf-8")
    logging.info("laporan selesai: %d unit", len(unit))
    return teks


if __name__ == "__main__":
    print(main())
    print("baris log:", len((KELUAR / "laporan.log").read_text().splitlines()))
# Laporan mingguan (data fiktif)
| Sektor | Unit | Rata-rata | Satuan | Beda dari minggu lalu |
|---|---|---|---|---|
| hutan | 3 | 35.2 | cm | +1.2% |
| kebun | 4 | 257.5 | kg | +3.0% |
| sawah | 2 | 1115.2 | kg | +1.4% |
| kolam | 3 | 369.3 | kg | +2.6% |
| kandang | 3 | 383.8 | kg | +1.0% |
baris log: 6Telusuri satu baris: sektor kolam punya 3 unit dengan rata-rata (432,4 + 380,0 + 295,5) / 3 = 369,3 kg. Rata-rata minggu lalu (angka contoh) 360,0, jadi (369,3 − 360,0) / 360,0 = +2,6%. Skrip juga menulis laporan.log yang berisi 6 baris (5 sektor dan 1 baris “laporan selesai”), bukti bahwa ia bisa dipantau tanpa layar.
Struktur skrip sengaja dibuat agar bisa dijadwalkan: semua pekerjaan ada dalam fungsi main(), dan bagian if __name__ == "__main__": hanya memanggilnya. Dengan bungkus .bat atau baris cron dari bagian penjadwalan, laporan ini akan tersusun sendiri tiap Senin pukul 07.00. Angka rata-rata sektor hutan (cm) dan lainnya (kg) tidak boleh dijumlahkan lintas sektor; itulah sebabnya laporan dibuat per sektor.
Latihan
- Ubah
01_subprocess_dasar.pysupaya proses anak mencetak penjumlahan dua angka yang Anda kirim sebagai argumen, lalu baca hasilnya di induk. - Tambahkan jenis berkas
.xlsx(folderlembar) pada03_otomasi_berkas.py. Berapa berkas yang masuklainnyasekarang? - Pada
07_robots_etika.py, ubahDisallowdi modulsitus_lokal.py(salinan Anda sendiri) agar/sektor/juga dilarang. Pastikancan_fetchmenjadiFalseuntuk halaman sektor. - Tantangan: tambahkan ke laporan mingguan satu kolom “unit tertinggi” (nama unit dengan nilai terbesar di tiap sektor), lalu tulis baris
schtasksatau cron untuk menjadwalkannya hari Jumat pukul 16.00 (cukup dicetak, jangan dijalankan).
Ringkasan Bab
subprocess.run([...], capture_output=True, text=True)menjalankan program lain; kirim argumen sebagai list, hindarishell=Truedengan teks tak tepercaya.- Tangani tiga kegagalan: kode keluar (
check=True), waktu habis (timeout), program tidak ada (FileNotFoundError). - Penjadwalan diserahkan ke Task Scheduler (Windows) atau cron (Linux/macOS); pakai jalur lengkap, tulis log, uji dengan tangan dulu.
- Scraping: cari API resmi dulu; patuhi
robots.txtdan syarat penggunaan; beri jeda; kenalkan diri; hati-hati data pribadi.robots.txtadalah permintaan, bukan gembok. - BeautifulSoup membaca HTML (
select,get_text);find()bisa mengembalikanNone. Scrapy mengurus perayapan besar lewat pengaturan. - Buku ini hanya melatih scraping pada situs buatan sendiri di komputer sendiri.
Selanjutnya, di Bab 42: antarmuka. Skrip tidak harus dipakai lewat berkas Python: Anda akan membuat perintah di terminal (CLI), jendela sederhana (GUI), dan melihat dasbor data pertama.