Bab 58 — Explainable AI, MLOps, dan AI Bertanggung Jawab
Seri A3 — Machine Learning untuk Sumber Daya Alam
Semua skrip bab ini ada di folder kode/bab58/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Bayangkan Anda memberi peta tutupan lahan kepada Dinas Kehutanan, lalu seorang kepala bidang bertanya: “Kenapa petak ini Anda sebut kebun, bukan hutan? Dan peta ini masih berlaku tahun depan?” Jawaban “karena modelnya bilang begitu” tidak cukup. Bab ini membekali Anda untuk menjawab: menjelaskan model, mencatat dan memantau model sepanjang hidupnya (inilah MLOps, machine learning operations), dan memakainya secara bertanggung jawab.
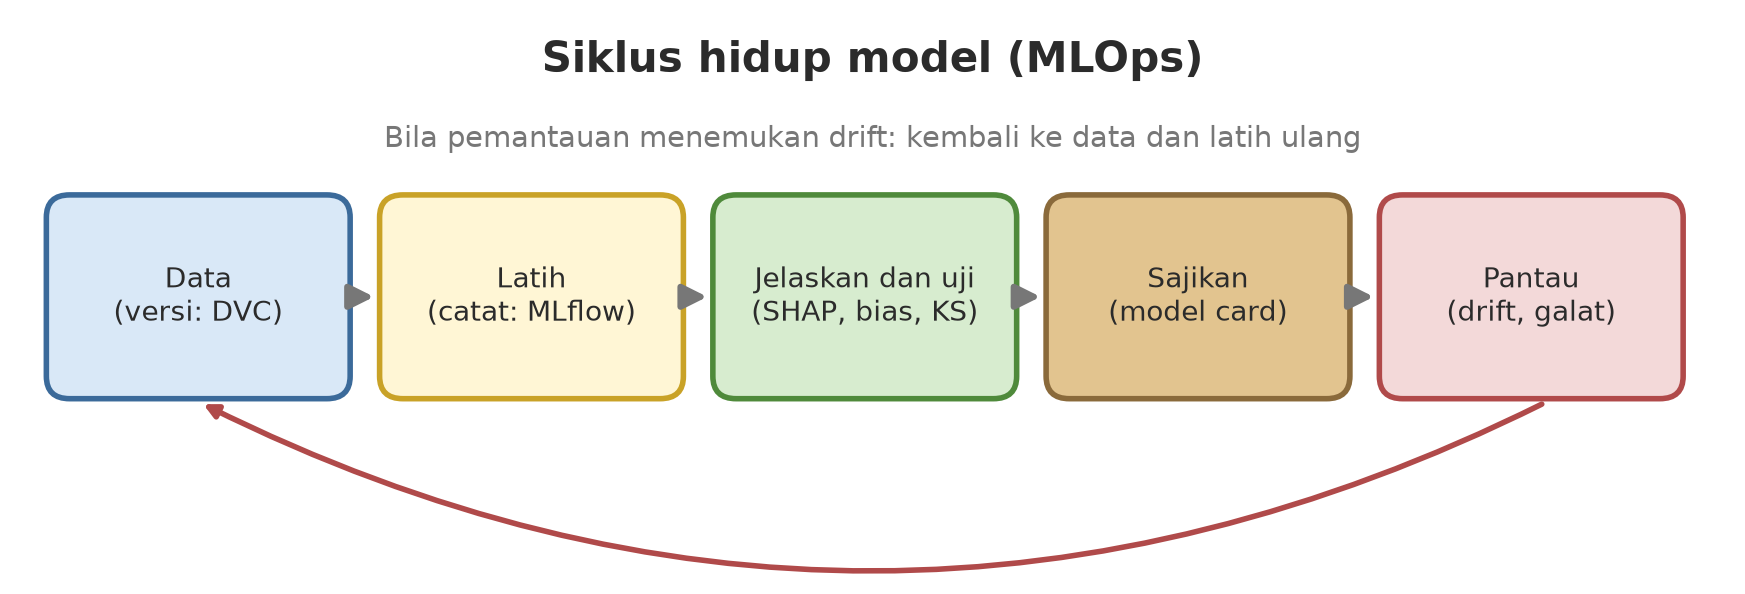
Data di bab ini sama dengan Bab 54: petak lahan tiruan. Salinan buat_data.py ada di folder bab ini agar bab ini berdiri sendiri. Semua angka adalah contoh.
Pentingnya fitur: hati-hati dengan ukuran bawaan
Di Bab 54 kita membaca feature_importances_ dari random forest. Ukuran itu (berbasis penurunan impurity) punya kelemahan: bila dua fitur berkorelasi, nilainya terbagi di antara mereka. Permutation importance menghitung seberapa turun akurasi pada data uji bila satu kolom diacak-acak: bila kolom itu penting, akurasi anjlok.
Kita buktikan dengan menambah fitur elevasi_ft: elevasi yang sama dalam satuan kaki (salinan persis elevasi_m).
01_importance_permutasi.py
# Bab 58 - Pentingnya fitur: bawaan random forest vs permutasi (pada data uji)
import numpy as np
from sklearn.ensemble import RandomForestClassifier
from sklearn.inspection import permutation_importance
from sklearn.model_selection import train_test_split

from buat_data import FITUR, buat_lahan

df = buat_lahan()
# Tambah fitur "elevasi_ft" = elevasi dalam kaki: salinan hampir persis elevasi_m (berkorelasi sempurna)
df["elevasi_ft"] = df["elevasi_m"] * 3.28084
kolom = FITUR + ["elevasi_ft"]
X_latih, X_uji, y_latih, y_uji = train_test_split(df[kolom], df["kelas"], test_size=0.3, random_state=42, stratify=df["kelas"])
model = RandomForestClassifier(n_estimators=200, random_state=42, n_jobs=1).fit(X_latih, y_latih)
print("Akurasi uji:", round(model.score(X_uji, y_uji), 3))

perm = permutation_importance(model, X_uji, y_uji, n_repeats=10, random_state=42, n_jobs=1)
print("\nfitur                | bawaan RF (impurity) | permutasi (turun akurasi)")
for i in np.argsort(-model.feature_importances_):
    print(f"{kolom[i]:20s} | {model.feature_importances_[i]:20.3f} | {perm.importances_mean[i]:.3f} +- {perm.importances_std[i]:.3f}")
Akurasi uji: 0.914
fitur | bawaan RF (impurity) | permutasi (turun akurasi)
ndvi | 0.413 | 0.356 +- 0.014
elevasi_ft | 0.205 | 0.082 +- 0.014
elevasi_m | 0.178 | 0.061 +- 0.009
kemiringan_derajat | 0.143 | 0.126 +- 0.017
curah_hujan_mm | 0.062 | 0.017 +- 0.005Elevasi muncul dua kali (elevasi_ft 0,205 dan elevasi_m 0,178 menurut ukuran bawaan), padahal informasinya satu. Permutasi menunjukkan hal serupa: mengacak salah satu salinan hanya menurunkan akurasi 0,082 atau 0,061, karena model masih bisa memakai salinan lainnya. Pelajaran: sebelum menyimpulkan “fitur ini tidak penting”, periksa apakah ada fitur kembarannya.
SHAP: kontribusi tiap fitur pada tiap prediksi
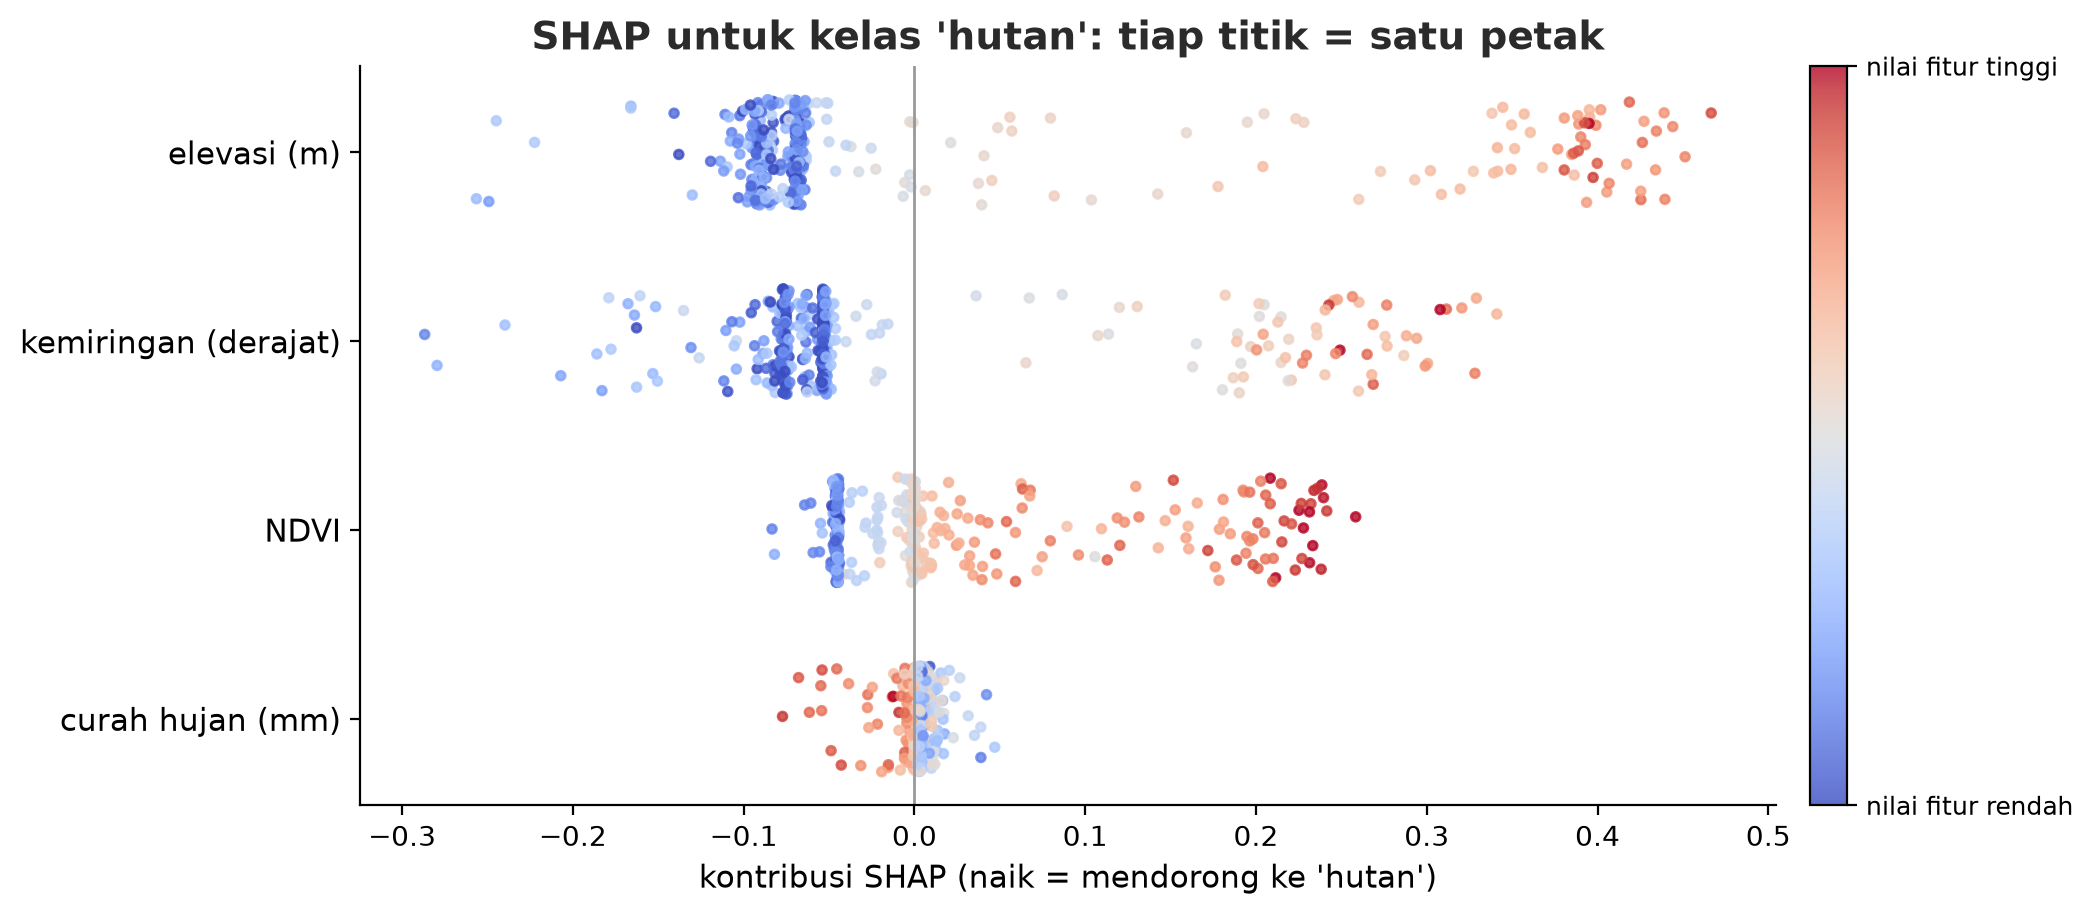
SHAP (SHapley Additive exPlanations) membagi selisih antara prediksi sebuah petak dan prediksi rata-rata menjadi kontribusi tiap fitur, memakai gagasan dari teori permainan (membagi “hadiah” secara adil di antara “pemain”). Untuk model berbasis pohon, shap.TreeExplainer menghitungnya cepat dan eksak. Dokumentasi SHAP (dibaca 2026-10-10) menyatakan bahwa jumlah nilai SHAP ditambah nilai dasar (expected_value) sama dengan keluaran model, dan random forest scikit-learn didukung.
02_shap_rf.py
# Bab 58 - SHAP: menjelaskan prediksi random forest per petak, dan bukti bahwa penjelasannya "menjumlah"
import numpy as np
import shap
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split

from buat_data import FITUR, buat_lahan

df = buat_lahan()
X_latih, X_uji, y_latih, y_uji = train_test_split(df[FITUR], df["kelas"], test_size=0.3, random_state=42, stratify=df["kelas"])
model = RandomForestClassifier(n_estimators=100, max_depth=8, random_state=42, n_jobs=1).fit(X_latih, y_latih)
kelas = list(model.classes_)

penjelas = shap.TreeExplainer(model)
sv = penjelas(X_uji.iloc[:100])                         # objek Explanation: nilai (petak, fitur, kelas)
print("Bentuk nilai SHAP (petak, fitur, kelas):", sv.values.shape)

# Satu petak: mengapa model menjawab seperti itu?
i = 0
proba = model.predict_proba(X_uji.iloc[[i]])[0]
k = int(np.argmax(proba))
print(f"\nPetak uji #{i}: kelas sebenarnya = {y_uji.iloc[i]}, prediksi = {kelas[k]} (peluang {proba[k]:.2f})")
print("Nilai fitur :", X_uji.iloc[i].round(2).to_dict())
print(f"Peluang dasar kelas '{kelas[k]}' (rata-rata data latih): {sv.base_values[i, k]:.3f}")
for nama, nilai in sorted(zip(FITUR, sv.values[i, :, k]), key=lambda p: -abs(p[1])):
    print(f"  {nama:20s} {nilai:+.3f}")
print("Dasar + jumlah kontribusi =", round(sv.base_values[i, k] + sv.values[i, :, k].sum(), 3), "| peluang model =", round(proba[k], 3))

# Gambaran global: rata-rata |SHAP| per fitur untuk kelas 'hutan'
kh = kelas.index("hutan")
penting = np.abs(sv.values[:, :, kh]).mean(axis=0)
print("\nRata-rata |SHAP| untuk kelas 'hutan':")
for nama, nilai in sorted(zip(FITUR, penting), key=lambda p: -p[1]):
    print(f"  {nama:20s} {nilai:.3f}")
Bentuk nilai SHAP (petak, fitur, kelas): (100, 4, 4)
Petak uji #0: kelas sebenarnya = kebun, prediksi = kebun (peluang 0.78)
Nilai fitur : {'ndvi': 0.59, 'elevasi_m': 237.0, 'kemiringan_derajat': 3.7, 'curah_hujan_mm': 2174.0}
Peluang dasar kelas 'kebun' (rata-rata data latih): 0.121
elevasi_m +0.424
ndvi +0.199
kemiringan_derajat +0.039
curah_hujan_mm +0.001
Dasar + jumlah kontribusi = 0.784 | peluang model = 0.784
Rata-rata |SHAP| untuk kelas 'hutan':
elevasi_m 0.131
kemiringan_derajat 0.108
ndvi 0.066
curah_hujan_mm 0.009- Bentuk
(100, 4, 4): 100 petak, 4 fitur, 4 kelas. Tiap kelas punya penjelasan sendiri. - Petak uji #0 (sebenarnya
kebun) diprediksikebundengan peluang 0,78. Peluang dasar kelas kebun hanya 0,121. Elevasi 237 m menambah +0,424 dan NDVI 0,59 menambah +0,199; kemiringan dan curah hujan hampir tak berperan. - Buktinya:
0,121 + 0,424 + 0,199 + 0,039 + 0,001= 0,784, sama dengan peluang model (0,784). Penjelasan SHAP benar-benar menjumlah ke prediksi. - Secara global, untuk kelas
hutan: elevasi (rata-rata |SHAP| 0,131) dan kemiringan (0,108) paling berpengaruh. Bandingkan dengan bawaan RF di Bab 54 yang menaruh NDVI di puncak; ukuran yang berbeda menjawab pertanyaan yang berbeda (di sini: pengaruh pada kelas hutan saja).
LIME: tetangga acak dan model sederhana
LIME menjelaskan satu prediksi dengan cara lain: ia membuat ribuan petak “tetangga” dengan mengacak fitur di sekitar petak itu, meminta model asli menebaknya, lalu mencocokkan model linear sederhana pada hasilnya. Koefisien model sederhana itulah penjelasannya. Kita jalankan tiga kali dengan pengacakan LIME berbeda.
03_lime.py
# Bab 58 - LIME: menjelaskan SATU prediksi dengan model sederhana di sekitar titik itu
import pandas as pd
from lime.lime_tabular import LimeTabularExplainer
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split

from buat_data import FITUR, buat_lahan

df = buat_lahan()
X_latih, X_uji, y_latih, y_uji = train_test_split(df[FITUR], df["kelas"], test_size=0.3, random_state=42, stratify=df["kelas"])
model = RandomForestClassifier(n_estimators=100, max_depth=8, random_state=42, n_jobs=1).fit(X_latih, y_latih)

def prediksi(larik):                                      # LIME mengirim larik NumPy; model kita dilatih dengan DataFrame
    return model.predict_proba(pd.DataFrame(larik, columns=FITUR))


k = list(model.classes_).index("kebun")
for biji in (42, 1, 2):                                   # jalankan tiga kali dengan pengacakan LIME berbeda
    penjelas = LimeTabularExplainer(X_latih.values, feature_names=FITUR, class_names=list(model.classes_),
                                    discretize_continuous=True, random_state=biji)
    penjelasan = penjelas.explain_instance(X_uji.values[0], prediksi, num_features=4, num_samples=2000, labels=[k])
    print(f"Petak uji #0, kelas 'kebun', random_state LIME = {biji}  (R2 model lokal = {penjelasan.score:.2f})")
    for aturan, bobot in penjelasan.as_list(label=k):
        print(f"  {aturan:45s} {bobot:+.3f}")
Petak uji #0, kelas 'kebun', random_state LIME = 42 (R2 model lokal = 0.03)
0.38 < ndvi <= 0.61 +0.082
1.00 < kemiringan_derajat <= 4.15 -0.053
114.50 < elevasi_m <= 237.25 -0.004
2117.50 < curah_hujan_mm <= 2245.00 -0.001
Petak uji #0, kelas 'kebun', random_state LIME = 1 (R2 model lokal = 0.02)
0.38 < ndvi <= 0.61 +0.066
1.00 < kemiringan_derajat <= 4.15 -0.039
2117.50 < curah_hujan_mm <= 2245.00 -0.017
114.50 < elevasi_m <= 237.25 -0.001
Petak uji #0, kelas 'kebun', random_state LIME = 2 (R2 model lokal = 0.02)
0.38 < ndvi <= 0.61 +0.050
1.00 < kemiringan_derajat <= 4.15 -0.044
114.50 < elevasi_m <= 237.25 -0.025
2117.50 < curah_hujan_mm <= 2245.00 +0.009LIME sepakat dengan SHAP pada arah umum: 0,38 < ndvi <= 0,61 mendorong ke kebun. Tetapi lihat tanda peringatannya:
- Angka tiap jalan berbeda (bobot NDVI +0,082, +0,066, +0,050) dan urutan fitur lemah berubah. LIME tidak stabil karena memakai sampel acak.
- R² model lokal hanya 0,02 sampai 0,03: model sederhana itu hampir tidak bisa meniru model asli di sekitar petak ini. Penjelasannya tidak dapat dipercaya sebagai rincian.
- SHAP sebaliknya eksak untuk pohon dan menjumlah ke prediksi. Untuk model berbasis pohon, utamakan SHAP; LIME berguna untuk model yang tidak punya penjelas khusus, dengan skeptisisme dan pemeriksaan R².
Partial dependence: bentuk hubungan
Partial dependence menjawab “bila fitur ini digeser, bagaimana prediksi rata-rata berubah?” dengan mengganti nilai satu fitur pada semua baris, lalu merata-ratakan prediksinya.
04_pdp.py
# Bab 58 - Partial dependence: bagaimana prediksi rata-rata berubah bila SATU fitur digeser
import numpy as np
from sklearn.ensemble import RandomForestRegressor
from sklearn.inspection import partial_dependence

from buat_data import FITUR, buat_lahan

df = buat_lahan()
sawah = df[df["kelas"] == "sawah"].copy()
rng = np.random.default_rng(7)
sawah["panen_kg_ha"] = (4000 + 5000 * np.sin(np.pi * sawah["ndvi"].clip(0, 1))
                        + 0.8 * (sawah["curah_hujan_mm"] - 2200) + rng.normal(0, 250, len(sawah))).round(0)
kolom = ["ndvi", "curah_hujan_mm", "elevasi_m"]
model = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=1).fit(sawah[kolom], sawah["panen_kg_ha"])

for fitur in ["ndvi", "curah_hujan_mm"]:
    pd_ = partial_dependence(model, sawah[kolom], [fitur], grid_resolution=6)
    print(f"\nPartial dependence panen terhadap {fitur}:")
    for nilai, pred in zip(pd_["grid_values"][0], pd_["average"][0]):
        print(f"  {fitur} = {nilai:8.2f}  ->  panen rata-rata = {pred:7.0f} kg/ha")
Partial dependence panen terhadap ndvi:
  ndvi =     0.25  ->  panen rata-rata =    7259 kg/ha
  ndvi =     0.33  ->  panen rata-rata =    8175 kg/ha
  ndvi =     0.41  ->  panen rata-rata =    8708 kg/ha
  ndvi =     0.49  ->  panen rata-rata =    8830 kg/ha
  ndvi =     0.57  ->  panen rata-rata =    8759 kg/ha
  ndvi =     0.65  ->  panen rata-rata =    8185 kg/ha

Partial dependence panen terhadap curah_hujan_mm:
  curah_hujan_mm =  1811.42  ->  panen rata-rata =    8372 kg/ha
  curah_hujan_mm =  1929.86  ->  panen rata-rata =    8404 kg/ha
  curah_hujan_mm =  2048.30  ->  panen rata-rata =    8490 kg/ha
  curah_hujan_mm =  2166.73  ->  panen rata-rata =    8524 kg/ha
  curah_hujan_mm =  2285.17  ->  panen rata-rata =    8653 kg/ha
  curah_hujan_mm =  2403.61  ->  panen rata-rata =    8675 kg/ha
Panen sawah (angka contoh) naik dari 7.259 kg/ha pada NDVI 0,25 hingga puncak 8.830 pada NDVI 0,49, lalu turun ke 8.185 pada NDVI 0,65: hubungannya melengkung, seperti yang kita susun di Bab 54. Curah hujan hanya menaikkan panen perlahan, dari 8.372 ke 8.675. Hubungan seperti ini tidak terlihat dari angka feature_importances_ saja.
Penjelasan model menerangkan apa yang dilakukan model, bukan apa yang terjadi di alam. “NDVI tinggi mendorong prediksi hutan” tidak berarti menaikkan NDVI akan menjadikan petak itu hutan. Hubungan sebab-akibat membutuhkan desain penelitian, bukan hanya model (Bab 26-27).
MLflow: buku catatan percobaan
Setelah puluhan percobaan, siapa ingat model mana memakai parameter apa dan hasilnya berapa? MLflow (tracking) mencatat parameter, metrik, dan berkas tiap percobaan (run) ke penyimpanan lokal atau server. Kita memakai basis data SQLite di folder _tmp/, tanpa server apa pun.
05_mlflow.py
# Bab 58 - MLflow: mencatat percobaan (parameter, metrik, model) ke folder lokal, tanpa server
import logging
import shutil
from pathlib import Path

import mlflow
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GroupKFold, cross_val_score

from buat_data import FITUR, buat_lahan

logging.disable(logging.INFO)                         # sembunyikan log INFO MLflow yang berisi jam
folder = Path(__file__).parent / "_tmp" / "mlflow_lokal"
shutil.rmtree(folder, ignore_errors=True)
folder.mkdir(parents=True)
mlflow.set_tracking_uri(f"sqlite:///{(folder / 'mlflow.db').as_posix()}")        # basis data SQLite lokal
mlflow.set_experiment("tutupan-lahan")

df = buat_lahan()
for n_pohon, kedalaman in [(50, 4), (100, 8), (200, 12)]:
    with mlflow.start_run(run_name=f"rf_{n_pohon}_{kedalaman}"):
        model = RandomForestClassifier(n_estimators=n_pohon, max_depth=kedalaman, random_state=42, n_jobs=1)
        skor = cross_val_score(model, df[FITUR], df["kelas"], groups=df["blok"], cv=GroupKFold(n_splits=4))
        mlflow.log_params({"n_estimators": n_pohon, "max_depth": kedalaman, "validasi": "GroupKFold blok"})
        mlflow.log_metric("akurasi_blok", float(skor.mean()))
        mlflow.log_metric("simpangan_baku", float(skor.std()))

hasil = mlflow.search_runs(experiment_names=["tutupan-lahan"], order_by=["metrics.akurasi_blok DESC"])
print("Jumlah percobaan tercatat:", len(hasil))
print(hasil[["tags.mlflow.runName", "params.n_estimators", "params.max_depth", "metrics.akurasi_blok"]]
      .round(3).to_string(index=False))
print("\nBerkas basis data MLflow ada:", (folder / "mlflow.db").exists())
Jumlah percobaan tercatat: 3
tags.mlflow.runName params.n_estimators params.max_depth metrics.akurasi_blok
rf_200_12 200 12 0.889
rf_100_8 100 8 0.884
rf_50_4 50 4 0.876
Berkas basis data MLflow ada: TrueTiga percobaan (50, 100, dan 200 pohon) tercatat dan search_runs mengurutkannya dari akurasi blok tertinggi: 0,889 untuk 200 pohon kedalaman 12. Di komputer Anda, mlflow ui --backend-store-uri sqlite:///... membuka antarmuka web untuk membandingkannya (tidak dijalankan di buku ini). Dokumentasi tentang pilihan penyimpanan MLflow tidak berhasil kami baca hari ini, jadi buku ini hanya menyatakan bahwa jalur SQLite berjalan di versi MLflow yang terpasang.
Catat juga versi data dan kode (hash Git) sebagai parameter. Tanpa itu, “model 0,889” tidak bisa direproduksi tiga bulan lagi.
DVC: versi untuk data
Git hebat untuk kode tetapi buruk untuk berkas data besar. DVC (Data Version Control) menyimpan data di tempat lain (disk bersama, cloud) dan hanya memasukkan berkas kecil .dvc yang berisi sidik jari (hash) data ke Git. Mengubah data mengubah sidik jarinya, sehingga Git mencatat versi data bersama versi kode.
DVC belum bisa dipasang di Python 3.14 milik buku ini: pip gagal menyelesaikan dependensinya (percobaan 2026-10-10). Kami memasangnya di lingkungan Python 3.12 terpisah (DVC 3.67.1) dan mengambil keluaran asli sekali; naskah ini memakai keluaran tersimpan itu (@statis), jadi skrip di bawah tidak dijalankan ulang saat buku dibuat.
09_dvc_versi_data.py
# Bab 58 - DVC: versi data seperti Git untuk berkas besar (dijalankan lewat perintah dvc di folder sementara)
import os
import shutil
import stat
import subprocess
from pathlib import Path

kerja = Path(__file__).parent / "_tmp" / "demo_dvc"


def paksa_hapus(fungsi, jalur, galat):                  # DVC membuat berkas cache read-only di Windows; izinkan dulu lalu hapus
    os.chmod(jalur, stat.S_IWRITE)
    fungsi(jalur)


if kerja.exists():
    shutil.rmtree(kerja, onexc=paksa_hapus)
kerja.mkdir(parents=True)
os.environ["DVC_NO_ANALYTICS"] = "1"


def dvc(*argumen):
    hasil = subprocess.run(["dvc", *argumen], cwd=kerja, capture_output=True, text=True)
    print("$ dvc", *argumen)
    print((hasil.stdout + hasil.stderr).strip())


(kerja / "lahan.csv").write_text("petak,ndvi\n1,0.81\n2,0.35\n3,0.62\n", encoding="utf-8")
dvc("init", "--no-scm")                    # --no-scm: tanpa Git, hanya untuk demo
dvc("add", "lahan.csv")
print("\nIsi lahan.csv.dvc (berkas kecil yang dimasukkan ke Git):")
print((kerja / "lahan.csv.dvc").read_text(encoding="utf-8"))
dvc("status")
(kerja / "lahan.csv").write_text("petak,ndvi\n1,0.81\n2,0.35\n3,0.62\n4,0.48\n", encoding="utf-8")   # data berubah
print("\nSetelah data diubah:")
dvc("status")
$ dvc init --no-scm
Initialized DVC repository.
What's next?
------------
- Check out the documentation: <https://dvc.org/doc>
- Get help and share ideas: <https://dvc.org/chat>
- Star us on GitHub: <https://github.com/treeverse/dvc>
$ dvc add lahan.csv
Isi lahan.csv.dvc (berkas kecil yang dimasukkan ke Git):
outs:
- md5: 02302a68c615060922d2eaa491ffb4e3
size: 36
hash: md5
path: lahan.csv
$ dvc status
Data and pipelines are up to date.
Setelah data diubah:
$ dvc status
lahan.csv.dvc:
changed outs:
modified: lahan.csvdvc init --no-scmmenyiapkan DVC tanpa Git (hanya untuk demo; di proyek nyata Anda memakai Git).dvc add lahan.csvmenghitung hash md502302a68...dan menulislahan.csv.dvc. Berkas kecil inilah yang Andagit add.dvc statusberkata “up to date” lalu, setelah kita menambah satu baris data, melaporkanmodified: lahan.csv: DVC menyadari data berubah dari hash-nya.- Perintah
dvc pushdandvc pull(untuk mengirim data ke penyimpanan jarak jauh) tidak dicoba di sini.
Memantau model: drift
Model dilatih dari potret masa lalu. Dunia berubah: sensor menua, musim kemarau panjang, kebijakan mengubah tanam. Pergeseran distribusi data masukan disebut data drift. Cara paling sederhana mendeteksinya: bandingkan distribusi tiap fitur antara data latih dan data baru dengan uji Kolmogorov-Smirnov (scipy.stats.ks_2samp). P-value kecil berarti dua sebaran sangat mungkin berbeda.
06_drift_ks.py
# Bab 58 - Memantau drift: apakah data baru masih "sejenis" dengan data latih? (uji Kolmogorov-Smirnov)
import numpy as np
from scipy.stats import ks_2samp

from buat_data import FITUR, buat_lahan

semua = buat_lahan(n=2400, benih=42)
acak = np.random.default_rng(0).permutation(len(semua))
latih = semua.iloc[acak[:1200]]                       # data waktu model dilatih
aman = semua.iloc[acak[1200:1800]]                    # data baru dari proses yang sama
bergeser = semua.iloc[acak[1800:]].copy()             # data baru, tetapi kondisi lapangan berubah
bergeser["ndvi"] = (bergeser["ndvi"] - 0.08).round(3)                    # sensor menua / musim kering: NDVI turun 0,08
bergeser["curah_hujan_mm"] = bergeser["curah_hujan_mm"] * 0.85           # curah hujan 15% lebih rendah

print("fitur                | data baru normal (p) | data baru bergeser (p)")
for f in FITUR:
    p_aman = ks_2samp(latih[f], aman[f]).pvalue
    p_geser = ks_2samp(latih[f], bergeser[f]).pvalue
    tanda = "  <- DRIFT" if p_geser < 0.01 else ""
    print(f"{f:20s} | {p_aman:20.3f} | {p_geser:22.4g}{tanda}")


def psi(a, b, k=10):
    """Population Stability Index: <0,1 stabil, 0,1-0,25 waspada, >0,25 berubah besar (aturan praktis industri)."""
    batas = np.quantile(a, np.linspace(0, 1, k + 1))
    batas[0], batas[-1] = -np.inf, np.inf
    pa = np.histogram(a, batas)[0] / len(a) + 1e-6
    pb = np.histogram(b, batas)[0] / len(b) + 1e-6
    return float(((pb - pa) * np.log(pb / pa)).sum())


print("\nPSI NDVI, data normal  :", round(psi(latih["ndvi"], aman["ndvi"]), 3))
print("PSI NDVI, data bergeser:", round(psi(latih["ndvi"], bergeser["ndvi"]), 3))
fitur | data baru normal (p) | data baru bergeser (p)
ndvi | 0.412 | 1.368e-05 <- DRIFT
elevasi_m | 0.995 | 0.679
kemiringan_derajat | 0.882 | 0.4124
curah_hujan_mm | 0.595 | 1.046e-132 <- DRIFT
PSI NDVI, data normal : 0.01
PSI NDVI, data bergeser: 0.166- Data baru “normal” (diambil dari peta yang sama) p-value 0,412 untuk NDVI, 0,995 untuk elevasi: tidak ada drift, sesuai harapan.
- Setelah NDVI diturunkan 0,08 dan curah hujan dikurangi 15%, uji KS menandai keduanya (p = 1,4 x 10^-5 dan 1 x 10^-132). Elevasi dan kemiringan tidak berubah dan tidak ditandai.
- PSI (population stability index) merangkum pergeseran dengan satu angka: 0,010 (normal) vs 0,166 (bergeser). Ambang “di bawah 0,1 stabil, 0,1 sampai 0,25 waspada, di atas 0,25 berubah besar” adalah aturan praktis industri, bukan standar baku.
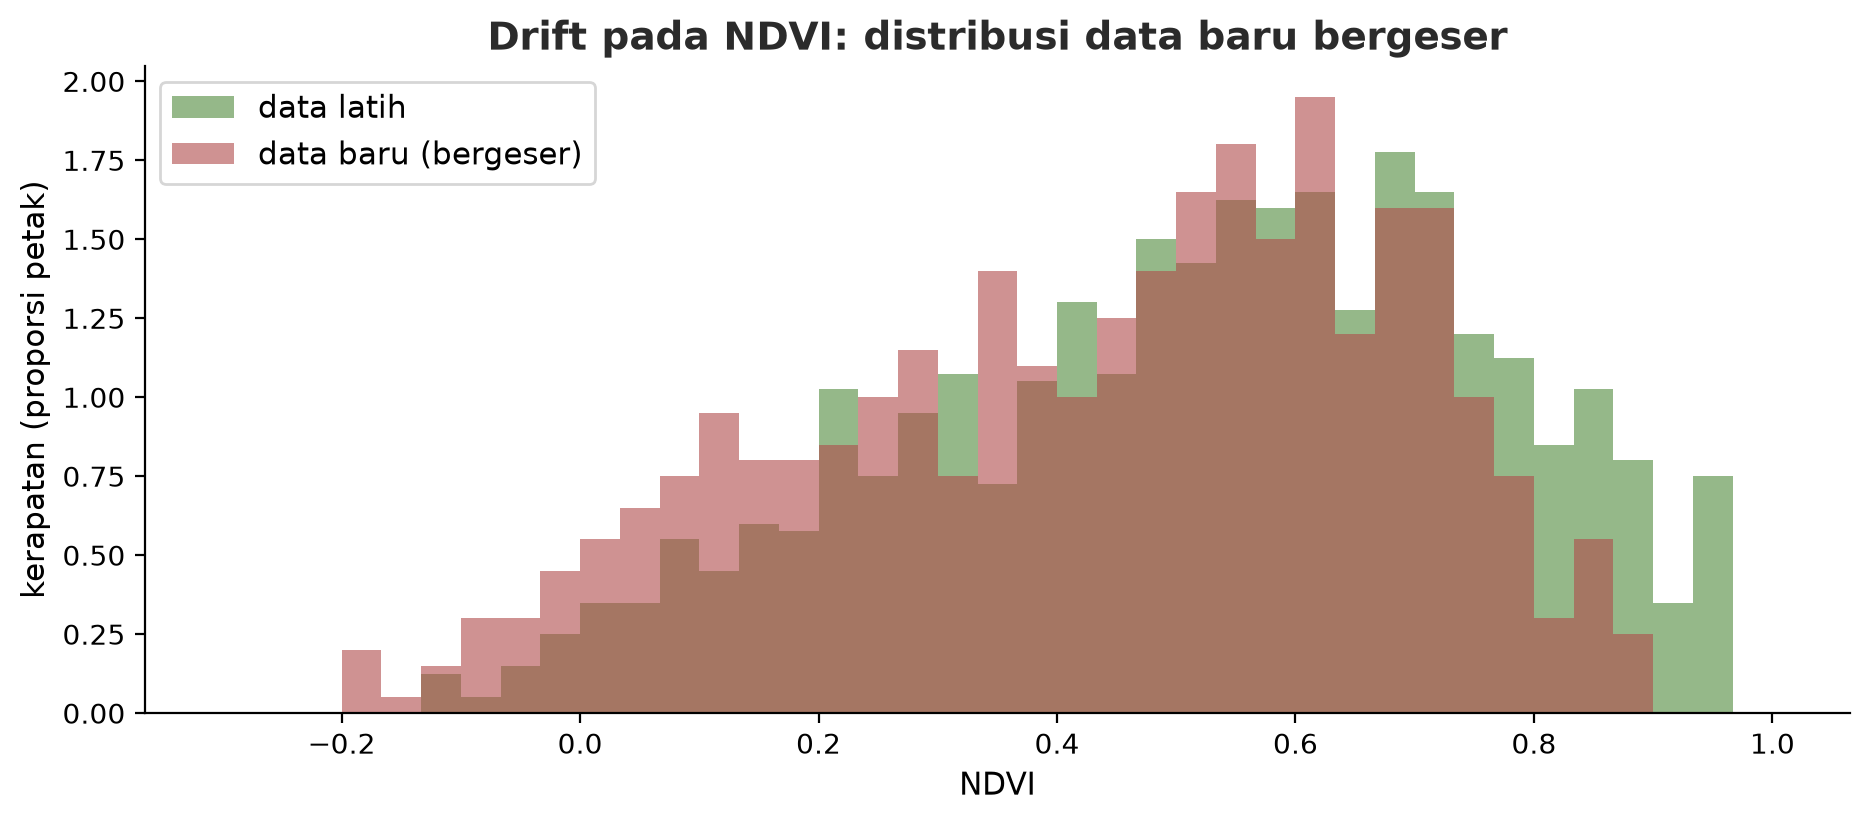
Uji KS dengan data besar sangat sensitif: perbedaan kecil yang tak berdampak bisa menghasilkan p-value mungil. Lengkapi dengan ukuran besarnya pergeseran (PSI, selisih rata-rata) dan, bila tersedia, kinerja model sebenarnya pada data berlabel terbaru. Drift pada fitur tidak otomatis berarti model buruk.
Ketidakpastian prediksi
Model yang berkata “panen 8.696 kg/ha” tanpa rentang itu terdengar lebih yakin daripada seharusnya. Dua cara memberi rentang:
- Sebaran pohon: tiap pohon di random forest memberi prediksi sendiri; sebarannya menggambarkan perbedaan pendapat. Mudah, tetapi cakupannya tidak dijamin.
- Conformal prediction (versi split): sisihkan data kalibrasi, ukur galat sebenarnya model pada data itu, lalu pakai kuantil galat sebagai lebar selang. Dengan asumsi data kalibrasi dan data baru sejenis, ia menjamin cakupan minimal sekitar tingkat yang diminta (di sini 90%) rata-rata.
07_ketidakpastian.py
# Bab 58 - Ketidakpastian prediksi: selang dari sebaran pohon, dan "conformal prediction" yang cakupannya teruji
import numpy as np
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import train_test_split

from buat_data import buat_lahan

df = buat_lahan()
rng = np.random.default_rng(7)
sawah = df[df["kelas"] == "sawah"].copy()
sawah["panen_kg_ha"] = (4000 + 5000 * np.sin(np.pi * sawah["ndvi"].clip(0, 1))
                        + 0.8 * (sawah["curah_hujan_mm"] - 2200) + rng.normal(0, 250, len(sawah))).round(0)
kolom = ["ndvi", "curah_hujan_mm", "elevasi_m"]
X_sisa, X_uji, y_sisa, y_uji = train_test_split(sawah[kolom], sawah["panen_kg_ha"], test_size=0.3, random_state=1)
X_latih, X_kal, y_latih, y_kal = train_test_split(X_sisa, y_sisa, test_size=0.4, random_state=1)   # kalibrasi terpisah
model = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=1).fit(X_latih, y_latih)

# 1) Sebaran prediksi 200 pohon untuk satu petak
semua_pohon = np.array([p.predict(X_uji.iloc[[0]].values)[0] for p in model.estimators_])
print(f"Petak uji #0: prediksi forest = {model.predict(X_uji.iloc[[0]])[0]:.0f} kg/ha, kenyataan = {y_uji.iloc[0]:.0f}")
print(f"  pohon-pohon berbeda pendapat: 10%-90% = {np.percentile(semua_pohon, 10):.0f} sampai {np.percentile(semua_pohon, 90):.0f}")

# 2) Split conformal prediction: ukur galat nyata pada data kalibrasi, pakai sebagai lebar selang
galat = np.abs(y_kal - model.predict(X_kal))
alfa = 0.1                                                                  # target cakupan 90%
n = len(galat)
q = np.quantile(galat, min(1.0, np.ceil((n + 1) * (1 - alfa)) / n))
pred = model.predict(X_uji)
tercakup = np.mean((y_uji >= pred - q) & (y_uji <= pred + q))
print(f"\nConformal: lebar selang = +-{q:.0f} kg/ha (dari {n} petak kalibrasi)")
print(f"Cakupan pada {len(y_uji)} petak uji (target 90%): {tercakup:.0%}")

# Selang 10%-90% dari sebaran pohon tidak dijamin memenuhi cakupan
lo, hi = [], []
for x in X_uji.values:
    ps = np.array([p.predict(x.reshape(1, -1))[0] for p in model.estimators_])
    lo.append(np.percentile(ps, 5)), hi.append(np.percentile(ps, 95))
print("Cakupan selang 5%-95% sebaran pohon (nominal 90%):", f"{np.mean((y_uji >= lo) & (y_uji <= hi)):.0%}")
Petak uji #0: prediksi forest = 8696 kg/ha, kenyataan = 8692
pohon-pohon berbeda pendapat: 10%-90% = 8389 sampai 9273
Conformal: lebar selang = +-564 kg/ha (dari 92 petak kalibrasi)
Cakupan pada 98 petak uji (target 90%): 97%
Cakupan selang 5%-95% sebaran pohon (nominal 90%): 82%- Petak #0: prediksi 8.696, kenyataan 8.692; pohon-pohon berbeda pendapat di rentang 8.389 sampai 9.273 (persentil 10-90).
- Conformal: selang ±564 kg/ha dari 92 petak kalibrasi, cakupan di 98 petak uji 97% (target minimal 90%). Cakupan lebih tinggi daripada target adalah hal wajar: jaminannya batas bawah rata-rata dan sampel kecil bisa membuat selang konservatif.
- Selang 5%-95% dari sebaran pohon yang diberi label “90%” hanya mencakup 82% kenyataan: terlalu percaya diri. Tanpa pengujian cakupan seperti ini, kita tidak tahu selang mana yang jujur.
Bias, privasi, dan model card
Bias di sini berarti model bekerja buruk untuk kelompok tertentu tanpa disadari karena akurasi keseluruhan menutupinya. Periksa kinerja per kelompok: per kelas, per wilayah, per musim, per kelompok pemilik lahan bila datanya ada. Privasi: koordinat petak milik perorangan bisa menunjukkan siapa pemiliknya; kaburkan sebelum data dibagikan. Model card adalah dokumen ringkas (diusulkan peneliti sebagai praktik dokumentasi model) berisi tujuan, data, evaluasi, kelemahan, dan batas pemakaian model.
08_bias_dan_model_card.py
# Bab 58 - Bias antar-wilayah, pengaburan koordinat (privasi), dan model card
import json
from pathlib import Path

import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GroupKFold, cross_val_predict

from buat_data import FITUR, buat_lahan

df = buat_lahan()
model = RandomForestClassifier(n_estimators=100, max_depth=8, random_state=42, n_jobs=1)
df["prediksi"] = cross_val_predict(model, df[FITUR], df["kelas"], groups=df["blok"], cv=GroupKFold(n_splits=4))
df["benar"] = df["prediksi"] == df["kelas"]

# 1) Kinerja per kelompok: akurasi keseluruhan bisa menyembunyikan kelompok yang diperlakukan buruk
print("Akurasi keseluruhan:", round(df["benar"].mean(), 3))
print("\nAkurasi per kelas sebenarnya (recall):")
print(df.groupby("kelas")["benar"].agg(["mean", "size"]).round(3).rename(columns={"mean": "akurasi", "size": "jumlah"}).to_string())
df["wilayah"] = np.where(df["x"] < 500, "barat", "timur")
print("\nAkurasi per wilayah:")
print(df.groupby("wilayah")["benar"].agg(["mean", "size"]).round(3).rename(columns={"mean": "akurasi", "size": "jumlah"}).to_string())

# 2) Privasi: koordinat petak milik perorangan bisa dikaburkan sebelum data dibagikan
publik = df[["x", "y"]].copy()
publik["x"], publik["y"] = (publik["x"] // 100) * 100, (publik["y"] // 100) * 100       # dibulatkan ke sel 100 m
print("\nTitik unik sebelum dikaburkan:", len(df[["x", "y"]].drop_duplicates()), "| sesudah:", len(publik.drop_duplicates()))

# 3) Model card: dokumen ringkas tentang model, dibuat dari angka nyata percobaan
kartu = {
    "nama": "Klasifikasi tutupan lahan (random forest, contoh buku)",
    "tujuan": "Memetakan empat kelas lahan dari NDVI, elevasi, kemiringan, curah hujan pada data TIRUAN",
    "data": f"{len(df)} petak tiruan, peta 1000 x 1000 m, 4 kelas",
    "evaluasi": f"GroupKFold 4 lipatan berbasis blok 250 m; akurasi {df['benar'].mean():.3f}",
    "kelemahan": "kelas terlemah: " + df.groupby("kelas")["benar"].mean().idxmin(),
    "bukan_untuk": ["keputusan hukum atau sanksi", "wilayah dengan sensor atau musim berbeda tanpa validasi ulang"],
    "pemantauan": "uji KS dan PSI pada NDVI dan curah hujan tiap bulan",
}
berkas = Path(__file__).parent / "_tmp" / "model_card.json"
berkas.parent.mkdir(exist_ok=True)
berkas.write_text(json.dumps(kartu, indent=2, ensure_ascii=False), encoding="utf-8")
print("\nIsi model card:")
print(berkas.read_text(encoding="utf-8"))
Akurasi keseluruhan: 0.884
Akurasi per kelas sebenarnya (recall):
akurasi jumlah
kelas
hutan 0.939 198
kebun 0.753 146
permukiman 0.928 530
sawah 0.837 326
Akurasi per wilayah:
akurasi jumlah
wilayah
barat 0.905 602
timur 0.863 598
Titik unik sebelum dikaburkan: 1200 | sesudah: 100
Isi model card:
{
"nama": "Klasifikasi tutupan lahan (random forest, contoh buku)",
"tujuan": "Memetakan empat kelas lahan dari NDVI, elevasi, kemiringan, curah hujan pada data TIRUAN",
"data": "1200 petak tiruan, peta 1000 x 1000 m, 4 kelas",
"evaluasi": "GroupKFold 4 lipatan berbasis blok 250 m; akurasi 0.884",
"kelemahan": "kelas terlemah: kebun",
"bukan_untuk": [
"keputusan hukum atau sanksi",
"wilayah dengan sensor atau musim berbeda tanpa validasi ulang"
],
"pemantauan": "uji KS dan PSI pada NDVI dan curah hujan tiap bulan"
}- Akurasi keseluruhan 0,884 terdengar baik, tetapi kelas
kebunhanya 0,753 sementarahutan0,939. Peta yang dipakai untuk kebijakan kebun akan paling sering salah. - Wilayah barat 0,905 vs timur 0,863: sedikit lebih buruk di timur. Selisih sekecil ini bisa kebetulan; yang penting adalah memeriksa.
- 1.200 titik unik menjadi 100 sel setelah koordinat dibulatkan ke 100 m. Pengaburan mengurangi risiko, tetapi tidak menjamin anonimitas bila data lain bisa dicocokkan.
- Model card dibuat dari angka nyata percobaan, lengkap dengan “bukan untuk” (keputusan hukum atau sanksi) dan rencana pemantauan.
Proyek Bersambung A3: model yang dapat dipertanggungjawabkan
Proyek ini bukan skrip baru, tetapi kebiasaan: untuk setiap model Seri A3, siapkan lima hal berikut sebelum menyerahkan peta kepada pengguna.
| Pertanyaan pengguna | Alat di bab ini |
|---|---|
| “Mengapa petak ini begini?” | SHAP (skrip 02), partial dependence (04) |
| “Percobaan mana yang dipakai, bisa diulang?” | MLflow (05), DVC (09) |
| “Masih berlaku tahun depan?” | KS dan PSI (06) |
| “Seberapa yakin?” | Conformal (07) |
| “Adil dan aman?” | Akurasi per kelompok, pengaburan koordinat, model card (08) |
Latihan
- Di
02_shap_rf.py, gantii = 0dengan petak lain dan tulis penjelasan satu kalimat dari angka SHAP-nya. - Di
03_lime.py, naikkannum_samplesdari 2000 menjadi 20000. Apakah R² lokal dan kestabilan antar-jalan membaik? - Di
06_drift_ks.py, kurangi NDVI hanya 0,01. Apakah KS masih menandai drift? Apa arti hasilnya? - Tantangan: ubah
07_ketidakpastian.pyagar mencoba targetalfa = 0.2(cakupan 80%) dan 0.05 (95%). Apakah cakupan nyata mengikuti targetnya?
Ringkasan Bab
- Ukuran pentingnya fitur bawaan bisa menyesatkan bila fitur berkorelasi; coba permutasi.
- SHAP menjelaskan tiap prediksi dengan kontribusi yang menjumlah; LIME acak dan bisa tidak stabil; partial dependence menunjukkan bentuk hubungan.
- MLflow mencatat percobaan; DVC memberi versi pada data lewat hash.
- Drift: bandingkan sebaran data baru dengan data latih (KS, PSI), dan jangan lupa memantau kinerja sebenarnya.
- Beri selang ketidakpastian yang cakupannya diuji (conformal).
- Periksa kinerja per kelompok, kaburkan data pribadi, dan tulis model card.
Selanjutnya, di Bab 59: semua perkakas Seri A3 bertemu di lapangan: kehutanan, pertanian, perikanan, peternakan, dan sumber daya alam, dari LiDAR sampai ternak dalam foto udara.