%%{init: {"flowchart": {"diagramPadding": 40}}}%%
flowchart LR
    A[1. Kumpulkan<br/>dan bersihkan data] --> B[2. Bagi: latih,<br/>validasi, uji]
    B --> C[3. Pilih model<br/>dan fungsi galat]
    C --> D[4. Latih:<br/>ulangi epoch]
    D --> E[5. Evaluasi<br/>pada data uji]
    E -->|kurang bagus| C
    E -->|cukup bagus| F[6. Pakai dan pantau<br/>Bab 58]
Bab 55 — Machine Learning dan AI: PyTorch dan Hardware GPU
Seri A3 — Machine Learning untuk Sumber Daya Alam
Semua skrip bab ini ada di folder kode/bab55/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Bab 54 memakai model berbasis pohon pada tabel angka. Untuk citra, suara, dan pola yang rumit, model terbaik adalah jaringan saraf (neural network): tumpukan “neuron” kecil yang masing-masing hanya mengalikan dan menjumlahkan angka, tetapi bila jumlahnya jutaan, mereka bisa mengenali daun sakit dari foto. Melatihnya membutuhkan miliaran perkalian. Itulah mengapa bab ini juga membahas perangkat keras: dengan GPU yang tepat, pekerjaan yang butuh hari di CPU selesai dalam menit.
CatatanINGAT
Bab ini ditulis di satu komputer: GPU NVIDIA GeForce GTX 1660 SUPER (VRAM 6 GB), driver 616.92, CUDA Toolkit 13.4, PyTorch 2.14.1 build CUDA 13.0. Keluaran “nama GPU” dan angka memori di buku adalah keluaran komputer penulis. Komputer Anda akan mencetak hal yang berbeda, dan itu normal.
Alur kerja ML
Apa pun modelnya, urutan kerjanya sama:
Satu putaran data penuh disebut epoch. Data dipecah menjadi potongan kecil (batch) agar muat di memori.
PyTorch: tensor dan autograd
PyTorch adalah pustaka deep learning yang paling banyak dipakai di riset. Dua gagasan intinya: tensor (array angka seperti NumPy, tetapi bisa dipindah ke GPU) dan autograd (menghitung turunan secara otomatis).
01_tensor_autograd.py
# Bab 55 - Tensor dan autograd: PyTorch menghitung turunan (gradien) secara otomatis
import torch

# Tensor = array angka (seperti NumPy) yang bisa pindah ke GPU
curah = torch.tensor([[120.0, 95.0], [200.0, 150.0]])
print("Tensor:", curah.tolist(), "| bentuk:", tuple(curah.shape), "| tipe:", curah.dtype)
print("Dikali 2:", (curah * 2).tolist())

# Model paling sederhana: panen = w * curah. Kita cari w dengan menurunkan galat
w = torch.tensor(0.0, requires_grad=True)             # requires_grad: "tolong catat turunan untuk saya"
curah_x = torch.tensor([1.0, 2.0, 3.0])
panen_y = torch.tensor([2.1, 3.9, 6.2])               # angka contoh, kira-kira y = 2x

for langkah in range(60):
    tebakan = w * curah_x
    galat = ((tebakan - panen_y) ** 2).mean()          # rata-rata kuadrat galat (MSE)
    galat.backward()                                   # hitung d(galat)/dw secara otomatis
    with torch.no_grad():
        w -= 0.05 * w.grad                             # geser w ke arah yang menurunkan galat
    w.grad.zero_()                                     # kosongkan catatan turunan untuk langkah berikutnya
    if langkah in (0, 1, 2, 59):
        print(f"langkah {langkah:2d}: w = {w.item():.4f}, galat = {galat.item():.4f}")
Tensor: [[120.0, 95.0], [200.0, 150.0]] | bentuk: (2, 2) | tipe: torch.float32
Dikali 2: [[240.0, 190.0], [400.0, 300.0]]
langkah 0: w = 0.9500, galat = 19.3533
langkah 1: w = 1.4567, galat = 5.5150
langkah 2: w = 1.7269, galat = 1.5788
langkah 59: w = 2.0357, galat = 0.0140Kita mencari bobot w pada model panen = w x curah. Data contoh kira-kira y = 2x. galat.backward() menghitung seberapa besar galat berubah bila w digeser sedikit (gradien), lalu w digeser ke arah yang menurunkan galat. Ini gradient descent, jantung semua pelatihan jaringan saraf. Setelah 60 langkah, w mendekati 2 (2,0357) dan galat turun dari 19,35 menjadi 0,014.
Alur lengkap pada data tabel (CPU)
Sekarang semua tahap digabung: data kolam tiruan (suhu, pH, oksigen) untuk menebak ikan sehat atau stres (angka contoh).
02_alur_ml_mlp.py
# Bab 55 - Alur kerja ML di PyTorch (CPU): data -> model -> loss -> latih -> evaluasi
import numpy as np
import torch
from torch import nn

torch.manual_seed(42)
rng = np.random.default_rng(42)

# 1) Data tabel tiruan: 3 fitur kolam -> 1 = ikan sehat, 0 = stres (angka contoh)
n = 600
suhu = rng.normal(28, 2, n)
ph = rng.normal(7.0, 0.5, n)
oksigen = rng.normal(5.5, 1.2, n)
sehat = ((oksigen > 5.0) & (suhu < 30) & (np.abs(ph - 7) < 0.7)).astype(np.float32)
X = np.column_stack([suhu, ph, oksigen]).astype(np.float32)
X = (X - X.mean(axis=0)) / X.std(axis=0)                   # penskalaan
X_t, y_t = torch.from_numpy(X), torch.from_numpy(sehat).unsqueeze(1)
latih, uji = slice(0, 450), slice(450, 600)

# 2) Model: jaringan saraf kecil (MLP)
model = nn.Sequential(nn.Linear(3, 16), nn.ReLU(), nn.Linear(16, 1))
fungsi_loss = nn.BCEWithLogitsLoss()                       # untuk klasifikasi dua kelas
optimiser = torch.optim.Adam(model.parameters(), lr=0.02)

# 3) Perulangan latih
for epoch in range(1, 151):
    model.train()
    optimiser.zero_grad()
    loss = fungsi_loss(model(X_t[latih]), y_t[latih])
    loss.backward()
    optimiser.step()
    if epoch in (1, 50, 100, 150):
        print(f"epoch {epoch:3d}: loss latih = {loss.item():.3f}")

# 4) Evaluasi pada data yang tidak dipakai melatih
model.eval()
with torch.no_grad():
    prediksi = (torch.sigmoid(model(X_t[uji])) > 0.5).float()
print("Akurasi uji:", round((prediksi == y_t[uji]).float().mean().item(), 3))
print("Jumlah parameter:", sum(p.numel() for p in model.parameters()))
epoch 1: loss latih = 0.694
epoch 50: loss latih = 0.235
epoch 100: loss latih = 0.137
epoch 150: loss latih = 0.086
Akurasi uji: 0.947
Jumlah parameter: 81Pola ini akan Anda lihat di hampir setiap kode PyTorch: optimiser.zero_grad(), loss.backward(), optimiser.step(). nn.Sequential menyusun lapisan; ReLU adalah “saklar” yang mematikan angka negatif supaya jaringan bisa belajar pola melengkung. Loss turun dari 0,694 ke 0,086, dan akurasi uji 0,947. Model mungil ini hanya punya 81 parameter.
Hardware untuk AI: CPU, GPU, TPU, dan NPU
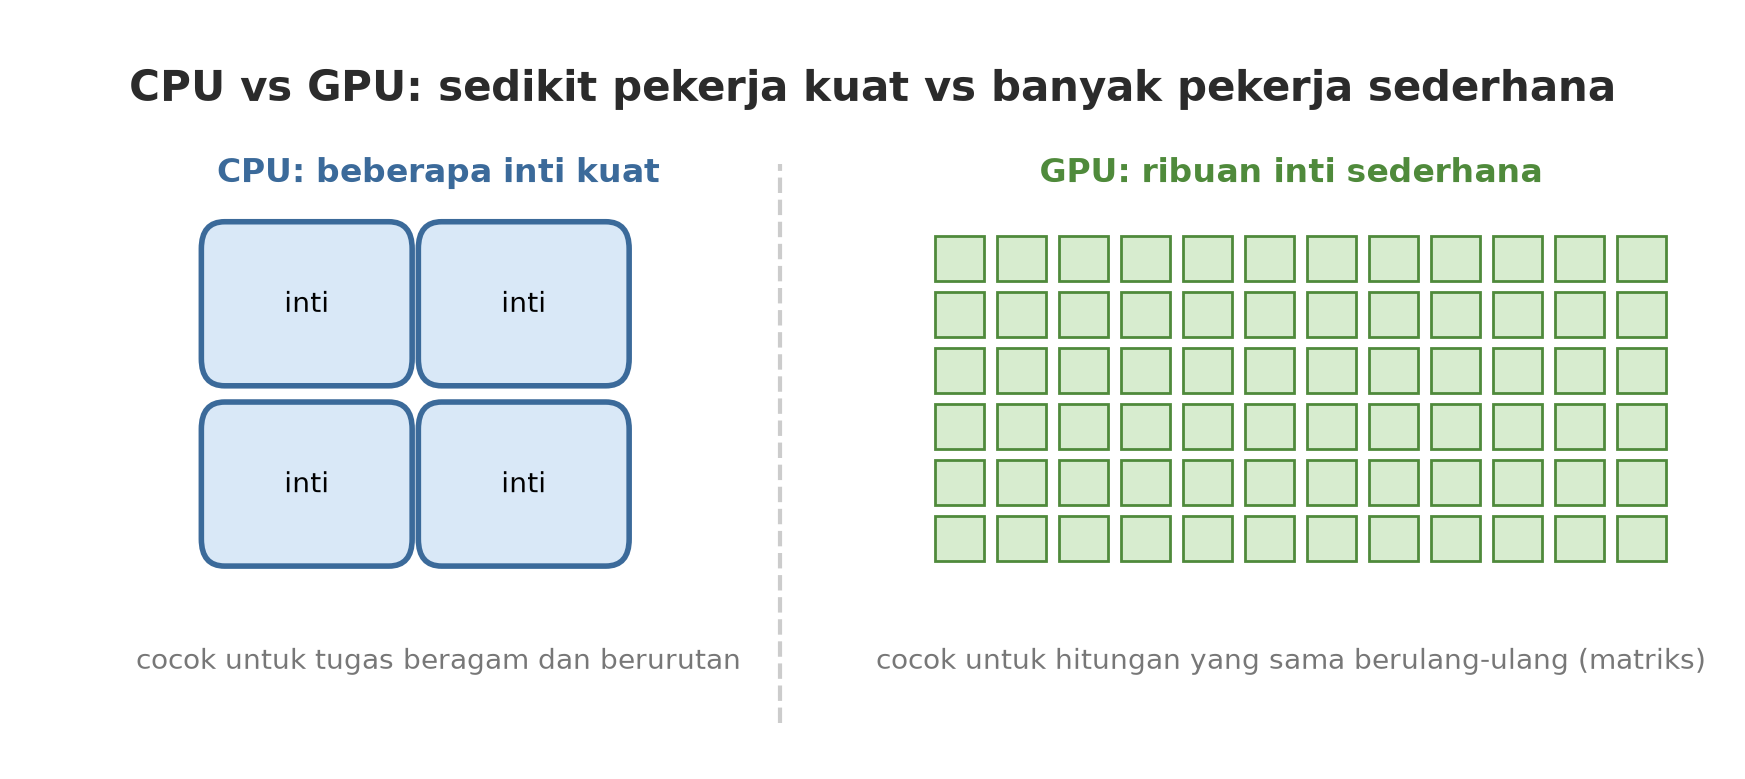
Melatih jaringan saraf didominasi satu operasi: perkalian matriks (tabel angka dikalikan tabel angka), diulang miliaran kali, dan semuanya bisa dikerjakan serentak.
| Perangkat | Gambaran | Cocok untuk |
|---|---|---|
| CPU | Beberapa inti serba bisa | Program umum, ML klasik (Bab 54), mengatur data |
| GPU | Ribuan inti sederhana, memori sendiri (VRAM) | Melatih dan menjalankan jaringan saraf |
| TPU | Cip khusus buatan Google (ASIC) untuk hitungan matriks | Pelatihan skala besar di cloud Google |
| NPU | Pemroses saraf hemat daya di laptop/ponsel baru | Menjalankan model kecil (inferensi) di perangkat |
Tentang TPU: dokumentasi Google Cloud menyebutnya cip ASIC rancangan Google untuk mempercepat beban kerja ML, bagus untuk operasi matriks besar dan kurang cocok untuk program yang banyak bercabang atau memakai operasi kustom di dalam perulangan latih (https://docs.cloud.google.com/tpu/docs/intro-to-tpu, dibaca 2026-10-10). Tentang NPU: penjelasan tabel di atas adalah gambaran umum; buku ini tidak menjalankan atau memverifikasi NPU secara khusus.
Kita buktikan sendiri bahwa GPU lebih cepat. Skrip berikut mengalikan dua matriks 4096 x 4096 di CPU dan di GPU. Waktunya tidak dicetak (berbeda di tiap komputer); yang dicetak hanya perbandingan.
04_cpu_vs_gpu.py
# Bab 55 - CPU vs GPU: perkalian matriks besar (hanya perbandingan, waktu tidak dicetak)
import time

import torch

assert torch.cuda.is_available(), "skrip ini butuh GPU NVIDIA"
ukuran = 4096
a_cpu = torch.randn(ukuran, ukuran)
b_cpu = torch.randn(ukuran, ukuran)
a_gpu, b_gpu = a_cpu.cuda(), b_cpu.cuda()


def ukur(fungsi, ulang):
    fungsi()                                              # pemanasan (inisialisasi, kompilasi kernel)
    if torch.cuda.is_available():
        torch.cuda.synchronize()
    mulai = time.perf_counter()
    for _ in range(ulang):
        fungsi()
    torch.cuda.synchronize()                              # tunggu GPU benar-benar selesai
    return (time.perf_counter() - mulai) / ulang


t_cpu = ukur(lambda: a_cpu @ b_cpu, 3)
t_gpu = ukur(lambda: a_gpu @ b_gpu, 20)
hasil_cpu = a_cpu @ b_cpu
hasil_gpu = (a_gpu @ b_gpu).cpu()

print("Hasil sama (selisih relatif kecil):", bool(torch.allclose(hasil_cpu, hasil_gpu, rtol=1e-2, atol=1e-2)))
print("GPU lebih dari 3x lebih cepat      :", t_cpu / t_gpu > 3)
Hasil sama (selisih relatif kecil): True
GPU lebih dari 3x lebih cepat : TrueDua hal penting di kode: (1) torch.cuda.synchronize() menunggu GPU selesai, karena GPU bekerja asinkron (perintah dikirim dulu, selesainya belakangan); tanpa itu waktu yang terukur keliru. (2) Ada satu kali pemanasan sebelum mengukur.
NVIDIA dan CUDA: apa saja yang harus ada
CUDA adalah platform pemrograman NVIDIA agar program bisa memakai inti GPU. Beberapa istilah yang sering membingungkan:
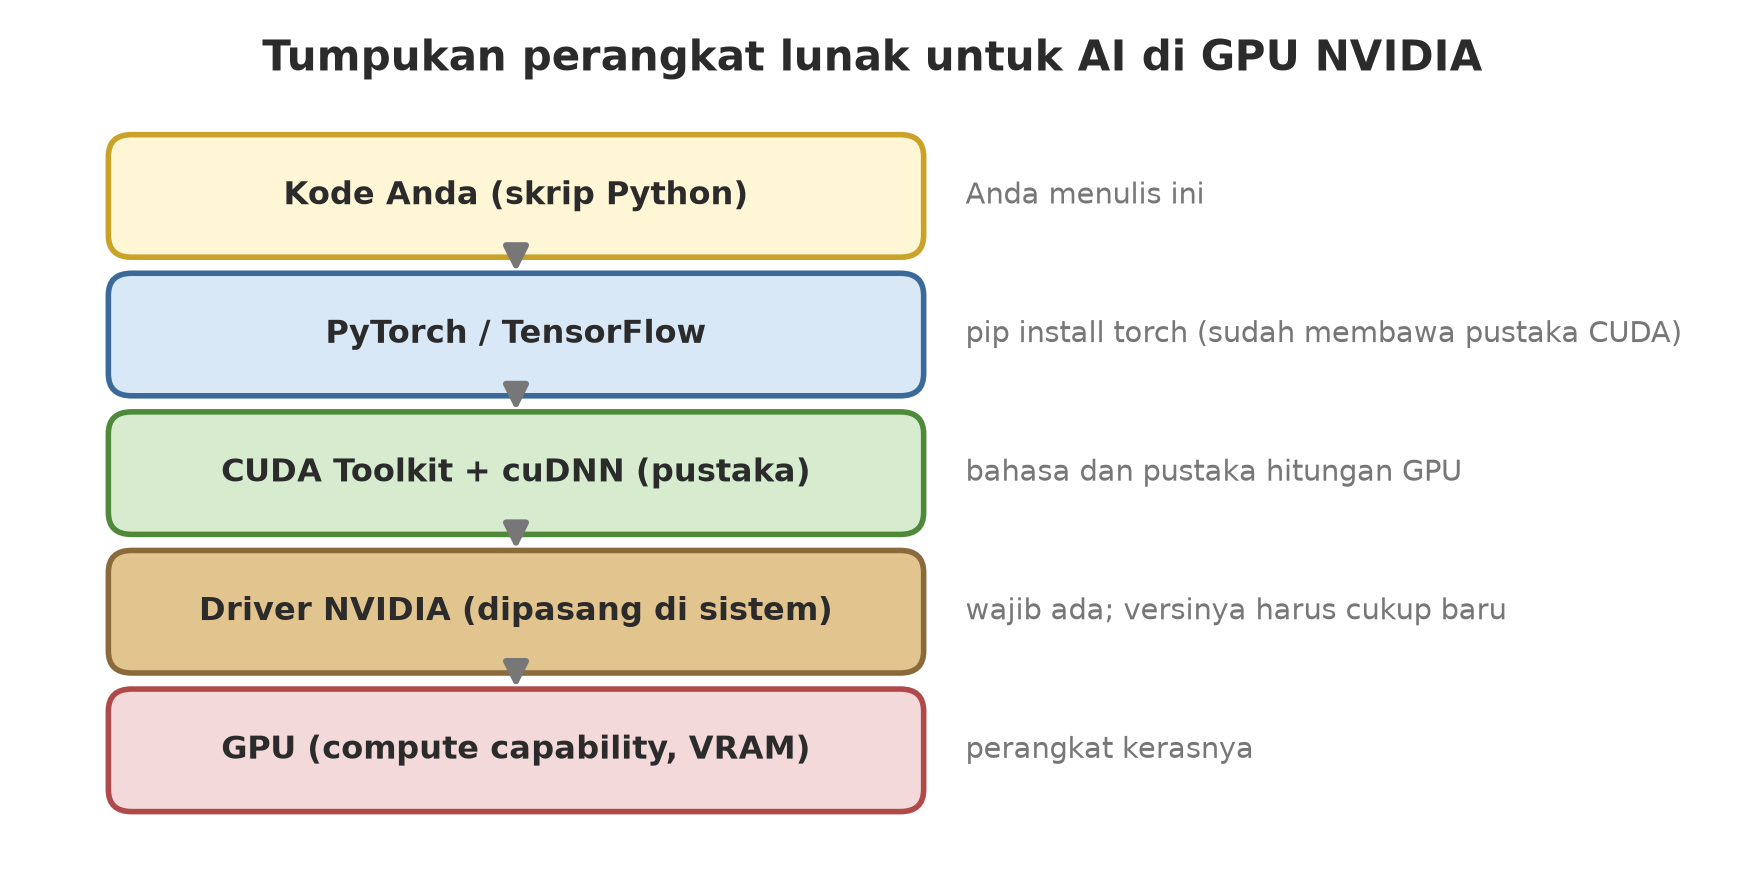
- Driver NVIDIA: perangkat lunak sistem yang membuat komputer bisa “berbicara” dengan kartu. Wajib. Versinya menentukan versi CUDA tertinggi yang didukung.
- CUDA Toolkit: kompilator (
nvcc), pustaka, dan alat bagi orang yang menulis atau mengompilasi kode CUDA. Untuk memakai PyTorch lewatpip, Toolkit tidak wajib: pakettorchsudah membawa pustaka CUDA sendiri. Buktinya ada di keluaran skrip 03 di bawah. - cuDNN: pustaka NVIDIA berisi operasi jaringan saraf yang sudah sangat dioptimalkan (konvolusi, atensi, perkalian matriks, dst.; https://developer.nvidia.com/cudnn, dibaca 2026-10-10). PyTorch memakainya otomatis.
- Compute capability: nomor versi “kemampuan” arsitektur GPU, berbentuk mayor.minor. Dokumentasi NVIDIA menyebut kemampuan dan fitur sebuah GPU bergantung pada nomor ini (https://docs.nvidia.com/cuda/cuda-programming-guide/05-appendices/compute-capabilities.html, dibaca 2026-10-10). Kartu penulis: 7.5. Paket PyTorch hanya berisi kode untuk daftar arsitektur tertentu; kartu yang terlalu tua bisa tidak didukung.
03_periksa_gpu.py
# Bab 55 - Memeriksa GPU: apakah PyTorch melihat kartu grafis NVIDIA?
import subprocess
from pathlib import Path

import torch

print("torch.cuda.is_available():", torch.cuda.is_available())
if not torch.cuda.is_available():
    print("GPU tidak terbaca; PyTorch memakai CPU.")
else:
    sifat = torch.cuda.get_device_properties(0)
    print("Nama GPU          :", sifat.name)
    print("Compute capability:", f"{sifat.major}.{sifat.minor}")
    print("VRAM total (GB)   :", round(sifat.total_memory / 1024**3, 1))
    print("Versi CUDA yang dipakai PyTorch:", torch.version.cuda)
    print("cuDNN tersedia    :", torch.backends.cudnn.is_available())
    x = torch.ones(3, device="cuda") * 2                  # tensor langsung dibuat di GPU
    print("Tensor di GPU     :", x.tolist(), "| perangkat:", x.device)

    # Apakah build PyTorch ini membawa kode untuk compute capability kartu kita?
    print("Arsitektur yang didukung build ini mencakup sm_75:", "sm_75" in torch.cuda.get_arch_list())

    # PyTorch membawa pustaka CUDA sendiri di folder torch/lib (itu sebabnya CUDA Toolkit tidak wajib)
    folder_lib = Path(torch.__file__).parent / "lib"
    nama = sorted({p.name for pola in ("cudart64*", "cublas64*", "cudnn64*") for p in folder_lib.glob(pola + ".dll")})
    print("Pustaka CUDA di dalam paket torch:", nama)

    # Versi driver dibaca dari alat nvidia-smi (bila ada)
    try:
        keluaran = subprocess.run(["nvidia-smi", "--query-gpu=driver_version", "--format=csv,noheader"],
                                  capture_output=True, text=True, timeout=20).stdout.strip()
        print("Versi driver NVIDIA (di komputer penulis):", keluaran)
    except (OSError, subprocess.TimeoutExpired):
        print("nvidia-smi tidak ditemukan")
torch.cuda.is_available(): True
Nama GPU : NVIDIA GeForce GTX 1660 SUPER
Compute capability: 7.5
VRAM total (GB) : 6.0
Versi CUDA yang dipakai PyTorch: 13.0
cuDNN tersedia : True
Tensor di GPU : [2.0, 2.0, 2.0] | perangkat: cuda:0
Arsitektur yang didukung build ini mencakup sm_75: True
Pustaka CUDA di dalam paket torch: ['cublas64_13.dll', 'cudart64_13.dll', 'cudnn64_9.dll']
Versi driver NVIDIA (di komputer penulis): 616.92torch.cuda.is_available()adalah tes pertama setiap kali. BilaFalse: driver belum terpasang atau PyTorch yang terpasang adalah versi CPU saja.- Nama GPU, VRAM, dan versi driver adalah milik komputer penulis. Pustaka CUDA (
cudart,cublas,cudnn) terlihat di dalam foldertorch/lib: itu sebabnya CUDA Toolkit tidak wajib. sm_75ada di daftar arsitektur build ini, jadi kartu 7.5 didukung.
Memasang PyTorch dengan CUDA
Perintah pemasangan bergantung pada sistem Anda; selalu ambil dari halaman resmi https://pytorch.org/get-started/locally/ (pilih sistem operasi, pip, dan versi CUDA). Pada komputer penulis, pemasangan memakai indeks resmi PyTorch untuk CUDA 13.0 (https://download.pytorch.org/whl/cu130, dengan pip install dan opsi --index-url). Halaman resmi itu dinamis sehingga perintah persisnya tidak disalin ke buku; bacalah dari sumbernya saat Anda memasang.
Alternatif non-NVIDIA
Skrip berikut memilih perangkat terbaik yang ada, sehingga kode yang sama jalan di komputer mana pun.
09_pilih_perangkat.py
# Bab 55 - Kode yang berjalan di mana saja: pilih perangkat terbaik yang tersedia
import torch


def pilih_perangkat():
    """Urutan: NVIDIA/AMD (cuda) -> Apple (mps) -> Intel (xpu) -> CPU."""
    if torch.cuda.is_available():
        return torch.device("cuda")                  # build ROCm (AMD) juga memakai nama "cuda"
    if torch.backends.mps.is_available():
        return torch.device("mps")                   # GPU Apple
    if hasattr(torch, "xpu") and torch.xpu.is_available():
        return torch.device("xpu")                   # GPU Intel
    return torch.device("cpu")


perangkat = pilih_perangkat()
print("Perangkat terpilih:", perangkat)
print("Build CUDA (NVIDIA)  :", torch.version.cuda is not None)
print("Build ROCm/HIP (AMD) :", torch.version.hip is not None)
print("MPS (Apple) tersedia :", torch.backends.mps.is_available())
x = torch.arange(5, dtype=torch.float32, device=perangkat)
print("Tensor di perangkat itu:", x.tolist())
Perangkat terpilih: cuda
Build CUDA (NVIDIA) : True
Build ROCm/HIP (AMD) : False
MPS (Apple) tersedia : False
Tensor di perangkat itu: [0.0, 1.0, 2.0, 3.0, 4.0]| Perangkat | Cara PyTorch memakainya | Catatan dari dokumentasi |
|---|---|---|
| AMD (ROCm) | Tetap memakai nama cuda; bedakan dengan torch.version.hip |
PyTorch untuk HIP “sengaja memakai ulang antarmuka torch.cuda” (docs.pytorch.org, catatan HIP, dibaca 2026-10-10) |
| Apple (MPS) | torch.device("mps"), cek torch.backends.mps.is_available() |
Butuh build PyTorch dengan MPS, macOS 14.0 atau lebih baru, dan Mac dengan GPU yang mendukung (catatan MPS, dibaca 2026-10-10) |
| Intel | torch.device("xpu"), cek torch.xpu.is_available() |
Tersedia sejak PyTorch 2.5 sebagai prototipe; mendukung antara lain Intel Arc dan Core Ultra dengan grafis Arc (catatan Intel GPU, dibaca 2026-10-10) |
Ketiganya tidak dijalankan di buku ini karena komputer penulis memakai NVIDIA. Keluaran skrip 09 hanya membuktikan bahwa fungsi pemilihannya benar di sini.
Windows, WSL2, atau Linux?
- Windows asli: PyTorch dengan CUDA berjalan (buku ini membuktikannya). Pilihan paling mudah bagi pemula.
- WSL2 (Linux di dalam Windows): panduan NVIDIA menyebut Anda cukup memasang driver Windows dan tidak boleh memasang driver tampilan Linux di dalam WSL; Windows 11 didukung penuh (https://docs.nvidia.com/cuda/wsl-user-guide/index.html, dibaca 2026-10-10).
- TensorFlow: dokumentasi resmi menyatakan TensorFlow 2.10 adalah rilis terakhir yang mendukung GPU di Windows asli; untuk versi lebih baru, GPU di Windows dipakai lewat WSL2 (https://www.tensorflow.org/install/pip, dibaca 2026-10-10).
- Linux langsung: jalur yang paling umum di server dan cloud.
VRAM: berapa yang dibutuhkan?
VRAM adalah memori kartu grafis. Bila model dan datanya tidak muat, program berhenti dengan error out of memory (OOM). Saat melatih dengan optimiser Adam, VRAM terisi empat hal:
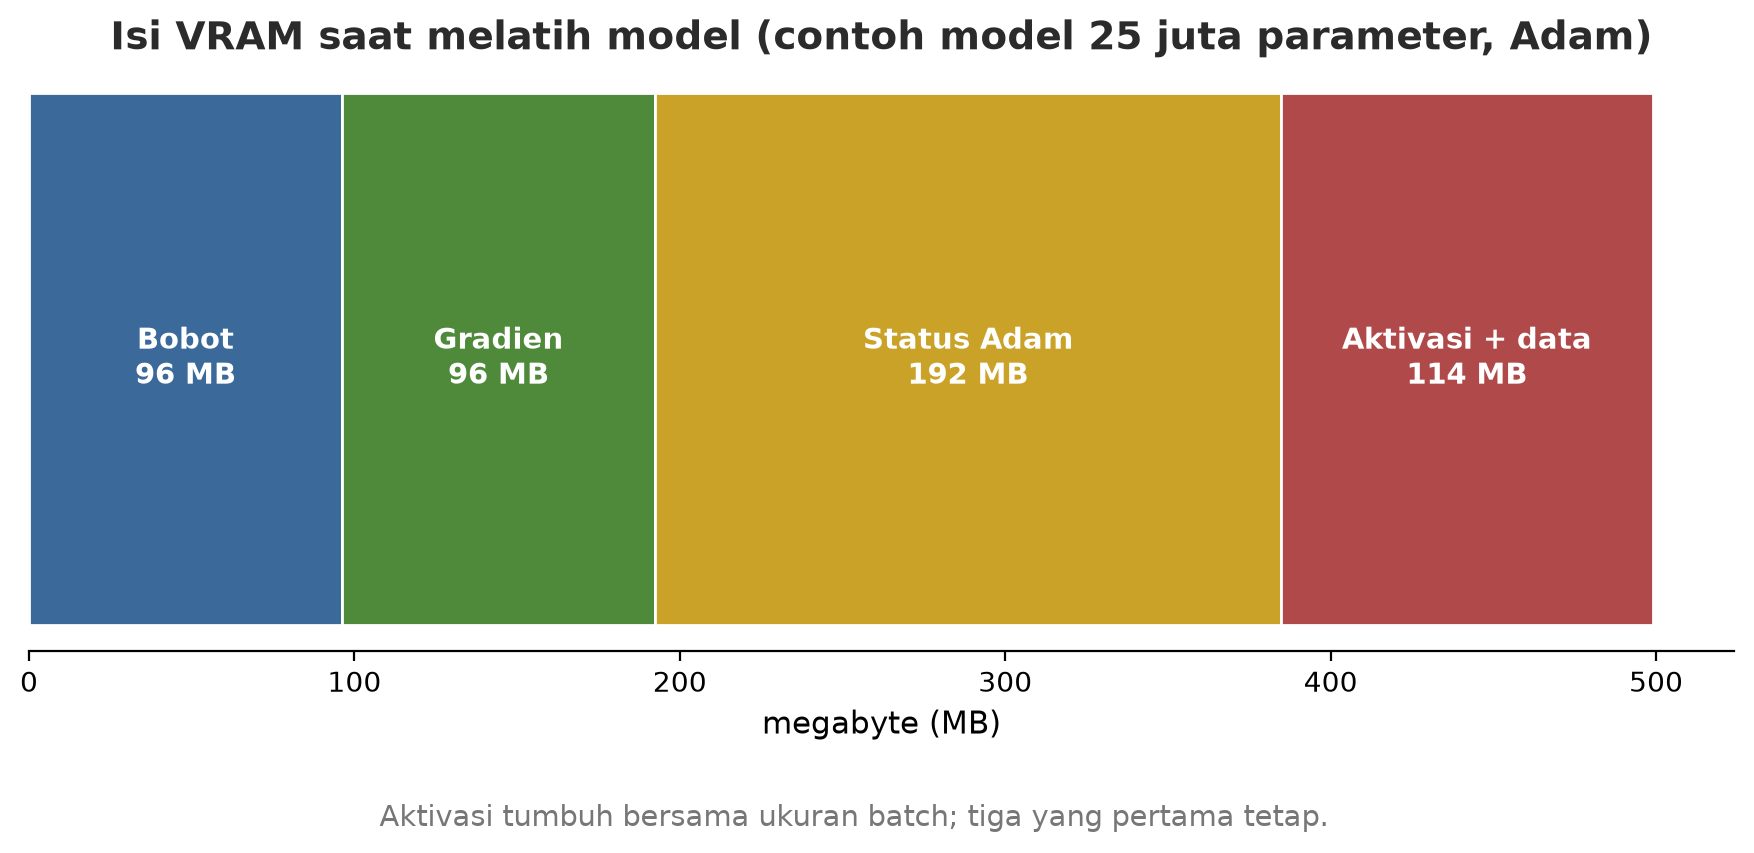
- Bobot: jumlah parameter x ukuran angka (fp32 = 4 byte, fp16 = 2 byte).
- Gradien: satu angka per parameter.
- Status optimiser: Adam menyimpan 2 angka per parameter.
- Aktivasi dan data: hasil antara tiap lapisan, tumbuh seiring batch size.
Rumus kasar pelatihan: jumlah parameter x 16 byte (fp32 + Adam) ditambah aktivasi. Untuk menjalankan model saja (tanpa latih): sekitar parameter x 4 byte (fp32) atau x 2 byte (fp16). Kita hitung dengan tangan lalu ukur sungguhan:
05_hitung_vram.py
# Bab 55 - Memperkirakan VRAM: hitung dari jumlah parameter, lalu ukur sungguhan di GPU
import torch
from torch import nn

assert torch.cuda.is_available(), "skrip ini butuh GPU NVIDIA"
JUTA = 1_000_000


def memori_params_mb(jumlah, byte_per_angka):
    return jumlah * byte_per_angka / 1024**2


print("Perkiraan memori parameter saja (MB):")
for nama, jumlah in [("model kecil 1 juta", 1 * JUTA), ("ResNet-50 (25,6 juta)", 25_600_000),
                     ("model 1 miliar", 1000 * JUTA)]:
    print(f"  {nama:24s} fp32 = {memori_params_mb(jumlah, 4):9.1f}   fp16 = {memori_params_mb(jumlah, 2):9.1f}")

# Latih satu langkah dengan optimiser Adam, lalu bandingkan dengan hitungan tangan
model = nn.Sequential(nn.Linear(2048, 4096), nn.ReLU(), nn.Linear(4096, 4096), nn.ReLU(),
                      nn.Linear(4096, 10)).cuda()
jumlah = sum(p.numel() for p in model.parameters())
optimiser = torch.optim.Adam(model.parameters(), lr=1e-3)

torch.cuda.empty_cache()
torch.cuda.reset_peak_memory_stats()
x = torch.randn(256, 2048, device="cuda")
y = torch.randint(0, 10, (256,), device="cuda")
loss = nn.functional.cross_entropy(model(x), y)
loss.backward()
optimiser.step()                                       # Adam membuat 2 salinan tambahan per parameter

puncak_mb = torch.cuda.max_memory_allocated() / 1024**2
bobot = memori_params_mb(jumlah, 4)
print(f"\nModel uji: {jumlah:,} parameter")
print(f"Bobot            : {bobot:7.1f} MB")
print(f"Gradien          : {bobot:7.1f} MB   (satu angka per parameter)")
print(f"Status Adam (x2) : {2 * bobot:7.1f} MB   (rata-rata dan varians)")
print(f"Perkiraan tetap  : {4 * bobot:7.1f} MB   (belum termasuk aktivasi dan data)")
print(f"Terukur (puncak) : {round(puncak_mb):7d} MB   (dibulatkan; termasuk aktivasi dan data)")
print("Terukur >= perkiraan tetap:", puncak_mb >= 4 * bobot)
Perkiraan memori parameter saja (MB):
model kecil 1 juta fp32 = 3.8 fp16 = 1.9
ResNet-50 (25,6 juta) fp32 = 97.7 fp16 = 48.8
model 1 miliar fp32 = 3814.7 fp16 = 1907.3
Model uji: 25,214,986 parameter
Bobot : 96.2 MB
Gradien : 96.2 MB (satu angka per parameter)
Status Adam (x2) : 192.4 MB (rata-rata dan varians)
Perkiraan tetap : 384.8 MB (belum termasuk aktivasi dan data)
Terukur (puncak) : 499 MB (dibulatkan; termasuk aktivasi dan data)
Terukur >= perkiraan tetap: True- Model 1 miliar parameter saja butuh 3.814,7 MB (sekitar 3,7 GB) hanya untuk bobot fp32, hampir seluruh VRAM kartu 6 GB. Melatihnya butuh sekitar 15 GB dengan Adam. Inilah mengapa model besar butuh GPU besar atau trik khusus (kuantisasi, Bab 61).
- Model uji kita: 25.214.986 parameter, bobot 96,2 MB. Perkiraan tetap (bobot + gradien + Adam) = 384,8 MB; terukur puncak 499 MB, selisih ~114 MB adalah aktivasi dan data.
torch.cuda.max_memory_allocated()yang mengukurnya. (Angka dengan koma ribuan ala Inggris itu memang keluaran asli Python.)
PeringatanAWAS
Perkiraan di atas batas bawah. Ada tambahan: memori yang dicadangkan penyimpan sementara PyTorch, pustaka CUDA (cuDNN dan cuBLAS menyisihkan ruang kerja), dan Windows sendiri memakai VRAM untuk tampilan (di komputer penulis, tanpa program apa pun, VRAM sudah terpakai sekitar 1,8 GB menurut nvidia-smi saat bab ini ditulis). Selalu sisakan ruang.
Mixed precision
Mixed precision menjalankan sebagian hitungan dalam float16 (setengah ukuran float32) dan sisanya float32, lewat torch.autocast. Penskala gradien (GradScaler) mencegah gradien kecil “lenyap” menjadi nol di float16. Dokumentasi PyTorch menyebut autocast di CUDA memakai float16 secara bawaan, dan operasi seperti mm, linear, conv2d dijalankan dalam float16 (docs.pytorch.org/docs/2.14/amp.html, dibaca 2026-10-10).
06_mixed_precision.py
# Bab 55 - Mixed precision: sebagian hitungan memakai float16 agar hemat memori
import torch
from torch import nn

assert torch.cuda.is_available(), "skrip ini butuh GPU NVIDIA"
torch.manual_seed(0)


def langkah(pakai_amp):
    model = nn.Sequential(nn.Linear(1024, 4096), nn.ReLU(), nn.Linear(4096, 4096), nn.ReLU(),
                          nn.Linear(4096, 10)).cuda()
    optimiser = torch.optim.SGD(model.parameters(), lr=0.01)
    penskala = torch.amp.GradScaler("cuda", enabled=pakai_amp)   # mencegah gradien float16 "habis" jadi nol
    x = torch.randn(8192, 1024, device="cuda")
    y = torch.randint(0, 10, (8192,), device="cuda")
    torch.cuda.empty_cache()
    torch.cuda.reset_peak_memory_stats()
    with torch.autocast(device_type="cuda", dtype=torch.float16, enabled=pakai_amp):
        loss = nn.functional.cross_entropy(model(x), y)
    penskala.scale(loss).backward()
    penskala.step(optimiser)
    penskala.update()
    return loss.item(), torch.cuda.max_memory_allocated() / 1024**2


loss32, mem32 = langkah(False)
loss16, mem16 = langkah(True)
print("Loss fp32 :", round(loss32, 2))
print("Loss amp  :", round(loss16, 2), "(hampir sama)")
print("Memori puncak mixed precision lebih kecil:", mem16 < mem32)
print("Perbandingan memori amp / fp32 (dibulatkan 1 desimal):", round(mem16 / mem32, 1))
Loss fp32 : 2.31
Loss amp : 2.31 (hampir sama)
Memori puncak mixed precision lebih kecil: True
Perbandingan memori amp / fp32 (dibulatkan 1 desimal): 0.7Loss hampir sama, tetapi memori puncak turun menjadi sekitar 70% pada percobaan ini. Pada kartu GTX 1660 SUPER manfaatnya terbatas pada memori: kartu ini tidak punya Tensor Core (cip TU116 dibuat tanpa unit itu menurut ulasan perangkat keras, mis. AnandTech), sehingga percepatan besar dari mixed precision yang sering dibahas di internet berlaku untuk kartu RTX ke atas. Kami tidak mengukur kecepatannya di sini.
Batch size dan error OOM
Batch lebih besar: pelatihan lebih cepat dan stabil, tetapi memori aktivasi membesar. Batch lebih kecil: hemat memori, lebih berisik. Percobaan di bawah juga sengaja meminta memori jauh melebihi VRAM untuk melihat error OOM yang asli.
07_batch_dan_oom.py
# Bab 55 - Batch size mempengaruhi VRAM; kalau terlalu besar terjadi error "out of memory"
import os
os.environ["TORCH_CPP_LOG_LEVEL"] = "ERROR"          # sembunyikan peringatan C++ (berisi angka memori yang berubah-ubah)
import torch
from torch import nn

assert torch.cuda.is_available(), "skrip ini butuh GPU NVIDIA"
model = nn.Sequential(nn.Linear(1024, 2048), nn.ReLU(), nn.Linear(2048, 10)).cuda()

print("batch | memori puncak (MB, dibulatkan ke 10)")
for batch in [64, 256, 1024, 4096, 16384]:
    torch.cuda.empty_cache()
    torch.cuda.reset_peak_memory_stats()
    x = torch.randn(batch, 1024, device="cuda")
    model(x).sum().backward()
    mb = torch.cuda.max_memory_allocated() / 1024**2
    print(f"{batch:5d} | {round(mb, -1):6.0f}")

# Sengaja meminta memori jauh melebihi VRAM (kartu ini 6 GB): minta 40 GB
try:
    torch.empty(10_000_000_000, dtype=torch.float32, device="cuda")
except torch.cuda.OutOfMemoryError as galat:
    print("\nError tertangkap:", type(galat).__name__)
    print("Awal pesan:", str(galat).split(".")[0][:45])
batch | memori puncak (MB, dibulatkan ke 10)
64 | 30
256 | 40
1024 | 60
4096 | 140
16384 | 480
Error tertangkap: OutOfMemoryError
Awal pesan: CUDA out of memoryMemori puncak naik dari 30 MB (batch 64) menjadi 480 MB (batch 16.384). Permintaan 40 GB menghasilkan OutOfMemoryError, yang bisa ditangkap dengan try/except. Jika OOM menimpa pelatihan Anda: kecilkan batch, aktifkan mixed precision, pakai model lebih kecil, atau gunakan gradient accumulation (beberapa batch kecil dijumlahkan sebelum satu langkah update; tidak dijalankan di buku ini).
TipTIPS
Gejala “Windows jadi lambat saat melatih” sering karena VRAM penuh. Tutup program berat (peramban, game) dan pantau dengan nvidia-smi.
Multi-GPU, cloud, dan memilih hardware
- Multi-GPU: PyTorch menyediakan
DistributedDataParalleluntuk melatih di beberapa GPU. Tidak dijalankan di sini karena penulis hanya punya satu kartu. - GPU cloud: menyewa GPU per jam bila kebutuhan sesekali. Harga dan jenis kartu berubah cepat, jadi buku ini tidak memberi angka; periksa penyedia pilihan Anda.
- Memilih hardware: tentukan dulu ukuran model terbesar yang akan Anda latih, hitung VRAM-nya dengan cara di atas, lalu beli VRAM yang cukup. VRAM biasanya menjadi batas yang pertama menghalangi, bukan kecepatan. Untuk data tabel dan ML klasik (Bab 54), GPU tidak perlu.
TensorFlow
TensorFlow (dengan antarmuka Keras) adalah pustaka lain dari Google. Gagasannya sama; yang beda adalah cara menulisnya. Skrip berikut menunjukkan model yang setara dengan skrip 02.
10_tensorflow_ringkas.py
# Bab 55 - Model yang sama ditulis dengan TensorFlow/Keras (hanya sebagai perbandingan)
import numpy as np
import tensorflow as tf

rng = np.random.default_rng(42)
X = rng.normal(size=(600, 3)).astype("float32")
y = ((X[:, 2] > 0) & (X[:, 0] < 0.5)).astype("float32")

model = tf.keras.Sequential([
    tf.keras.Input(shape=(3,)),
    tf.keras.layers.Dense(16, activation="relu"),
    tf.keras.layers.Dense(1, activation="sigmoid"),
])
model.compile(optimizer="adam", loss="binary_crossentropy", metrics=["accuracy"])
model.fit(X[:450], y[:450], epochs=50, verbose=0)
loss, akurasi = model.evaluate(X[450:], y[450:], verbose=0)
print("Akurasi uji:", round(akurasi, 3))
Kode ini tidak dijalankan saat buku dibuat karena TensorFlow belum punya paket untuk Python 3.14 (pip tidak menemukan distribusinya di .venv buku) dan dukungan GPU di Windows asli berakhir setelah TensorFlow 2.10, jadi keluarannya tidak ditampilkan. Sintaks Keras di atas ditulis dari pengetahuan umum dan belum diuji di komputer penulis.
Proyek Bersambung A3: CNN penyakit daun di GPU
Kita melatih CNN (convolutional neural network): jaringan saraf untuk citra yang menggeser “saringan kecil” (konvolusi) ke seluruh gambar untuk mendeteksi tepi, tekstur, lalu bentuk. Citra daun 32 x 32 piksel dibuat skrip (buat_citra.py): tiga kelas, sehat (hijau polos), bercak (bintik cokelat), dan menguning (pucat ke kuning), dengan derau acak. Ini data tiruan, bukan foto sungguhan.
08_cnn_gpu.py
# Bab 55 - CNN kecil di GPU: mengenali daun sehat, bercak, dan menguning (citra tiruan)
import os
os.environ["CUBLAS_WORKSPACE_CONFIG"] = ":4096:8"             # syarat perhitungan deterministik di GPU
import numpy as np
import torch
from sklearn.metrics import confusion_matrix
from torch import nn
from torchmetrics.classification import MulticlassF1Score

from buat_citra import KELAS, buat_daun

torch.manual_seed(42)
torch.use_deterministic_algorithms(True)                      # error bila ada operasi yang tak bisa deterministik
perangkat = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print("Memakai perangkat:", perangkat.type)

citra, label = buat_daun()
X = torch.from_numpy(citra).to(perangkat)
y = torch.from_numpy(label).to(perangkat)
latih, uji = slice(0, 960), slice(960, 1200)

model = nn.Sequential(
    nn.Conv2d(3, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),     # 32 -> 16
    nn.Conv2d(16, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),    # 16 -> 8
    nn.Flatten(), nn.Linear(32 * 8 * 8, 64), nn.ReLU(), nn.Linear(64, 3),
).to(perangkat)
print("Jumlah parameter:", sum(p.numel() for p in model.parameters()))
optimiser = torch.optim.Adam(model.parameters(), lr=0.001)

for epoch in range(1, 41):
    model.train()
    urutan = torch.randperm(960, device=perangkat)
    total = 0.0
    for awal in range(0, 960, 64):                             # mini-batch 64
        idx = urutan[awal:awal + 64]
        optimiser.zero_grad()
        loss = nn.functional.cross_entropy(model(X[latih][idx]), y[latih][idx])
        loss.backward()
        optimiser.step()
        total += loss.item() * len(idx)
    if epoch == 1 or epoch % 10 == 0:
        print(f"epoch {epoch}: loss latih = {total / 960:.3f}")

model.eval()
with torch.no_grad():
    tebakan = model(X[uji]).argmax(dim=1).cpu().numpy()
benar = y[uji].cpu().numpy()
print("\nAkurasi uji:", round(float((tebakan == benar).mean()), 3))
print("Matriks kebingungan (baris = sebenarnya):", KELAS)
print(confusion_matrix(benar, tebakan))

f1 = MulticlassF1Score(num_classes=3, average="macro")(torch.from_numpy(tebakan), torch.from_numpy(benar))
print("F1 makro (torchmetrics):", round(float(f1), 3))
Memakai perangkat: cuda
Jumlah parameter: 136419
epoch 1: loss latih = 1.030
epoch 10: loss latih = 0.569
epoch 20: loss latih = 0.469
epoch 30: loss latih = 0.318
epoch 40: loss latih = 0.236
Akurasi uji: 0.858
Matriks kebingungan (baris = sebenarnya): ['sehat', 'bercak', 'menguning']
[[58 10 14]
[ 5 66 1]
[ 4 0 82]]
F1 makro (torchmetrics): 0.856perangkat = cuda: model dan data dipindah ke GPU dengan.to(perangkat). Keduanya harus di perangkat yang sama, atau PyTorch mengeluh.- Loss turun dari 1,030 ke 0,236 dalam 40 epoch. Akurasi uji 0,858 (angka contoh).
- Matriks kebingungan: kesalahan terbanyak adalah
sehatyang ditebakmenguning(14) danbercak(10). Daunmenguninghampir selalu benar (82 dari 86). torch.use_deterministic_algorithms(True)dan benih tetap membuat hasil sama di setiap jalan, walau GPU pada dasarnya bisa tidak deterministik. Di kartu atau versi PyTorch lain, angka Anda bisa sedikit berbeda.torchmetricsmenyediakan metrik siap pakai (di sini F1 makro).
Bab 56 memakai alur yang sama untuk gambar sungguhan yang lebih besar, dengan YOLO.
Latihan
- Di
01_tensor_autograd.py, ubah laju belajar 0.05 menjadi 0.5 dan 0.001. Apa yang terjadi padaw? - Di
05_hitung_vram.py, gantiAdamdenganSGD(tanpa momentum) lalu ukur lagi. Perkirakan dulu berapa MB yang hemat. - Di
08_cnn_gpu.py, ganti jumlah epoch menjadi 10 dan 80. Apakah akurasi uji terus naik? (Petunjuk: perhatikan juga loss latih.) - Tantangan: ubah
08_cnn_gpu.pyagar memakai mixed precision (torch.autocastdanGradScaler, lihat skrip 06) dan bandingkan memori puncaknya sebelum dan sesudah.
Ringkasan Bab
- Alur ML: data, bagi latih/uji, model, latih berulang (epoch), evaluasi, pakai.
- PyTorch: tensor dan autograd; satu langkah latih =
zero_grad,backward,step. - GPU unggul pada perkalian matriks serentak; yang wajib dipasang sendiri hanya driver, karena paket
torchsudah membawa pustaka CUDA dan cuDNN. - VRAM latih kira-kira parameter x 16 byte (fp32 + Adam) ditambah aktivasi; ukur dengan
torch.cuda.max_memory_allocated(). - Mixed precision dan batch kecil menghemat memori; OOM bisa ditangkap.
- AMD, Apple, dan Intel punya jalur sendiri di PyTorch (tidak dijalankan di sini); TensorFlow tidak dijalankan.
Selanjutnya, di Bab 56: kita memakai GPU untuk melihat: computer vision, deteksi objek dengan YOLO, dan menghitung tajuk pohon di citra drone tiruan.