Bab 44 — Performa: Cepat Itu Diukur, Bukan Ditebak
Seri A1 — Rekayasa Perangkat Lunak Profesional
Semua skrip bab ini ada di folder kode/bab44/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Selamat datang di tingkat Advanced! Aplikasi dari Seri I5 sudah berjalan. Sekarang ia harus menghadapi dunia nyata: data bertambah dari ratusan baris menjadi puluhan ribu, dan rekap yang tadinya instan mulai terasa lambat. Bayangkan Anda mengelola gudang kayu yang makin penuh. Mencari satu karung kayu dengan membuka semua karung satu per satu itu lambat. Menyimpan daftar letaknya di buku catatan membuat pencarian jadi cepat. Bab ini mengajarkan cara menemukan di mana program Anda “membuka semua karung”, lalu memperbaikinya.
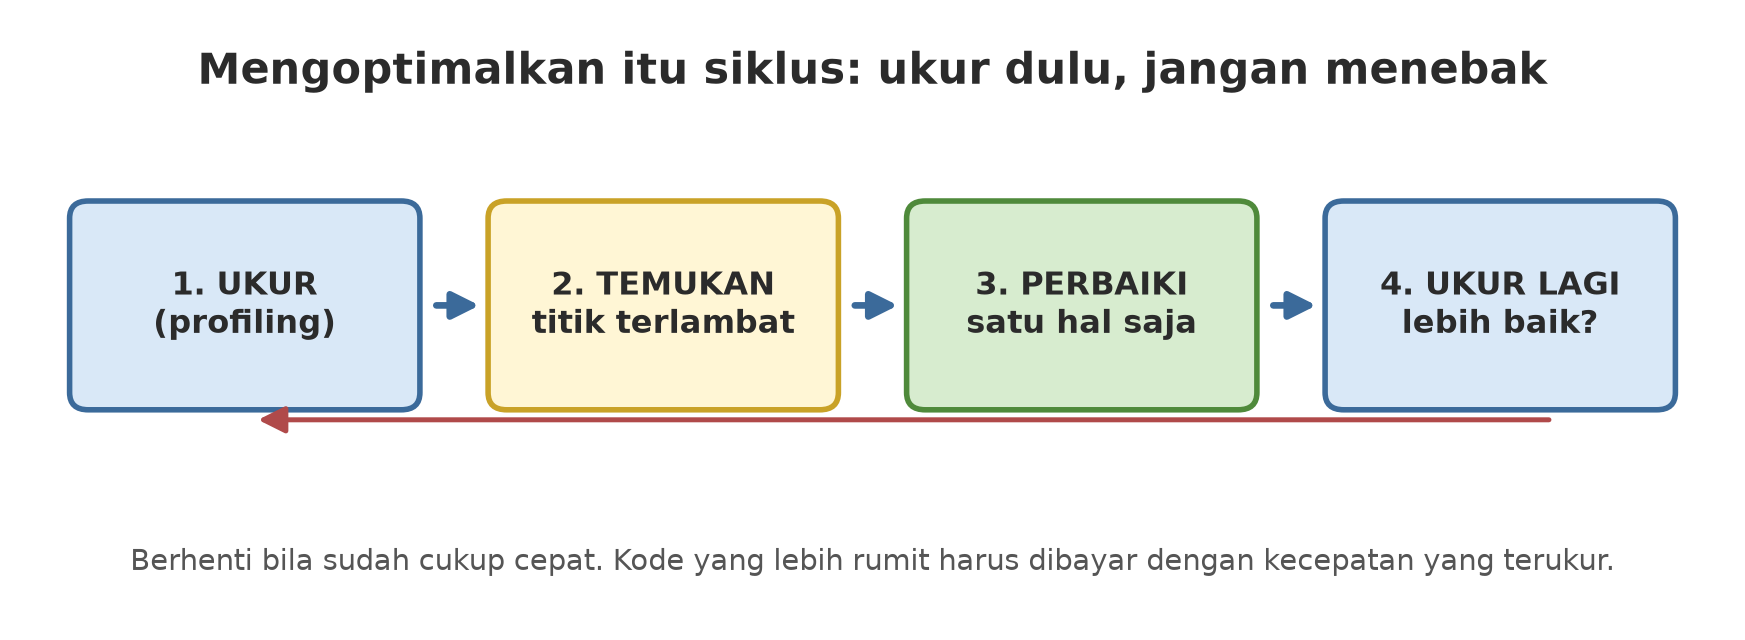
Aturan emas performa: ukur dulu, jangan menebak. Programmer berpengalaman pun sering salah menebak bagian yang lambat. Mengoptimalkan bagian yang salah hanya membuat kode lebih rumit tanpa membuatnya lebih cepat.
Profiling: mencari titik terlambat dengan cProfile
Profiling adalah mengukur bagian mana dari program yang menghabiskan waktu. Python membawa profiler bawaan bernama cProfile. Skrip berikut menjumlahkan luas bidang dasar pohon per plot dengan cara yang agak boros:
01_cprofile.py
# Bab 44 - cProfile: mencari fungsi yang paling berat
import cProfile
import pstats
import random


def buat_data(n):
    rng = random.Random(42)
    return [(rng.choice("ABC"), rng.uniform(10, 60)) for _ in range(n)]


def luas_dasar(diameter_cm):
    return 3.14159 * (diameter_cm / 200) ** 2


def total_per_plot(data, plot):
    total = 0.0
    for p, d in data:
        if p == plot:
            total += luas_dasar(d)
    return total


def rekap(data):
    hasil = {}
    for plot in "ABC":
        hasil[plot] = total_per_plot(data, plot)
    return hasil


data = buat_data(3000)
profil = cProfile.Profile()
profil.runcall(rekap, data)
statistik = pstats.Stats(profil)

# Waktu berbeda di tiap komputer, jadi kita tampilkan hanya yang stabil:
# berapa kali tiap fungsi dipanggil, dan urutan "waktu kumulatif".
ours = {k: v for k, v in statistik.stats.items() if k[0].endswith("01_cprofile.py")}
print("fungsi            jumlah panggilan")
for (_, _, nama), (_, panggilan, _, _, _) in sorted(ours.items(), key=lambda kv: kv[0][2]):
    print(f"{nama:17} {panggilan:6}")

urut = sorted(ours.items(), key=lambda kv: kv[1][3], reverse=True)
print("urutan dari yang paling lama (kumulatif):", [k[2] for k, _ in urut])
fungsi jumlah panggilan
luas_dasar 3000
rekap 1
total_per_plot 3
urutan dari yang paling lama (kumulatif): ['rekap', 'total_per_plot', 'luas_dasar']Cara membacanya:
luas_dasardipanggil 3000 kali: sekali untuk tiap pohon.total_per_plotdipanggil 3 kali (satu per plot), danrekapsekali.- Urutan waktu kumulatif (waktu kumulatif = waktu fungsi itu ditambah semua yang ia panggil) selalu dari pembungkus terluar ke fungsi terdalam:
rekap, lalutotal_per_plot, laluluas_dasar.
Skrip ini sengaja tidak mencetak angka detik. Waktu berbeda di tiap komputer dan tiap kali dijalankan, bahkan di komputer yang sama. Angka yang stabil adalah jumlah panggilan dan urutan. Jangan menyimpulkan apa pun dari satu kali pengukuran waktu.
Supaya Anda tahu seperti apa keluaran lengkapnya, skrip berikut mengambil keluaran asli cProfile sekali saja:
07_waktu_statis.py
# Bab 44 - Keluaran cProfile asli (lengkap dengan angka waktu)
import cProfile
import pstats
import random


def buat_data(n):
    rng = random.Random(42)
    return [(rng.choice("ABC"), rng.uniform(10, 60)) for _ in range(n)]


def luas_dasar(diameter_cm):
    return 3.14159 * (diameter_cm / 200) ** 2


def total_per_plot(data, plot):
    total = 0.0
    for p, d in data:
        if p == plot:
            total += luas_dasar(d)
    return total


def rekap(data):
    return {plot: total_per_plot(data, plot) for plot in "ABC"}


data = buat_data(300_000)
profil = cProfile.Profile()
profil.runcall(rekap, data)
pstats.Stats(profil).strip_dirs().sort_stats("cumulative").print_stats(4)
300005 function calls in 0.293 seconds
Ordered by: cumulative time
ncalls tottime percall cumtime percall filename:lineno(function)
1 0.000 0.000 0.293 0.293 07_waktu_statis.py:25(rekap)
3 0.179 0.060 0.293 0.098 07_waktu_statis.py:17(total_per_plot)
300000 0.114 0.000 0.114 0.000 07_waktu_statis.py:13(luas_dasar)
1 0.000 0.000 0.000 0.000 {method 'disable' of '_lsprof.Profiler' objects}Keluaran di atas diambil sekali dari komputer penulis (arahan @statis), karena angka waktunya tidak mungkin sama persis di komputer Anda. Angka waktu di komputer Anda berbeda, tetapi bentuknya sama. Kolom penting: ncalls (jumlah panggilan), tottime (waktu di dalam fungsi itu saja), cumtime (waktu kumulatif). Jumlah panggilan di sini (300000 untuk luas_dasar, total 300005) sama persis di komputer Anda karena ia dihitung, bukan diukur.
line_profiler: sampai ke tingkat baris
cProfile menunjukkan fungsi mana yang berat. Bila fungsinya panjang, line_profiler (paket tambahan: pip install line_profiler) menunjukkan baris mana. Biasanya Anda memakainya lewat perintah kernprof, tetapi di sini kita memakai antarmuka Python-nya agar bisa dijalankan sebagai skrip biasa:
02_line_profiler.py
# Bab 44 - line_profiler: menghitung berapa kali tiap baris dijalankan
import linecache

from line_profiler import LineProfiler


def ringkas(diameter):
    jumlah_besar = 0
    total = 0.0
    for d in diameter:
        if d >= 30:
            jumlah_besar += 1
        total += d
    return jumlah_besar, total / len(diameter)


diameter = [32.5, 45.2, 28.0, 51.5, 29.9, 30.0]

profiler = LineProfiler()
ringkas_terpantau = profiler(ringkas)
ringkas_terpantau(diameter)

stats = profiler.get_stats()
for (berkas, baris_awal, nama), isi in stats.timings.items():
    print(f"Fungsi {nama}: kolom 'kali' = berapa kali baris dijalankan")
    for nomor, kali, _waktu in isi:
        kode = linecache.getline(berkas, nomor).strip()
        print(f"  {kali:3} kali  {kode}")
Fungsi ringkas: kolom 'kali' = berapa kali baris dijalankan
1 kali jumlah_besar = 0
1 kali total = 0.0
7 kali for d in diameter:
6 kali if d >= 30:
4 kali jumlah_besar += 1
6 kali total += d
1 kali return jumlah_besar, total / len(diameter)Dari tujuh baris, baris for dijalankan 7 kali (6 elemen ditambah satu kali pemeriksaan “sudah habis”), if 6 kali, dan jumlah_besar += 1 hanya 4 kali (diameter 32,5; 45,2; 51,5; dan 30,0, yang >= 30). Pada program sungguhan, line_profiler juga memberi kolom waktu per baris; kita hanya menampilkan jumlahnya karena stabil.
memory_profiler: mengukur memori
Kadang masalahnya bukan waktu, melainkan memori. memory_profiler mengukur pemakaian memori sebuah fungsi. Kita membandingkan dua cara menjumlahkan dua juta angka:
03_memori.py
# Bab 44 - memory_profiler: list menyimpan semua, generator menghasilkan satu per satu
from memory_profiler import memory_usage


def pakai_list(n):
    angka = [i * 1.5 for i in range(n)]
    return sum(angka)


def pakai_generator(n):
    return sum(i * 1.5 for i in range(n))


# Di Windows, memory_usage memulai proses baru, jadi wajib dalam "if __name__".
if __name__ == "__main__":
    n = 2_000_000
    puncak_list = max(memory_usage((pakai_list, (n,)), interval=0.01))
    puncak_gen = max(memory_usage((pakai_generator, (n,)), interval=0.01))

    print("hasil sama:", pakai_list(1000) == pakai_generator(1000))
    print("puncak memori list lebih besar dari generator:", puncak_list > puncak_gen)
    print("selisihnya lebih dari 20 MB:", puncak_list - puncak_gen > 20)
hasil sama: True
puncak memori list lebih besar dari generator: True
selisihnya lebih dari 20 MB: TrueList menyimpan semua angka di memori sekaligus; generator (Bab 30) menghasilkan satu per satu lalu membuangnya. Hasilnya sama, tetapi puncak memorinya jauh berbeda. Kita hanya mencetak perbandingan, bukan angka megabita yang berubah-ubah.
Di Windows, memory_usage memulai proses baru, sehingga kode utama wajib berada di bawah if __name__ == "__main__":. Tanpa itu, Anda akan mendapat RuntimeError tentang “bootstrapping phase”. Itu bukan bug paket, melainkan aturan multiprocessing di Windows.
Struktur data yang tepat
Sering kali optimasi terbesar bukan trik rumit, melainkan memilih wadah yang tepat. Mencari sebuah item dalam list berarti memeriksa dari depan satu per satu. Pada set dan dict (yang memakai tabel hash), Python “melompat” langsung ke tempatnya.
04_struktur_data.py
# Bab 44 - Struktur data yang tepat: list vs set vs dict
import timeit

kode_pohon = [f"P{i:05d}" for i in range(20_000)]
daftar = list(kode_pohon)
himpunan = set(kode_pohon)
kamus = {k: i for i, k in enumerate(kode_pohon)}

dicari = "P19999"  # paling belakang: kasus terburuk untuk list

t_list = min(timeit.repeat(lambda: dicari in daftar, number=200, repeat=5))
t_set = min(timeit.repeat(lambda: dicari in himpunan, number=200, repeat=5))
t_dict = min(timeit.repeat(lambda: kamus[dicari], number=200, repeat=5))

print("hasil sama:", (dicari in daftar) == (dicari in himpunan) == (dicari in kamus))
print("set lebih dari 100x lebih cepat dari list:", t_list / t_set > 100)
print("dict lebih dari 100x lebih cepat dari list:", t_list / t_dict > 100)
hasil sama: True
set lebih dari 100x lebih cepat dari list: True
dict lebih dari 100x lebih cepat dari list: TrueKita mencari kode pohon yang letaknya paling belakang dari 20.000 kode, kasus terburuk bagi list. Set dan dict lebih dari 100 kali lebih cepat. Pelajaran praktis:
| Kebutuhan | Pilih | Alasan |
|---|---|---|
| Daftar berurutan, sering diurutkan | list |
urutan dijaga |
| Cek “apakah ada?” berulang kali | set |
pencarian langsung |
| Cari data lengkap dari kuncinya | dict |
kunci menunjuk nilai |
| Antrean masuk-keluar dua ujung | collections.deque |
murah di kedua ujung |
Vektorisasi: menghitung sekaligus dengan numpy
Perulangan for di Python itu fleksibel tetapi lambat untuk jutaan angka, karena tiap putaran melewati banyak lapisan. Vektorisasi berarti menyerahkan seluruh perulangan ke numpy, yang menjalankannya dalam kode C yang cepat:
05_vektorisasi.py
# Bab 44 - Vektorisasi dengan numpy: hitung banyak angka sekaligus
import timeit

import numpy as np

rng = np.random.default_rng(42)
diameter_cm = rng.uniform(10, 60, size=1_000_000)


def luas_dengan_loop(diameter):
    hasil = []
    for d in diameter:
        hasil.append(3.14159 * (d / 200) ** 2)
    return hasil


def luas_vektor(diameter):
    return 3.14159 * (diameter / 200) ** 2


sampel = diameter_cm[:5]
print("loop  :", [round(float(x), 5) for x in luas_dengan_loop(sampel)])
print("vektor:", np.round(luas_vektor(sampel), 5).tolist())

t_loop = min(timeit.repeat(lambda: luas_dengan_loop(diameter_cm), number=1, repeat=3))
t_vektor = min(timeit.repeat(lambda: luas_vektor(diameter_cm), number=1, repeat=3))
print("vektor lebih dari 10x lebih cepat:", t_loop / t_vektor > 10)
loop : [0.18626, 0.08014, 0.22003, 0.15811, 0.01699]
vektor: [0.18626, 0.08014, 0.22003, 0.15811, 0.01699]
vektor lebih dari 10x lebih cepat: TrueDua cara memberi hasil yang sama (lima angka contoh identik), tetapi cara vektor lebih dari 10 kali lebih cepat untuk sejuta diameter. Aturan jempolnya: bila Anda menulis for atas array numpy, hampir pasti ada cara yang lebih baik.
Caching: jangan menghitung dua kali
Bila fungsi yang sama dipanggil berulang dengan masukan yang sama, simpan hasilnya. functools.lru_cache melakukannya otomatis:
06_cache.py
# Bab 44 - Caching dengan functools.lru_cache: kena (hit) dan meleset (miss)
from functools import lru_cache

panggilan_asli = 0


@lru_cache(maxsize=None)
def tarif_per_jenis(jenis):
    global panggilan_asli
    panggilan_asli += 1          # hitungan "kerja berat" yang sebenarnya
    return {"Jati": 120.0, "Meranti": 95.0, "Mahoni": 80.0}.get(jenis, 50.0)


pohon = ["Jati", "Meranti", "Jati", "Mahoni", "Jati", "Meranti", "Sengon", "Jati"]
total = sum(tarif_per_jenis(j) for j in pohon)

print("total tarif:", total)
print("kerja berat sungguhan dijalankan:", panggilan_asli, "kali dari", len(pohon), "pemanggilan")
info = tarif_per_jenis.cache_info()
print("kena (hits):", info.hits, "| meleset (misses):", info.misses, "| tersimpan:", info.currsize)

tarif_per_jenis.cache_clear()
print("setelah cache_clear:", tarif_per_jenis.cache_info())
total tarif: 800.0
kerja berat sungguhan dijalankan: 4 kali dari 8 pemanggilan
kena (hits): 4 | meleset (misses): 4 | tersimpan: 4
setelah cache_clear: CacheInfo(hits=0, misses=0, maxsize=None, currsize=0)Ada 8 pohon tetapi hanya 4 jenis berbeda. Pemanggilan pertama untuk tiap jenis meleset (miss: belum ada di cache, kerja berat dijalankan): 4 kali. Sisanya kena (hit: hasil diambil dari cache): 4 kali. real_calls membuktikan kerja berat benar-benar hanya 4 kali. Nilai total 800,0 dihitung dari 4 kali Jati (120 x 4 = 480), 2 Meranti (95 x 2 = 190), 1 Mahoni (80), 1 Sengon (bawaan 50): 480 + 190 + 80 + 50 = 800.
lru_cache hanya cocok untuk fungsi yang murni: hasilnya hanya bergantung pada argumen, dan argumennya harus bisa di-hash (angka, teks, tuple; bukan list). Jangan men-cache fungsi yang hasilnya berubah dari waktu ke waktu (misalnya membaca harga hari ini) tanpa cara menghapus cache (cache_clear()).
Proyek Bersambung A1: mempercepat rekap nilai kayu
Inilah awal proyek Seri A1. Aplikasi kita menghitung nilai kayu per plot dan jenis dari 50.000 pohon (harga fiktif, hanya angka contoh). Versi lambat menyimpan data per baris dan memindai semua pohon untuk tiap kombinasi plot dan jenis. Versi cepat menyimpan data per kolom dan menghitung semuanya sekaligus:
08_proyek_percepat.py
# Bab 44 - Proyek bersambung A1: rekap nilai kayu per plot dan jenis, versi lambat lalu versi cepat
import cProfile
import pstats
import timeit

import numpy as np

JENIS = ["Jati", "Meranti", "Mahoni", "Sengon"]
PLOT = ["A", "B", "C"]
HARGA_M3 = np.array([4_000_000, 2_500_000, 3_000_000, 1_000_000])   # angka contoh fiktif per jenis


def buat_kolom(n):
    """Data disimpan per KOLOM (array numpy): bentuk yang cocok untuk dihitung serempak."""
    rng = np.random.default_rng(42)
    return {
        "jenis": rng.integers(0, len(JENIS), n),
        "plot": rng.integers(0, len(PLOT), n),
        "diameter_cm": rng.uniform(10, 60, n).round(1),
        "tinggi_m": rng.uniform(5, 25, n).round(1),
    }


# ---- Versi 1: lambat. Data per BARIS (list of dict), tiap rekap memindai semuanya lagi ----
def volume_m3(p):
    return 3.14159 * (p["diameter_cm"] / 200) ** 2 * p["tinggi_m"] * 0.5


def nilai_lambat(baris):
    hasil = {}
    for plot in range(len(PLOT)):
        for jenis in range(len(JENIS)):
            total = 0.0
            for p in baris:
                if p["plot"] == plot and p["jenis"] == jenis:
                    total += volume_m3(p) * HARGA_M3[jenis]
            hasil[(PLOT[plot], JENIS[jenis])] = float(total)
    return hasil


# ---- Versi 2: cepat. Data per kolom, satu kali hitung serempak ----
def nilai_cepat(kolom):
    volume = 3.14159 * (kolom["diameter_cm"] / 200) ** 2 * kolom["tinggi_m"] * 0.5
    nilai = volume * HARGA_M3[kolom["jenis"]]
    kelompok = kolom["plot"] * len(JENIS) + kolom["jenis"]
    jumlah = np.bincount(kelompok, weights=nilai, minlength=len(PLOT) * len(JENIS))
    return {(PLOT[k // len(JENIS)], JENIS[k % len(JENIS)]): float(jumlah[k]) for k in range(len(jumlah))}


kolom = buat_kolom(50_000)
baris = [{k: kolom[k][i].item() for k in kolom} for i in range(50_000)]   # versi baris untuk versi lambat

lambat = nilai_lambat(baris)
cepat = nilai_cepat(kolom)
sama = all(abs(lambat[k] - cepat[k]) < 1e-6 * lambat[k] for k in lambat)
print("kedua versi memberi hasil sama:", sama)
print("jumlah kelompok (plot x jenis):", len(cepat))
print("lambat mengunjungi tiap pohon", len(PLOT) * len(JENIS), "kali; cepat hanya 1 kali")

panggilan = {}
for nama, fungsi, data in [("lambat", nilai_lambat, baris), ("cepat", nilai_cepat, kolom)]:
    profil = cProfile.Profile()
    profil.runcall(fungsi, data)
    st = pstats.Stats(profil)
    panggilan[nama] = sum(v[1] for k, v in st.stats.items() if k[2] == "volume_m3")
    print(f"versi {nama}: pemanggilan volume_m3 = {panggilan[nama]}")

t_lambat = min(timeit.repeat(lambda: nilai_lambat(baris), number=1, repeat=3))
t_cepat = min(timeit.repeat(lambda: nilai_cepat(kolom), number=1, repeat=3))
print("versi cepat lebih dari 20x lebih cepat:", t_lambat / t_cepat > 20)
kedua versi memberi hasil sama: True
jumlah kelompok (plot x jenis): 12
lambat mengunjungi tiap pohon 12 kali; cepat hanya 1 kali
versi lambat: pemanggilan volume_m3 = 50000
versi cepat: pemanggilan volume_m3 = 0
versi cepat lebih dari 20x lebih cepat: TruePerhatikan urutannya: pertama membuktikan hasilnya sama (tanpa itu, “lebih cepat” tak ada artinya), lalu cProfile menunjukkan versi lambat memanggil volume_m3 50.000 kali dan versi cepat tidak sama sekali, lalu perbandingan waktu yang kita nyatakan secara kualitatif (lebih dari 20 kali). Angka “20 kali” itu batas longgar; di komputer Anda selisih sebenarnya bisa jauh lebih besar atau sedikit lebih kecil.
Proyek ini kita bawa ke bab berikutnya: kode yang sudah cepat sebaiknya dikemas rapi menjadi paket.
Latihan
- Jalankan
01_cprofile.pydengan 6000 pohon, bukan 3000. Perkirakan lebih dulu: berapa panggilanluas_dasar? Cocokkan dengan keluaran. - Ubah
04_struktur_data.pyagar mencari kode"P00000"(paling depan). Apakah list masih jauh lebih lambat? Jelaskan dugaan Anda. - Tambahkan
@lru_cache(maxsize=2)padatarif_per_jenisdi06_cache.pydan perhatikan perubahanmisses. Mengapa bisa bertambah? - Tantangan: ubah
08_proyek_percepat.pyagar juga menghitung rata-rata diameter per plot dan jenis dengannp.bincount(petunjuk: bagi jumlah diameter dengan banyaknya pohon per kelompok), lalu cocokkan dengan versi lambat.
Ringkasan Bab
- Ukur dulu, lalu perbaiki satu hal, lalu ukur lagi. Menebak titik lambat sering salah.
cProfilemenunjukkan fungsi mana yang berat;line_profilermenunjukkan barisnya;memory_profilermengukur memori.- Waktu tidak stabil antar komputer. Andalkan jumlah panggilan dan perbandingan, bukan angka detik tunggal.
- Pilih struktur data yang tepat:
setdandictuntuk pencarian,listuntuk urutan. - Vektorisasi dengan numpy menggantikan
foratas jutaan angka. lru_cachemenyimpan hasil fungsi murni;cache_info()menghitung kena dan meleset.
Selanjutnya, di Bab 45: pengemasan, mengubah folder kode menjadi paket Python yang rapi dan bisa dipasang orang lain.