%%{init: {"flowchart": {"diagramPadding": 40}}}%%
flowchart TD
  A["Pertanyaan penelitian"] --> B["Wawancara<br/>terbuka"]
  A --> C["Survei<br/>angka"]
  B --> D["Pengodean tema<br/>(Python: teks)"]
  C --> E["Statistik<br/>(Python: Bab 26-27)"]
  D --> F["Tampilan gabungan<br/>(joint display)"]
  E --> F
  F --> G["Kesimpulan<br/>dan validasi"]
Bab 28 — Metode Kualitatif dan Campuran: Mendengar Cerita, Lalu Menghitungnya
Seri I3 — Statistik dan Pemodelan
Semua skrip bab ini ada di folder kode/bab28/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Bab 26 dan 27 berurusan dengan angka. Tetapi bila Anda ingin tahu mengapa petani enggan menanam pohon di lahannya, atau bagaimana nelayan menghadapi musim paceklik, angka saja tidak cukup. Anda perlu mendengar cerita. Bayangkan seorang dokter hewan: angka suhu sapi memberi tahu bahwa sapi demam, tetapi cerita peternak (“kemarin sapi saya menolak makan, dan tetangga saya kehilangan dua ekor”) memberi tahu mengapa dan apa yang harus dicari. Metode kualitatif menganalisis kata, makna, dan cerita; metode campuran (mixed methods) menggabungkan keduanya.
PeringatanAWAS
Catatan etika dan data tiruan. Semua responden, kutipan wawancara, dan angka survei di bab ini fiktif, ditulis oleh penulis buku untuk latihan, dan tidak mewakili orang atau desa mana pun. Pada penelitian sungguhan Anda wajib: (1) meminta persetujuan responden setelah menjelaskan tujuan dan risikonya (informed consent, idealnya tertulis); (2) menyamarkan identitas (anonimisasi) pada data dan laporan; (3) menyimpan rekaman dan transkrip dengan aman; (4) menjelaskan bahwa responden boleh berhenti kapan saja. Untuk komunitas adat dan lokal, ada pula prinsip persetujuan komunitas yang diminta lebih dulu tanpa paksaan, yang perlu dipelajari dari pedoman lembaga etik Anda. Cek juga aturan lembaga atau universitas tentang izin penelitian.
Kualitatif, kuantitatif, atau campuran?
| Kuantitatif | Kualitatif | |
|---|---|---|
| Pertanyaan khas | Berapa banyak? Seberapa besar? Apakah beda? | Mengapa? Bagaimana? Apa maknanya? |
| Data | Angka (bobot, hasil panen, skor 1-5) | Teks, cerita, pengamatan, dokumen |
| Sampel | Besar, acak | Kecil, dipilih sesuai tujuan |
| Alat utama | Uji hipotesis, regresi (Bab 26-27) | Pengodean tema, analisis isi |
| Kekuatan | Dapat digeneralisasi, terukur | Kaya konteks, menemukan hal tak terduga |
| Kelemahan | Dangkal pada “mengapa” | Sulit digeneralisasi, rawan subjektivitas |
Aturan praktis: kuantitatif untuk “berapa”, kualitatif untuk “mengapa”, dan keduanya bila keputusan yang dibuat penting. Ada tiga desain campuran umum:
- Sekuensial menjelaskan: survei angka dulu, lalu wawancara untuk menjelaskan temuan aneh.
- Sekuensial menjajaki: wawancara dulu untuk menemukan topik, lalu survei untuk mengukur seberapa umum.
- Konvergen (paralel): keduanya dikumpulkan bersamaan lalu dibandingkan. Proyek kita memakai ini.
Data wawancara tiruan kita
Kita memakai 24 wawancara singkat fiktif: 8 petani, 8 nelayan, 8 peternak. Pertanyaan terbukanya: “Apa perubahan terbesar yang Anda rasakan dalam lima tahun terakhir, dan bagaimana Anda menghadapinya?” Tiap responden juga mengisi skor kepuasan (1 sampai 5) dan penghasilan (juta rupiah per bulan), sehingga kita punya cerita dan angka untuk orang yang sama. Datanya ada di kode/bab28/data/wawancara.csv.
01_data_wawancara.py
# Bab 28 - Membaca data wawancara tiruan (fiktif)
from pathlib import Path

import pandas as pd

# CATATAN ETIKA: seluruh responden dan kutipan di bab ini FIKTIF, ditulis penulis buku.
# Pada penelitian sungguhan Anda wajib meminta persetujuan tertulis (informed consent),
# menyamarkan identitas (anonimisasi), dan menyimpan rekaman dengan aman.
data = pd.read_csv(Path(__file__).parent / "data" / "wawancara.csv")

print("Jumlah responden:", len(data))
print(data["peran"].value_counts().to_string())
print()
print("Kepuasan rata-rata (skala 1-5) per peran:")
print(data.groupby("peran")["kepuasan"].mean().round(2).to_string())
print()
data["jumlah_kata"] = data["jawaban"].str.split().str.len()
print("Panjang jawaban (kata): min", data["jumlah_kata"].min(), " maks", data["jumlah_kata"].max(),
      " rata-rata", round(data["jumlah_kata"].mean(), 1))
print()
for _, baris in data.head(3).iterrows():
    print(f"[{baris['kode']}, {baris['peran']}, {baris['umur']} th] {baris['jawaban']}")
Jumlah responden: 24
peran
petani 8
nelayan 8
peternak 8
Kepuasan rata-rata (skala 1-5) per peran:
peran
nelayan 2.50
petani 2.75
peternak 3.00
Panjang jawaban (kata): min 18 maks 24 rata-rata 20.4
[R01, petani, 45 th] Hujan sekarang tidak menentu. Tahun lalu sawah saya kekeringan padahal sudah tanam, dan panen turun hampir separuh. Saya khawatir tahun ini terulang.
[R02, petani, 52 th] Pupuk makin mahal, tetapi harga gabah jatuh waktu panen raya. Tengkulak datang menawar murah dan kami terpaksa menjual karena butuh uang.
[R03, petani, 38 th] Kelompok tani kami membantu. Kami membeli pupuk bersama sehingga lebih murah, dan penyuluh datang tiap bulan. Hasil panen tahun ini bagus dan saya senang.Tiap kelompok 8 orang. Kepuasan rata-rata nelayan 2,50, petani 2,75, peternak 3,00. Jawaban pendek, 18 sampai 24 kata (wawancara sungguhan jauh lebih panjang). Tiga kutipan pertama menunjukkan ragam isinya: kekeringan, harga murah dari tengkulak, dan kelompok tani yang membantu.
Pengodean tema
Pengodean (coding) adalah memberi label pada potongan teks yang membicarakan hal yang sama. Label itu disebut kode atau tema. Daftar tema beserta definisinya disebut buku kode (codebook). Ada dua cara menyusunnya:
- Induktif: tema muncul dari data; Anda membaca dulu, lalu menamai pola yang berulang.
- Deduktif: tema berasal dari teori atau pertanyaan penelitian, lalu dicari di data.
Pada praktiknya peneliti memakai campuran: mulai induktif dari sebagian transkrip, menyusun buku kode, lalu menerapkannya deduktif ke seluruh data. Python membantu langkah terakhir. Cara paling sederhana: tiap tema punya daftar kata kunci.
02_pengodean_tema.py
# Bab 28 - Pengodean tema berbasis buku kode (codebook) sederhana
import re
from pathlib import Path

import pandas as pd

data = pd.read_csv(Path(__file__).parent / "data" / "wawancara.csv")

# Buku kode: tema -> kata kunci (awalan kata). Disusun peneliti setelah membaca sebagian data.
buku_kode = {
    "iklim": ["hujan", "kemarau", "cuaca", "banjir", "kering", "gelombang", "paceklik"],
    "harga_pasar": ["harga", "tengkulak", "pengepul", "jual", "margin"],
    "biaya_modal": ["modal", "pinjam", "bunga", "mahal", "biaya", "solar", "pupuk", "pakan"],
    "hama_penyakit": ["hama", "wereng", "penyakit", "vaksin", "mati", "bom ikan"],
    "kerja_sama": ["kelompok", "koperasi", "gotong royong", "bersama", "berbagi", "kerja sama"],
    "teknologi_info": ["aplikasi", "ponsel", "video", "informasi", "pelatihan", "penyuluh"],
    "aturan_lahan": ["izin", "kawasan", "digusur", "aturan", "zona", "sertifikat", "petugas"],
}


def beri_kode(teks):
    """Daftar tema yang kata kuncinya muncul di teks (huruf kecil, awal kata)."""
    teks = teks.lower()
    return [tema for tema, kunci in buku_kode.items()
            if any(re.search(r"\b" + re.escape(k), teks) for k in kunci)]


data["tema"] = data["jawaban"].apply(beri_kode)
for tema in buku_kode:
    data[tema] = data["tema"].apply(lambda daftar: tema in daftar)

print("Jumlah responden yang menyebut tiap tema (dari", len(data), "responden):")
print(data[list(buku_kode)].sum().sort_values(ascending=False).to_string())
print()
print("Rata-rata tema per responden:", round(data["tema"].str.len().mean(), 2))
print("Responden tanpa tema satu pun:", int((data["tema"].str.len() == 0).sum()))
print()
for kode in ("R01", "R03", "R09"):
    baris = data[data["kode"] == kode].iloc[0]
    print(kode, "->", baris["tema"])
Jumlah responden yang menyebut tiap tema (dari 24 responden):
biaya_modal 11
harga_pasar 9
iklim 7
teknologi_info 6
kerja_sama 5
hama_penyakit 4
aturan_lahan 3
Rata-rata tema per responden: 1.88
Responden tanpa tema satu pun: 0
R01 -> ['iklim']
R03 -> ['biaya_modal', 'kerja_sama', 'teknologi_info']
R09 -> ['iklim']re.search(r"\b" + kata, teks)mencari kata kunci yang diawali pada batas kata.\bberarti “batas kata”, dipelajari di Bab 22.- Tema terbanyak adalah
biaya_modal(11 dari 24 responden), laluharga_pasar(9) daniklim(7). Tema paling jarang:aturan_lahan(3). - Rata-rata 1,88 tema per responden: satu jawaban sering membicarakan beberapa hal, jadi jumlah tema lebih besar dari jumlah responden. R03 mendapat tiga tema:
biaya_modal,kerja_sama, danteknologi_info.
PeringatanAWAS
Kode berbasis kata kunci cepat dan konsisten tetapi kasar. Kata kering tidak menemukan “kekeringan” (awalannya beda), dan kata mahal selalu dihitung sebagai biaya padahal bisa tentang hal lain. Karena itu hasil mesin perlu dibaca ulang manusia. Anggap kode otomatis sebagai asisten yang cepat tetapi sembrono, bukan hakim.
Analisis isi: frekuensi kata dan KWIC
Analisis isi menghitung dan mengelompokkan unsur teks secara sistematis. Dua alat dasar: frekuensi kata (setelah membuang kata umum seperti “yang”, “dan”, yang disebut stopword) dan KWIC (keyword in context), yaitu menampilkan sebuah kata kunci dengan beberapa kata di kiri dan kanannya agar Anda melihat bagaimana kata itu dipakai.
03_frekuensi_kata.py
# Bab 28 - Analisis isi: frekuensi kata dan KWIC (kata dalam konteks)
import re
from collections import Counter
from pathlib import Path

import pandas as pd

data = pd.read_csv(Path(__file__).parent / "data" / "wawancara.csv")

KATA_UMUM = set("""yang dan di ke dari untuk dengan pada itu ini saya kami kita tidak tetapi karena
sudah masih juga atau jadi tahun lalu sekarang makin sangat bisa ada akan kalau saat waktu lebih
hanya agar oleh dalam sering banyak tiap satu dua sehingga padahal serta mereka mau sama harus""".split())


def kata_kata(teks):
    return [k for k in re.findall(r"[a-z]+", teks.lower()) if k not in KATA_UMUM and len(k) > 2]


semua = Counter()
for jawaban in data["jawaban"]:
    semua.update(kata_kata(jawaban))

print("15 kata paling sering (setelah membuang kata umum):")
for kata, n in semua.most_common(15):
    print(f"  {kata:12} {n}")

# KWIC: tampilkan kata kunci beserta 4 kata di kiri dan kanan
print()
print("Konteks kata 'harga':")
for kode, jawaban in zip(data["kode"], data["jawaban"]):
    token = re.findall(r"[A-Za-z]+", jawaban)
    for i, t in enumerate(token):
        if t.lower() == "harga":
            kiri = " ".join(token[max(0, i - 4):i])
            kanan = " ".join(token[i + 1:i + 5])
            print(f"  {kode}: ...{kiri} [{t}] {kanan}...")
            break
15 kata paling sering (setelah membuang kata umum):
harga 9
ikan 8
pakan 6
datang 5
membantu 5
rugi 5
naik 5
turun 4
mahal 4
bagus 4
musim 4
sulit 4
biaya 4
panen 3
khawatir 3
Konteks kata 'harga':
R02: ...Pupuk makin mahal tetapi [harga] gabah jatuh waktu panen...
R05: ...melihat prakiraan cuaca dan [harga] Informasinya membantu menentukan waktu...
R11: ...kami menjual ikan dengan [harga] stabil dan menyediakan es...
R12: ...Pengepul menentukan [harga] dan sering menekan kami...
R13: ...ikan lebih segar dan [harga] lebih baik...
R21: ...Bobot sapi naik dan [harga] jual bagus Kerja sama...
R22: ... [Harga] ayam jatuh waktu banyak...Kata paling sering: harga (9), ikan (8), pakan (6). Frekuensi memberi petunjuk, bukan jawaban: “harga” muncul banyak, tetapi KWIC memperlihatkan konteksnya sangat berbeda. R02: harga gabah jatuh (buruk); R11: harga stabil lewat koperasi (baik); R22: harga ayam jatuh sementara pakan tetap mahal. Kata yang sama, makna berlawanan. Itulah mengapa analisis isi tidak boleh berhenti di hitungan.
Pada analisis dokumen kebijakan (misalnya peraturan pengelolaan hutan), alat yang sama dipakai: hitung kata kunci seperti “masyarakat”, “izin”, dan “sanksi”, lalu bandingkan dengan KWIC untuk melihat siapa yang disebut sebagai subjek dan siapa sebagai objek. Analisis wacana melangkah lebih jauh: ia bertanya bagaimana pilihan kata membentuk gambaran tentang siapa yang berwenang dan siapa yang bersalah. Bagian ini lebih banyak membaca cermat daripada menghitung, dan Python hanya membantu menemukan bagian yang layak dibaca.
TF-IDF: kata yang khas
Kata yang sering belum tentu khas. “Ikan” sering muncul pada nelayan, tetapi apa yang membedakan nelayan dari petani? TF-IDF (term frequency-inverse document frequency) memberi skor tinggi pada kata yang sering di dokumen ini tetapi jarang di dokumen lain. Di sini, tiap kelompok peran digabung menjadi satu “dokumen”.
04_tfidf.py
# Bab 28 - TF-IDF: kata yang khas untuk tiap kelompok responden
from pathlib import Path

import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer

data = pd.read_csv(Path(__file__).parent / "data" / "wawancara.csv")

KATA_UMUM = """yang dan di ke dari untuk dengan pada itu ini saya kami kita tidak tetapi karena
sudah masih juga atau jadi tahun lalu sekarang makin sangat bisa ada akan kalau saat waktu lebih
hanya agar oleh dalam sering banyak tiap satu dua sehingga padahal serta mereka mau sama harus""".split()

# Gabungkan semua jawaban per peran menjadi satu "dokumen"
per_peran = data.groupby("peran")["jawaban"].apply(" ".join)

vektor = TfidfVectorizer(stop_words=KATA_UMUM, token_pattern=r"[a-z]{3,}", lowercase=True)
matriks = vektor.fit_transform(per_peran)
kata = vektor.get_feature_names_out()

print("Ukuran matriks (peran x kata):", matriks.shape)
for i, peran in enumerate(per_peran.index):
    skor = pd.Series(matriks[i].toarray()[0], index=kata).sort_values(ascending=False)
    print(f"{peran:9}", ", ".join(f"{k} ({s:.2f})" for k, s in skor.head(5).items()))
Ukuran matriks (peran x kata): (3, 217)
nelayan ikan (0.63), harga (0.19), karang (0.16), tangkapan (0.16), penghasilan (0.16)
petani panen (0.29), pupuk (0.19), murah (0.19), tanam (0.19), tengkulak (0.19)
peternak pakan (0.48), membuat (0.24), ternak (0.24), naik (0.18), datang (0.18)Matriks berukuran 3 peran x 217 kata. Kata khas nelayan: ikan, karang, tangkapan. Petani: panen, pupuk, tengkulak, tanam. Peternak: pakan, ternak. Skor TF-IDF tinggi artinya “ciri pembeda kelompok ini”. Ini cara cepat menyusun gambaran awal sebelum membaca mendalam.
Topic modeling: topik dari tumpukan teks
Bila teksnya ribuan halaman, tidak mungkin membaca semuanya. Topic modeling mencari topik yang tersembunyi: kelompok kata yang cenderung muncul bersama. Kita pakai NMF (non-negative matrix factorization) dari scikit-learn pada matriks TF-IDF. Alternatif yang populer adalah LatentDirichletAllocation (LDA) di pustaka yang sama; keduanya dipakai serupa. Jumlah topik (n_components) kita tentukan sendiri.
05_topik_nmf.py
# Bab 28 - Topic modeling dengan NMF (scikit-learn)
from pathlib import Path

import numpy as np
import pandas as pd
from sklearn.decomposition import NMF
from sklearn.feature_extraction.text import TfidfVectorizer

data = pd.read_csv(Path(__file__).parent / "data" / "wawancara.csv")

KATA_UMUM = """yang dan di ke dari untuk dengan pada itu ini saya kami kita tidak tetapi karena
sudah masih juga atau jadi tahun lalu sekarang makin sangat bisa ada akan kalau saat waktu lebih
hanya agar oleh dalam sering banyak tiap satu dua sehingga padahal serta mereka mau sama harus""".split()

vektor = TfidfVectorizer(stop_words=KATA_UMUM, token_pattern=r"[a-z]{3,}", min_df=2)
X = vektor.fit_transform(data["jawaban"])
kata = vektor.get_feature_names_out()
print("Kata yang dipakai (muncul di >= 2 jawaban):", len(kata))

model = NMF(n_components=4, init="nndsvd", random_state=42, max_iter=500)
bobot_dok = model.fit_transform(X)          # responden x topik

for t, komponen in enumerate(model.components_):
    atas = np.argsort(komponen)[::-1][:6]
    print(f"Topik {t + 1}:", ", ".join(kata[atas]))

data["topik"] = bobot_dok.argmax(axis=1) + 1
print()
print("Jumlah responden dominan di tiap topik:")
print(data["topik"].value_counts().sort_index().to_string())
print()
print(pd.crosstab(data["topik"], data["peran"]).to_string())
Kata yang dipakai (muncul di >= 2 jawaban): 55
Topik 1: harga, jatuh, turun, hampir, menjual, khawatir
Topik 2: musim, sulit, biaya, panjang, pinjaman, membuat
Topik 3: jelas, takut, butuh, hewan, besar, menyerang
Topik 4: ikan, bagus, belajar, naik, bersama, membantu
Jumlah responden dominan di tiap topik:
topik
1 6
2 6
3 4
4 8
peran nelayan petani peternak
topik
1 2 3 1
2 1 3 2
3 1 1 2
4 4 1 3Kata yang dipakai hanya yang muncul di sedikitnya 2 jawaban (55 kata). Empat topik yang ditemukan, dengan kata teratasnya:
- Topik 1: harga, jatuh, turun, menjual: soal harga yang anjlok.
- Topik 2: musim, sulit, biaya, pinjaman: soal musim sulit dan biaya.
- Topik 3: takut, hewan, menyerang, jelas: soal ancaman dan ketidakpastian.
- Topik 4: ikan, bagus, belajar, bersama, membantu: soal dukungan dan keberhasilan bersama.
Nama topik adalah tafsiran kita, bukan keluaran mesin. Dengan hanya 24 jawaban pendek, topiknya kasar dan akan berubah bila Anda mengganti jumlah topik atau benih acak. Topic modeling cocok untuk menjelajah tumpukan teks besar, bukan untuk membuktikan sesuatu. Tabel silang di bawah menunjukkan topik 4 (dukungan) paling banyak dibicarakan oleh nelayan (4 orang) dan peternak (3).
Sentimen berbasis kamus
Analisis sentimen menilai apakah teks bernada positif atau negatif. Cara paling sederhana memakai kamus: daftar kata positif dan negatif, lalu skor = jumlah positif dikurangi jumlah negatif. Kita bandingkan dengan skor kepuasan yang diisi responden sendiri untuk menguji apakah kamus kita masuk akal.
06_sentimen_kamus.py
# Bab 28 - Analisis sentimen berbasis kamus sederhana
from pathlib import Path
import re

import pandas as pd
from scipy import stats

data = pd.read_csv(Path(__file__).parent / "data" / "wawancara.csv")

POSITIF = {"membantu", "bagus", "senang", "puas", "membaik", "naik", "lancar", "stabil", "segar",
           "sehat", "baik", "melimpah", "murah", "menolong", "unggul"}
NEGATIF = {"khawatir", "rugi", "sulit", "susah", "mahal", "turun", "jatuh", "takut", "mati",
           "rusak", "hilang", "kurang", "tipis", "lambat", "membingungkan", "kekeringan", "kurus", "menekan"}


def skor_sentimen(teks):
    kata = re.findall(r"[a-z]+", teks.lower())
    return sum(k in POSITIF for k in kata) - sum(k in NEGATIF for k in kata)


data["sentimen"] = data["jawaban"].apply(skor_sentimen)
data["label"] = pd.cut(data["sentimen"], bins=[-99, -1, 0, 99], labels=["negatif", "netral", "positif"])

print(data["label"].value_counts().reindex(["negatif", "netral", "positif"]).to_string())
print()
print("Rata-rata kepuasan per label sentimen:")
print(data.groupby("label", observed=True)["kepuasan"].mean().round(2).to_string())

rho, p = stats.spearmanr(data["sentimen"], data["kepuasan"])
print()
print("Korelasi sentimen kamus vs skor kepuasan (Spearman):", round(rho, 3), " p =", format(p, ".1e"))

# Kelemahan kamus: cari responden yang labelnya bertentangan dengan skor kepuasannya
salah = data[((data["label"] == "positif") & (data["kepuasan"] <= 3))
             | ((data["label"] == "negatif") & (data["kepuasan"] >= 4))]
print()
print("Label bertentangan dengan kepuasan:", len(salah), "dari", len(data))

# Di data tiruan yang rapi ini kamus nyaris sempurna. Di dunia nyata ia gampang tertipu:
for kalimat in ("Hasil panen tidak bagus", "Pakan naik terus", "Harga naik, saya senang"):
    print(f"  '{kalimat}' -> skor {skor_sentimen(kalimat)}")
label
negatif 17
netral 0
positif 7
Rata-rata kepuasan per label sentimen:
label
negatif 2.06
positif 4.43
Korelasi sentimen kamus vs skor kepuasan (Spearman): 0.802 p = 2.5e-06
Label bertentangan dengan kepuasan: 0 dari 24
'Hasil panen tidak bagus' -> skor 1
'Pakan naik terus' -> skor 1
'Harga naik, saya senang' -> skor 2- 17 jawaban bernada negatif dan 7 positif. Rata-rata kepuasan: 2,06 untuk yang negatif dan 4,43 untuk yang positif. Korelasi Spearman antara skor kamus dan kepuasan 0,802 (p = 2,5e-06): kamus kita cocok dengan penilaian responden. Perhatikan bahwa ini validasi: kita menguji alat dengan data pembanding.
- Pada data tiruan yang rapi ini tidak ada label yang bertentangan dengan kepuasan. Di dunia nyata kamus mudah tertipu. Tiga kalimat uji menunjukkan kelemahannya: “Hasil panen tidak bagus” bernilai +1 (kamus tidak mengerti negasi), “Pakan naik terus” bernilai +1 (naik itu baik untuk penghasilan, buruk untuk biaya), dan sarkasme tak terdeteksi.
TipTIPS
Untuk bahasa Indonesia, kamus sentimen siap pakai terbatas, dan kata bergantung pada bidang (di pertanian, “naik” bisa baik atau buruk). Susun kamus khusus bidang Anda, uji pada sampel yang dinilai manusia, dan laporkan kecocokannya.
Embedding: kata menjadi titik di peta makna
Komputer tidak mengerti kata, hanya angka. Embedding adalah cara mengubah teks menjadi deretan angka (vektor) sehingga teks yang mirip maknanya punya vektor yang berdekatan. Bayangkan peta: kota yang berdekatan secara geografis dekat di peta. Embedding membuat “peta makna”: “banjir” dan “hujan lebat” berada berdekatan, “vaksin” jauh dari “solar”.
Model bahasa besar menghasilkan embedding berkualitas tinggi, tetapi model itu besar dan tidak dipasang di buku ini; ia dibahas di Seri A4. Di sini kita membuat embedding mini dengan cara klasik: TF-IDF lalu dipadatkan oleh TruncatedSVD (disebut juga latent semantic analysis, LSA). Prinsipnya sama: teks menjadi vektor pendek, lalu kemiripan diukur dengan kemiripan kosinus (1 = arah sama, 0 = tak berkaitan).
09_embedding_konsep.py
# Bab 28 - Konsep embedding: teks menjadi vektor, jarak = kemiripan makna
from pathlib import Path

import numpy as np
import pandas as pd
from sklearn.decomposition import TruncatedSVD
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity

data = pd.read_csv(Path(__file__).parent / "data" / "wawancara.csv")

# Langkah 1: teks -> vektor TF-IDF (satu angka per kata, mayoritas nol)
tfidf = TfidfVectorizer(token_pattern=r"[a-z]{3,}")
X = tfidf.fit_transform(data["jawaban"])
print("Vektor TF-IDF: tiap jawaban punya", X.shape[1], "angka")

# Langkah 2: padatkan jadi 6 angka (LSA). Ini embedding mini, bukan model bahasa besar.
svd = TruncatedSVD(n_components=6, random_state=42)
tertanam = svd.fit_transform(X)
print("Setelah dipadatkan: tiap jawaban punya", tertanam.shape[1], "angka")

# Langkah 3: kemiripan kosinus antar jawaban; cari tetangga terdekat R01
kemiripan = cosine_similarity(tertanam)
np.fill_diagonal(kemiripan, -1)
print()
for kode in ("R01", "R17"):
    i = data.index[data["kode"] == kode][0]
    terdekat = np.argsort(kemiripan[i])[::-1][:2]
    print(f"Jawaban termirip dengan {kode}:")
    for j in terdekat:
        print(f"   {data.loc[j, 'kode']} (kemiripan {kemiripan[i, j]:.2f}): {data.loc[j, 'jawaban'][:55]}...")
Vektor TF-IDF: tiap jawaban punya 250 angka
Setelah dipadatkan: tiap jawaban punya 6 angka
Jawaban termirip dengan R01:
R24 (kemiripan 0.66): Kandang saya rusak karena banjir. Modal untuk memperbai...
R06 (kemiripan 0.65): Lahan saya dekat kawasan hutan dan izinnya tidak jelas....
Jawaban termirip dengan R17:
R10 (kemiripan 0.89): Solar mahal dan hasil tangkapan menurun. Ikan makin jau...
R23 (kemiripan 0.76): Saya belajar dari video di ponsel tentang membuat pakan...Tiap jawaban awalnya 250 angka (satu per kata), lalu dipadatkan menjadi 6 angka. Jawaban termirip dengan R17 (pakan ternak mahal) adalah R10 (solar mahal dan hasil tangkapan menurun, kemiripan 0,89) dan R23 (biaya pakan, 0,76): pola “biaya input” ditemukan tanpa kita menyebut kata kuncinya. Untuk R01 (kekeringan), tetangganya R24 (banjir) dan R06 (izin lahan); yang kedua kurang masuk akal, tanda bahwa embedding mini dari 24 jawaban masih kasar. Embedding dari model besar jauh lebih peka terhadap makna.
Mengubah data kualitatif menjadi kuantitatif
Setelah tema dikode, tiap responden punya vektor 0/1: menyebut tema itu atau tidak. Itu data kuantitatif, dan semua alat Bab 26 berlaku.
07_kualitatif_ke_kuantitatif.py
# Bab 28 - Mengubah data kualitatif menjadi kuantitatif: tema menjadi tabel angka
import re
from pathlib import Path

import pandas as pd
from scipy import stats

data = pd.read_csv(Path(__file__).parent / "data" / "wawancara.csv")

buku_kode = {
    "iklim": ["hujan", "kemarau", "cuaca", "banjir", "kering", "gelombang", "paceklik"],
    "harga_pasar": ["harga", "tengkulak", "pengepul", "jual", "margin"],
    "biaya_modal": ["modal", "pinjam", "bunga", "mahal", "biaya", "solar", "pupuk", "pakan"],
    "hama_penyakit": ["hama", "wereng", "penyakit", "vaksin", "mati", "bom ikan"],
    "kerja_sama": ["kelompok", "koperasi", "gotong royong", "bersama", "berbagi", "kerja sama"],
    "teknologi_info": ["aplikasi", "ponsel", "video", "informasi", "pelatihan", "penyuluh"],
    "aturan_lahan": ["izin", "kawasan", "digusur", "aturan", "zona", "sertifikat", "petugas"],
}
for tema, kunci in buku_kode.items():
    data[tema] = data["jawaban"].str.lower().apply(
        lambda t: int(any(re.search(r"\b" + re.escape(k), t) for k in kunci)))

# 1. Tabel tema x peran (jumlah responden yang menyebut)
print("Jumlah penyebut tema per peran:")
print(data.groupby("peran")[list(buku_kode)].sum().T.to_string())

# 2. Apakah responden yang menyebut kerja sama lebih puas?
ya = data[data["kerja_sama"] == 1]["kepuasan"]
tidak = data[data["kerja_sama"] == 0]["kepuasan"]
print()
print("Kepuasan rata-rata, menyebut kerja sama:", round(ya.mean(), 2), "(n =", len(ya), ")")
print("Kepuasan rata-rata, tidak menyebut     :", round(tidak.mean(), 2), "(n =", len(tidak), ")")
print("Mann-Whitney p =", round(stats.mannwhitneyu(ya, tidak).pvalue, 4))

# 3. Tabel 2x2 dan uji Fisher (cocok untuk sampel kecil)
tinggi = (data["kepuasan"] >= 4).astype(int)
tabel = pd.crosstab(data["kerja_sama"], tinggi)
print()
print(tabel.to_string())
print("Fisher exact p =", round(stats.fisher_exact(tabel)[1], 4))
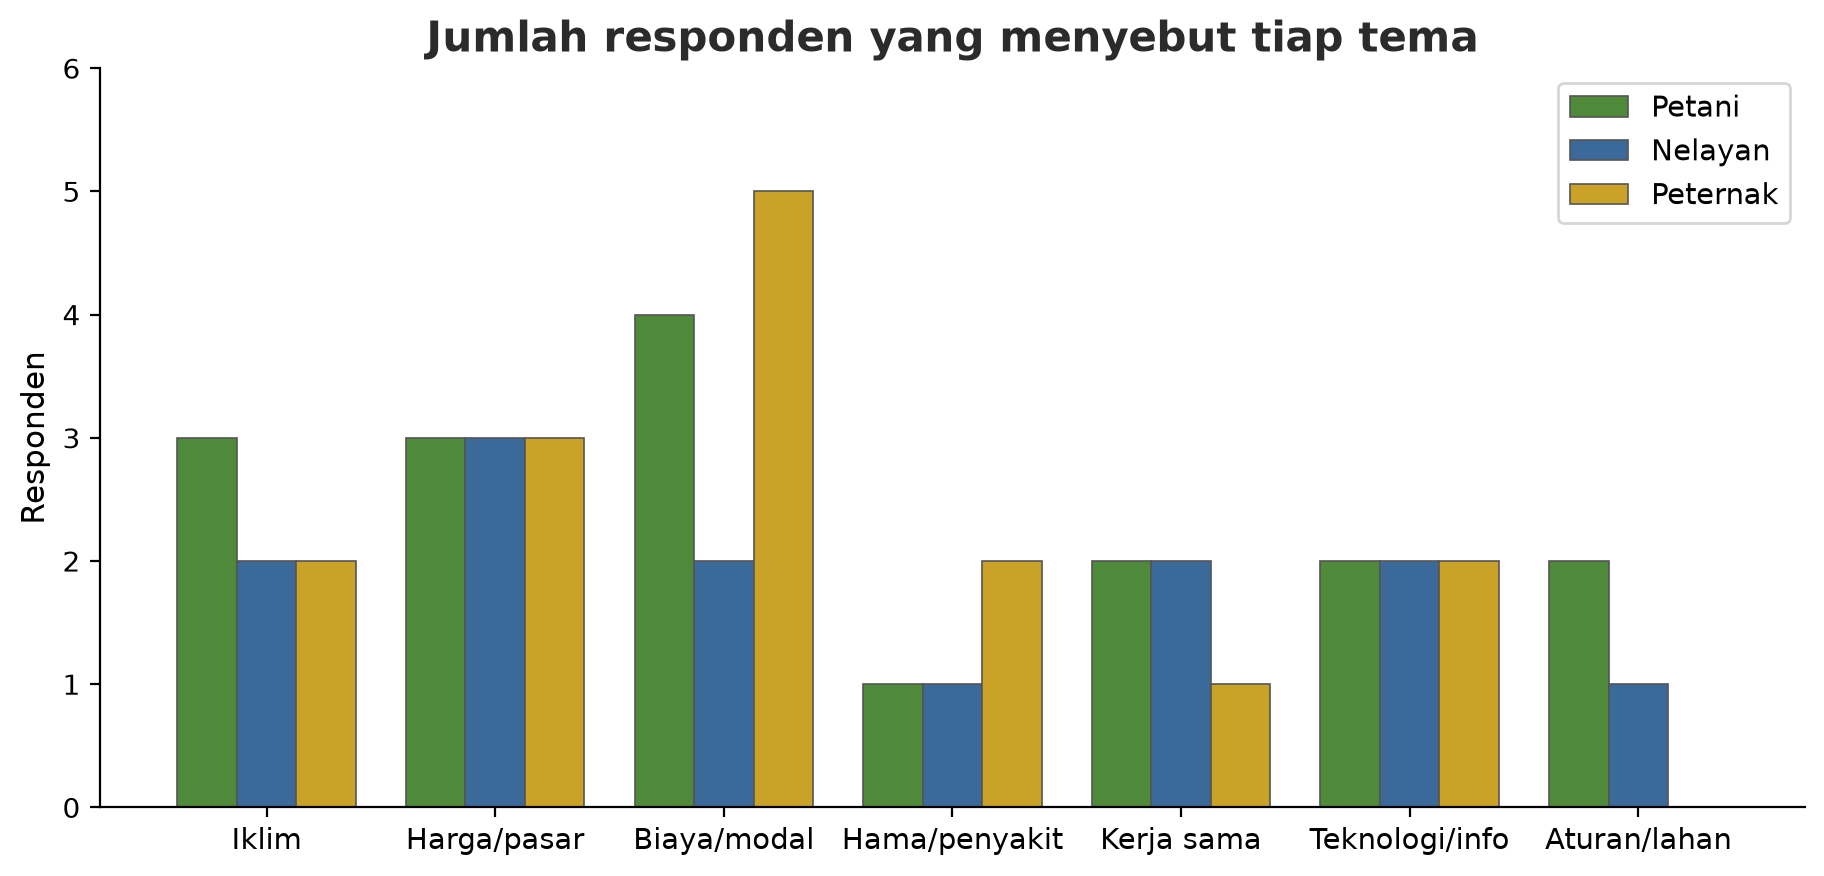
Jumlah penyebut tema per peran:
peran nelayan petani peternak
iklim 2 3 2
harga_pasar 3 3 3
biaya_modal 2 4 5
hama_penyakit 1 1 2
kerja_sama 2 2 1
teknologi_info 2 2 2
aturan_lahan 1 2 0
Kepuasan rata-rata, menyebut kerja sama: 3.8 (n = 5 )
Kepuasan rata-rata, tidak menyebut : 2.47 (n = 19 )
Mann-Whitney p = 0.0393
kepuasan 0 1
kerja_sama
0 15 4
1 2 3
Fisher exact p = 0.1265- Tabel tema x peran menunjukkan misalnya
biaya_modaldisebut 5 dari 8 peternak, 4 petani, dan 2 nelayan. - Responden yang menyebut kerja sama (n = 5) rata-rata puas 3,8 versus 2,47 untuk yang tidak menyebut (n = 19). Uji Mann-Whitney: p = 0,0393.
- Tetapi ketika kepuasan dibuat dua kelompok (4 atau lebih) dan diuji dengan Fisher exact (cocok untuk tabel kecil), p = 0,1265: tidak signifikan. Dengan sampel sekecil ini, kesimpulan bergantung pada cara menguji, dan keduanya wajib dilaporkan dengan jujur. Jangan memilih uji yang memberi p kecil.
Validitas dan reliabilitas
- Validitas: apakah kita mengukur apa yang kita maksud? Dalam kualitatif, caranya antara lain triangulasi (memeriksa dengan sumber atau metode lain, misalnya wawancara dibandingkan dengan survei), member checking (mengonfirmasi tafsiran kepada responden), dan jejak audit (mencatat keputusan pengodean agar orang lain bisa menelusuri).
- Reliabilitas: apakah hasilnya konsisten? Untuk pengodean, dua orang mengode data yang sama lalu kesepakatannya dihitung dengan Cohen kappa, yang membuang kesepakatan karena kebetulan. Untuk skala kuesioner (beberapa butir pertanyaan tentang hal yang sama), konsistensi diukur dengan alfa Cronbach.
08_reliabilitas.py
# Bab 28 - Reliabilitas: kesepakatan dua pengode (Cohen kappa) dan konsistensi skala (alfa Cronbach)
import re
from pathlib import Path

import numpy as np
import pandas as pd
import pingouin as pg
from sklearn.metrics import cohen_kappa_score

data = pd.read_csv(Path(__file__).parent / "data" / "wawancara.csv")
rng = np.random.default_rng(42)

kunci_kerja_sama = ["kelompok", "koperasi", "gotong royong", "bersama", "berbagi", "kerja sama"]
pengode_a = data["jawaban"].str.lower().apply(
    lambda t: int(any(re.search(r"\b" + k, t) for k in kunci_kerja_sama)))

# Pengode B (SIMULASI): sama dengan A, tetapi 3 dari 24 keputusan berbeda
pengode_b = pengode_a.copy()
beda = rng.choice(len(data), size=3, replace=False)
pengode_b.iloc[beda] = 1 - pengode_b.iloc[beda]

kesepakatan = (pengode_a == pengode_b).mean()
print("Kesepakatan mentah    :", round(kesepakatan, 3))
print("Cohen kappa           :", round(cohen_kappa_score(pengode_a, pengode_b), 3))
print("Responden yang berbeda:", list(data["kode"].iloc[sorted(beda)]))

# Alfa Cronbach: apakah 4 butir pertanyaan (skala 1-5) mengukur hal yang sama?
sifat = rng.normal(0, 1, len(data))          # "kepuasan sebenarnya" yang tak terlihat
butir = pd.DataFrame({
    f"butir{i}": np.clip(np.round(3 + sifat + rng.normal(0, 0.6, len(data))), 1, 5)
    for i in range(1, 5)
})
alfa, selang = pg.cronbach_alpha(data=butir)
print()
print("Alfa Cronbach 4 butir :", round(alfa, 3), " selang 95%:", [round(float(x), 2) for x in selang])
Kesepakatan mentah : 0.875
Cohen kappa : 0.69
Responden yang berbeda: ['R02', 'R16', 'R18']
Alfa Cronbach 4 butir : 0.896 selang 95%: [0.81, 0.95]Pengode B di skrip ini simulasi: sama dengan A kecuali 3 dari 24 keputusan sengaja dibalik (R02, R16, R18). Kesepakatan mentah 0,875 tampak tinggi, tetapi kappa hanya 0,69 karena tema kerja sama jarang muncul, sehingga banyak “sepakat” terjadi karena kebetulan. Pedoman kasar yang umum dipakai: kappa sekitar 0,6 sampai 0,8 dianggap cukup baik, di atas 0,8 sangat baik. Alfa Cronbach untuk 4 butir simulasi 0,896 dengan selang 95% 0,81 sampai 0,95; nilai di atas 0,7 umumnya dianggap memadai untuk skala penelitian.
Proyek Bersambung I3: analisis wawancara dengan mixed methods
Kita memakai desain konvergen: tema wawancara (kualitatif) dijajarkan dengan kepuasan dan penghasilan (kuantitatif) dalam satu tampilan gabungan (joint display), lalu diuji dengan regresi (Bab 27).
10_proyek_campuran.py
# Bab 28 - Proyek bersambung I3: mixed methods (menggabungkan tema wawancara dengan angka survei)
import re
from pathlib import Path

import pandas as pd
import statsmodels.formula.api as smf

data = pd.read_csv(Path(__file__).parent / "data" / "wawancara.csv")

buku_kode = {
    "iklim": ["hujan", "kemarau", "cuaca", "banjir", "kering", "gelombang", "paceklik"],
    "harga_pasar": ["harga", "tengkulak", "pengepul", "jual", "margin"],
    "biaya_modal": ["modal", "pinjam", "bunga", "mahal", "biaya", "solar", "pupuk", "pakan"],
    "hama_penyakit": ["hama", "wereng", "penyakit", "vaksin", "mati", "bom ikan"],
    "kerja_sama": ["kelompok", "koperasi", "gotong royong", "bersama", "berbagi", "kerja sama"],
    "teknologi_info": ["aplikasi", "ponsel", "video", "informasi", "pelatihan", "penyuluh"],
    "aturan_lahan": ["izin", "kawasan", "digusur", "aturan", "zona", "sertifikat", "petugas"],
}
for tema, kunci in buku_kode.items():
    data[tema] = data["jawaban"].str.lower().apply(
        lambda t: int(any(re.search(r"\b" + re.escape(k), t) for k in kunci)))

# Tampilan gabungan (joint display): temuan kualitatif di samping angka kuantitatif
baris = []
for tema in buku_kode:
    ada = data[data[tema] == 1]
    baris.append({"tema": tema, "n": len(ada),
                  "kepuasan": round(ada["kepuasan"].mean(), 2),
                  "penghasilan_juta": round(ada["penghasilan_juta"].mean(), 2)})
print(pd.DataFrame(baris).to_string(index=False))
print("Semua responden: kepuasan", round(data["kepuasan"].mean(), 2),
      " penghasilan", round(data["penghasilan_juta"].mean(), 2))

# Model: apakah tema "dukungan" (kerja sama, teknologi) berkaitan dengan penghasilan?
model = smf.ols("penghasilan_juta ~ kerja_sama + teknologi_info + hama_penyakit + iklim", data=data).fit()
print()
print(model.params.round(2).to_string())
print("Selang 95% kerja_sama :", model.conf_int().loc["kerja_sama"].round(2).tolist())
print("R kuadrat:", round(model.rsquared, 3), " n =", int(model.nobs))
tema n kepuasan penghasilan_juta
iklim 7 2.43 2.07
harga_pasar 9 3.00 2.53
biaya_modal 11 2.45 2.06
hama_penyakit 4 2.50 2.20
kerja_sama 5 3.80 2.98
teknologi_info 6 4.17 3.03
aturan_lahan 3 2.33 1.87
Semua responden: kepuasan 2.75 penghasilan 2.3
Intercept 1.94
kerja_sama 0.91
teknologi_info 1.00
hama_penyakit -0.22
iklim -0.15
Selang 95% kerja_sama : [0.38, 1.44]
R kuadrat: 0.623 n = 24- Tampilan gabungan: responden yang menyebut
teknologi_info(n = 6) punya kepuasan rata-rata 4,17 dan penghasilan 3,03 juta; yang menyebutkerja_sama(n = 5) 3,80 dan 2,98 juta. Sebaliknya yang menyebutaturan_lahan(n = 3) hanya 2,33 dan 1,87 juta; rata-rata seluruh responden 2,75 dan 2,3 juta. - Regresi: menyebut kerja sama berkaitan dengan penghasilan 0,91 juta lebih tinggi (selang 95% 0,38 sampai 1,44), dan menyebut teknologi dan informasi 1,00 juta lebih tinggi, setelah mengendalikan tema hama dan iklim. R kuadrat 0,623 dengan n = 24.
- Kesimpulan yang boleh ditarik: cerita dan angka sejalan. Orang yang bercerita tentang dukungan kelompok dan informasi cenderung lebih sejahtera. Yang tidak boleh ditarik: bahwa kelompok atau aplikasi menyebabkan penghasilan naik. Mungkin petani yang sudah berpenghasilan baik lebih mudah bergabung ke kelompok (sebab-akibat terbalik), atau ada faktor ketiga (Bab 26). Dan 24 responden fiktif tidak mewakili populasi mana pun. Wawancara lanjutan (“mengapa kelompok membantu?”) adalah langkah berikutnya pada desain sekuensial.
Hasil ini masuk ke laporan Quarto di Bab 29.
Latihan
- Tambahkan tema baru
kesehatan_keluargake buku kode dengan kata kunci pilihan Anda. Apakah ada responden yang menyebutnya? Apa artinya untuk buku kode? - Di
03_frekuensi_kata.py, ganti KWIC dari “harga” ke “musim” atau “modal”. Apa yang Anda pelajari dari konteksnya? - Di
05_topik_nmf.py, ubahn_componentsmenjadi 3 dan 6. Seberapa stabil topiknya? Apa yang Anda simpulkan tentang memilih jumlah topik? - Tantangan: tulis 8 jawaban wawancara fiktif baru dengan kata-kata Anda sendiri (dengan catatan etika), tambahkan ke CSV, dan periksa berapa banyak yang dikode benar oleh buku kode. Perbaiki buku kodenya dan hitung kappa antara kode mesin dan kode Anda.
Ringkasan Bab
- Kuantitatif menjawab “berapa”, kualitatif menjawab “mengapa”, dan campuran menggabungkan keduanya (sekuensial atau konvergen).
- Buku kode berisi tema dan kata kunci; kode otomatis cepat tetapi kasar dan perlu dibaca ulang manusia.
- Frekuensi kata, KWIC, TF-IDF, topic modeling (NMF/LDA), dan sentimen kamus adalah alat penjelajah, bukan pembuktian. Validasi alat dengan data pembanding.
- Embedding mengubah teks menjadi vektor sehingga makna yang mirip berdekatan; model besar dibahas di Seri A4.
- Tema yang dikode menjadi data kuantitatif: uji dengan Mann-Whitney, Fisher, atau regresi, dan laporkan jujur bila hasilnya bergantung pada uji.
- Validitas (triangulasi, member checking), reliabilitas (Cohen kappa, alfa Cronbach), dan etika (persetujuan, anonimisasi) sama pentingnya dengan kode Python.
Selanjutnya, di Bab 29: riset yang dapat direproduksi: bagaimana membungkus semua analisis ini dalam laporan Quarto yang bisa dijalankan ulang oleh siapa pun.