%%{init: {"flowchart": {"diagramPadding": 40}}}%%
flowchart LR
A["Katalog STAC<br/>(JSON)"] --> B["Cari<br/>waktu, lokasi, awan"]
B --> C["Item terpilih"]
C --> D["Aset COG<br/>(href)"]
D --> E["Baca jendela<br/>yang diperlukan"]
E --> F["Tumpukan xarray<br/>lalu Zarr"]
Bab 51 — Geospasial Lanjut dan Cloud-Native: Membaca Sepotong Bumi dari Jauh
Seri A2 — Data Skala Besar dan Geospasial Lanjut
Semua skrip bab ini ada di folder kode/bab51/. Di versi web, Anda juga bisa mengunduh semuanya sekaligus (zip).
Di Bab 39, Anda membuka sebuah GeoTIFF kecil di komputer sendiri. Citra satelit sungguhan berbeda: satu scene Sentinel-2 bisa berukuran ratusan megabita, dan satu wilayah dipotret berulang-ulang setiap beberapa hari. Mengunduh semuanya hanya untuk melihat satu kebun sama saja dengan membeli seluruh gudang beras demi satu karung.
Cloud-native berarti data disimpan dengan cara yang membuat pembacaan sebagian lewat internet murah: program meminta hanya potongan byte yang diperlukan. Bab ini menunjukkan tiga format (COG, GeoParquet, Zarr), satu katalog (STAC), dan satu jenis data baru (LiDAR). Semua contoh memakai data tiruan buatan skrip; tidak ada citra atau point cloud besar yang diunduh.
COG: GeoTIFF yang bisa dibaca sebagian
Cloud Optimized GeoTIFF (COG) adalah GeoTIFF biasa dengan tata letak khusus. Menurut dokumentasi GDAL, COG itu berubin (tiled), punya overview (ringkasan beresolusi lebih kasar), dan disusun supaya klien bisa membaca sebagian lewat permintaan rentang HTTP (HTTP range request): “kirim saya byte ke-1.000 sampai ke-5.000 saja”. Header dan daftar letak ubin diletakkan di awal berkas, lalu data dari overview terkecil sampai resolusi penuh.
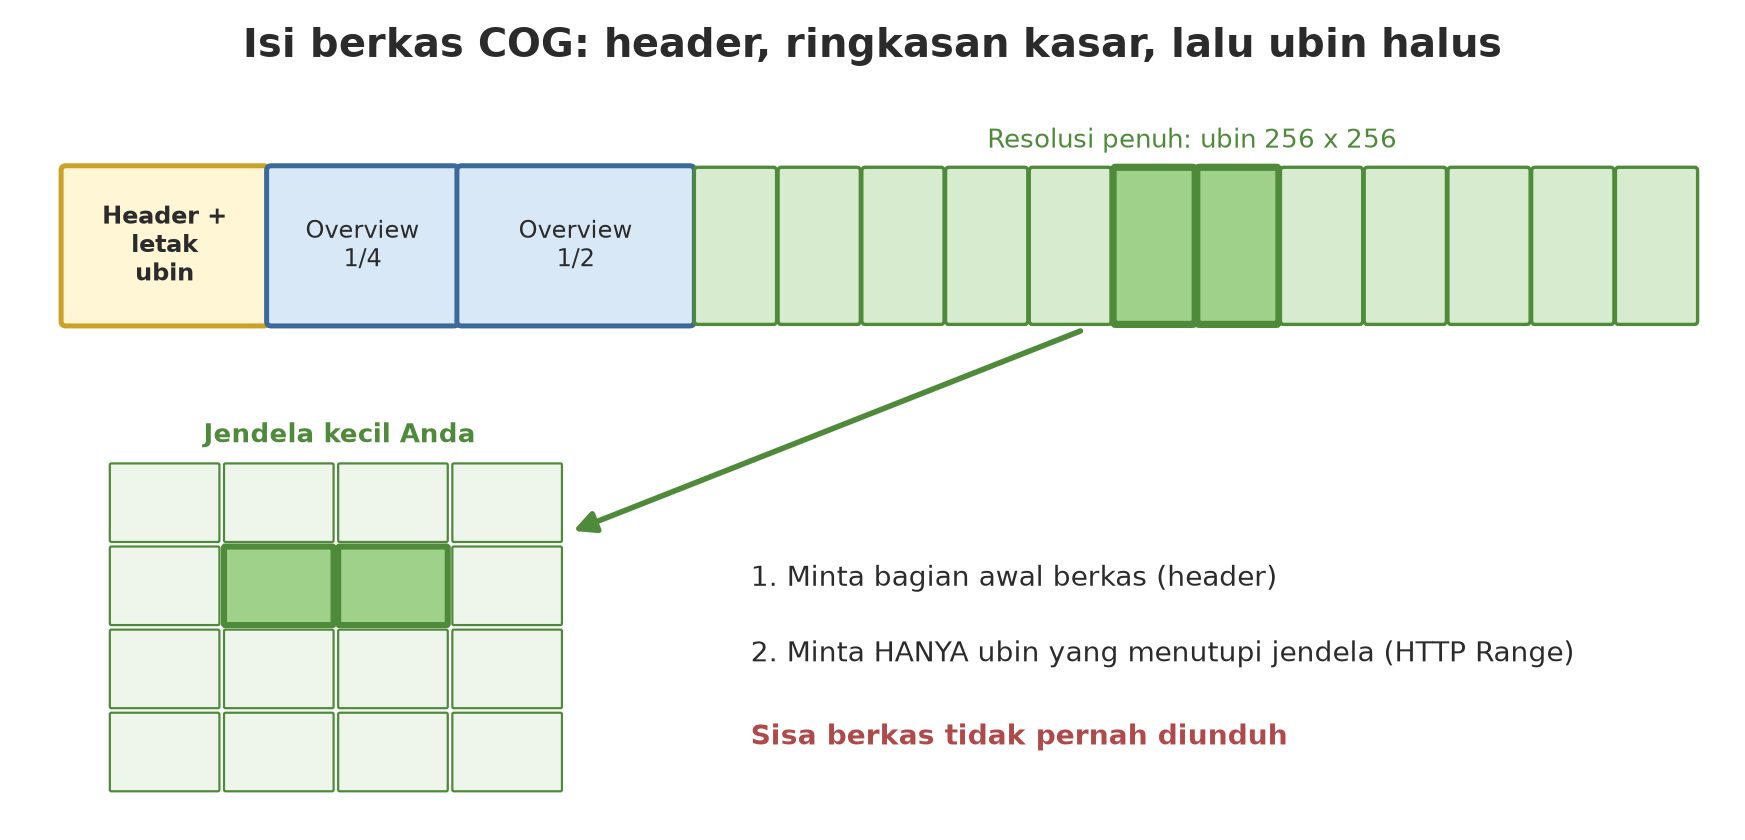
Rasterio bisa menulis COG lewat driver COG milik GDAL. Kita membuat citra tiruan 1024 x 1024 piksel, lalu membandingkan GeoTIFF biasa dengan COG.
01_tulis_cog.py
# Bab 51 - Menulis Cloud Optimized GeoTIFF (COG) dengan rasterio dan driver COG milik GDAL
from pathlib import Path

import numpy as np
import rasterio
from rasterio.shutil import copy as salin
from rasterio.transform import from_origin

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)

# Citra tiruan (fiktif): indeks vegetasi 1024 x 1024 piksel, resolusi 10 m, UTM zona 48S (EPSG:32748)
rng = np.random.default_rng(42)
y, x = np.mgrid[0:1024, 0:1024]
ndvi = 0.5 + 0.3 * np.sin(x / 120) * np.cos(y / 160) + rng.normal(0, 0.03, (1024, 1024))
ndvi = ndvi.astype("float32")

biasa = tmp / "ndvi_biasa.tif"
transform = from_origin(700000, 9270000, 10, 10)     # pojok kiri-atas (x, y) dan ukuran piksel
with rasterio.open(biasa, "w", driver="GTiff", height=1024, width=1024, count=1,
                   dtype="float32", crs="EPSG:32748", transform=transform) as dst:
    dst.write(ndvi, 1)

# Ubah menjadi COG: berubin 256x256, ada ringkasan beresolusi lebih kasar (overview)
cog = tmp / "ndvi_cog.tif"
salin(biasa, cog, driver="COG", compress="DEFLATE", blocksize=256, overview_resampling="average")

for nama, jalur in [("GeoTIFF biasa", biasa), ("COG", cog)]:
    with rasterio.open(jalur) as src:
        print(f"{nama:14s} ubin: {src.block_shapes[0]}  overview: {src.overviews(1)}  tata letak: {src.tags(ns='IMAGE_STRUCTURE').get('LAYOUT', '-')}")
GeoTIFF biasa ubin: (2, 1024) overview: [] tata letak: -
COG ubin: (256, 256) overview: [2, 4] tata letak: COG- GeoTIFF biasa tersimpan dalam jalur selebar citra (2 baris x 1024 kolom per blok), tanpa overview. Untuk membaca satu sudut, GDAL harus melompat-lompat di seluruh berkas.
- COG berubin 256 x 256, punya overview tingkat 2 dan 4 (setengah dan seperempat resolusi), dan menandai dirinya
LAYOUT=COG.
Sekarang bagian serunya: membaca jendela kecil.
02_jendela_cog.py
# Bab 51 - Membaca jendela kecil dari COG: lokal, lalu lewat HTTP dengan permintaan rentang (Range)
import re
import threading
from http.server import BaseHTTPRequestHandler, HTTPServer
from pathlib import Path

import rasterio
from rasterio.windows import Window

tmp = Path(__file__).parent / "_tmp"
cog = tmp / "ndvi_cog.tif"
if not cog.exists():                                   # dibuat oleh skrip 01
    raise SystemExit("jalankan 01_tulis_cog.py dulu")

# --- Bagian 1: berkas lokal ---------------------------------------------------
with rasterio.open(cog) as src:
    jendela = Window(col_off=512, row_off=256, width=128, height=128)
    potongan = src.read(1, window=jendela)
    print("Jendela 128x128 piksel:", potongan.shape, " rata-rata:", round(float(potongan.mean()), 3))
    # Meminta ukuran keluaran lebih kecil: GDAL memakai overview, bukan membaca semua piksel
    kasar = src.read(1, out_shape=(256, 256))
    print("Seluruh citra pada 256x256 (dari overview):", kasar.shape)

# --- Bagian 2: server HTTP kecil yang mendukung Range (hanya untuk uji lokal) ---
statistik = {"permintaan": 0, "byte": 0}
data = cog.read_bytes()


class Penyaji(BaseHTTPRequestHandler):
    def log_message(self, *argumen):                    # diamkan log bawaan
        pass

    def _kepala(self, kode, awal, akhir):
        self.send_response(kode)
        self.send_header("Accept-Ranges", "bytes")
        self.send_header("Content-Length", str(akhir - awal + 1))
        if kode == 206:
            self.send_header("Content-Range", f"bytes {awal}-{akhir}/{len(data)}")
        self.end_headers()

    def do_HEAD(self):
        self._kepala(200, 0, len(data) - 1)

    def do_GET(self):
        cocok = re.match(r"bytes=(\d+)-(\d*)", self.headers.get("Range", ""))
        awal = int(cocok.group(1)) if cocok else 0
        akhir = min(int(cocok.group(2) or len(data) - 1), len(data) - 1) if cocok else len(data) - 1
        self._kepala(206 if cocok else 200, awal, akhir)
        self.wfile.write(data[awal:akhir + 1])
        statistik["permintaan"] += 1
        statistik["byte"] += akhir - awal + 1


server = HTTPServer(("127.0.0.1", 0), Penyaji)
threading.Thread(target=server.serve_forever, daemon=True).start()
alamat = f"http://127.0.0.1:{server.server_port}/ndvi_cog.tif"

with rasterio.Env(GDAL_DISABLE_READDIR_ON_OPEN="EMPTY_DIR", CPL_VSIL_CURL_ALLOWED_EXTENSIONS=".tif"):
    with rasterio.open(alamat) as src:
        potongan_http = src.read(1, window=jendela)

server.shutdown()
print("Hasil lewat HTTP sama dengan lokal:", bool((potongan_http == potongan).all()))
print("Ukuran berkas (KB):", len(data) // 1024)
print("Byte yang diunduh lebih sedikit dari seluruh berkas:", statistik["byte"] < len(data))
print("Yang diunduh kurang dari 10% berkas:", statistik["byte"] < 0.10 * len(data))
Jendela 128x128 piksel: (128, 128) rata-rata: 0.615
Seluruh citra pada 256x256 (dari overview): (256, 256)
Hasil lewat HTTP sama dengan lokal: True
Ukuran berkas (KB): 4609
Byte yang diunduh lebih sedikit dari seluruh berkas: True
Yang diunduh kurang dari 10% berkas: TrueBagian 1 membaca jendela 128 x 128 piksel dari berkas lokal; dengan out_shape=(256, 256) GDAL membaca dari overview, bukan semua piksel. Bagian 2 menjalankan server HTTP kecil di komputer sendiri (127.0.0.1) yang mendukung Range, lalu membuka COG lewat alamat http://.... Hasilnya sama persis dengan pembacaan lokal, tetapi yang berpindah lewat “jaringan” kurang dari 10% ukuran berkas (4.609 KB). Pada citra satelit sungguhan dengan ratusan megabita, penghematannya jauh lebih besar.
PeringatanAWAS
Contoh nyata di atas hanya memakai berkas lokal dan server localhost. Membaca COG milik penyedia di internet memakai kode yang sama (rasterio.open("https://...")), tetapi bergantung pada sambungan Anda, hak akses penyedia, dan kebijakan penggunaannya. Itu tidak dijalankan di buku ini.
GeoParquet: data vektor kolumnar
Pada Bab 50 Anda belajar Parquet untuk tabel. GeoParquet menambahkan kolom geometri (dalam bentuk WKB) beserta metadata CRS ke dalam berkas Parquet. Hasilnya: data vektor besar (jutaan titik, poligon) yang cepat dibaca sebagian, dan bisa langsung dibuka DuckDB, Polars, atau GeoPandas.
03_geoparquet.py
# Bab 51 - GeoParquet: data vektor dalam format kolumnar, dengan GeoPandas dan pyarrow
import json
from pathlib import Path

import geopandas as gpd
import numpy as np
import pyarrow.parquet as pq
from shapely.geometry import Point, box

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)

# Data tiruan (fiktif): 5.000 titik pohon di sekitar 107,0 BT dan 6,6 LS, dan satu petak
rng = np.random.default_rng(42)
n = 5_000
bujur = rng.uniform(106.95, 107.05, n)
lintang = rng.uniform(-6.65, -6.55, n)
pohon = gpd.GeoDataFrame(
    {
        "id": np.arange(n),
        "jenis": rng.choice(["Jati", "Meranti", "Mahoni", "Sengon"], n),
        "tinggi_m": rng.normal(18, 4, n).round(1),
    },
    geometry=[Point(x, y) for x, y in zip(bujur, lintang)],
    crs="EPSG:4326",
)

# write_covering_bbox=True menambah kolom bbox: pembaca bisa menyaring tanpa membuka geometri
berkas = tmp / "pohon.parquet"
pohon.to_parquet(berkas, compression="zstd", write_covering_bbox=True, row_group_size=1000)

# Metadata GeoParquet tersimpan di dalam berkas, pada kunci 'geo'
meta = pq.read_schema(berkas).metadata
geo = json.loads(meta[b"geo"])
kolom = geo["columns"]["geometry"]
print("Versi GeoParquet:", geo["version"])
print("Jenis geometri:", kolom["geometry_types"], "| encoding:", kolom["encoding"])
print("CRS tersimpan:", "ya" if kolom.get("crs") else "tidak (dianggap OGC:CRS84)")
print("Kolom di berkas:", pq.read_schema(berkas).names)

# Membaca hanya yang berada di dalam kotak (bbox): minx, miny, maxx, maxy
kotak = (106.98, -6.62, 107.00, -6.60)
sebagian = gpd.read_parquet(berkas, bbox=kotak)
cek = pohon[pohon.within(box(*kotak))]
print("Titik dalam kotak (bbox):", len(sebagian), "dari", n)
print("Sama dengan penyaringan manual:", len(cek) == len(sebagian))
Versi GeoParquet: 1.1.0
Jenis geometri: ['Point'] | encoding: WKB
CRS tersimpan: ya
Kolom di berkas: ['id', 'jenis', 'tinggi_m', 'geometry', 'bbox']
Titik dalam kotak (bbox): 186 dari 5000
Sama dengan penyaringan manual: True- Metadata GeoParquet tersimpan di dalam berkas pada kunci
geo: versi 1.1.0, jenis geometriPoint, encodingWKB, dan CRS. write_covering_bbox=Truemenambah kolombbox(kotak pembatas tiap objek). Pembaca bisa menyaring dengan kolom itu tanpa membuka geometri.gpd.read_parquet(berkas, bbox=...)hanya mengambil 186 dari 5.000 titik di dalam kotak. Hasilnya sama dengan penyaringan manual memakai Shapely (True).
Zarr: array besar yang dipecah
Citra multitemporal adalah array tiga dimensi (waktu, y, x), kadang empat dimensi dengan band. Zarr menyimpan array seperti itu dengan memecahnya menjadi chunk: satu berkas kecil per potongan, ditambah metadata JSON. Karena tiap chunk adalah berkas tersendiri, banyak pekerja bisa menulis dan membaca potongan berbeda bersamaan, dan penyimpanan cloud cocok untuk itu.
04_zarr.py
# Bab 51 - Zarr: array besar yang dipecah menjadi potongan (chunk), satu berkas per potongan
import shutil
from pathlib import Path

import numpy as np
import zarr

tmp = Path(__file__).parent / "_tmp"
lokasi = tmp / "suhu.zarr"
shutil.rmtree(lokasi, ignore_errors=True)

# Array tiruan (fiktif): suhu permukaan 12 bulan x 400 x 400 piksel
rng = np.random.default_rng(42)
data = (25 + 3 * rng.random((12, 400, 400))).astype("float32")

z = zarr.create_array(
    store=lokasi,
    shape=data.shape,
    chunks=(1, 200, 200),            # satu bulan, seperempat citra
    dtype="float32",
    dimension_names=("bulan", "y", "x"),
)
z[:] = data

print("Bentuk:", z.shape, "| potongan:", z.chunks, "| tipe:", z.dtype)
print("Jumlah potongan:", z.nchunks)
print("Berkas berisi potongan nyata:", sum(1 for p in (lokasi / "c").rglob("*") if p.is_file()))

# Membaca irisan: hanya potongan yang bersinggungan yang dibuka
buka = zarr.open_array(lokasi, mode="r")
irisan = buka[3, 100:150, 250:300]
print("Irisan bulan ke-4:", irisan.shape, "sama dengan data asli:", bool(np.array_equal(irisan, data[3, 100:150, 250:300])))
print("Potongan yang tersentuh irisan itu: 1 dari", buka.nchunks)

# Metadata zarr = JSON biasa yang bisa dibaca manusia
print("Berkas metadata:", (lokasi / "zarr.json").name)
Bentuk: (12, 400, 400) | potongan: (1, 200, 200) | tipe: float32
Jumlah potongan: 48
Berkas berisi potongan nyata: 48
Irisan bulan ke-4: (50, 50) sama dengan data asli: True
Potongan yang tersentuh irisan itu: 1 dari 48
Berkas metadata: zarr.jsonArray 12 x 400 x 400 dipecah menjadi chunk (1, 200, 200): satu bulan, seperempat citra. Jumlah chunk = 12 x 2 x 2 = 48, dan tepat 48 berkas potongan ada di disk. Saat kita mengiris [3, 100:150, 250:300], irisan itu hanya berada di bulan ke-4 dan satu seperempat citra, jadi hanya satu chunk dibuka. Berkas zarr.json berisi metadata yang bisa dibaca manusia. (Paket zarr versi 3 dipasang untuk bab ini.)
TipTIPS
Ukuran chunk menentukan kecepatan. Terlalu kecil: terlalu banyak berkas dan permintaan. Terlalu besar: membaca irisan kecil tetap menarik banyak data. Cocokkan dengan pola baca Anda: bila sering mengambil deret waktu satu titik, jangan membuat chunk satu bulan per berkas. Bab 53 membahas ini lebih jauh.
STAC: katalog untuk menemukan data
Format yang bagus tidak berguna bila Anda tak bisa menemukan datanya. STAC (SpatioTemporal Asset Catalog) adalah spesifikasi JSON untuk mendeskripsikan data geospasial agar bisa dijelajahi dan dicari. Objek utamanya:
- Catalog: induk yang menautkan koleksi dan item.
- Collection: sekumpulan item sejenis, dengan cakupan ruang dan waktu.
- Item: satu satuan data (satu scene), berupa fitur GeoJSON dengan waktu dan properti (misalnya tutupan awan).
- Asset: tautan ke berkas sebenarnya (COG, JPEG, metadata), ada di dalam item.
Pustaka pystac membuat objek STAC, dan pystac-client membukanya dan mencarinya. Kita bangun katalog tiruan untuk satu kebun: empat scene, masing-masing satu COG kecil.
05_stac_lokal.py
# Bab 51 - Katalog STAC lokal: membuat item beserta aset COG, lalu mencarinya dengan pystac-client
import shutil
import warnings
from datetime import datetime, timezone
from pathlib import Path

import numpy as np
import pystac
import rasterio
from pystac_client import Client
from pystac_client.warnings import FallbackToPystac, NoConformsTo
from rasterio.shutil import copy as salin
from rasterio.transform import from_origin

akar = Path(__file__).parent / "_tmp" / "stac_kebun"
shutil.rmtree(akar, ignore_errors=True)
(akar / "citra").mkdir(parents=True)

# Empat "scene" tiruan (fiktif) untuk satu kebun; tiap scene = satu COG kecil + satu Item STAC
tanggal = [datetime(2026, 1, 5, tzinfo=timezone.utc), datetime(2026, 2, 4, tzinfo=timezone.utc),
           datetime(2026, 3, 6, tzinfo=timezone.utc), datetime(2026, 4, 5, tzinfo=timezone.utc)]
awan = [5.0, 62.0, 12.0, 3.0]                     # persen tutupan awan (contoh)
rng = np.random.default_rng(1)
transform = from_origin(700000, 9270000, 10, 10)
bbox = [106.0, -6.9, 106.1, -6.8]                 # kotak kasar (BT, LS) untuk Item
katalog = pystac.Catalog(id="kebun-tiruan", description="Katalog STAC tiruan untuk belajar")
koleksi = pystac.Collection(
    id="citra-kebun", description="Citra tiruan kebun",
    extent=pystac.Extent(pystac.SpatialExtent([bbox]),
                         pystac.TemporalExtent([[tanggal[0], tanggal[-1]]])),
)
katalog.add_child(koleksi)

for i, (waktu, tutup) in enumerate(zip(tanggal, awan)):
    mentah = akar / "citra" / f"mentah_{i}.tif"
    cog = akar / "citra" / f"scene_{waktu:%Y%m%d}.tif"
    nilai = (0.4 + 0.1 * i + rng.normal(0, 0.05, (256, 256))).astype("float32")
    with rasterio.open(mentah, "w", driver="GTiff", height=256, width=256, count=1, dtype="float32",
                       crs="EPSG:32748", transform=transform) as dst:
        dst.write(nilai, 1)
    salin(mentah, cog, driver="COG", compress="DEFLATE", blocksize=128)
    mentah.unlink()

    item = pystac.Item(id=f"scene-{waktu:%Y%m%d}", geometry=None, bbox=bbox, datetime=waktu,
                       properties={"eo:cloud_cover": tutup, "proj:code": "EPSG:32748"})
    item.add_asset("ndvi", pystac.Asset(href=f"citra/{cog.name}", media_type=pystac.MediaType.COG,
                                         roles=["data"], title="NDVI tiruan"))
    koleksi.add_item(item)

katalog.normalize_hrefs(str(akar))
katalog.save(catalog_type=pystac.CatalogType.SELF_CONTAINED)
print("Berkas JSON di katalog:", sorted(p.name for p in akar.rglob("*.json")))

# Katalog berkas (statis) tidak punya layanan pencarian, jadi pystac-client memperingatkan bahwa ia
# "jatuh kembali" ke pystac. Peringatan itu wajar di sini, jadi kita diamkan.
warnings.simplefilter("ignore", NoConformsTo)
warnings.simplefilter("ignore", FallbackToPystac)

# Membuka katalog lewat pystac-client, lalu menyaring item: awan < 20% dan sesudah 1 Februari
klien = Client.open(akar / "catalog.json")
semua = list(klien.get_collection("citra-kebun").get_items())
terpilih = [it for it in semua
            if it.properties["eo:cloud_cover"] < 20 and it.datetime >= datetime(2026, 2, 1, tzinfo=timezone.utc)]
print("Item di katalog:", len(semua), "| lolos saringan:", [it.id for it in terpilih])
print("Aset item pertama yang lolos:", list(terpilih[0].assets), "->", terpilih[0].assets["ndvi"].href.split("/")[-1])
Berkas JSON di katalog: ['catalog.json', 'collection.json', 'scene-20260105.json', 'scene-20260204.json', 'scene-20260306.json', 'scene-20260405.json']
Item di katalog: 4 | lolos saringan: ['scene-20260306', 'scene-20260405']
Aset item pertama yang lolos: ['ndvi'] -> scene_20260306.tifKatalog tersimpan sebagai 6 berkas JSON: satu catalog.json, satu collection.json, dan empat item. Setelah disaring (awan di bawah 20% dan sesudah 1 Februari), tersisa dua item: scene-20260306 dan scene-20260405 (scene 4 Februari berawan 62%, scene Januari terlalu dini). Setiap item punya aset ndvi yang menunjuk ke berkas COG.
BahayaBAGIAN TEKNIS (boleh dilewati)
Katalog berupa berkas JSON (statis) tidak punya layanan pencarian. Pustaka pystac-client mengeluarkan peringatan NoConformsTo dan FallbackToPystac: ia “jatuh kembali” ke pystac dan menyaring sisi klien, yang memang lambat untuk katalog besar. Skrip ini mendiamkan peringatan itu. Untuk katalog berlayanan STAC API (seperti yang berikut), Anda memakai client.search(...) dan penyaringan dikerjakan di server.
Satu pertanyaan ke katalog publik
Sekarang satu pertanyaan kecil ke katalog publik Earth Search (tanpa kunci, tanpa akun). Kita hanya membaca metadata: tidak ada citra yang diunduh.
06_stac_publik.py
# Bab 51 - Satu pertanyaan kecil ke katalog STAC publik (hanya metadata, tanpa mengunduh citra)
from pystac_client import Client

klien = Client.open("https://earth-search.aws.element84.com/v1")      # tanpa kunci
print("Katalog:", klien.title or klien.id)

pencarian = klien.search(
    collections=["sentinel-2-l2a"],
    bbox=[106.7, -6.7, 106.9, -6.5],                 # sekitar Bogor
    datetime="2025-01-01/2025-03-31",                # triwulan I 2025 (musim hujan)
)
print("Jumlah scene yang cocok:", pencarian.matched())

# Ambil metadata semua item (JSON kecil), lalu urutkan dari yang paling sedikit awannya
item = sorted(pencarian.items(), key=lambda it: it.properties["eo:cloud_cover"])
for it in item[:3]:
    print(it.id, "| awan:", round(it.properties["eo:cloud_cover"], 1), "% | tanggal:", it.datetime.date())
print("Contoh nama aset:", sorted(item[0].assets)[:8])
print("Alamat aset 'red' dimulai dengan:", item[0].assets["red"].href[:8], "(tidak diunduh)")
Katalog: Earth Search by Element 84
Jumlah scene yang cocok: 36
S2C_48MXT_20250314_0_L2A | awan: 30.6 % | tanggal: 2025-03-14
S2B_48MXT_20250227_0_L2A | awan: 37.5 % | tanggal: 2025-02-27
S2B_48MYT_20250227_0_L2A | awan: 43.7 % | tanggal: 2025-02-27
Contoh nama aset: ['aot', 'aot-jp2', 'blue', 'blue-jp2', 'cloud', 'coastal', 'coastal-jp2', 'granule_metadata']
Alamat aset 'red' dimulai dengan: https:// (tidak diunduh)Keluaran di atas adalah hasil nyata yang diambil sekali (arahan @statis), karena hasilnya bergantung pada internet dan katalog terus bertambah. Ada 36 scene Sentinel-2 yang menutupi kotak sekitar Bogor pada triwulan I 2025. Perhatikan: scene paling bersih pun masih berawan 30,6%. Itu pelajaran nyata tentang musim hujan di daerah tropis: citra optik sering tertutup awan, sehingga komposit median (Bagian xarray di bawah) dan citra radar (Sentinel-1, ada di katalog yang sama) sangat berguna. Setiap item punya banyak aset (blue, red, cloud, dan lain-lain). Kita hanya mencetak awal alamat aset red (https://), tidak mengunduhnya.
Bila internet gagal saat Anda mencoba sendiri, pakai katalog lokal dari skrip sebelumnya; kode pencariannya hampir sama.
xarray dan rioxarray: citra multitemporal
xarray memberi array bernama: sumbu bukan “sumbu 0, 1, 2”, tetapi waktu, y, x, lengkap dengan koordinatnya. rioxarray menambahkan fungsi geospasial (.rio) seperti CRS, memotong, dan reproject.
07_xarray_waktu.py
# Bab 51 - xarray dan rioxarray: tumpukan citra multitemporal (waktu, y, x)
import numpy as np
import pandas as pd
import rioxarray  # noqa: F401  (mendaftarkan aksesor .rio pada xarray)
import xarray as xr

rng = np.random.default_rng(3)
waktu = pd.to_datetime(["2026-01-05", "2026-02-04", "2026-03-06", "2026-04-05"])
y = 9270000 - 10 * (np.arange(100) + 0.5)       # koordinat pusat piksel, resolusi 10 m
x = 700000 + 10 * (np.arange(100) + 0.5)

# Data tiruan (fiktif): NDVI naik tiap bulan, dengan satu piksel berawan (NaN) di bulan Februari
nilai = np.stack([0.35 + 0.08 * i + rng.normal(0, 0.03, (100, 100)) for i in range(4)]).astype("float32")
nilai[1, 10:20, 10:20] = np.nan
ndvi = xr.DataArray(nilai, dims=("waktu", "y", "x"), coords={"waktu": waktu, "y": y, "x": x}, name="ndvi")
ndvi = ndvi.rio.write_crs("EPSG:32748")

print(dict(ndvi.sizes), "| CRS:", ndvi.rio.crs)

# Operasi per sumbu bernama: tidak perlu mengingat "sumbu 0"
rata_waktu = ndvi.mean(dim=("y", "x"))
print("NDVI rata-rata per tanggal:")
print(rata_waktu.to_series().round(3).to_string())

komposit = ndvi.median(dim="waktu", skipna=True)          # komposit median: awan (NaN) terlewati
print("Komposit median:", komposit.dims, "| masih ada NaN:", bool(komposit.isnull().any()))

# Pilih berdasarkan label, bukan nomor urut
maret = ndvi.sel(waktu="2026-03-06")
selisih = (ndvi.sel(waktu="2026-04-05") - maret).mean()
print("Kenaikan NDVI Maret -> April:", round(float(selisih), 3))

# Hitung rata-rata bulanan di satu blok kebun (potong dengan koordinat)
blok = ndvi.rio.clip_box(minx=700200, miny=9269200, maxx=700600, maxy=9269600)
print("Blok kebun:", dict(blok.sizes), "| rata-rata:", round(float(blok.mean()), 3))
{'waktu': 4, 'y': 100, 'x': 100} | CRS: EPSG:32748
NDVI rata-rata per tanggal:
waktu
2026-01-05 0.35
2026-02-04 0.43
2026-03-06 0.51
2026-04-05 0.59
Komposit median: ('y', 'x') | masih ada NaN: False
Kenaikan NDVI Maret -> April: 0.08
Blok kebun: {'waktu': 4, 'y': 40, 'x': 40} | rata-rata: 0.47ndvi.mean(dim=("y", "x"))menghasilkan satu angka per tanggal: 0,35 sampai 0,59 (naik sekitar 0,08 tiap bulan).- Sebagian piksel Februari bernilai
NaN(awan tiruan).median(dim="waktu", skipna=True)membuat komposit median yang melewatiNaN; hasilnya tak lagi memuatNaN(False). sel(waktu="2026-03-06")memilih dengan label, bukan nomor urut.rio.clip_boxmemotong dengan koordinat UTM: blok kebun 400 x 400 m berukuran 40 x 40 piksel (resolusi 10 m).
LiDAR: point cloud dan tinggi tajuk
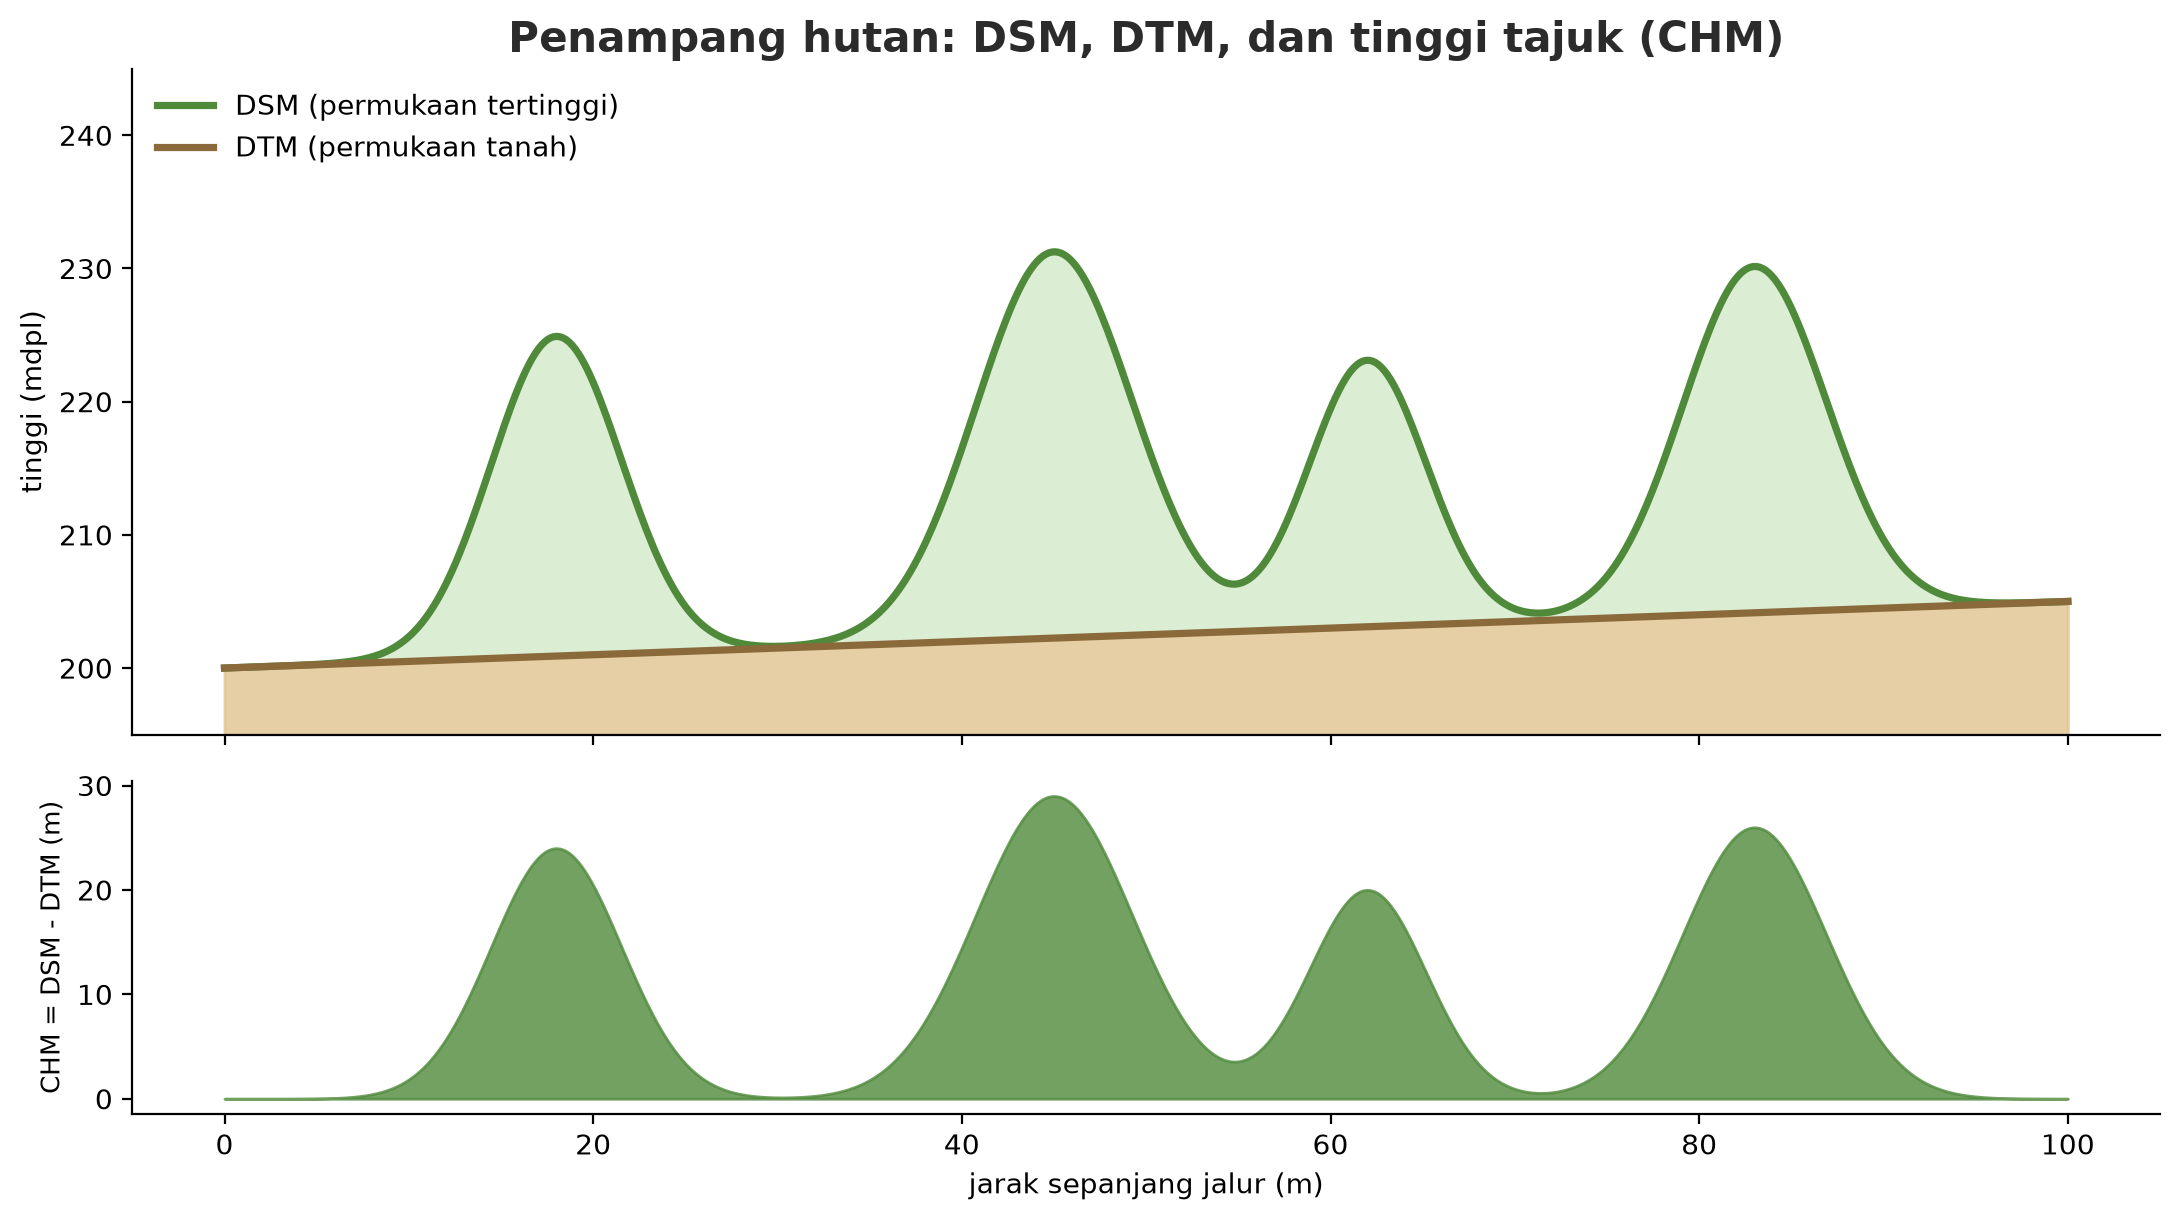
LiDAR menembakkan pulsa laser dari pesawat atau drone dan mengukur waktu pantulnya. Hasilnya point cloud: jutaan titik dengan koordinat (x, y, z) dan atribut seperti kelas (tanah, vegetasi, bangunan). Format umumnya LAS (dan LAZ yang terkompresi). Pustaka laspy membaca dan menulis LAS dari Python.
Kita membuat hutan tiruan 100 x 100 m berisi 12 pohon berbentuk kubah di atas tanah yang berlereng, lalu menyimpannya sebagai berkas LAS.
08_lidar_las.py
# Bab 51 - Point cloud LiDAR: membuat dan membaca berkas LAS kecil dengan laspy
from pathlib import Path

import laspy
import numpy as np

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)

# Hutan tiruan (fiktif) seluas 100 x 100 m: tanah berlereng lembut + 12 pohon berbentuk kubah
rng = np.random.default_rng(11)
x_tanah = rng.uniform(0, 100, 6000)
y_tanah = rng.uniform(0, 100, 6000)
z_tanah = 200 + 0.05 * x_tanah + 0.02 * y_tanah                 # tanah naik pelan (mdpl)

pusat = rng.uniform(10, 90, (12, 2))
tinggi = rng.uniform(15, 30, 12).round(1)                        # tinggi pohon 15-30 m (contoh)
xs, ys, zs = [], [], []
for (cx, cy), h in zip(pusat, tinggi):
    px = rng.normal(cx, 2.0, 300)
    py = rng.normal(cy, 2.0, 300)
    jarak2 = ((px - cx) ** 2 + (py - cy) ** 2)
    z_dasar = 200 + 0.05 * px + 0.02 * py
    xs.append(px); ys.append(py)
    zs.append(z_dasar + h * np.exp(-jarak2 / 8))               # kubah: puncak di tengah tajuk
x = np.concatenate([x_tanah] + xs)
y = np.concatenate([y_tanah] + ys)
z = np.concatenate([z_tanah] + zs)
kelas = np.concatenate([np.full(6000, 2), np.full(3600, 5)]).astype("uint8")   # 2 = tanah, 5 = vegetasi tinggi

header = laspy.LasHeader(point_format=3, version="1.4")
header.offsets = [x.min(), y.min(), z.min()]
header.scales = [0.01, 0.01, 0.01]                               # presisi 1 cm
las = laspy.LasData(header)
las.x, las.y, las.z = x, y, z
las.classification = kelas
las.write(tmp / "hutan.las")

# Membaca kembali
baca = laspy.read(tmp / "hutan.las")
print("Format titik:", baca.header.point_format.id, "| versi:", baca.header.version)
print("Jumlah titik:", len(baca.points))
print("Nama dimensi (sebagian):", list(baca.point_format.dimension_names)[:8])
print("Titik per kelas:", {int(k): int((baca.classification == k).sum()) for k in np.unique(baca.classification)})
print("Rentang tinggi (m):", round(float(baca.z.min()), 2), "sampai", round(float(baca.z.max()), 2))
print("Tinggi pohon contoh terbesar yang dibuat:", float(tinggi.max()))
np.save(tmp / "pohon_asli.npy", np.column_stack([pusat, tinggi]))   # x, y, tinggi tiap pohon
Format titik: 3 | versi: 1.4
Jumlah titik: 9600
Nama dimensi (sebagian): ['X', 'Y', 'Z', 'intensity', 'return_number', 'number_of_returns', 'scan_direction_flag', 'edge_of_flight_line']
Titik per kelas: {2: 6000, 5: 3600}
Rentang tinggi (m): 200.03 sampai 233.47
Tinggi pohon contoh terbesar yang dibuat: 29.9Berkas berisi 9.600 titik: 6.000 titik tanah (kelas 2) dan 3.600 titik vegetasi tinggi (kelas 5), format titik 3, versi LAS 1.4. Skala 0,01 berarti presisi koordinat 1 cm. Ketinggian z berkisar 200,03 sampai 233,47 m di atas permukaan laut (mdpl).
Dari point cloud, dibuat model tinggi tajuk (CHM, canopy height model):
- DSM (digital surface model) = permukaan tertinggi (puncak pohon, atap).
- DTM (digital terrain model) = permukaan tanah, diinterpolasi dari titik kelas tanah.
- CHM = DSM - DTM = tinggi tajuk di atas tanah.
09_tinggi_tajuk.py
# Bab 51 - Model tinggi tajuk (CHM = DSM - DTM) dari point cloud LiDAR tiruan
from pathlib import Path

import laspy
import numpy as np
from scipy import ndimage
from scipy.interpolate import griddata

tmp = Path(__file__).parent / "_tmp"
if not (tmp / "hutan.las").exists():                 # dibuat oleh skrip 08
    raise SystemExit("jalankan 08_lidar_las.py dulu")

las = laspy.read(tmp / "hutan.las")
x, y, z = np.asarray(las.x), np.asarray(las.y), np.asarray(las.z)
tanah = np.asarray(las.classification) == 2
sel = 1.0                                             # ukuran sel grid 1 m
kolom = np.floor((x - x.min()) / sel).astype(int).clip(0, 99)
baris = np.floor((y - y.min()) / sel).astype(int).clip(0, 99)

# DSM = tinggi permukaan tertinggi per sel (titik mana pun)
dsm = np.full((100, 100), np.nan)
for r, c, v in zip(baris, kolom, z):
    if np.isnan(dsm[r, c]) or v > dsm[r, c]:
        dsm[r, c] = v

# DTM = permukaan tanah: interpolasi dari titik kelas 2 (tanah) ke seluruh grid
gy, gx = np.mgrid[0:100, 0:100]
dtm = griddata((kolom[tanah], baris[tanah]), z[tanah], (gx, gy), method="linear")
dtm = np.where(np.isnan(dtm), griddata((kolom[tanah], baris[tanah]), z[tanah], (gx, gy), method="nearest"), dtm)

dsm = np.where(np.isnan(dsm), dtm, dsm)               # sel tanpa titik dianggap setinggi tanah
chm = np.clip(dsm - dtm, 0, None)
chm_halus = ndimage.gaussian_filter(chm, sigma=1.0)   # haluskan supaya satu tajuk = satu puncak

print("CHM maksimum (m):", round(float(chm.max()), 1))
print("Persen sel bertajuk (>2 m):", round(100 * float((chm > 2).mean()), 1), "%")

# Deteksi pohon: puncak lokal yang lebih tinggi dari 5 m
puncak = (chm_halus == ndimage.maximum_filter(chm_halus, size=7)) & (chm_halus > 5)
tinggi_deteksi = np.sort(chm[puncak])[::-1]
print("Pohon terdeteksi:", int(puncak.sum()), "dari 12 pohon yang dibuat")
print("Tiga tertinggi (m):", tinggi_deteksi[:3].round(1).tolist())
asli = np.load(tmp / "pohon_asli.npy")                 # kolom: x, y, tinggi
print("Tiga tertinggi sebenarnya (m):", np.sort(asli[:, 2])[::-1][:3].tolist())

# Mengapa satu pohon terlewat? Cari dua pohon sebenarnya yang paling berdekatan
jarak = np.hypot(*(asli[:, None, :2] - asli[None, :, :2]).transpose(2, 0, 1))
np.fill_diagonal(jarak, np.inf)
print("Jarak dua pohon terdekat (m):", round(float(jarak.min()), 1))
np.save(tmp / "chm.npy", chm)
CHM maksimum (m): 29.9
Persen sel bertajuk (>2 m): 6.4 %
Pohon terdeteksi: 11 dari 12 pohon yang dibuat
Tiga tertinggi (m): [29.9, 27.7, 26.8]
Tiga tertinggi sebenarnya (m): [29.9, 27.9, 26.8]
Jarak dua pohon terdekat (m): 3.8Tinggi tajuk maksimum yang terukur adalah 29,9 m, sama dengan pohon tertinggi yang kita buat. Tiga pohon tertinggi hasil deteksi (29,9; 27,7; 26,8) mendekati yang sebenarnya (29,9; 27,9; 26,8). Namun algoritma menemukan 11 dari 12 pohon. Mengapa satu hilang? Skrip menjawabnya: dua pohon terdekat hanya berjarak 3,8 m, sehingga tajuknya menyatu menjadi satu puncak. Ini keterbatasan nyata deteksi puncak lokal pada hutan rapat; metode yang lebih canggih (misalnya segmentasi watershed) dipakai untuk kasus itu. Persentase sel bertajuk (lebih dari 2 m) adalah 6,4%.
PDAL: alat point cloud yang lebih lengkap
PDAL adalah pustaka dan alat baris perintah untuk memproses point cloud lewat pipeline JSON: baca, saring, klasifikasikan titik tanah, buat raster. Dokumentasinya menjelaskan bahwa paket Python pdal (lewat pip install PDAL) membutuhkan PDAL yang sudah terpasang; cara termudah memasang keduanya adalah conda install -c conda-forge python-pdal. Di komputer penulis, PDAL tidak terpasang.
11_pdal_konsep.py
# Bab 51 - PDAL: alur pengolahan point cloud lewat JSON (dibaca, tidak dijalankan)
import json

import pdal

alur = [
    "hutan.las",
    {"type": "filters.smrf"},                                        # menandai titik tanah (kelas 2)
    {"type": "filters.expression", "expression": "Classification == 2"},
    {"type": "writers.gdal", "filename": "dtm.tif", "resolution": 1.0, "output_type": "min"},
]

pipeline = pdal.Pipeline(json.dumps(alur))
jumlah = pipeline.execute()
print("Titik yang diproses:", jumlah)
Kode ini tidak dijalankan saat buku dibuat karena PDAL tidak terpasang (PDAL biasanya dipasang lewat conda-forge dan belum diuji di komputer penulis), jadi keluarannya tidak ditampilkan. Tahap filters.smrf menandai titik tanah (metode Simple Morphological Filter), filters.expression menyisakan kelas 2, dan writers.gdal menulis raster dengan resolution dan output_type yang diatur. Pola ini dicocokkan dengan contoh pada dokumentasi PDAL; belum diuji pada data nyata di sini.
Tile dan peta web
Peta di browser tidak memuat satu gambar raksasa. Dunia dibagi menjadi ubin (tile) persegi dengan skema XYZ: pada zoom z, dunia terdiri dari 2^z x 2^z ubin, dan tiap ubin diberi nomor (x, y) dengan y = 0 di utara. Browser hanya meminta ubin yang terlihat di layar. Proyeksinya Web Mercator (EPSG:3857).
10_tile_peta_web.py
# Bab 51 - Tile peta web: hitung nomor tile (XYZ) dan susun peta web dengan folium
import math
from pathlib import Path

import folium
from pyproj import Transformer

tmp = Path(__file__).parent / "_tmp"
tmp.mkdir(exist_ok=True)


def nomor_tile(bujur, lintang, zoom):
    """Skema XYZ ('slippy map'): dunia dibagi 2^zoom x 2^zoom ubin; y=0 di utara."""
    n = 2 ** zoom
    x = int((bujur + 180) / 360 * n)
    y = int((1 - math.asinh(math.tan(math.radians(lintang))) / math.pi) / 2 * n)
    return x, y


def batas_tile(zoom, x, y):
    """Batas ubin dalam meter Web Mercator (EPSG:3857) -> kembali ke bujur/lintang."""
    setengah = 20037508.342789244                    # setengah keliling dunia (m) pada EPSG:3857
    lebar = 2 * setengah / 2 ** zoom
    kiri, atas = -setengah + x * lebar, setengah - y * lebar
    ke_derajat = Transformer.from_crs(3857, 4326, always_xy=True)
    barat, utara = ke_derajat.transform(kiri, atas)
    timur, selatan = ke_derajat.transform(kiri + lebar, atas - lebar)
    return barat, selatan, timur, utara


bogor = (106.8, -6.6)
for zoom in (0, 5, 10, 14):
    x, y = nomor_tile(*bogor, zoom)
    b, s, t, u = batas_tile(zoom, x, y)
    di_dalam = b <= bogor[0] <= t and s <= bogor[1] <= u
    print(f"zoom {zoom:2d}: tile ({x}, {y})  jumlah ubin sedunia: {4 ** zoom:>10,}  titik di dalam ubin: {di_dalam}")

# Peta web: lapisan tile + satu petak (GeoJSON). Alamat tile hanya templat; tidak ada yang diunduh di sini.
peta = folium.Map(location=[bogor[1], bogor[0]], zoom_start=14, tiles=None)
folium.TileLayer("https://tile.example.org/{z}/{x}/{y}.png", name="Peta dasar contoh",
                 attr="Penyedia tile contoh").add_to(peta)
petak = {"type": "Feature", "properties": {"nama": "Blok A"},
         "geometry": {"type": "Polygon", "coordinates": [[[106.79, -6.61], [106.81, -6.61],
                                                           [106.81, -6.59], [106.79, -6.59], [106.79, -6.61]]]}}
folium.GeoJson(petak, name="Blok kebun", tooltip="Blok A").add_to(peta)
peta.save(tmp / "peta.html")
html = (tmp / "peta.html").read_text(encoding="utf-8")
print("Templat tile ada di HTML:", "{z}/{x}/{y}" in html)
print("Data petak ada di HTML:", "Blok A" in html)
zoom 0: tile (0, 0) jumlah ubin sedunia: 1 titik di dalam ubin: True
zoom 5: tile (25, 16) jumlah ubin sedunia: 1,024 titik di dalam ubin: True
zoom 10: tile (815, 530) jumlah ubin sedunia: 1,048,576 titik di dalam ubin: True
zoom 14: tile (13052, 8493) jumlah ubin sedunia: 268,435,456 titik di dalam ubin: True
Templat tile ada di HTML: True
Data petak ada di HTML: TrueTitik di Bogor jatuh di ubin (25, 16) pada zoom 5, dan (13052, 8493) pada zoom 14, di mana dunia sudah terbagi menjadi 268.435.456 ubin. Fungsi batas_tile menghitung batas ubin dari EPSG:3857 memakai pyproj dan memastikan titik memang berada di dalamnya (True di setiap tingkat), jadi rumus nomor ubin kita terverifikasi secara independen. Lalu folium menyusun peta web HTML dengan lapisan tile dan satu petak GeoJSON. Alamat tile tile.example.org hanya templat contoh; tidak ada ubin yang diunduh. Bila Anda memakai penyedia tile sungguhan, baca syarat penggunaannya.
Model fondasi geospasial: SAM
Model fondasi adalah model besar yang dilatih pada data sangat banyak lalu dipakai untuk banyak tugas. Segment Anything Model (SAM) dari Meta meng-“segmentasi” objek di gambar: Anda memberi gambar (dan, bila mau, petunjuk berupa titik atau kotak), ia mengembalikan mask (daftar piksel tiap objek). Dokumentasi resminya menyebut model dilatih pada sekitar 11 juta gambar dan 1,1 miliar mask, berlisensi Apache 2.0, dan tersedia dalam tiga ukuran tulang punggung: vit_h, vit_l, vit_b. Pada citra drone atau satelit beresolusi tinggi, ia berguna untuk menandai petak, atap, atau tajuk.
12_sam_konsep.py
# Bab 51 - Model fondasi SAM: segmentasi otomatis atas citra (dibaca, tidak dijalankan)
import rasterio
from segment_anything import SamAutomaticMaskGenerator, sam_model_registry

# 1. Muat bobot model yang sudah Anda unduh sendiri dari halaman resmi
sam = sam_model_registry["vit_b"](checkpoint="sam_vit_b.pth")        # berkas bobot milik Anda

# 2. SAM menerima citra 8-bit berbentuk (tinggi, lebar, kanal): "HWC uint8" menurut dokumentasi kodenya
with rasterio.open("kebun_rgb.tif") as src:
    citra = src.read([1, 2, 3]).transpose(1, 2, 0)                   # (band, y, x) -> (y, x, band)

# 3. Hasilnya: daftar "mask", satu per objek yang ditemukan (petak, pohon, atap, ...)
pembuat_mask = SamAutomaticMaskGenerator(sam)
daftar_mask = pembuat_mask.generate(citra)
print("Jumlah objek ditemukan:", len(daftar_mask))
# Tiap mask berisi kunci seperti 'segmentation' (piksel objek) dan 'area' (luas dalam piksel)
Kode ini tidak dijalankan saat buku dibuat karena butuh model SAM besar (berkas bobot terpisah), torch, dan citra nyata yang tidak dipasang di sini, jadi keluarannya tidak ditampilkan. Pola panggilannya sama dengan README resmi (sam_model_registry, SamAutomaticMaskGenerator, generate). Catatan jujur: SAM tidak dirancang khusus untuk citra bumi (sudut pandang dari atas, objek kecil, banyak pita spektral); hasilnya pada citra satelit atau drone perlu diperiksa dan mungkin perlu disesuaikan. Soal ini belum diuji di sini. Ada pula pustaka turunan yang khusus geospasial, tetapi tidak dibahas atau diuji di sini.
Proyek Bersambung A2: dari katalog STAC ke Zarr
Saatnya menyambung potongan-potongan itu: memilih scene dari katalog, membuka COG-nya, menumpuknya menjadi satu array waktu, dan menyimpannya sebagai Zarr.
13_proyek_pipeline.py
# Bab 51 - Proyek bersambung A2: katalog STAC -> tumpukan waktu -> Zarr
import shutil
import warnings
from pathlib import Path

import pystac
import rioxarray  # noqa: F401
import xarray as xr

akar = Path(__file__).parent / "_tmp" / "stac_kebun"
if not (akar / "catalog.json").exists():                 # dibuat oleh skrip 05
    raise SystemExit("jalankan 05_stac_lokal.py dulu")
warnings.simplefilter("ignore")

# 1. Pilih item dari katalog: awan di bawah 20 persen
katalog = pystac.Catalog.from_file(str(akar / "catalog.json"))
item_terpilih = [it for it in katalog.get_items(recursive=True) if it.properties["eo:cloud_cover"] < 20]
item_terpilih.sort(key=lambda it: it.datetime)
print("Scene dipakai:", [it.id for it in item_terpilih])

# 2. Buka tiap COG, beri sumbu waktu, tumpuk jadi satu DataArray
lapisan = []
for it in item_terpilih:
    jalur = akar / it.assets["ndvi"].href
    da = rioxarray.open_rasterio(jalur).squeeze("band", drop=True)
    lapisan.append(da.expand_dims(waktu=[it.datetime.replace(tzinfo=None)]))
tumpukan = xr.concat(lapisan, dim="waktu").rename("ndvi").chunk({"waktu": 1, "y": 128, "x": 128})
print("Tumpukan:", dict(tumpukan.sizes), "| potongan:", tumpukan.chunksizes["y"])

# 3. Simpan sebagai Zarr, lalu baca kembali dan bandingkan
tujuan = akar.parent / "ndvi_kebun.zarr"
shutil.rmtree(tujuan, ignore_errors=True)
tumpukan.to_dataset().to_zarr(tujuan, mode="w", consolidated=False)
baca = xr.open_zarr(tujuan, consolidated=False)
sama = bool((baca["ndvi"].compute() == tumpukan.compute()).all())
print("Zarr terbaca kembali sama persis:", sama)
rata = baca["ndvi"].mean(dim=("y", "x")).compute()
print("NDVI rata-rata per tanggal:", [round(float(v), 3) for v in rata.values])
Scene dipakai: ['scene-20260105', 'scene-20260306', 'scene-20260405']
Tumpukan: {'waktu': 3, 'y': 256, 'x': 256} | potongan: (128, 128)
Zarr terbaca kembali sama persis: True
NDVI rata-rata per tanggal: [0.4, 0.6, 0.7]Tiga scene dipilih (awan di bawah 20%): 5 Januari, 6 Maret, dan 5 April. Tumpukannya berukuran 3 x 256 x 256 dengan chunk 128 x 128. Setelah disimpan sebagai Zarr dan dibaca ulang, isinya sama persis dengan aslinya. Rata-rata NDVI per tanggal: 0,4; 0,6; 0,7 (data tiruan yang dibuat naik 0,1 per scene). Bersama model tinggi tajuk dari LiDAR tiruan di atas, dua dari tiga unsur proyek Seri A2 sudah ada; unsur ketiga (data sensor) datang di Bab 52.
Latihan
- Ubah
blocksizepada01_tulis_cog.pymenjadi 128. Berapa overview yang dibuat GDAL sekarang? - Pada
03_geoparquet.py, ganti kotakboundsmenjadi dua kali lebih besar. Berapa titik yang terambil, dan apakah hasilnya masih sama dengan penyaringan manual? - Tambahkan satu item kelima (awan 8%, tanggal 5 Mei 2026) ke katalog di
05_stac_lokal.py, lalu pastikan item itu lolos saringan. - Tantangan: pada
09_tinggi_tajuk.py, ubahsigmapenghalus dari 1,0 menjadi 0,5 dan 2,0. Berapa pohon yang terdeteksi pada tiap nilai? Jelaskan mengapa angkanya berubah.
Ringkasan Bab
- Data cloud-native dirancang agar bisa dibaca sebagian lewat internet (permintaan rentang).
- COG: GeoTIFF berubin dengan overview; GeoParquet: vektor kolumnar dengan metadata CRS; Zarr: array besar dalam chunk.
- STAC menggambarkan data lewat Catalog, Collection, Item, dan Asset;
pystac-clientmencari, dan pada katalog publik cukup membaca metadata dulu. - xarray/rioxarray menangani tumpukan citra multitemporal dengan sumbu bernama dan komposit median untuk melewati awan.
- LiDAR menghasilkan point cloud; CHM = DSM - DTM. PDAL dan SAM dijelaskan dari dokumentasi, tidak dijalankan di sini.
- Tile XYZ dan Web Mercator mendasari peta web.
Selanjutnya, di Bab 52: data tidak hanya datang dari langit. Sensor di kebun, kolam, dan kandang juga mengirim data. Kita belajar MicroPython, MQTT, GPS, dan citra drone.