SERI BELAJAR AI · JILID 2 · TAHAP 16
AI Generatif Multimodal
Dari Teks ke Gambar, Audio, dan Video
Sejauh ini, Tahap 11-15 fokus pada AI yang bekerja dengan TEKS. Tapi dunia AI generatif jauh lebih luas: ada AI yang bisa membuat gambar dari deskripsi teks (seperti Midjourney, DALL-E, Stable Diffusion, atau fitur gambar di Gemini dan GPT-4o), AI yang membuat suara/musik (seperti Suno atau ElevenLabs), bahkan AI yang membuat video penuh dari teks (seperti Sora dari OpenAI, Veo dari Google, atau Runway). Tahap 16 membahas bagaimana cara kerja AI 'lintas-media' ini secara umum, dan bagaimana ia berhubungan dengan konsep-konsep yang sudah kita pelajari di tahap sebelumnya.
1. Apa Itu 'Multimodal'?
Multimodal berarti AI yang bisa memproses dan/atau menghasilkan lebih dari satu jenis data (modalitas) — teks, gambar, audio, video. Ada dua arah: (a) AI yang bisa MEMAHAMI input dari berbagai modalitas (misalnya Claude, Gemini, dan GPT-4o yang bisa 'melihat' gambar yang Anda unggah dan menjelaskannya), dan (b) AI yang bisa MENGHASILKAN (generate) konten dalam modalitas yang berbeda dari inputnya, misalnya mengubah teks deskripsi menjadi gambar.
Tahap ini fokus terutama pada kemampuan GENERATIF lintas-modalitas: bagaimana AI mengubah deskripsi teks menjadi gambar, audio, atau video yang benar-benar baru.
2. Cara Kerja Umum: Mengubah Teks Menjadi Gambar
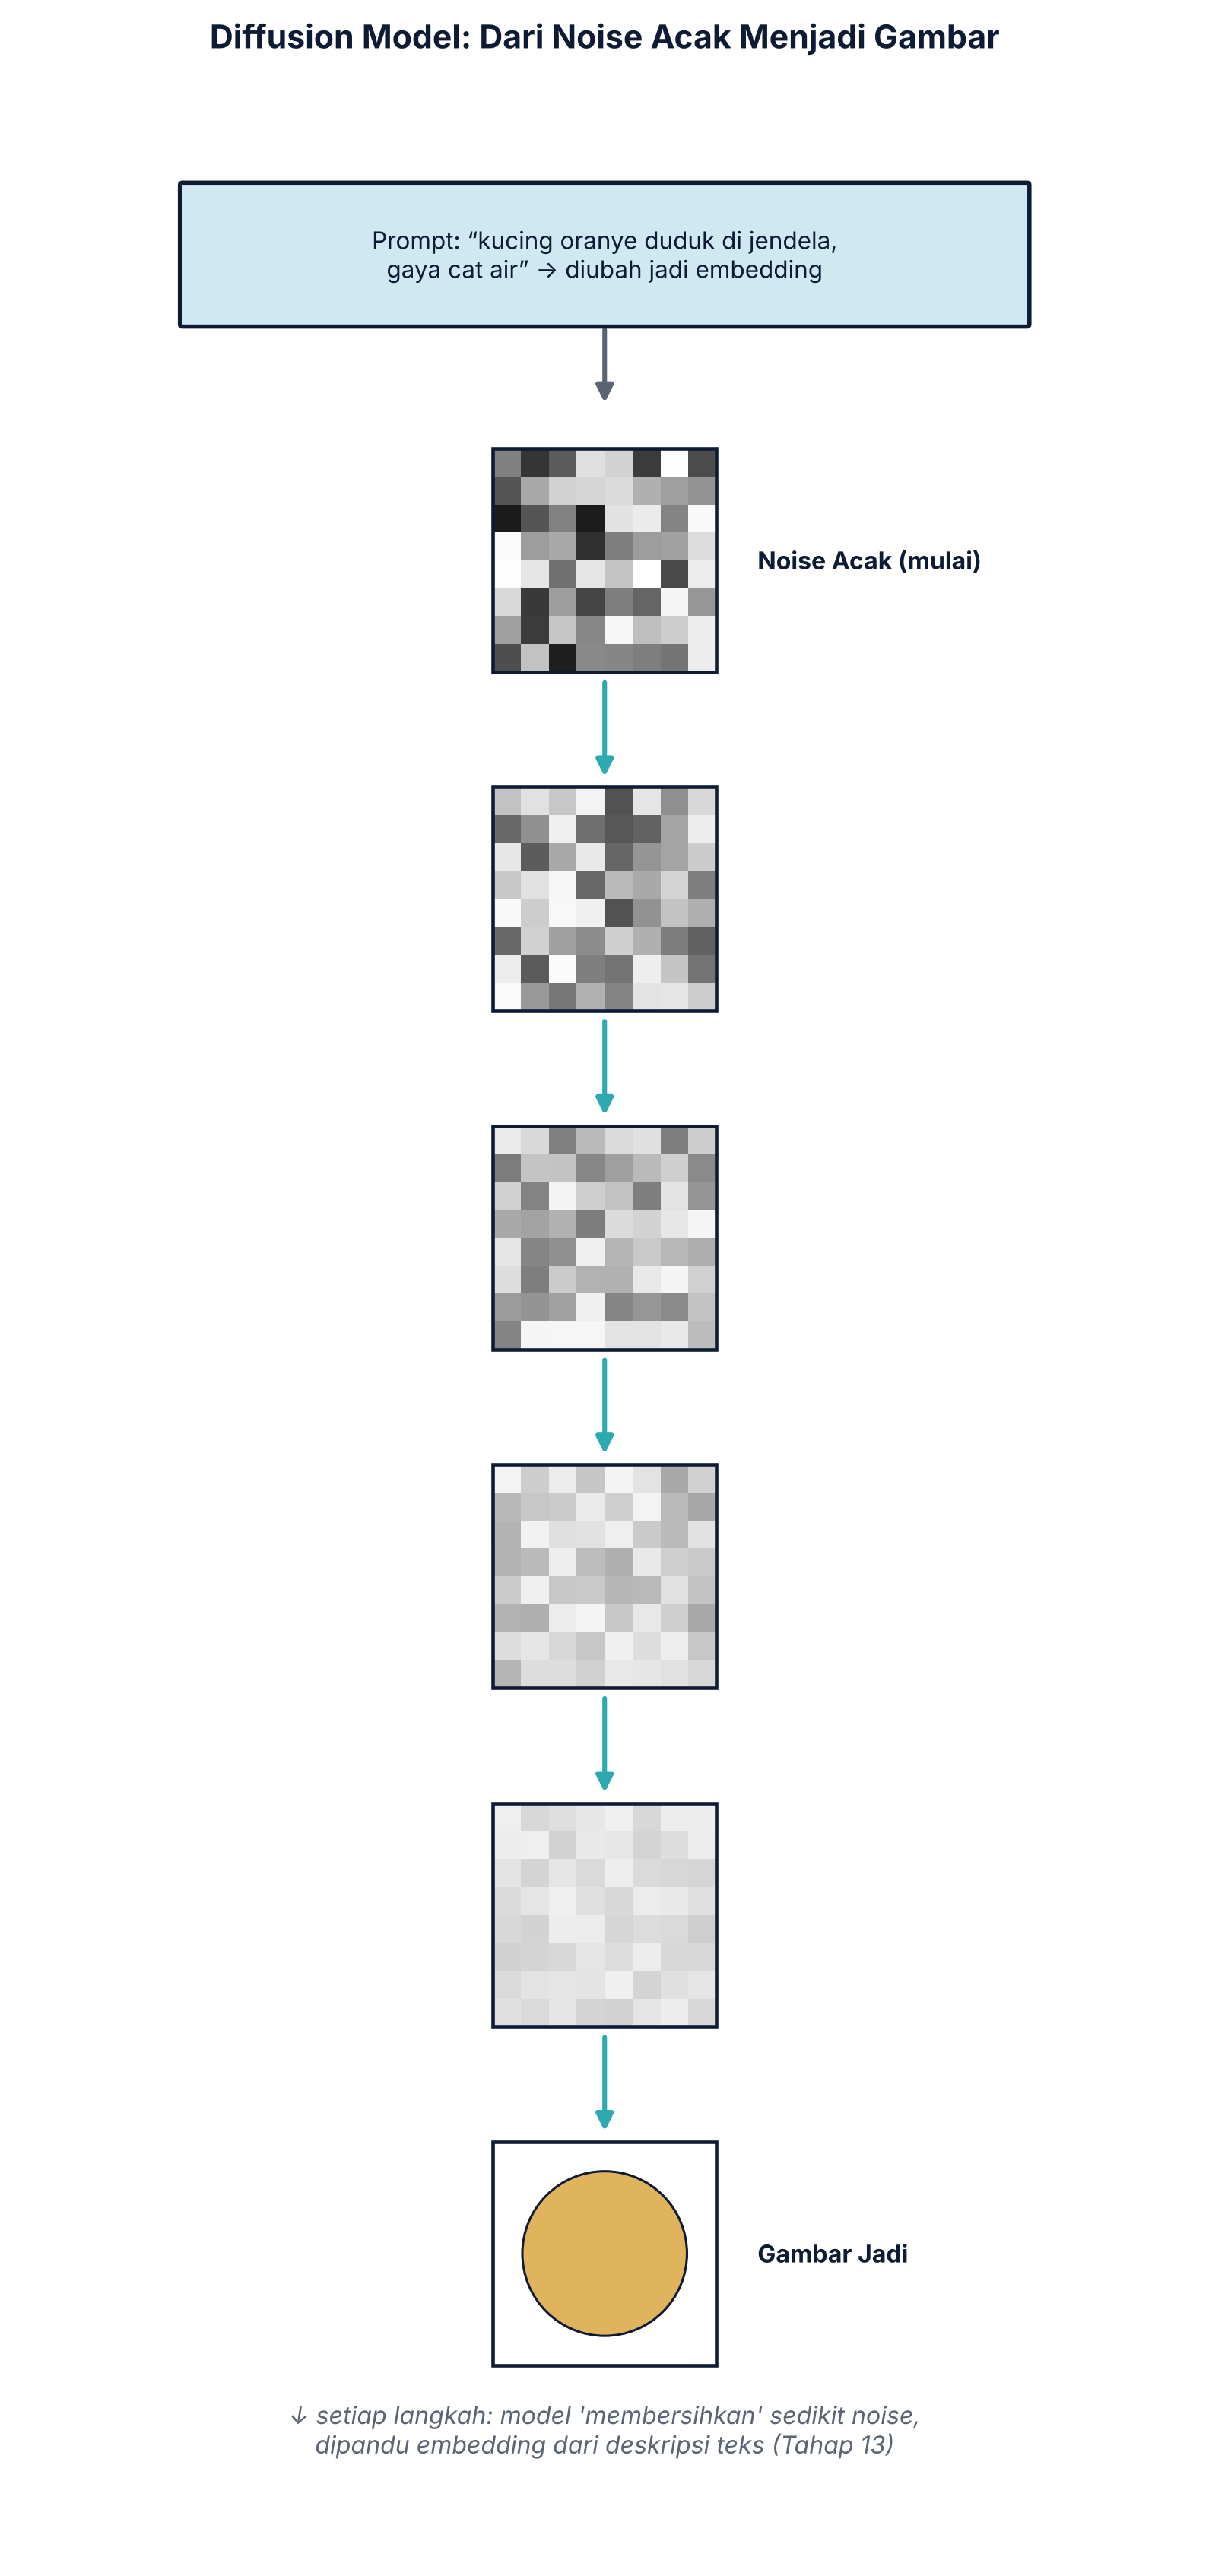
Mayoritas AI generator gambar populer saat ini (termasuk Stable Diffusion, Midjourney, dan DALL-E) memakai pendekatan bernama diffusion model. Cara kerjanya cukup unik dan berlawanan dengan intuisi: model dilatih untuk 'membersihkan noise' (derau/bintik acak) secara bertahap dari sebuah gambar, langkah demi langkah, sampai menghasilkan gambar yang jelas dan sesuai dengan deskripsi teks yang diberikan.
Saat menghasilkan gambar baru, prosesnya dimulai dari gambar yang BENAR-BENAR hanya berisi noise acak (seperti gambar 'semut' di TV lama), lalu model secara bertahap 'membersihkan' noise itu sedikit demi sedikit (puluhan langkah), setiap kali dipandu oleh embedding (ingat Tahap 13!) dari deskripsi teks yang kita berikan, sampai akhirnya noise acak itu 'berubah' menjadi gambar yang koheren dan sesuai deskripsi.
💡 Analogi
Bayangkan seorang pematung yang bekerja dengan cara terbalik dari biasanya: ia mulai dari balok marmer yang terlihat seperti 'kekacauan' tanpa bentuk, lalu secara bertahap memahat sedikit demi sedikit, SAMBIL terus melihat sketsa/deskripsi yang Anda berikan sebagai panduan, sampai akhirnya bentuk yang jelas muncul dari kekacauan tadi. Diffusion model bekerja mirip seperti ini — 'memahat' gambar dari noise acak, bertahap, dipandu deskripsi teks.
3. Bagaimana dengan Audio dan Video?
AI generator audio (musik maupun suara/voice) umumnya juga memakai pendekatan serupa (diffusion atau varian arsitektur Transformer yang disesuaikan untuk data audio), hanya saja 'kanvas'-nya bukan piksel gambar, melainkan gelombang suara atau representasi spektral audio.
AI generator video (seperti Sora dari OpenAI atau Veo dari Google) jauh lebih kompleks karena harus menjaga KONSISTENSI antar-frame dari waktu ke waktu (objek, pencahayaan, gerakan harus masuk akal dan konsisten dari satu frame ke frame berikutnya), biasanya menggabungkan prinsip diffusion dengan arsitektur Transformer untuk menangani dimensi waktu (temporal) selain dimensi ruang (spasial).
4. Peran Embedding Lintas-Modalitas (CLIP dan Sejenisnya)
Agar AI bisa menghubungkan deskripsi TEKS dengan GAMBAR yang sesuai, dibutuhkan 'jembatan' yang menempatkan teks dan gambar dalam ruang embedding YANG SAMA (ingat konsep embedding dari Tahap 13) — sehingga teks 'kucing oranye duduk di jendela' punya vektor yang dekat dengan foto-foto kucing oranye yang sedang duduk di jendela. Model seperti CLIP (dikembangkan OpenAI) adalah contoh terkenal dari pendekatan ini, dan menjadi fondasi banyak sistem generator gambar modern.
5. Lanskap AI Generatif Multimodal Saat Ini
- Gambar: Midjourney, DALL-E (OpenAI), Stable Diffusion, Imagen (Google), serta fitur pembuatan gambar terintegrasi di ChatGPT (GPT-4o) dan Gemini.
- Audio/Musik: Suno, Udio, untuk musik; ElevenLabs untuk suara/voice cloning yang sangat realistis.
- Video: Sora (OpenAI), Veo (Google), Runway, Kling, dan lainnya — kategori yang berkembang sangat cepat.
- Model 'serba bisa' (natively multimodal): beberapa model terbaru seperti Gemini dan GPT-4o dirancang untuk memahami DAN menghasilkan berbagai modalitas dalam satu model terpadu, bukan menyambungkan beberapa model terpisah.
Diagram & Ilustrasi
Geser ke samping, atau ketuk gambar untuk membukanya dalam ukuran penuh.
Rangkuman Tahap 16
- AI generatif multimodal menghasilkan konten di luar teks — gambar, audio, dan video — berdasarkan deskripsi (biasanya teks).
- Mayoritas AI generator gambar memakai diffusion model: membersihkan noise acak secara bertahap menjadi gambar koheren, dipandu embedding dari deskripsi teks.
- AI generator video memperluas prinsip ini dengan tantangan tambahan menjaga konsistensi antar-frame dari waktu ke waktu.
- Model seperti CLIP menjembatani teks dan gambar dalam satu ruang embedding yang sama, menjadi fondasi banyak sistem generatif.
- Lanskap saat ini sangat beragam: Midjourney, DALL-E, Stable Diffusion (gambar), Suno/ElevenLabs (audio), Sora/Veo/Runway (video), serta model multimodal terpadu seperti Gemini dan GPT-4o.
- Tahap terakhir Jilid 2 (Tahap 17) akan membahas keterbatasan LLM — hallucination, bias, dan cara mengevaluasi keandalan jawaban AI.
Istilah Penting
| Istilah | Penjelasan |
|---|---|
| Multimodal | Kemampuan AI memproses dan/atau menghasilkan lebih dari satu jenis data: teks, gambar, audio, video. |
| Diffusion Model | Pendekatan AI generatif yang bekerja dengan membersihkan noise acak secara bertahap menjadi output yang koheren, dipandu oleh deskripsi/kondisi tertentu. |
| CLIP | Model yang menempatkan teks dan gambar dalam ruang embedding yang sama, menjembatani pemahaman lintas-modalitas. |
| Text-to-Image / Text-to-Video | Kategori AI generatif yang mengubah deskripsi teks menjadi gambar atau video baru. |