SERI BELAJAR AI · JILID 2 · TAHAP 15
Fine-Tuning vs Prompting
Dua Cara Berbeda Menyesuaikan AI untuk Kebutuhan Spesifik Anda
Setelah memahami bagaimana LLM dilatih (Tahap 12) dan bagaimana RAG memberinya akses ke dokumen eksternal (Tahap 14), muncul pertanyaan praktis: bagaimana jika saya ingin AI berperilaku dengan cara tertentu — misalnya selalu menjawab dengan gaya formal, atau sangat ahli dalam istilah hukum perusahaan saya? Ada dua pendekatan utama: prompting (termasuk in-context learning) dan fine-tuning. Tahap 15 ini membahas keduanya, kapan masing-masing cocok dipakai, dan bagaimana keduanya saling melengkapi.
1. Prompting: Mengarahkan AI Lewat Instruksi, Tanpa Melatih Ulang
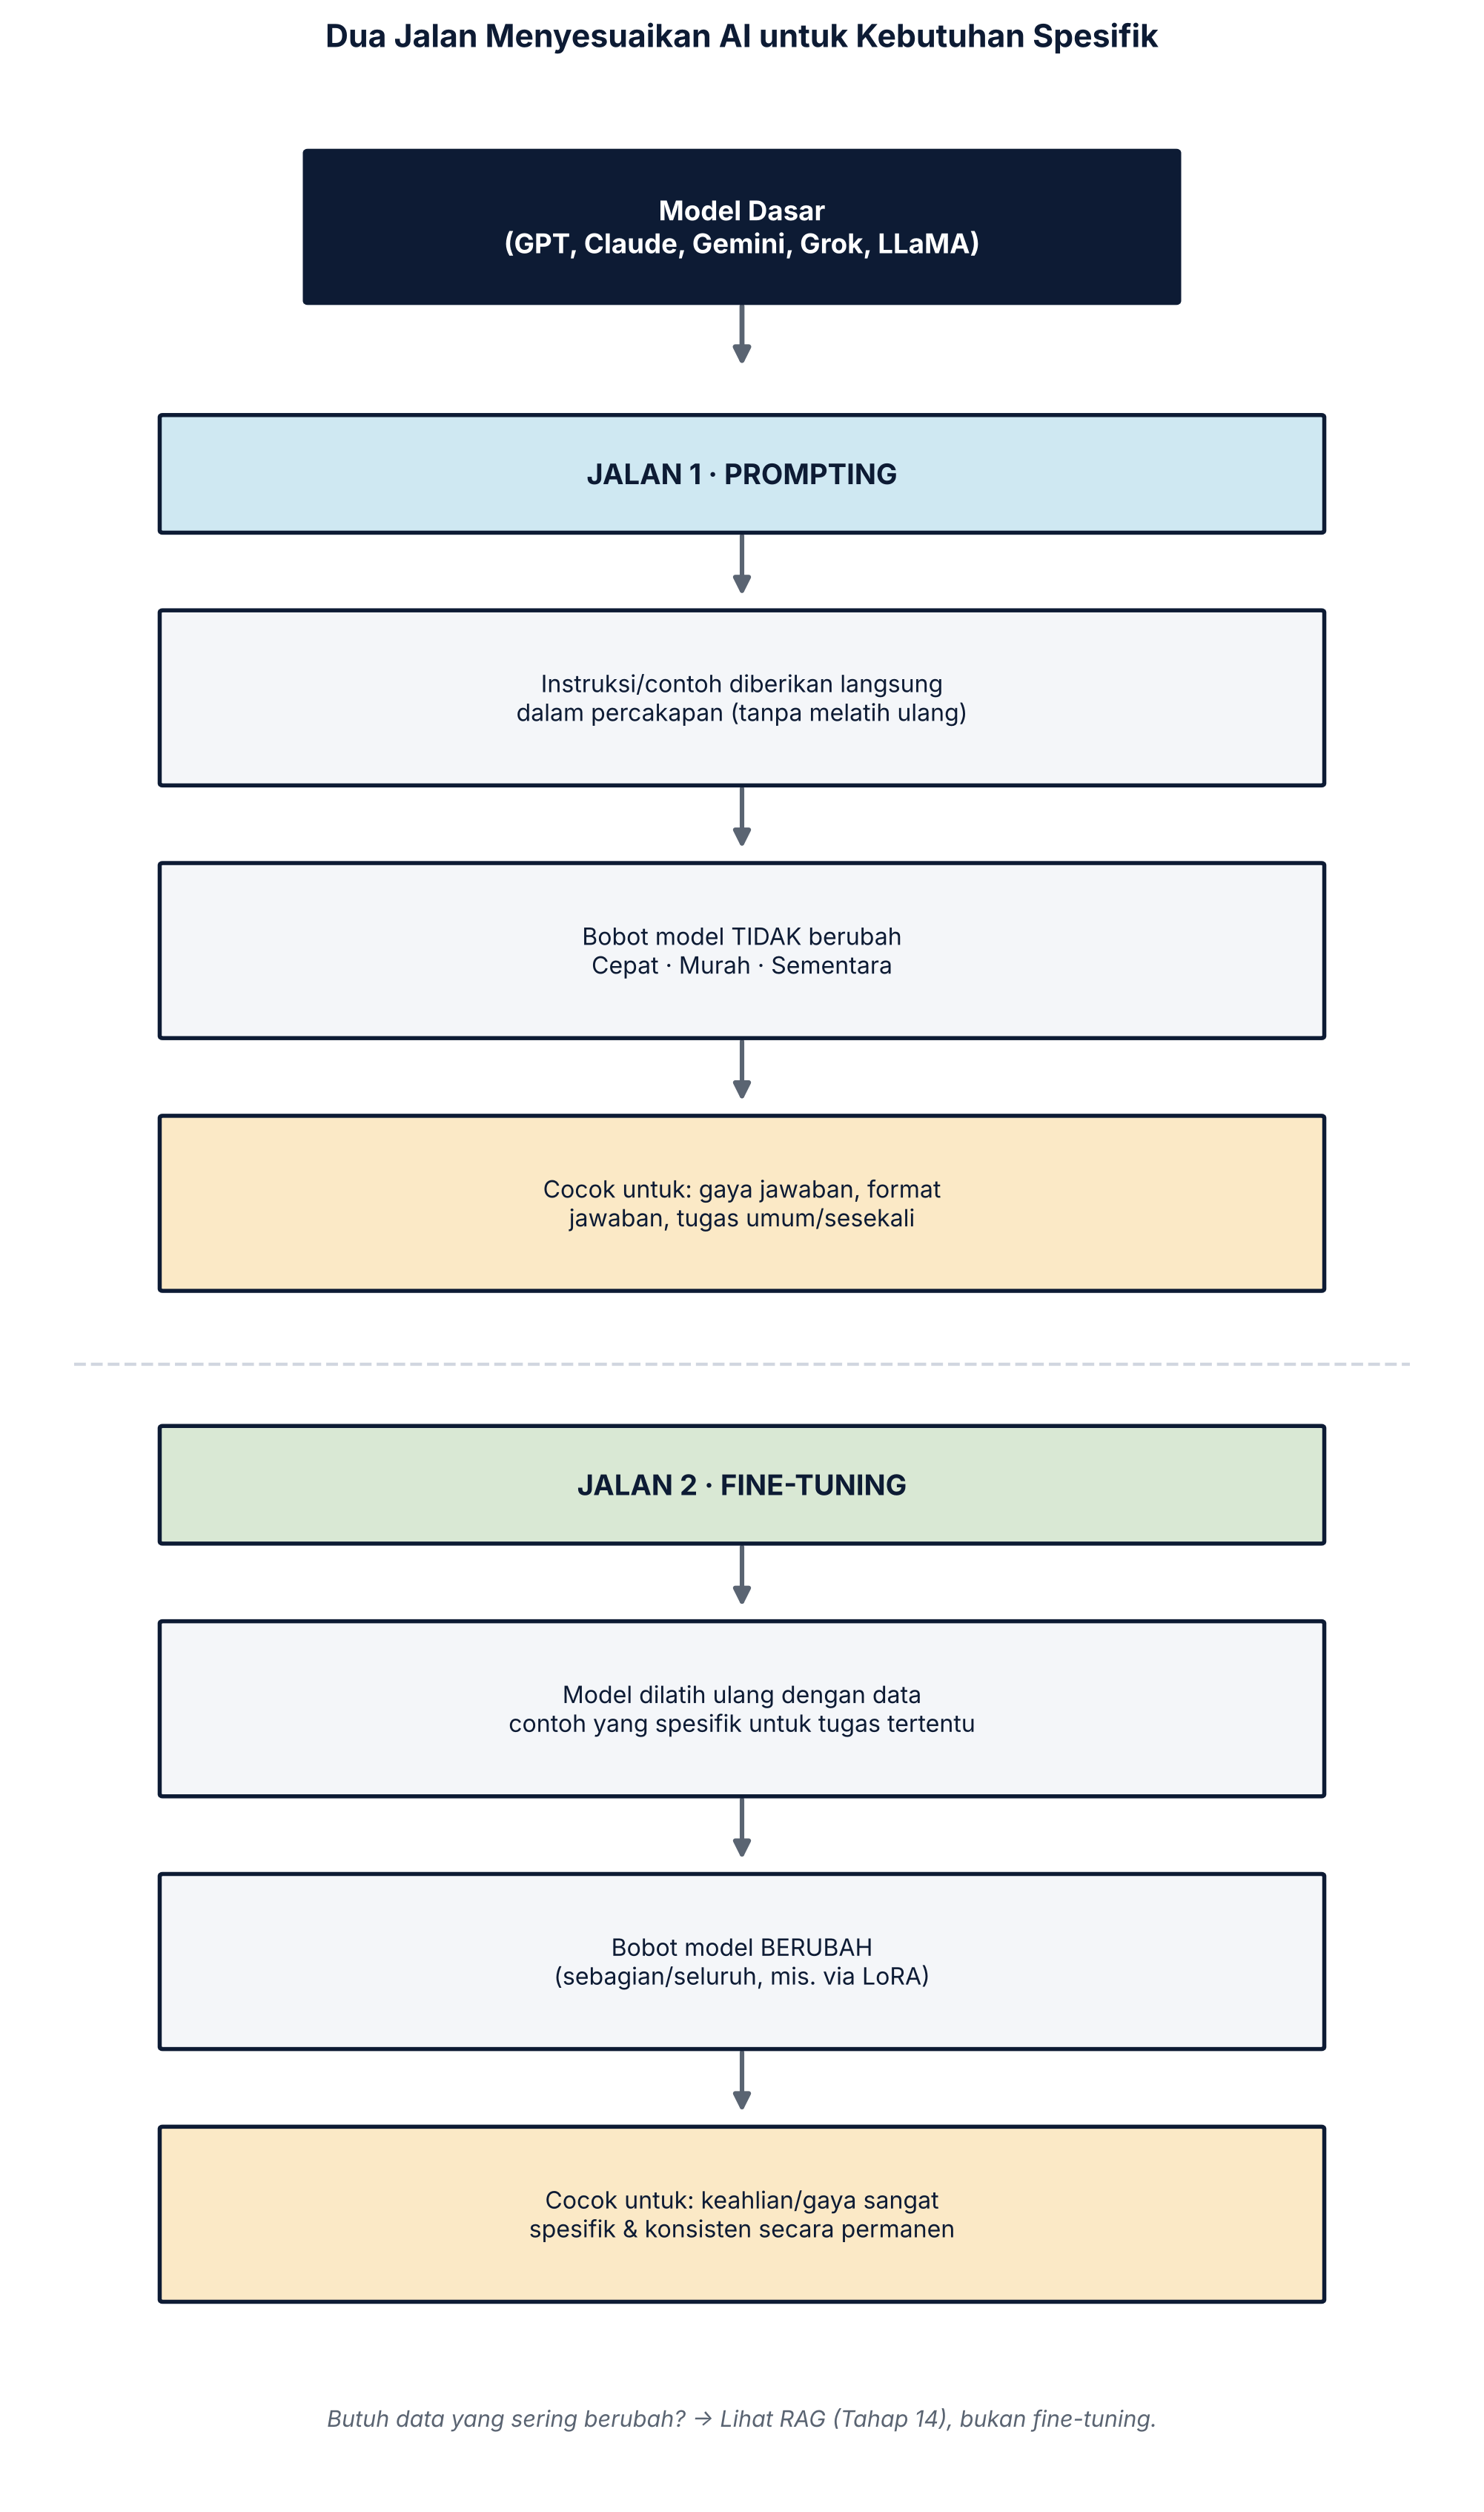
Prompting adalah cara paling sederhana dan paling umum dipakai sehari-hari: memberi instruksi, konteks, atau contoh langsung dalam percakapan dengan AI, TANPA mengubah satu pun bobot/parameter internal model. Model dasar (seperti GPT di balik ChatGPT, atau model dasar Claude/Gemini/Grok/LLaMA) tetap sama persis; yang berubah hanyalah teks yang kita berikan sebagai instruksi.
Salah satu bentuk prompting yang kuat disebut in-context learning (atau few-shot prompting): kita memberi beberapa CONTOH di dalam prompt tentang bagaimana kita ingin AI menjawab, dan model akan 'meniru' pola dari contoh-contoh itu untuk pertanyaan baru, meski tidak pernah 'dilatih ulang' secara formal.
💡 Analogi
Prompting ibarat memberi instruksi lisan kepada seorang pegawai baru yang sebenarnya sudah sangat berpengalaman dan pintar: 'tolong tulis balasan email ini dengan nada formal, dan sertakan tiga poin utama berikut.' Pegawai itu TIDAK perlu 'belajar ulang' keahliannya dari nol — ia hanya menyesuaikan caranya bekerja berdasarkan instruksi spesifik yang baru saja diberikan, lalu kembali ke 'default' di percakapan berikutnya.
2. Fine-Tuning: Melatih Ulang Sebagian Model untuk Tugas Spesifik
Fine-tuning adalah proses melanjutkan pelatihan model yang SUDAH ADA (model dasar hasil pre-training) dengan data tambahan yang lebih spesifik, sehingga bobot/parameter internal model BENAR-BENAR BERUBAH (walau biasanya hanya sebagian kecil darinya yang disesuaikan, tergantung tekniknya).
Berbeda dengan prompting yang sifatnya sementara (hanya berlaku untuk percakapan itu), hasil fine-tuning menjadi 'melekat' secara permanen pada model baru itu — model akan konsisten berperilaku sesuai data fine-tuning, bahkan tanpa instruksi khusus di setiap prompt.
💡 Analogi
Fine-tuning ibarat mengirim pegawai itu mengikuti PELATIHAN KHUSUS selama berminggu-minggu untuk menjadi ahli di bidang sangat spesifik — misalnya terminologi hukum perusahaan farmasi. Setelah pelatihan itu, keahliannya benar-benar 'melekat' pada dirinya; ia akan otomatis memakai istilah dan gaya yang tepat tanpa perlu diingatkan setiap kali, karena caranya berpikir sudah benar-benar berubah, bukan sekadar mengikuti instruksi sesaat.
3. Perbandingan Langsung
| Aspek | Prompting / In-Context Learning | Fine-Tuning |
|---|---|---|
| Mengubah bobot model? | Tidak | Ya (sebagian atau seluruhnya) |
| Biaya & waktu | Sangat murah & instan | Butuh data latih, komputasi, dan waktu |
| Sifat perubahan | Sementara, per-percakapan | Permanen, melekat pada model baru |
| Cocok untuk | Instruksi gaya, format jawaban, tugas umum | Pengetahuan/gaya sangat spesifik & konsisten, istilah khusus domain |
| Butuh data latih khusus? | Tidak wajib (cukup contoh di prompt) | Ya, perlu dataset contoh berkualitas |
4. Parameter-Efficient Fine-Tuning (PEFT) & LoRA
Melakukan fine-tuning penuh terhadap model raksasa (dengan miliaran parameter) sangat mahal secara komputasi. Karena itu, berkembang teknik yang lebih hemat bernama PEFT (Parameter-Efficient Fine-Tuning), dengan metode populer bernama LoRA (Low-Rank Adaptation). Alih-alih mengubah SEMUA bobot model, LoRA hanya menambahkan sejumlah kecil parameter baru yang dilatih, sementara mayoritas bobot model asli dibiarkan tidak berubah — hasilnya jauh lebih murah dan cepat, namun tetap efektif untuk banyak kasus penggunaan.
5. Kapan Memilih yang Mana?
- Butuh AI mengikuti format/gaya tertentu untuk tugas sesekali? Cukup prompting — paling cepat dan murah.
- Butuh AI mengakses informasi terbaru/dokumen spesifik yang sering berubah? Pakai RAG (Tahap 14), bukan fine-tuning.
- Butuh AI punya 'kepribadian'/keahlian sangat konsisten dalam domain sangat spesifik (misalnya istilah medis, gaya penulisan khas brand tertentu) untuk dipakai berulang kali dalam skala besar? Fine-tuning lebih masuk akal, meski biayanya lebih besar.
- Dalam praktiknya, banyak aplikasi AI menggabungkan ketiganya: model dasar (dari OpenAI, Anthropic, Google, xAI, atau Meta) + fine-tuning ringan (opsional) + prompting yang baik + RAG untuk data terbaru.
Diagram & Ilustrasi
Geser ke samping, atau ketuk gambar untuk membukanya dalam ukuran penuh.
Rangkuman Tahap 15
- Prompting mengarahkan perilaku AI lewat instruksi dalam percakapan, TANPA mengubah model — cepat, murah, tapi sifatnya sementara.
- Fine-tuning benar-benar mengubah sebagian bobot internal model lewat pelatihan tambahan — lebih mahal, tapi hasilnya melekat permanen pada model baru.
- Teknik seperti LoRA/PEFT membuat fine-tuning jauh lebih hemat biaya dengan hanya melatih sebagian kecil parameter tambahan.
- Pilihan antara prompting, RAG, dan fine-tuning tergantung kebutuhan: instruksi sesaat, data yang sering berubah, atau keahlian/gaya yang harus konsisten permanen.
- Tahap berikutnya (Tahap 16) membahas AI generatif multimodal — bagaimana AI menghasilkan gambar, audio, dan video, bukan hanya teks.
Istilah Penting
| Istilah | Penjelasan |
|---|---|
| Prompting | Mengarahkan perilaku AI lewat instruksi/contoh dalam teks percakapan, tanpa mengubah model. |
| In-Context Learning | Kemampuan model 'meniru' pola dari contoh yang diberikan langsung di dalam prompt. |
| Fine-Tuning | Melanjutkan pelatihan model yang sudah ada dengan data tambahan spesifik, mengubah sebagian bobot internalnya. |
| LoRA (Low-Rank Adaptation) | Teknik fine-tuning hemat biaya yang hanya menambah & melatih sebagian kecil parameter baru, bukan seluruh model. |
| PEFT | Parameter-Efficient Fine-Tuning — kelompok teknik fine-tuning yang hemat komputasi, salah satunya LoRA. |