SERI BELAJAR AI · JILID 2 · TAHAP 14
RAG — Retrieval-Augmented Generation
AI yang 'Membuka Buku Catatan' Sebelum Menjawab
LLM seperti ChatGPT, Claude, Gemini, Grok, atau LLaMA hanya 'tahu' apa yang ada dalam data pelatihannya, yang punya batas waktu tertentu (knowledge cutoff) dan tidak mencakup dokumen pribadi Anda — seperti kebijakan internal perusahaan, laporan keuangan terbaru, atau isi email Anda. Lalu bagaimana AI bisa menjawab pertanyaan tentang dokumen yang belum pernah dilihatnya sebelumnya, atau peristiwa yang terjadi SETELAH data pelatihannya berakhir?
Jawabannya: RAG (Retrieval-Augmented Generation) — teknik yang menggabungkan embedding dan semantic search (Tahap 13) dengan kemampuan generatif LLM (Tahap 11-12), sehingga AI bisa 'membuka buku catatan' yang relevan terlebih dahulu sebelum menjawab, alih-alih hanya mengandalkan 'ingatan' dari data pelatihan.
1. Masalah yang Dipecahkan RAG
- Knowledge cutoff: LLM tidak tahu peristiwa yang terjadi setelah data pelatihannya berhenti dikumpulkan.
- Data privat/internal: LLM tidak pernah membaca dokumen pribadi Anda (kontrak perusahaan, database pelanggan, manual produk internal) kecuali diberi tahu secara eksplisit.
- Hallucination (mengarang jawaban): tanpa sumber yang jelas, LLM kadang 'mengarang' jawaban yang terdengar meyakinkan tapi salah (akan dibahas lebih dalam di Tahap 17).
2. Cara Kerja RAG, Langkah demi Langkah
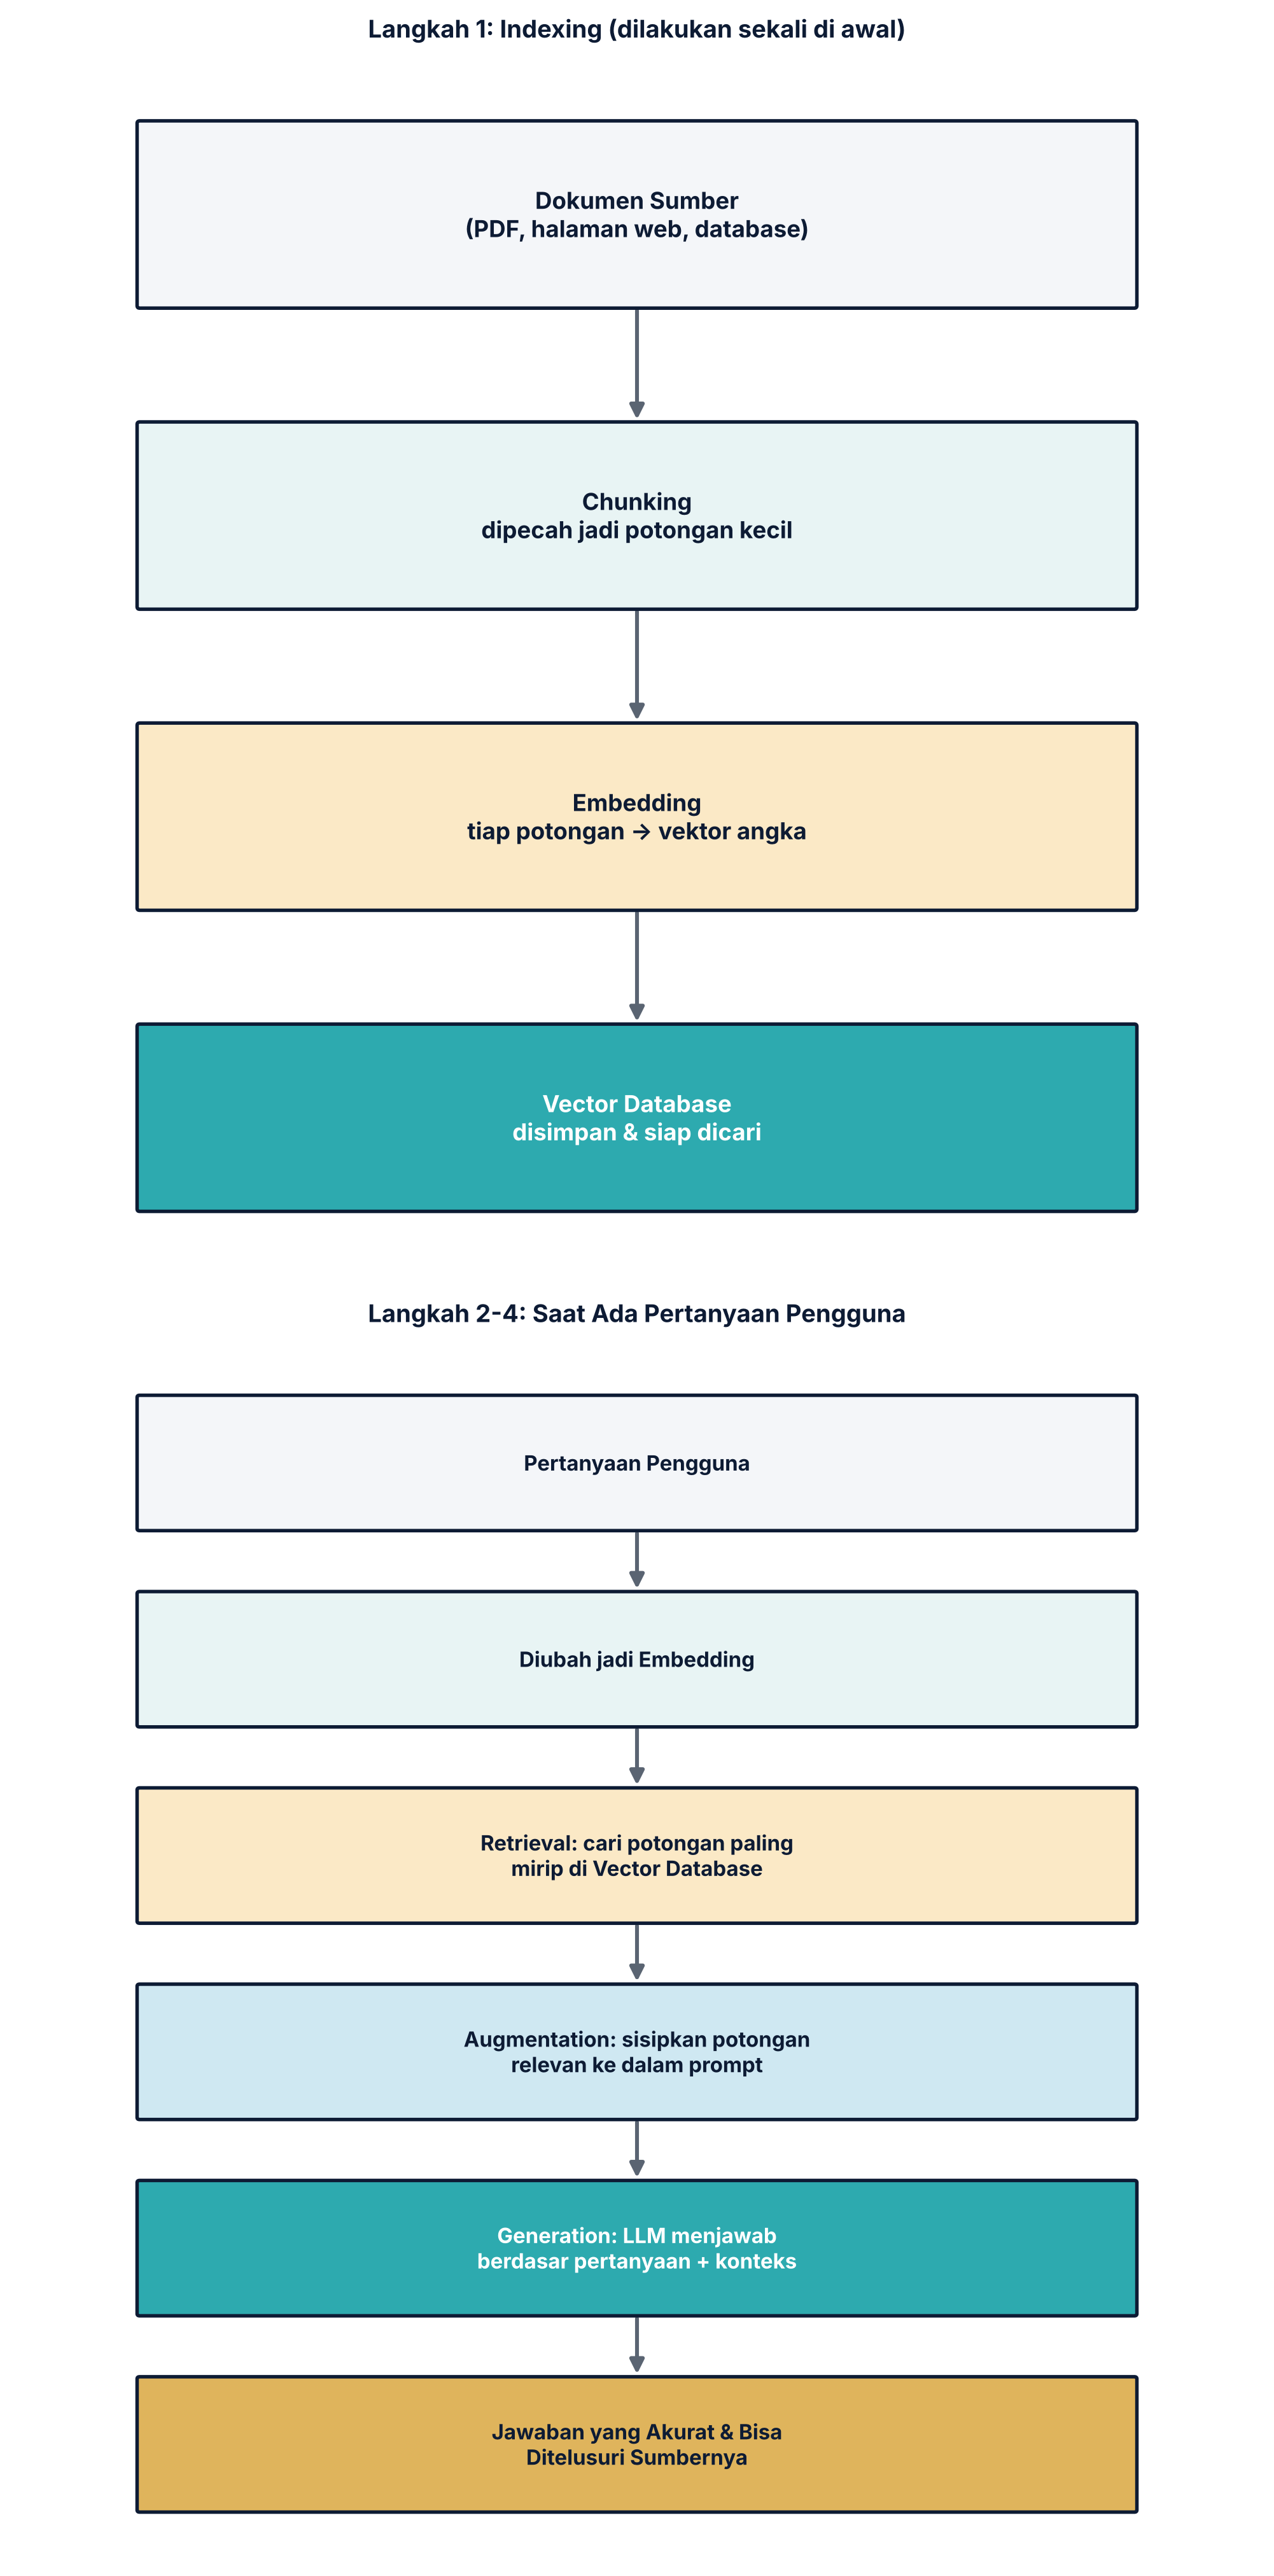
Langkah 1 — Indexing (dilakukan sekali di awal, sebelum ada pertanyaan): dokumen-dokumen sumber (PDF, halaman web, database) dipecah menjadi potongan-potongan kecil (chunks), lalu masing-masing potongan diubah menjadi vektor embedding dan disimpan dalam basis data khusus bernama vector database.
Langkah 2 — Retrieval (saat ada pertanyaan dari pengguna): pertanyaan pengguna juga diubah menjadi vektor embedding, lalu dicari potongan dokumen dengan vektor PALING MIRIP di vector database (persis teknik semantic search dari Tahap 13).
Langkah 3 — Augmentation: potongan-potongan dokumen paling relevan yang ditemukan tadi 'disisipkan' ke dalam prompt yang dikirim ke LLM, sebagai konteks tambahan.
Langkah 4 — Generation: LLM (GPT, Claude, Gemini, Grok, atau model lain) menghasilkan jawaban berdasarkan PERTANYAAN pengguna DITAMBAH potongan dokumen relevan yang baru saja ditemukan — bukan hanya mengandalkan 'ingatan' dari pelatihan.
3. Studi Kasus: Chatbot Internal Perusahaan
Bayangkan sebuah perusahaan ingin membuat chatbot yang bisa menjawab pertanyaan karyawan tentang kebijakan cuti terbaru, yang baru diperbarui minggu lalu dan tentu saja TIDAK ada dalam data pelatihan LLM manapun.
Dengan RAG: dokumen kebijakan cuti terbaru diindex ke vector database. Saat karyawan bertanya 'berapa hari cuti melahirkan yang saya dapat?', sistem mencari potongan dokumen kebijakan yang paling relevan dengan pertanyaan itu, menyisipkannya ke prompt, lalu LLM menjawab berdasarkan isi dokumen tersebut — bukan menebak-nebak dari pengetahuan umum yang mungkin sudah usang atau salah.
💡 Analogi
Bayangkan seorang asisten yang sangat pintar tapi baru bekerja dan belum hafal semua aturan perusahaan. Alih-alih menjawab dari ingatan yang mungkin salah/usang, asisten ini punya kebiasaan baik: setiap kali ditanya, ia dulu membuka buku pedoman perusahaan, mencari halaman yang relevan dengan pertanyaan itu, membacanya sekilas, BARU menjawab berdasarkan apa yang baru dibacanya. Itulah persis yang dilakukan RAG — 'membuka buku catatan' sebelum menjawab, alih-alih menjawab murni dari ingatan.
4. Mengapa RAG Penting dan Populer
- Jawaban lebih akurat dan bisa diberi sumber/rujukan (bisa ditunjukkan dokumen mana yang jadi dasar jawaban).
- Tidak perlu melatih ulang (fine-tuning) model yang mahal setiap kali ada dokumen baru — cukup tambahkan dokumen baru ke vector database.
- Bisa dipakai untuk data yang sangat privat/internal tanpa harus mengirim data itu untuk melatih ulang model AI pihak ketiga.
- Banyak produk AI populer memakai pendekatan ini, termasuk fitur 'chat dengan dokumen Anda' di berbagai platform AI, serta fitur pencarian berbasis AI di aplikasi seperti Notion AI, Microsoft Copilot, maupun fitur upload-dokumen di ChatGPT, Claude, dan Gemini.
5. RAG vs Fine-Tuning: Kapan Pakai yang Mana?
RAG cocok ketika informasi sering berubah (kebijakan, berita, dokumen internal yang terus diperbarui) dan Anda ingin jawaban bisa ditelusuri sumbernya. Fine-tuning (akan dibahas lebih detail di Tahap 15) lebih cocok ketika Anda ingin mengubah GAYA atau PERILAKU model secara mendasar, bukan sekadar menambah pengetahuan faktual baru. Dalam praktiknya, banyak sistem AI canggih menggabungkan keduanya.
Diagram & Ilustrasi
Geser ke samping, atau ketuk gambar untuk membukanya dalam ukuran penuh.
Rangkuman Tahap 14
- RAG (Retrieval-Augmented Generation) memungkinkan LLM menjawab berdasarkan dokumen eksternal/terbaru, bukan hanya dari data pelatihan yang sudah 'membeku' di suatu waktu.
- Cara kerjanya: indexing dokumen jadi vector database → saat ada pertanyaan, cari potongan dokumen relevan (retrieval) → sisipkan ke prompt (augmentation) → LLM menjawab berdasarkan itu (generation).
- RAG memanfaatkan langsung konsep embedding dan semantic search dari Tahap 13.
- RAG membantu mengurangi hallucination dan memungkinkan jawaban yang bisa ditelusuri sumbernya, serta dipakai luas di produk AI modern.
- Tahap berikutnya (Tahap 15) membahas Fine-Tuning vs Prompting — dua cara lain menyesuaikan perilaku LLM untuk kebutuhan spesifik.
Istilah Penting
| Istilah | Penjelasan |
|---|---|
| RAG (Retrieval-Augmented Generation) | Teknik yang menggabungkan pencarian dokumen relevan (retrieval) dengan kemampuan menjawab LLM (generation). |
| Vector Database | Basis data khusus yang menyimpan potongan dokumen dalam bentuk vektor embedding agar bisa dicari berdasarkan kemiripan makna. |
| Chunking | Proses memecah dokumen panjang menjadi potongan-potongan kecil sebelum diubah menjadi embedding. |
| Retrieval | Langkah mencari potongan dokumen paling relevan dengan pertanyaan pengguna. |
| Knowledge Cutoff | Batas waktu data pelatihan sebuah LLM; model tidak tahu peristiwa setelah tanggal ini kecuali diberi informasi tambahan (misalnya lewat RAG). |