SERI BELAJAR AI · JILID 2 · TAHAP 13
Embedding & Semantic Search
Mengubah Makna Kata Menjadi Angka yang Bisa Dihitung Komputer
Di Tahap 11 kita sempat menyinggung 'embedding' sebagai langkah mengubah kata menjadi vektor angka sebelum masuk ke proses attention. Tahap 13 ini membahas konsep itu lebih dalam, karena embedding bukan cuma langkah teknis di Transformer — ia adalah fondasi dari banyak fitur AI modern: pencarian berbasis makna (semantic search), sistem rekomendasi, deteksi konten serupa, dan RAG (yang akan dibahas di Tahap 14).
Setelah tahap ini, Anda akan paham kenapa AI bisa tahu bahwa 'mobil' dan 'kendaraan' punya makna yang dekat, atau bahwa 'raja' dikurangi 'pria' ditambah 'wanita' kurang lebih menghasilkan 'ratu' — semua lewat operasi matematika sederhana pada angka.
1. Masalah: Komputer Hanya Mengerti Angka
Komputer tidak benar-benar 'memahami' kata seperti manusia. Supaya AI bisa memproses bahasa, setiap kata (atau potongan kata/token) harus diubah menjadi representasi angka. Cara paling sederhana adalah memberi setiap kata sebuah ID angka unik (misalnya 'kucing'=102, 'anjing'=305). Tapi cara ini punya masalah besar: angka 102 dan 305 tidak menunjukkan bahwa 'kucing' dan 'anjing' itu mirip (sama-sama hewan peliharaan), sementara 'kucing' dan 'meja' yang sama sekali tidak berhubungan mungkin kebetulan punya ID angka yang berdekatan.
2. Solusinya: Embedding — Kata sebagai Titik dalam Ruang Makna
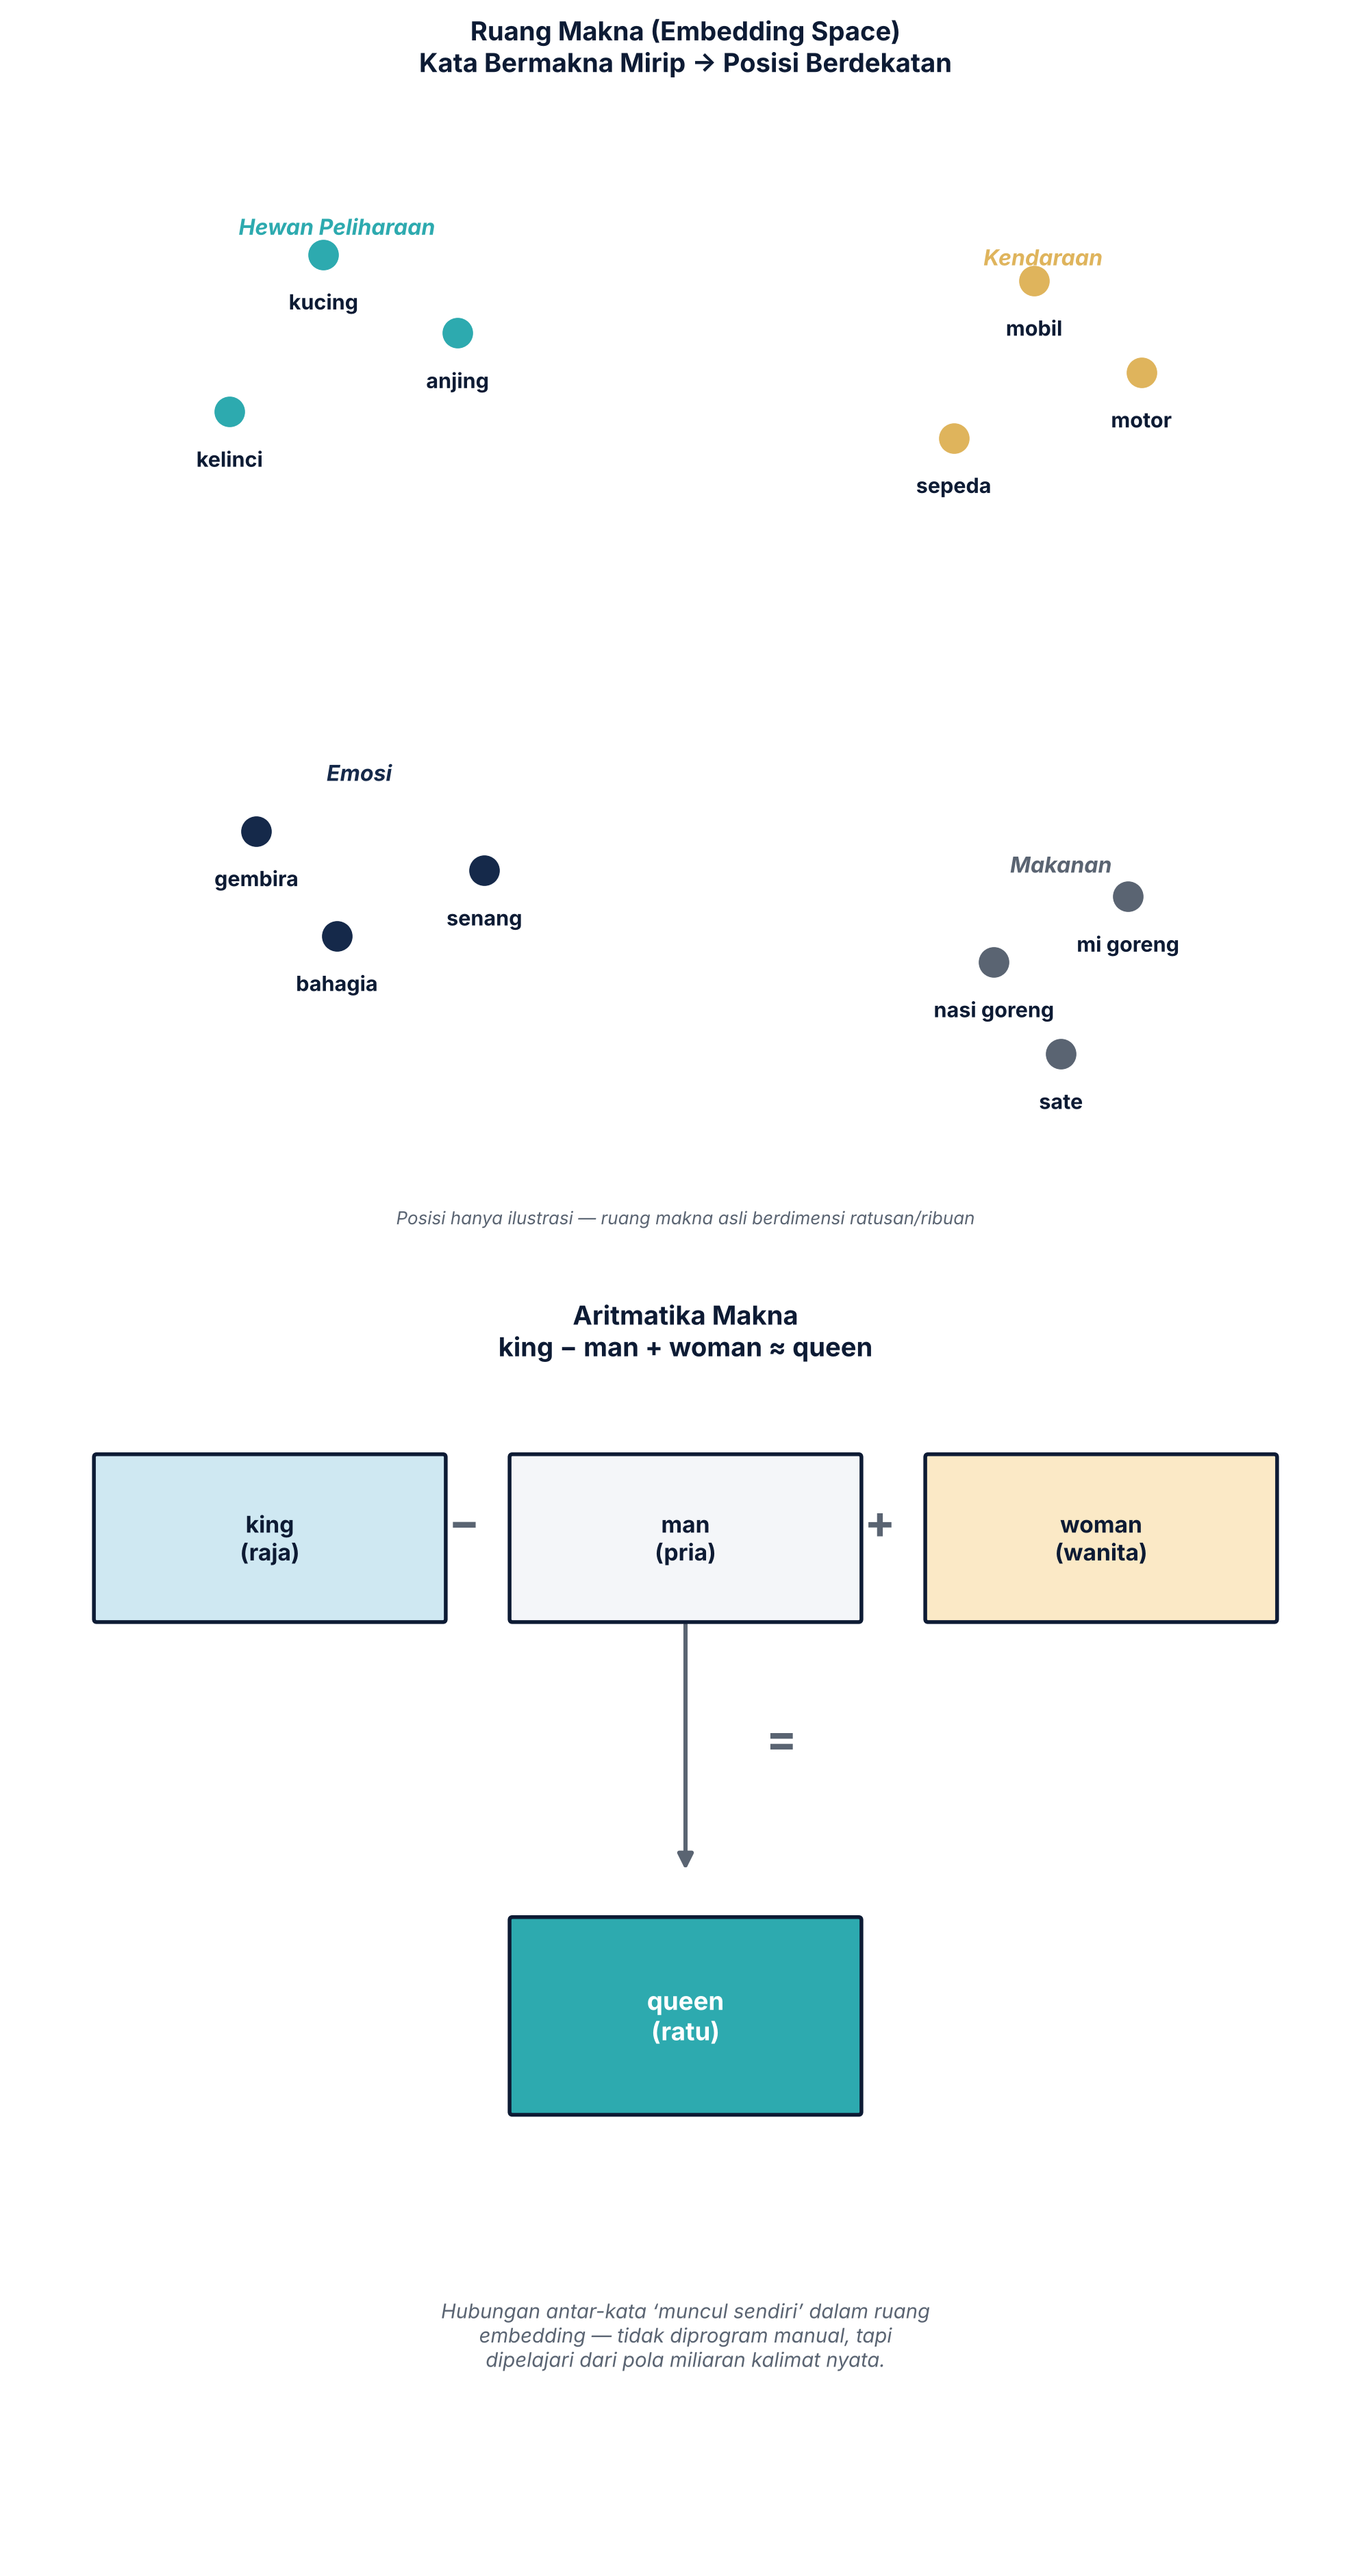
Embedding adalah cara merepresentasikan setiap kata sebagai sebuah vektor — daftar angka (misalnya ratusan hingga ribuan angka desimal) — yang posisinya dalam 'ruang makna' berdimensi tinggi mencerminkan makna kata tersebut. Kata-kata dengan makna mirip akan punya vektor yang 'berdekatan' dalam ruang ini, sementara kata yang maknanya jauh berbeda akan punya vektor yang 'berjauhan'.
Vektor-vektor ini TIDAK diisi manual oleh manusia. Mereka dipelajari otomatis oleh model AI selama proses pelatihan (lihat Tahap 12), berdasarkan pola kata-kata yang sering muncul berdekatan dalam kalimat-kalimat nyata dari data pelatihan.
💡 Analogi
Bayangkan sebuah peta raksasa di mana setiap kata punya satu titik koordinat. Kata 'kucing' dan 'anjing' ditempatkan berdekatan karena sering muncul dalam konteks serupa (hewan peliharaan, makan, bermain). Kata 'mobil' dan 'motor' juga berdekatan satu sama lain, tapi jauh dari 'kucing' dan 'anjing'. Kata 'bahagia' dan 'senang' saling berdekatan di area yang berbeda lagi (emosi). Peta ini tidak digambar manual — ia 'muncul dengan sendirinya' setelah model membaca miliaran kalimat dan belajar kata mana yang sering dipakai dalam konteks yang mirip.
3. Aritmatika Makna: Contoh Klasik King - Man + Woman = Queen
Salah satu penemuan paling terkenal dari embedding adalah bahwa hubungan antar-kata bisa direpresentasikan sebagai operasi matematika sederhana. Jika kita ambil vektor kata 'king' (raja), kurangi dengan vektor 'man' (pria), lalu tambahkan vektor 'woman' (wanita), hasilnya akan sangat dekat dengan vektor kata 'queen' (ratu) — walau tidak ada yang secara eksplisit memprogram hubungan ini. Pola ini 'muncul sendiri' dari cara model belajar dari data bahasa dalam jumlah besar.
Contoh serupa dalam Bahasa Indonesia: vektor 'Jakarta' dikurangi 'Indonesia' ditambah 'Jepang' cenderung menghasilkan vektor yang dekat dengan 'Tokyo' — karena pola hubungan 'ibu kota dari' tertangkap secara konsisten dalam ruang embedding.
4. Mengukur Kedekatan Makna: Cosine Similarity
Untuk mengetahui seberapa 'dekat' makna dua kata atau kalimat, AI menghitung sudut antara dua vektor tersebut dalam ruang berdimensi tinggi — disebut cosine similarity. Semakin kecil sudutnya (semakin searah dua vektor itu), semakin mirip maknanya; nilainya biasanya dinyatakan antara -1 (berlawanan makna) sampai 1 (identik maknanya).
Teknik ini tidak hanya berlaku untuk kata tunggal, tapi juga bisa diperluas untuk KALIMAT UTUH atau bahkan dokumen lengkap, dengan menghasilkan satu vektor yang mewakili makna keseluruhan teks tersebut — inilah dasar dari semantic search.
5. Semantic Search: Mencari Berdasarkan Makna, Bukan Kata Persis
Mesin pencari tradisional (seperti pencarian kata kunci biasa) hanya mencocokkan kata-kata yang PERSIS SAMA. Semantic search berbeda: ia mengubah query pencarian dan semua dokumen yang dicari menjadi vektor embedding, lalu mencari dokumen dengan vektor PALING MIRIP, meski kata-katanya tidak identik.
Contoh: jika Anda mencari 'cara membuat kendaraan roda dua tidak berisik', semantic search bisa menemukan dokumen berjudul 'tips mengurangi suara knalpot motor', meski tidak ada satu kata pun yang sama persis — karena secara MAKNA, kedua kalimat itu sangat berkaitan.
💡 Analogi
Bayangkan pustakawan yang sangat paham isi semua buku di perpustakaan (bukan sekadar hafal judul). Saat Anda bertanya 'buku tentang hewan buas yang hidup berkelompok di savana', pustakawan ini bisa langsung menyodorkan buku berjudul 'Singa: Raja Padang Rumput Afrika', meski tidak ada kata yang sama persis antara pertanyaan Anda dan judul bukunya — karena ia memahami MAKNA, bukan sekadar mencocokkan kata.
Diagram & Ilustrasi
Geser ke samping, atau ketuk gambar untuk membukanya dalam ukuran penuh.
Rangkuman Tahap 13
- Embedding mengubah kata (atau kalimat/dokumen) menjadi vektor angka yang posisinya dalam 'ruang makna' mencerminkan makna sebenarnya — kata bermakna mirip punya vektor berdekatan.
- Vektor ini dipelajari otomatis oleh model dari data, bukan diprogram manual; hubungan antar-kata bahkan bisa diotak-atik lewat operasi matematika sederhana (king - man + woman ≈ queen).
- Cosine similarity dipakai untuk mengukur seberapa dekat makna dua vektor.
- Semantic search memakai embedding untuk mencari berdasarkan MAKNA, bukan hanya kecocokan kata persis — inilah fondasi penting untuk Tahap 14: RAG (Retrieval-Augmented Generation).
Istilah Penting
| Istilah | Penjelasan |
|---|---|
| Embedding | Representasi kata/kalimat/dokumen sebagai vektor angka yang mencerminkan maknanya dalam ruang berdimensi tinggi. |
| Vector Space (Ruang Vektor) | Ruang matematis berdimensi tinggi tempat semua vektor embedding 'ditempatkan' berdasarkan makna. |
| Cosine Similarity | Ukuran kedekatan makna antar dua vektor, berdasarkan sudut di antara keduanya. |
| Semantic Search | Pencarian berbasis makna (bukan hanya kecocokan kata persis), memanfaatkan kedekatan vektor embedding. |
| Nearest Neighbor Search | Teknik mencari vektor-vektor yang paling dekat/mirip dengan vektor query dalam suatu kumpulan data besar. |