SERI BELAJAR AI · JILID 2 · TAHAP 12
Bagaimana LLM Dilatih: Next-Token Prediction & Training
Dari Teks Mentah sampai Menjadi Model yang Bisa Diajak Bicara
Di Tahap 11, kita belajar arsitektur Transformer dan attention mechanism — 'mesin' yang dipakai ChatGPT, Claude, Gemini, Grok, dan LLaMA untuk memproses teks. Tapi mesin itu, sebelum dilatih, hanyalah kumpulan angka acak yang tidak tahu apa-apa tentang bahasa.
Tahap 12 ini menjawab pertanyaan besar berikutnya: bagaimana caranya kumpulan angka acak itu bisa berubah menjadi model yang bisa menulis esai, menjawab pertanyaan, bahkan menulis kode program? Jawabannya ada pada proses training (pelatihan), yang intinya sangat sederhana walau dijalankan dalam skala sangat besar: menebak kata berikutnya, berulang kali, miliaran kali.
1. Tugas Sederhana di Balik Semua Kecerdasan: Next-Token Prediction
Inti pelatihan LLM (Large Language Model) ternyata sangat sederhana: model diberi potongan teks, lalu diminta menebak satu kata/token berikutnya. Itu saja. Model GPT di balik ChatGPT, Claude, Gemini, Grok, dan LLaMA semuanya dilatih dengan tugas dasar yang sama ini, hanya berbeda pada data, skala, dan detail teknik pelatihan masing-masing perusahaan.
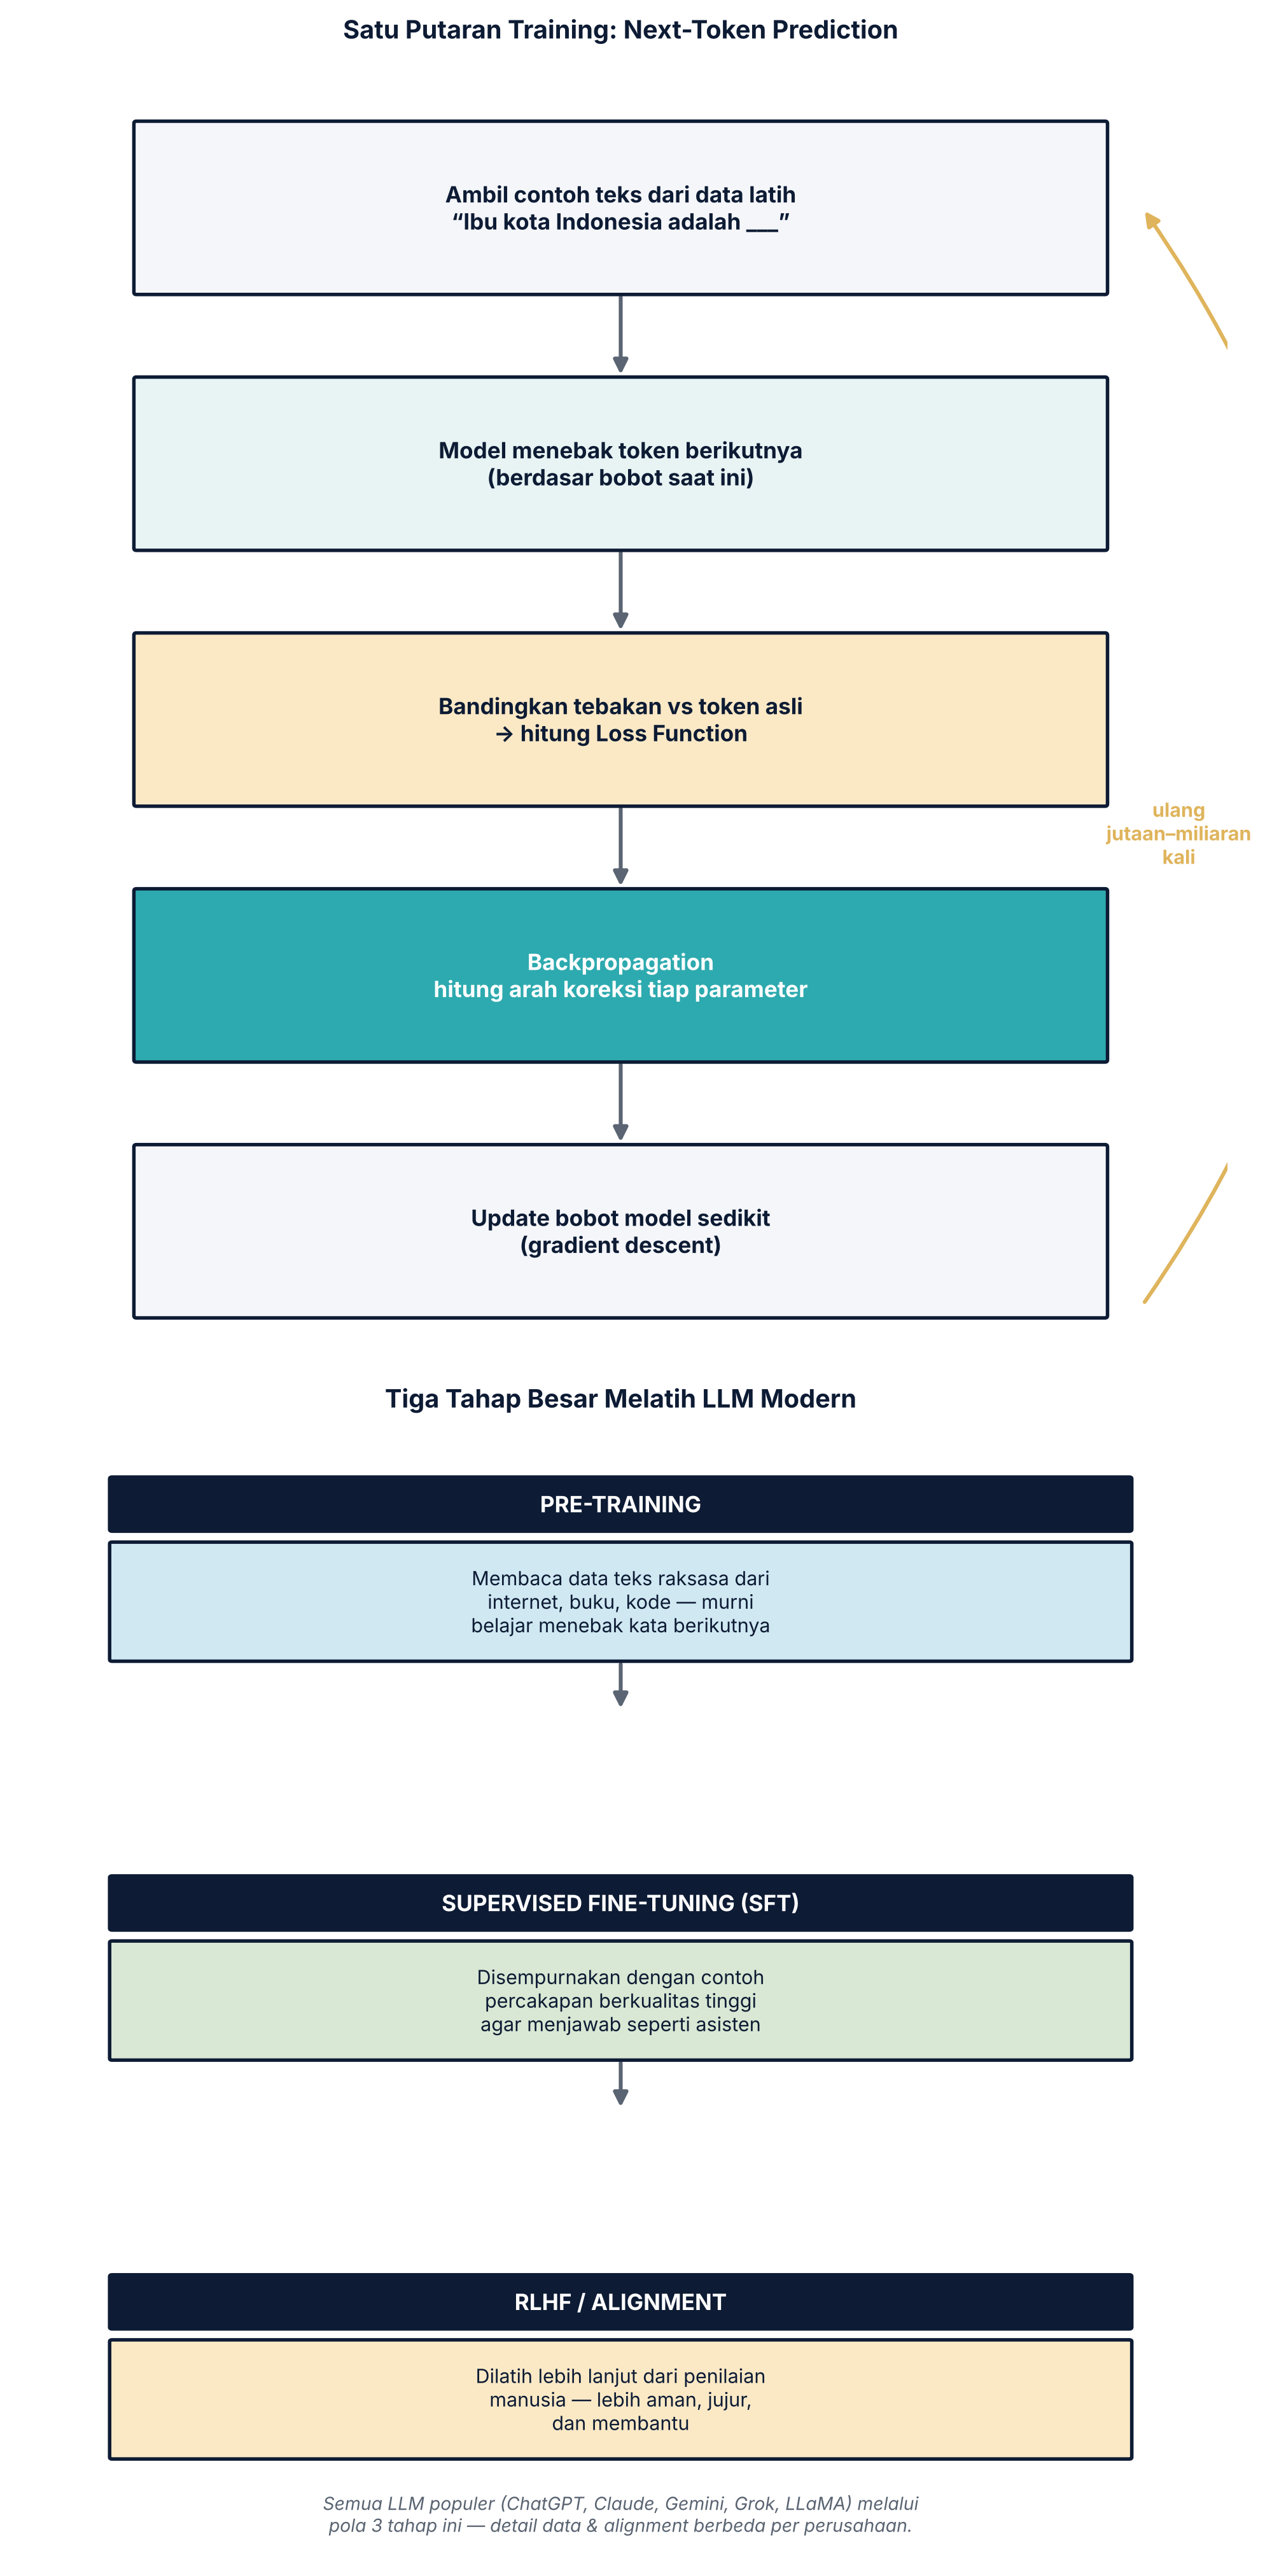
Misalnya, model diberi teks 'Ibu kota Indonesia adalah', lalu diminta menebak kata berikutnya. Di awal pelatihan (saat bobot/weight modelnya masih acak), tebakannya akan sangat buruk — bisa jadi menebak kata acak yang tidak nyambung sama sekali. Tapi setelah dikoreksi jutaan-miliaran kali, model mulai belajar pola bahasa, fakta dunia, bahkan cara bernalar sederhana — semua muncul sebagai 'efek samping' dari tugas menebak kata berikutnya yang dilakukan dalam skala sangat besar.
💡 Analogi
Bayangkan permainan tebak kata: teman Anda membacakan awal kalimat lalu berhenti, dan Anda harus menebak kata selanjutnya. Mula-mula tebakan Anda ngawur. Tapi setelah bermain ribuan kali dengan banyak kalimat berbeda, Anda mulai menangkap pola — tata bahasa, kebiasaan susunan kata, bahkan fakta umum (karena kalimat 'Ibu kota Indonesia adalah ___' hampir selalu diikuti 'Jakarta'). LLM belajar dengan cara yang serupa, hanya dengan skala data dan pengulangan yang jauh lebih besar daripada yang bisa dilakukan manusia.
2. Loss Function: Cara Model Tahu Dia Salah
Supaya model bisa 'belajar dari kesalahan', dibutuhkan cara untuk mengukur seberapa jauh tebakannya dari jawaban yang benar. Ukuran ini disebut loss function (fungsi kerugian/kesalahan).
Setiap kali model menebak token berikutnya, hasil tebakannya (berupa daftar probabilitas untuk setiap kemungkinan token) dibandingkan dengan token yang SEBENARNYA muncul di data latih. Semakin jauh tebakan dari jawaban sebenarnya, semakin besar nilai loss-nya. Tujuan pelatihan adalah membuat nilai loss ini sekecil mungkin, secara bertahap, lewat jutaan contoh.
3. Backpropagation: Cara Model Memperbaiki Diri
Setelah nilai loss dihitung, model perlu tahu bagian mana dari dirinya (dari miliaran parameter/bobot internal) yang harus disesuaikan, dan seberapa besar penyesuaiannya, agar tebakan berikutnya lebih baik. Proses ini disebut backpropagation, dipasangkan dengan teknik optimisasi (umumnya disebut gradient descent) yang menentukan arah dan besaran penyesuaian setiap bobot.
Proses ini diulang untuk SETIAP contoh teks dalam data latih, satu per satu (atau dalam kelompok kecil disebut batch), jutaan sampai miliaran kali. Setiap putaran, model menjadi sedikit lebih baik dalam menebak kata berikutnya.
💡 Analogi
Bayangkan Anda belajar melempar panah ke papan target sambil ditutup matanya, hanya mendapat info 'terlalu ke kiri' atau 'terlalu ke kanan' setiap lemparan. Awalnya lemparan Anda berantakan, tapi dengan ribuan percobaan dan koreksi kecil setiap kali, tangan Anda perlahan 'terlatih' untuk melempar lebih akurat. Backpropagation adalah mekanisme matematis yang memberi tahu model 'koreksi' semacam itu untuk setiap bagian dirinya, setiap kali menebak salah.
4. Tiga Tahap Besar Melatih LLM Modern
- Pre-training: tahap pelatihan awal dan terbesar, model 'membaca' data teks dalam jumlah raksasa dari internet, buku, artikel, kode program, dan sumber lain, murni belajar menebak kata berikutnya. Tahap ini paling mahal secara komputasi dan memakan waktu berminggu-minggu bahkan berbulan-bulan dengan ribuan chip pemroses (GPU/TPU).
- Fine-tuning / Supervised Fine-Tuning (SFT): model hasil pre-training 'disempurnakan' dengan contoh percakapan berkualitas tinggi yang ditulis/dikurasi manusia, agar model belajar menjawab seperti asisten yang membantu, bukan sekadar menyambung teks.
- RLHF (Reinforcement Learning from Human Feedback) / alignment: manusia memberi penilaian terhadap berbagai jawaban model, dan model dilatih lebih lanjut untuk menghasilkan jawaban yang lebih disukai manusia — lebih aman, lebih membantu, lebih jujur. Setiap perusahaan (OpenAI untuk ChatGPT, Anthropic untuk Claude, Google untuk Gemini, xAI untuk Grok, Meta untuk LLaMA) punya pendekatan dan penekanan nilai yang sedikit berbeda di tahap ini, yang sebagian menjelaskan mengapa 'kepribadian' tiap model terasa berbeda walau fondasi arsitekturnya serupa.
5. Mengapa Butuh Data dan Komputasi Sebesar Itu
Model bahasa modern punya miliaran hingga triliunan parameter (bobot internal yang bisa disetel). Untuk menyetel parameter sebanyak itu secara bermakna, dibutuhkan data pelatihan dalam jumlah sangat besar (triliunan kata) dan daya komputasi masif (ribuan chip khusus AI yang bekerja selama berminggu-minggu).
Inilah salah satu alasan mengapa hanya segelintir perusahaan besar (OpenAI, Anthropic, Google, xAI, Meta, dan beberapa lainnya) yang mampu melatih model fondasi (foundation model) dari nol — biayanya bisa mencapai puluhan hingga ratusan juta dolar untuk satu model besar.
6. Studi Kasus: Dari Teks Acak ke Jawaban yang Masuk Akal
Bayangkan proses pelatihan dalam tiga 'snapshot' waktu. Di awal pelatihan (0% progres), jika diberi 'Resep membuat nasi goreng:', model mungkin menghasilkan teks acak tak bermakna karena bobotnya masih random. Di tengah pelatihan (pre-training sebagian selesai), model mulai menghasilkan kalimat yang tata bahasanya benar tapi isinya kadang tidak akurat atau tidak relevan. Setelah pre-training selesai dan melalui fine-tuning serta alignment, model mampu menghasilkan resep nasi goreng yang masuk akal, terstruktur, dan relevan dengan permintaan.
Perjalanan dari 'teks acak' ke 'jawaban yang membantu' inilah yang dilalui semua LLM besar saat ini, termasuk ChatGPT, Claude, Gemini, Grok, dan LLaMA — dengan detail data dan teknik alignment yang berbeda-beda di tiap perusahaan, menghasilkan karakter jawaban yang sedikit berbeda pula.
Diagram & Ilustrasi
Geser ke samping, atau ketuk gambar untuk membukanya dalam ukuran penuh.
Rangkuman Tahap 12
- Inti pelatihan LLM adalah tugas sederhana: menebak token/kata berikutnya, diulang dalam skala sangat besar.
- Loss function mengukur seberapa salah tebakan model; backpropagation menyesuaikan bobot internal model agar tebakan berikutnya lebih baik.
- Pelatihan LLM modern umumnya melalui tiga tahap besar: pre-training (belajar bahasa dari data raksasa), fine-tuning/SFT (belajar menjadi asisten), dan RLHF/alignment (belajar menjawab sesuai preferensi manusia).
- ChatGPT, Claude, Gemini, Grok, dan LLaMA semuanya melalui proses serupa, namun detail data dan teknik alignment masing-masing perusahaan berbeda — inilah salah satu sumber perbedaan 'karakter' tiap model.
- Tahap berikutnya (Tahap 13) akan membahas embedding — bagaimana makna kata direpresentasikan sebagai angka/vektor, fondasi dari semantic search dan RAG.
Istilah Penting
| Istilah | Penjelasan |
|---|---|
| Next-Token Prediction | Tugas dasar pelatihan LLM: menebak token/kata berikutnya berdasarkan konteks sebelumnya. |
| Loss Function | Ukuran matematis seberapa jauh tebakan model dari jawaban yang benar; semakin kecil, semakin baik. |
| Backpropagation | Proses menghitung dan menyebarkan 'koreksi' ke seluruh parameter model agar tebakan berikutnya lebih akurat. |
| Pre-training | Tahap pelatihan awal dan terbesar, model belajar bahasa dari data teks dalam jumlah masif. |
| Fine-tuning / SFT | Penyempurnaan model hasil pre-training dengan contoh percakapan berkualitas tinggi agar menjadi asisten yang membantu. |
| RLHF | Reinforcement Learning from Human Feedback — melatih model lebih lanjut berdasarkan penilaian manusia terhadap kualitas jawaban. |
| Parameter | Bobot internal model yang disesuaikan selama pelatihan; model besar punya miliaran hingga triliunan parameter. |