SERI BELAJAR AI · JILID 2 · TAHAP 11
Arsitektur Transformer & Attention Mechanism
Bagaimana AI Benar-Benar ‘Membaca’ dan Memahami Teks
Di Jilid 1 (Tahap 1 sampai 10), kita sudah belajar dasar-dasar AI: apa itu kecerdasan buatan, perbedaan pendekatan symbolic vs connectionist, cara kerja machine learning, neural network sederhana, sampai mengenal beberapa model AI besar yang ada saat ini seperti ChatGPT (OpenAI), Claude (Anthropic), Gemini (Google), Grok (xAI), dan LLaMA (Meta).
Sekarang kita masuk ke Jilid 2: AI Generatif & LLM Lanjutan. Tahap 11 ini adalah fondasi paling penting dalam seluruh jilid ini, karena hampir SEMUA chatbot AI modern yang Anda kenal — ChatGPT, Claude, Gemini, Grok, Copilot, LLaMA, Mistral, DeepSeek, dan lainnya — dibangun di atas satu arsitektur yang sama: Transformer, dengan jantungnya bernama attention mechanism.
Setelah memahami tahap ini, Anda akan tahu kenapa AI bisa menjawab pertanyaan panjang dengan tetap 'nyambung' ke konteks di awal kalimat, dan kenapa semua model besar sekarang punya cara kerja dasar yang mirip walaupun dibuat perusahaan berbeda-beda.
1. Masalah yang Ingin Dipecahkan
Sebelum tahun 2017, AI pemrosesan bahasa (menerjemahkan, merangkum, menjawab pertanyaan) umumnya memakai arsitektur bernama RNN atau LSTM. Cara kerjanya: AI membaca kalimat KATA DEMI KATA secara berurutan, sambil mencoba menyimpan 'ingatan' tentang kata-kata sebelumnya dalam sebuah memori yang terbatas.
Masalahnya ada dua. Pertama, prosesnya lambat karena harus dikerjakan satu per satu secara berurutan, tidak bisa disebar/diparalelkan ke banyak prosesor sekaligus. Kedua, dan ini yang lebih krusial, AI sering 'lupa' konteks penting dari awal kalimat kalau kalimatnya panjang — mirip memori jangka pendek yang penuh.
💡 Analogi
Bayangkan Anda menerjemahkan surat panjang dengan cara membaca SATU kata, menerjemahkannya, lalu lanjut ke kata berikutnya sambil mengandalkan catatan kecil yang mudah penuh untuk mengingat konteks sebelumnya. Begitu suratnya panjang, Anda mulai salah paham konteks di bagian akhir karena 'catatan' Anda sudah kelebihan muatan. Inilah persis masalah yang dihadapi AI generasi sebelum Transformer.
2. Lahirnya Transformer: Baca Semua Kata Sekaligus
Pada tahun 2017, tim peneliti Google merilis makalah berjudul 'Attention Is All You Need', yang memperkenalkan arsitektur Transformer. Idenya radikal: daripada membaca kalimat kata demi kata secara berurutan, kenapa tidak membaca SEMUA kata sekaligus secara paralel, lalu membiarkan AI sendiri yang memutuskan kata mana yang paling penting untuk dipahami bersama kata lainnya?
Mekanisme yang memungkinkan AI 'memutuskan kata mana yang penting' inilah yang disebut attention mechanism — inti dari segala inovasi yang mengikutinya, termasuk seluruh keluarga model GPT (OpenAI/ChatGPT), Claude (Anthropic), Gemini (Google), Grok (xAI), dan LLaMA (Meta).
3. Attention Mechanism: Inti dari Segalanya
Attention adalah cara AI memberi 'bobot perhatian' berbeda-beda ke setiap kata lain dalam kalimat, tergantung seberapa relevan kata itu untuk memahami makna kata yang sedang diproses.
Contoh sederhana: perhatikan dua kalimat ini — 'Budi pergi ke bank untuk mengambil uang' dan 'Budi duduk di bank taman sambil membaca buku'. Kata 'bank' di kedua kalimat itu sama persis secara tulisan, tapi maknanya berbeda total. Manusia tahu bedanya karena secara otomatis 'memperhatikan' kata-kata di sekitarnya — 'uang' di kalimat pertama, 'taman' di kalimat kedua. Attention mechanism membuat AI melakukan hal yang sama: memberi bobot perhatian tinggi ke kata-kata kunci itu untuk menentukan makna yang tepat.
4. Cara Kerja Teknis: Query, Key, dan Value (QKV)
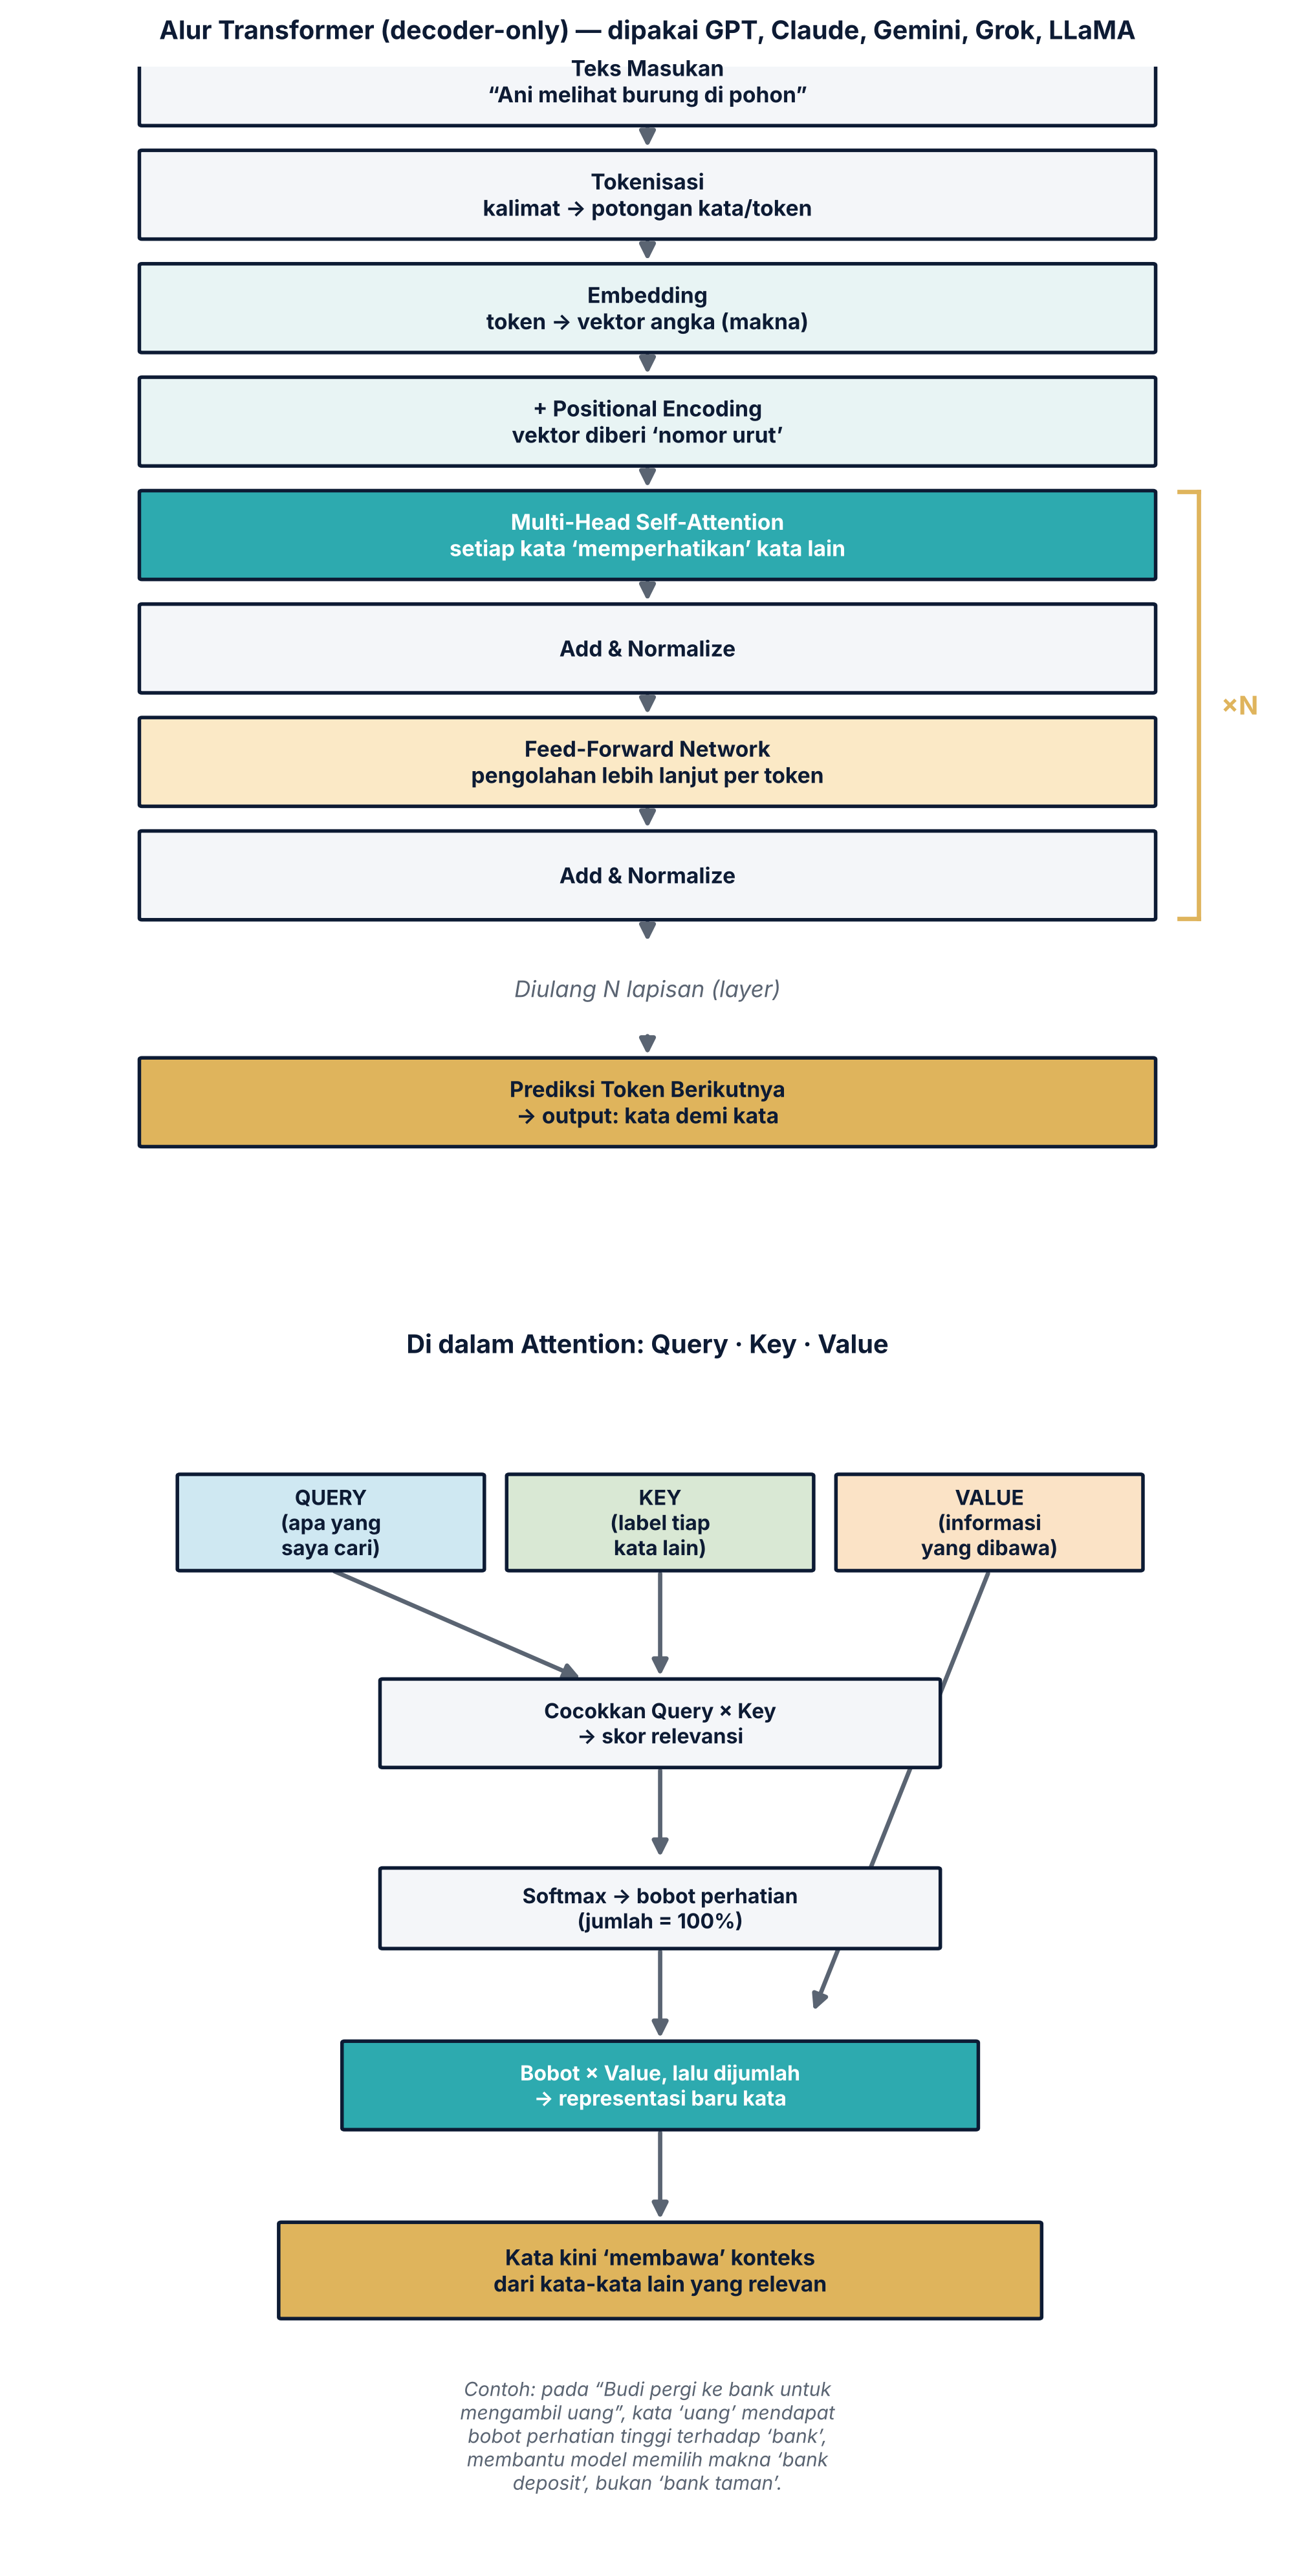
Secara teknis (disederhanakan), setiap kata diubah menjadi representasi angka (disebut vector/embedding), dan dari vector itu dibentuk tiga peran berbeda: Query (Q), Key (K), dan Value (V).
Query adalah 'pertanyaan' yang dibawa sebuah kata: 'informasi apa yang saya butuhkan dari kata-kata lain?' Key adalah semacam 'label' yang ditawarkan tiap kata lain: 'ini informasi yang saya punya.' Value adalah isi/informasi sebenarnya yang dibawa kata tersebut.
AI mencocokkan Query suatu kata dengan Key semua kata lain untuk menghasilkan skor relevansi. Skor ini diubah menjadi bobot perhatian (lewat fungsi matematika bernama softmax, yang membuat semua bobot berjumlah 100%). Bobot ini kemudian dikalikan dengan Value masing-masing kata dan dijumlahkan — hasilnya adalah representasi baru dari kata tersebut yang sudah 'membawa konteks' dari kata-kata lain yang relevan.
💡 Analogi: Mencari Buku di Perpustakaan
Bayangkan Anda masuk perpustakaan membawa pertanyaan di kepala (Query): 'saya butuh resep nasi goreng'. Di setiap rak ada label (Key) yang menjelaskan isi rak itu. Anda mencocokkan pertanyaan Anda dengan label di setiap rak — rak 'Buku Masakan' cocok sekali, rak 'Novel Fiksi' tidak cocok. Semakin cocok label suatu rak dengan pertanyaan Anda, semakin besar perhatian yang Anda berikan ke rak itu, dan semakin banyak isi buku (Value) dari rak itu yang Anda pakai. Itulah persis cara kerja attention: mencocokkan 'apa yang dicari' dengan 'label yang tersedia', lalu mengambil 'isi' sesuai tingkat kecocokannya.
5. Self-Attention dan Multi-Head Attention
Disebut self-attention karena kata-kata dalam SATU kalimat yang sama saling 'memperhatikan' satu sama lain (bukan membandingkan dengan kalimat lain).
Dalam praktiknya, Transformer tidak menjalankan proses attention hanya sekali, tapi berkali-kali secara paralel dengan 'sudut pandang' berbeda-beda — ini disebut multi-head attention. Satu 'head' mungkin fokus menangkap hubungan subjek-predikat, head lain fokus menangkap hubungan kata yang berjauhan letaknya, head lain lagi menangkap nada/emosi kalimat. Semua hasil dari head-head ini kemudian digabungkan menjadi satu pemahaman yang lebih kaya.
💡 Analogi
Bayangkan satu kalimat dibaca bersamaan oleh beberapa ahli berbeda: satu ahli tata bahasa, satu ahli makna, satu ahli nada bicara. Masing-masing fokus ke aspek yang berbeda dari kalimat yang sama, lalu catatan mereka digabung jadi satu pemahaman utuh. Itulah multi-head attention.
6. Positional Encoding: Supaya AI Tahu Urutan Kata
Karena Transformer membaca semua kata SEKALIGUS (bukan satu-satu seperti RNN), ada risiko AI kehilangan informasi tentang urutan kata. Padahal urutan sangat menentukan makna: 'Budi memukul Andi' artinya sangat berbeda dengan 'Andi memukul Budi', walau kata-katanya persis sama.
Solusinya disebut positional encoding: semacam 'nomor urut' matematis yang ditambahkan ke representasi setiap kata, sehingga AI tetap tahu kata mana yang muncul lebih dulu, di tengah, atau di akhir kalimat — meski semua kata diproses secara paralel.
7. Dari Transformer ke LLM Modern: Decoder-Only
Transformer versi asli (2017) punya dua bagian: Encoder (bertugas memahami input) dan Decoder (bertugas menghasilkan output) — cocok untuk tugas seperti penerjemahan bahasa.
Namun hampir semua LLM (Large Language Model) populer saat ini — GPT di balik ChatGPT, Claude dari Anthropic, Gemini dari Google, Grok dari xAI, maupun LLaMA dari Meta — hanya memakai bagian Decoder saja, disebut arsitektur decoder-only. Model ini dilatih dengan tugas sederhana namun sangat kuat: memprediksi kata/token berikutnya, terus-menerus, satu per satu, berdasarkan semua kata sebelumnya. Mekanisme ini akan dibahas lebih dalam di Tahap 12.
Menariknya, walaupun ChatGPT, Claude, Gemini, Grok, dan LLaMA dibuat oleh perusahaan yang berbeda-beda dengan data dan cara pelatihan yang berbeda, fondasi arsitektur dasarnya — Transformer decoder-only dengan attention mechanism — pada dasarnya sama. Perbedaan performa dan karakter masing-masing model lebih banyak ditentukan oleh ukuran model, kualitas & jumlah data latih, serta teknik fine-tuning/alignment yang dipakai masing-masing perusahaan.
8. Mengapa Transformer Begitu Revolusioner
- Bisa diproses secara paralel (bukan satu per satu) → pelatihan jauh lebih cepat untuk data dalam jumlah sangat besar.
- Attention bisa langsung 'melompat' menghubungkan kata manapun dalam kalimat tanpa kehilangan konteks, walau kalimatnya panjang.
- Arsitektur yang sama bisa diperbesar (scale up) dengan menambah data dan parameter, menghasilkan lompatan kemampuan — inilah yang memicu lahirnya era LLM raksasa seperti sekarang.
- Karena fleksibel, arsitektur ini dipakai lintas perusahaan dan lintas jenis tugas: teks (ChatGPT, Claude, Gemini, Grok), gambar, audio, bahkan video generatif.
9. Studi Kasus Lengkap: Kalimat Ambigu
Perhatikan kalimat: 'Ani melihat burung di pohon dengan teropongnya.' Kalimat ini ambigu — siapa yang membawa teropong? Dua kemungkinan: (a) Ani melihat burung menggunakan teropong miliknya, atau (b) ada burung yang 'membawa' teropong (secara harfiah tidak masuk akal, tapi secara struktur kalimat bisa ditafsirkan begitu).
Saat memproses kalimat ini, mekanisme attention menghitung bobot hubungan antara kata 'teropongnya' dengan semua kata lain di kalimat. Karena model sudah dilatih dari jutaan contoh kalimat nyata, ia 'belajar' pola bahwa kata kerja 'melihat' dengan objek alat optik ('teropong') jauh lebih sering berkaitan dengan SUBJEK (orang yang melakukan aksi melihat) dibanding OBJEK yang dilihat (burung). Maka bobot attention antara 'teropongnya' dan 'Ani'/'melihat' akan jauh lebih besar dibanding bobot ke 'burung'.
Inilah sebabnya AI modern seperti ChatGPT, Claude, Gemini, atau Grok bisa menafsirkan kalimat ambigu dengan cukup akurat — bukan karena ia 'mengerti' seperti manusia, tapi karena attention mechanism-nya telah belajar pola hubungan antar-kata dari data pelatihan dalam jumlah sangat besar.
Diagram & Ilustrasi
Geser ke samping, atau ketuk gambar untuk membukanya dalam ukuran penuh.
Rangkuman Tahap 11
- Transformer (2017) memecahkan masalah AI generasi lama yang membaca kalimat kata demi kata dan mudah 'lupa' konteks panjang.
- Attention mechanism memungkinkan AI membaca semua kata sekaligus dan memberi bobot perhatian berbeda ke tiap kata, berdasarkan konsep Query-Key-Value.
- Multi-head attention menjalankan banyak 'sudut pandang' attention sekaligus; positional encoding menjaga informasi urutan kata.
- Hampir semua LLM populer saat ini — ChatGPT, Claude, Gemini, Grok, LLaMA, dan lainnya — memakai arsitektur Transformer decoder-only dengan fondasi attention yang sama, walau dibuat perusahaan berbeda.
- Tahap berikutnya (Tahap 12) akan membahas bagaimana LLM benar-benar 'dilatih' — next-token prediction, loss function, dan proses training dari awal hingga menjadi model yang bisa diajak bicara.
Istilah Penting
| Istilah | Penjelasan |
|---|---|
| Transformer | Arsitektur neural network yang memproses seluruh urutan data (misalnya kalimat) secara paralel, memakai attention mechanism sebagai inti kerjanya. Diperkenalkan tahun 2017. |
| Attention Mechanism | Mekanisme yang memberi 'bobot perhatian' berbeda ke setiap bagian input, menentukan bagian mana yang paling relevan untuk dipahami bersama. |
| Self-Attention | Attention yang dihitung antar-kata dalam kalimat yang sama. |
| Multi-Head Attention | Menjalankan beberapa proses attention secara paralel dengan 'sudut pandang' berbeda-beda, lalu menggabungkan hasilnya. |
| Query, Key, Value (QKV) | Tiga representasi dari setiap kata yang dipakai untuk menghitung attention: Query = yang dicari, Key = label yang ditawarkan, Value = isi informasi. |
| Positional Encoding | Informasi tambahan yang disisipkan ke representasi kata agar AI tetap tahu urutan kata, walau semua kata diproses secara paralel. |
| Decoder-only | Jenis arsitektur Transformer yang hanya memakai bagian decoder, dilatih untuk memprediksi token berikutnya. Dipakai oleh GPT (ChatGPT), Claude, Gemini, Grok, LLaMA, dan sebagian besar LLM modern. |
| Softmax | Fungsi matematika yang mengubah sekumpulan skor menjadi bobot/probabilitas yang jumlahnya selalu 100%. |