SERI BELAJAR AI · JILID 2 · TAHAP 17
Evaluasi, Hallucination & Keterbatasan LLM
Memahami Kapan dan Mengapa AI Bisa Salah
Jilid 2 ini ditutup dengan topik yang sangat penting bagi siapa pun yang memakai AI sehari-hari: memahami keterbatasan LLM. Setelah mempelajari arsitektur Transformer (Tahap 11), cara LLM dilatih (Tahap 12), embedding dan RAG (Tahap 13-14), serta fine-tuning dan AI generatif multimodal (Tahap 15-16), Tahap 17 ini menutup Jilid 2 dengan topik yang sangat praktis: kapan kita boleh percaya jawaban AI, kapan harus curiga, dan bagaimana cara mengevaluasi keandalannya.
1. Apa Itu Hallucination?
Hallucination (dalam konteks AI) adalah ketika model menghasilkan informasi yang terdengar meyakinkan dan ditulis dengan percaya diri, tapi sebenarnya SALAH atau sepenuhnya dikarang. Ini bukan 'kebohongan' yang disengaja (AI tidak punya niat), melainkan konsekuensi alami dari cara kerja LLM: ingat dari Tahap 12, tugas dasar LLM hanyalah menebak kata berikutnya yang PALING MUNGKIN secara statistik — bukan memverifikasi fakta ke sumber aslinya.
Contoh umum: meminta AI menyebutkan referensi/sumber akademik tentang topik yang sangat spesifik, dan AI 'mengarang' judul paper, nama penulis, bahkan nomor halaman yang terdengar sangat meyakinkan tapi tidak benar-benar ada.
💡 Analogi
Bayangkan seorang murid yang sangat pandai bicara dan punya memori luas, tapi diminta menjawab ujian lisan tanpa boleh membuka buku. Untuk pertanyaan yang ia benar-benar tahu jawabannya, ia akan menjawab akurat. Tapi untuk pertanyaan yang ia TIDAK yakin jawabannya, alih-alih bilang 'saya tidak tahu', ia cenderung menjawab dengan nada percaya diri berdasarkan 'perkiraan terbaik' — kadang benar, kadang terdengar masuk akal tapi sebenarnya salah. LLM punya kecenderungan serupa, karena dilatih untuk selalu menghasilkan jawaban yang 'terdengar lancar', bukan untuk mengakui ketidaktahuan.
2. Mengapa Hallucination Terjadi?
- LLM menghasilkan jawaban berdasarkan pola statistik dari data latih, bukan dengan 'mencari fakta' secara real-time (kecuali dibantu RAG, lihat Tahap 14, atau fitur pencarian web yang terintegrasi).
- Untuk topik yang jarang muncul dalam data latih, atau topik yang sangat spesifik/niche, model punya lebih sedikit 'bukti pola' untuk menebak dengan akurat, sehingga risiko mengarang jawaban meningkat.
- Model dilatih (lewat RLHF, Tahap 12) untuk menghasilkan jawaban yang TERDENGAR membantu dan percaya diri — ini bisa menjadi pedang bermata dua karena mendorong model tetap menjawab dengan yakin walau sebenarnya tidak yakin.
3. Cara Mengurangi Risiko Hallucination
- Gunakan RAG atau fitur pencarian web (jika tersedia) untuk pertanyaan yang butuh fakta terbaru/spesifik, bukan hanya mengandalkan 'ingatan' model.
- Minta AI menyebutkan sumber, lalu verifikasi sumber itu secara independen — jangan percaya begitu saja walau terdengar meyakinkan.
- Untuk topik berisiko tinggi (medis, hukum, keuangan), selalu silang-cek dengan sumber terpercaya atau ahli manusia; jangan jadikan jawaban AI sebagai satu-satunya rujukan.
- Perhatikan bahwa SEMUA LLM populer saat ini — ChatGPT, Claude, Gemini, Grok, LLaMA — sama-sama berisiko mengalami hallucination, walau tingkat dan karakteristiknya bisa berbeda tergantung data latih dan teknik alignment masing-masing.
4. Bias dalam AI
Selain hallucination, LLM juga bisa mewarisi BIAS dari data pelatihannya. Jika data latih (yang sebagian besar berasal dari internet) mengandung pola bias tertentu — stereotip gender, bias budaya, representasi tidak seimbang antar kelompok — model berisiko mereplikasi atau bahkan memperkuat bias tersebut dalam jawabannya, kecuali ditangani secara khusus lewat proses alignment (Tahap 12).
Perusahaan-perusahaan AI besar (OpenAI, Anthropic, Google, xAI, Meta) masing-masing punya tim dan pendekatan khusus untuk mengurangi bias ini, meski tidak ada yang mengklaim modelnya 100% bebas bias.
5. Cara Mengevaluasi Kualitas Jawaban LLM
- Benchmark otomatis: menguji model dengan ribuan soal standar (matematika, coding, pemahaman bacaan, penalaran) dan membandingkan skor akurasinya — dipakai untuk membandingkan GPT, Claude, Gemini, Grok, dan model lain secara objektif pada tugas tertentu.
- Evaluasi manusia (human evaluation): manusia menilai langsung kualitas, keamanan, dan kegunaan jawaban model untuk kasus nyata yang sulit diukur otomatis.
- LLM-as-judge: memakai LLM lain (atau versi model yang lebih besar) untuk menilai kualitas jawaban model lain secara otomatis dalam skala besar — teknik yang makin populer meski punya keterbatasannya sendiri.
- Untuk pengguna sehari-hari, cara paling praktis adalah: selalu berpikir kritis, cross-check untuk hal penting, dan perlakukan AI sebagai 'asisten yang sangat membantu tapi bisa salah' — bukan sumber kebenaran mutlak.
Diagram & Ilustrasi
Geser ke samping, atau ketuk gambar untuk membukanya dalam ukuran penuh.
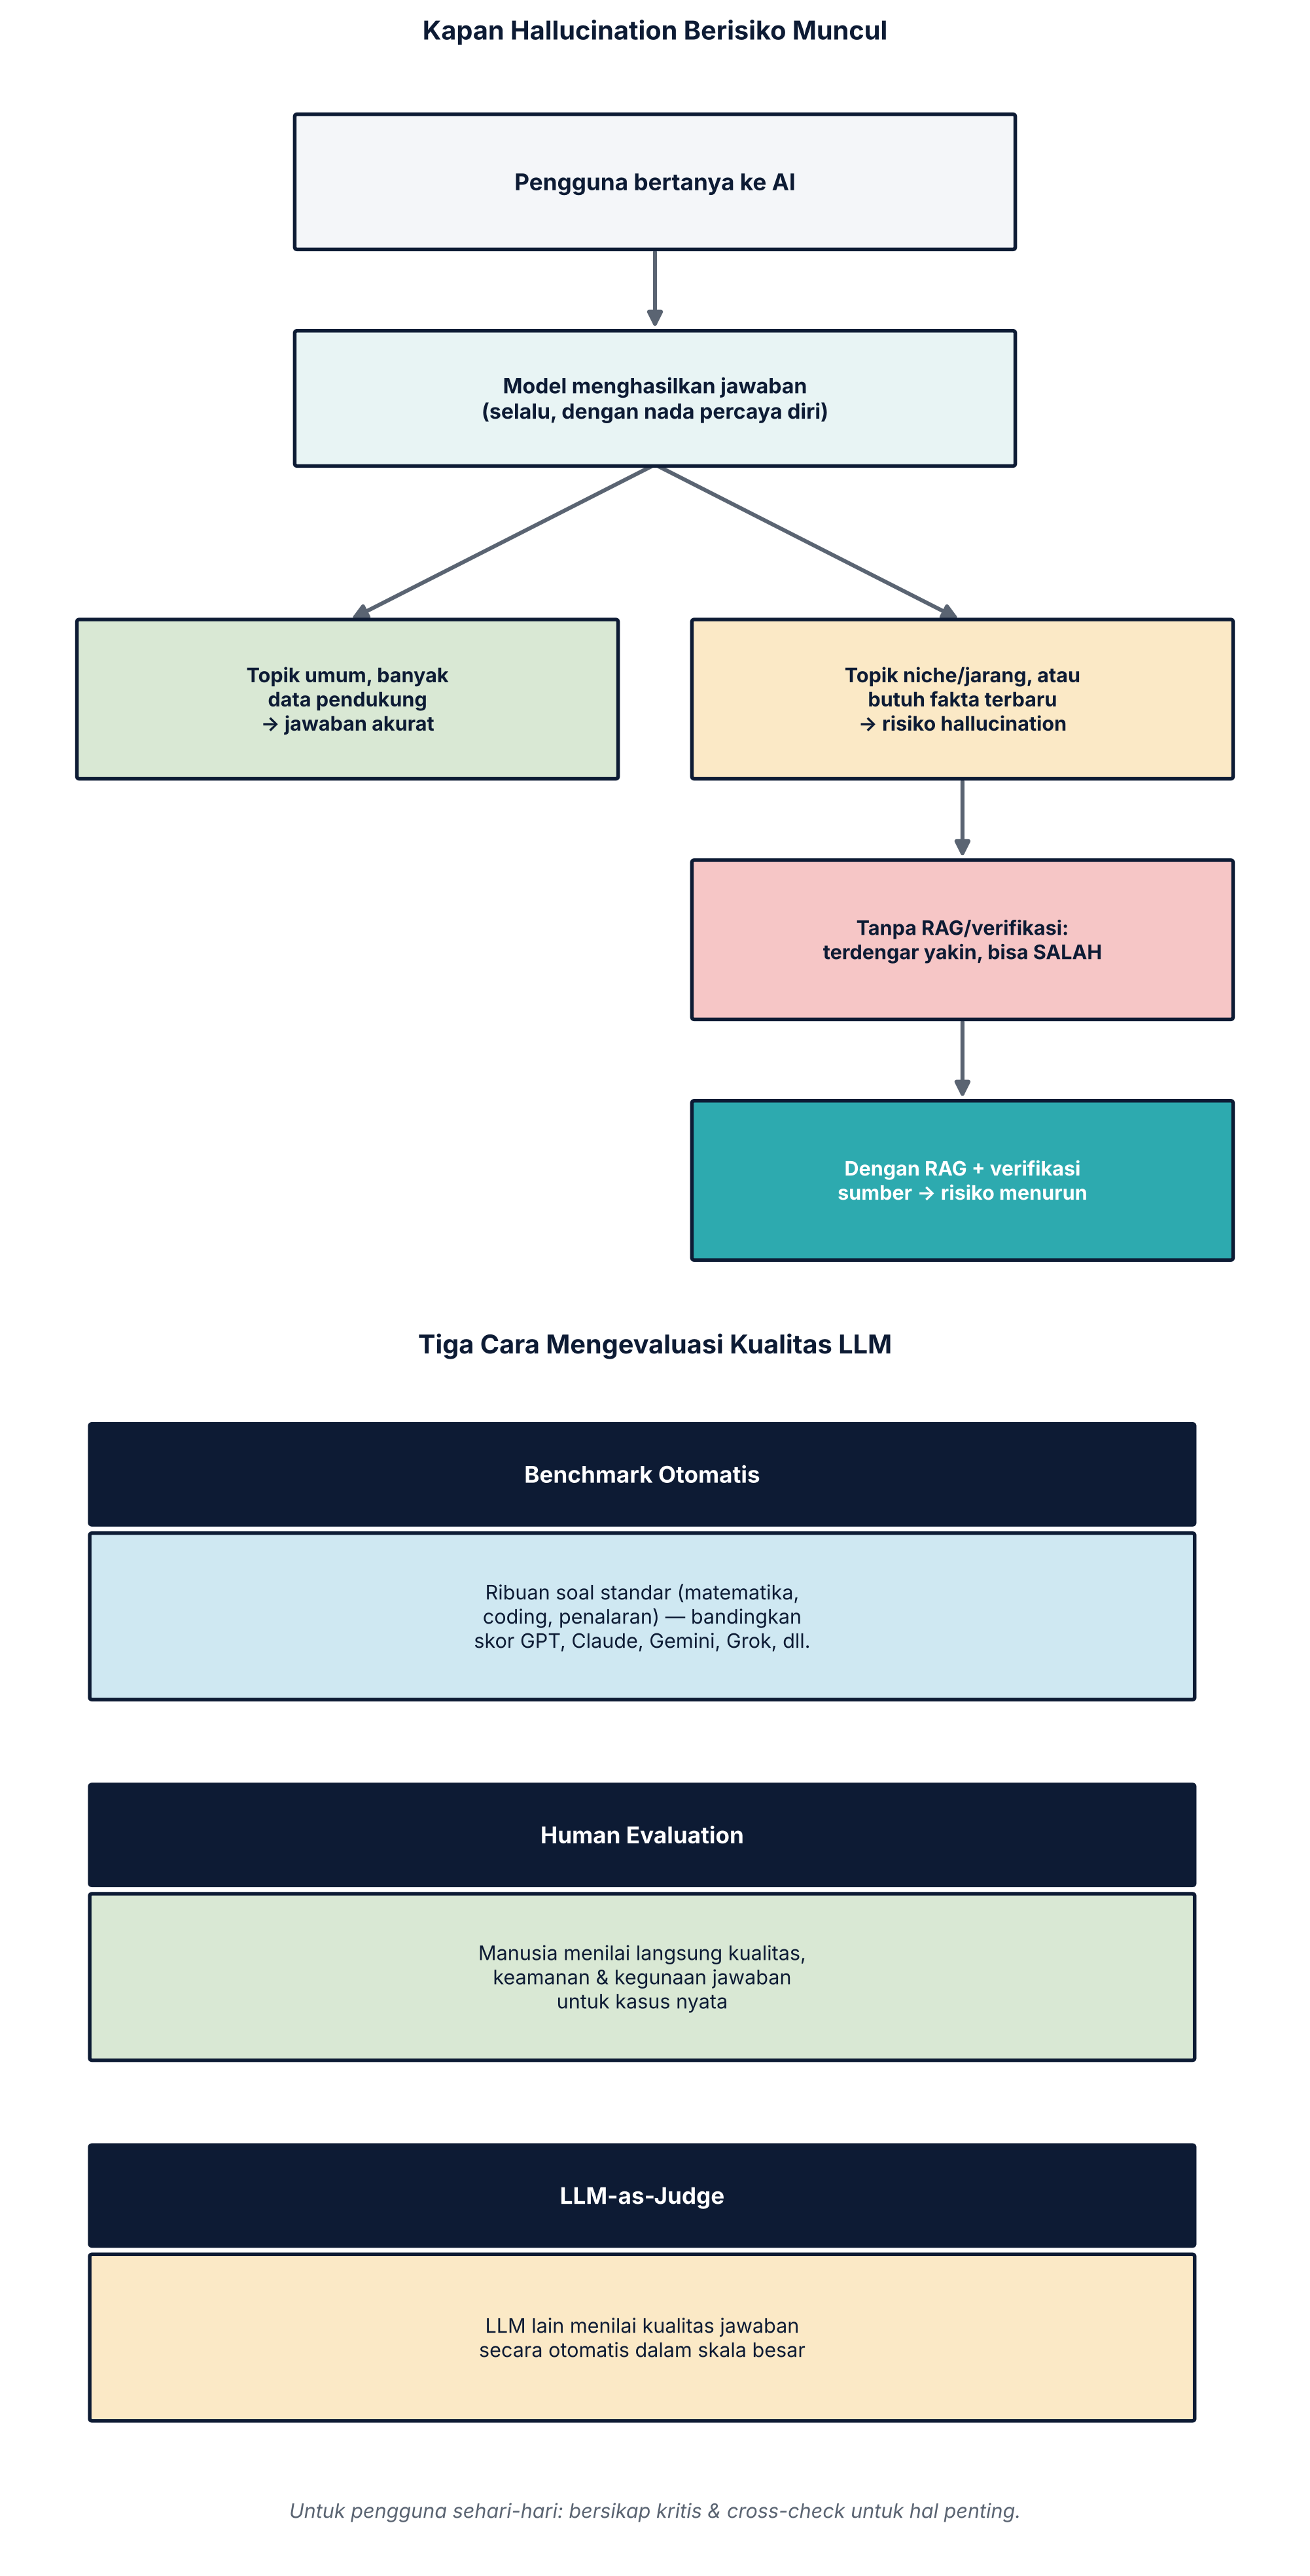
Rangkuman Tahap 17
- Hallucination adalah ketika AI menghasilkan jawaban yang terdengar meyakinkan tapi sebenarnya salah/dikarang — konsekuensi alami dari cara kerja LLM yang menebak pola statistik, bukan mencari fakta.
- Risiko hallucination bisa dikurangi lewat RAG, verifikasi sumber, dan sikap kritis pengguna — berlaku untuk semua LLM besar (ChatGPT, Claude, Gemini, Grok, LLaMA).
- LLM juga bisa mewarisi bias dari data pelatihannya, yang coba ditangani lewat proses alignment meski tidak sepenuhnya hilang.
- Evaluasi kualitas LLM memakai kombinasi benchmark otomatis, evaluasi manusia, dan teknik LLM-as-judge.
- Ini menutup Jilid 2: AI Generatif & LLM Lanjutan — dari arsitektur Transformer (Tahap 11) sampai memahami keterbatasan dan cara mengevaluasi AI secara kritis (Tahap 17).
Istilah Penting
| Istilah | Penjelasan |
|---|---|
| Hallucination | Ketika AI menghasilkan informasi yang terdengar meyakinkan namun sebenarnya salah atau dikarang. |
| Bias | Kecenderungan tidak seimbang/stereotip yang diwarisi model dari pola dalam data pelatihannya. |
| Benchmark | Kumpulan soal/tugas standar untuk mengukur dan membandingkan kemampuan model AI secara objektif. |
| Human Evaluation | Penilaian kualitas jawaban AI secara langsung oleh manusia, untuk aspek yang sulit diukur otomatis. |
| LLM-as-Judge | Teknik menggunakan satu model AI untuk menilai kualitas jawaban model AI lain secara otomatis dalam skala besar. |