BAB 3
Apa itu Large Language Model (LLM)?
Sejarah, dasar logika, proses training, dan studi kasus mudah
3.1 Sejarah Singkat: dari Model Bahasa Sederhana ke LLM
Model bahasa awalnya sangat sederhana — model n-gram, yang hanya menghitung “kata apa yang paling sering muncul setelah kata ini”. Lalu muncul RNN/LSTM (1990an–2010an) yang memproses kata berurutan tapi lambat dan gampang “lupa” konteks panjang.
Titik baliknya: Transformer (2017) memungkinkan model memproses seluruh kalimat sekaligus lewat self-attention. Dari situ lahir generasi LLM modern: GPT-1 dan BERT (2018), GPT-2 (2019) yang mulai menulis paragraf koheren, GPT-3 (2020) yang mengejutkan dunia dengan “few-shot learning”, lalu ChatGPT (November 2022) yang memopulerkan teknik RLHF. Anthropic lahir 2021 dari mantan peneliti OpenAI yang fokus membuat LLM lebih aman, melahirkan Claude.
3.2 Dasar Logika: Bagaimana LLM Sebenarnya “Menulis” Kalimat
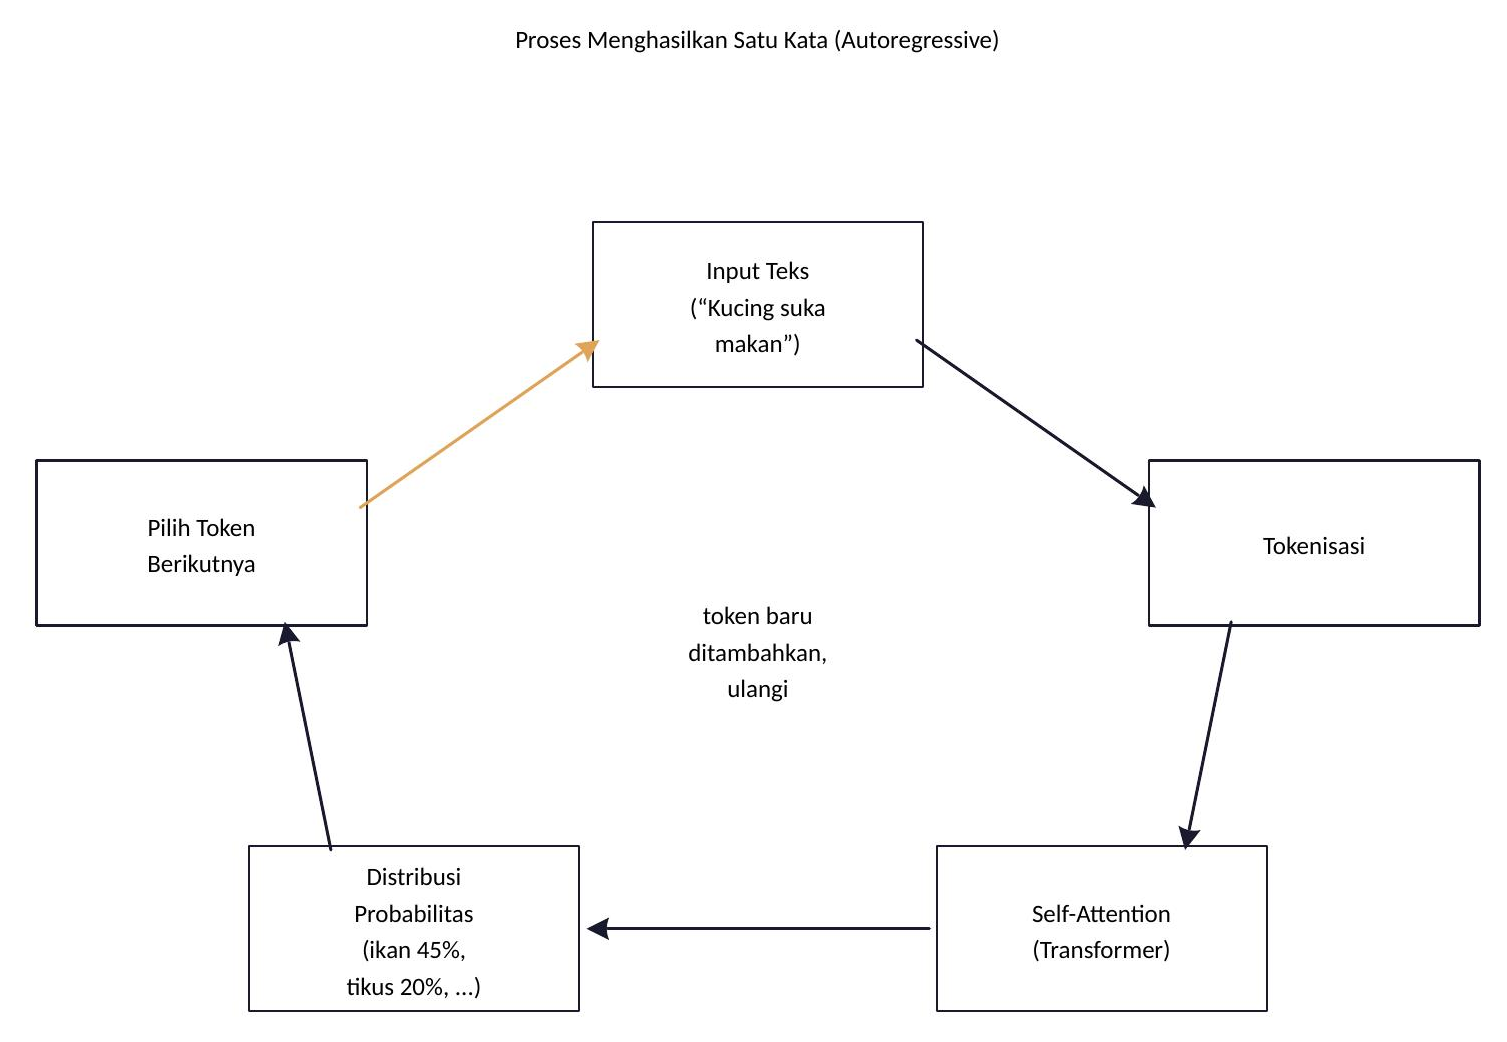
LLM tidak “berpikir” jawaban lengkap sekaligus. Ia bekerja secara autoregresif — menebak satu token berikutnya, lalu token itu ditambahkan kembali ke input, lalu menebak lagi, diulang sampai jawaban selesai: (1) Tokenisasi, (2) Embedding, (3) Self-Attention, (4) distribusi probabilitas token berikutnya, (5) token dipilih (tergantung “temperature”), (6) token ditambahkan ke input, ulangi.
3.3 Studi Kasus Mudah: Melengkapi Kalimat “Kucing suka makan ___”
Bayangkan Anda mengetik “Kucing suka makan” ke Claude. Di balik layar, model menghitung distribusi probabilitas kira-kira begini: “ikan” 45%, “tikus” 20%, “daging” 15%, “rumput” 2%. Model memilih “ikan” (paling mungkin), menambahkannya jadi “Kucing suka makan ikan”, lalu mengulang proses untuk menebak kata berikutnya lagi.
Ini persis kenapa LLM kadang terasa “mengarang” hal yang salah (halusinasi) — ia tidak mengecek fakta, ia hanya memilih kata yang secara statistik paling masuk akal.
3.4 Bagaimana LLM Dilatih Jadi Asisten yang Membantu
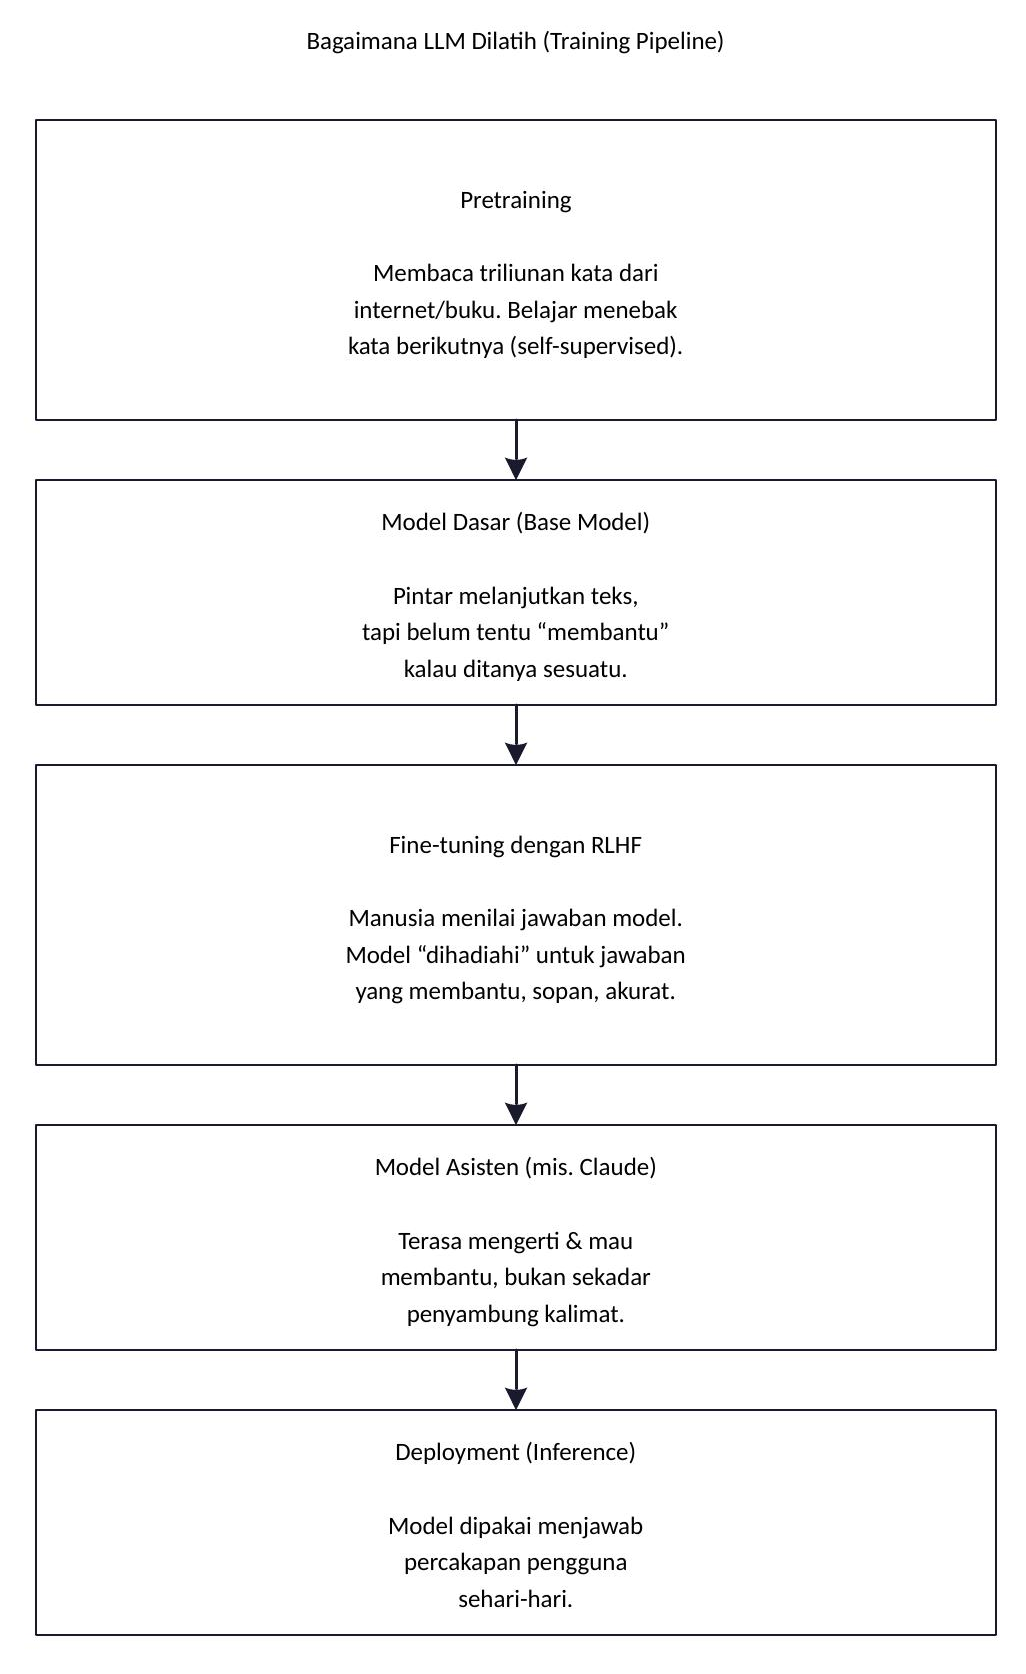
LLM melewati dua tahap besar: Pretraining — model membaca triliunan kata dari internet/buku, hanya belajar menebak kata berikutnya. Hasilnya model yang pintar melanjutkan teks, tapi belum tentu “membantu”.
Fine-tuning dengan RLHF (Reinforcement Learning from Human Feedback) — manusia menilai berbagai jawaban model, dan model “dihadiahi” untuk menghasilkan jawaban seperti itu. Inilah yang mengubah model dari sekadar “penyambung kalimat pintar” menjadi asisten seperti Claude.
3.5 Istilah Kunci Tambahan
| Istilah | Arti |
|---|---|
| Autoregressive | Cara model menghasilkan teks satu token demi satu token. |
| Temperature | Pengaturan seberapa “berani”/acak model memilih kata. |
| RLHF | Reinforcement Learning from Human Feedback. |
| Prompt engineering | Teknik menyusun instruksi agar mendapat jawaban terbaik dari LLM. |
| System prompt | Instruksi tersembunyi di awal percakapan yang mengatur perilaku model. |