BAB 2
Apa itu Machine Learning?
Definisi, sejarah, tiga jenis utama, alur kerja, dan studi kasus mudah
2.1 Definisi Formal & Sejarah Singkat
Machine learning pertama kali diistilahkan oleh Arthur Samuel pada 1959, peneliti IBM yang membuat program permainan dam (checkers) yang bisa memperbaiki caranya bermain sendiri setelah tiap partai — tanpa ia menulis ulang kodenya secara manual.
Definisi formal yang paling sering dikutip datang dari Tom Mitchell (1997): “Sebuah program dikatakan belajar dari pengalaman E terhadap tugas T dan ukuran performa P, jika performanya pada T (diukur dengan P) meningkat seiring bertambahnya E.” Sederhananya: makin banyak “pengalaman” (data) yang diberikan, makin baik performa sistem — tanpa manusia perlu menulis ulang aturannya.
2.2 Tiga Jenis Utama Machine Learning
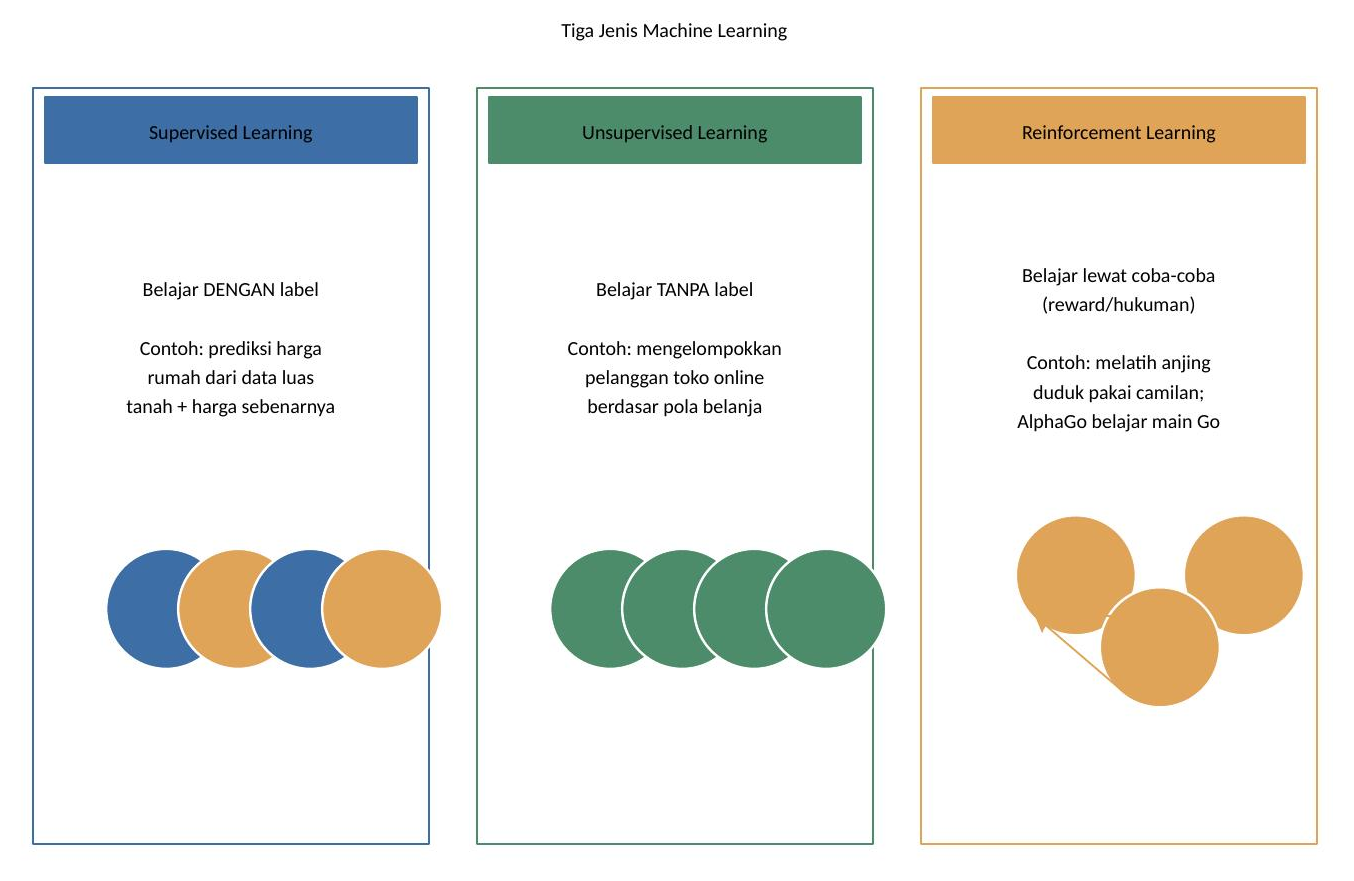
Supervised Learning (belajar dengan label) — sistem diberi data yang sudah punya “kunci jawaban”. Studi kasus mudah: memprediksi harga rumah dari ribuan data (luas tanah, jumlah kamar) beserta harga jual sebenarnya. Deteksi spam di Bab 1 juga contoh supervised learning.
Unsupervised Learning (belajar tanpa label) — sistem hanya diberi data mentah tanpa “kunci jawaban”, dan harus menemukan pola/kelompok sendiri. Studi kasus mudah: toko online punya data belanja ribuan pelanggan tanpa kategori apa pun — sistem menemukan sendiri “kelompok pembeli hemat”, “kelompok pembeli impulsif”, dan “kelompok pembeli musiman”.
Reinforcement Learning (belajar lewat coba-coba) — analoginya paling mudah dari melatih anak anjing: setiap kali anjing duduk dengan benar, ia dapat camilan (reward). Ini persis cara AlphaGo (DeepMind, 2016) belajar main Go dengan bermain jutaan kali melawan dirinya sendiri.
2.3 Alur Kerja Umum (Pipeline) Sebuah Proyek Machine Learning
2.4 Istilah Kunci Tambahan
| Istilah | Arti |
|---|---|
| Dataset | Kumpulan data yang dipakai untuk melatih/menguji model. |
| Fitur (feature) | Informasi/karakteristik yang dilihat model (mis. luas tanah, jumlah kata “gratis”). |
| Label | “Kunci jawaban” pada supervised learning. |
| Overfitting | Model terlalu hafal data latih sampai gagal saat menghadapi data baru. |
| Loss function | Cara mengukur “seberapa salah” tebakan model dibanding jawaban sebenarnya. |
| Gradient descent | Metode matematis untuk pelan-pelan mengurangi kesalahan dengan menyesuaikan bobot. |
2.5 Studi Kasus: Bagaimana Bobot 0.7 dan 0.5 Ditemukan?
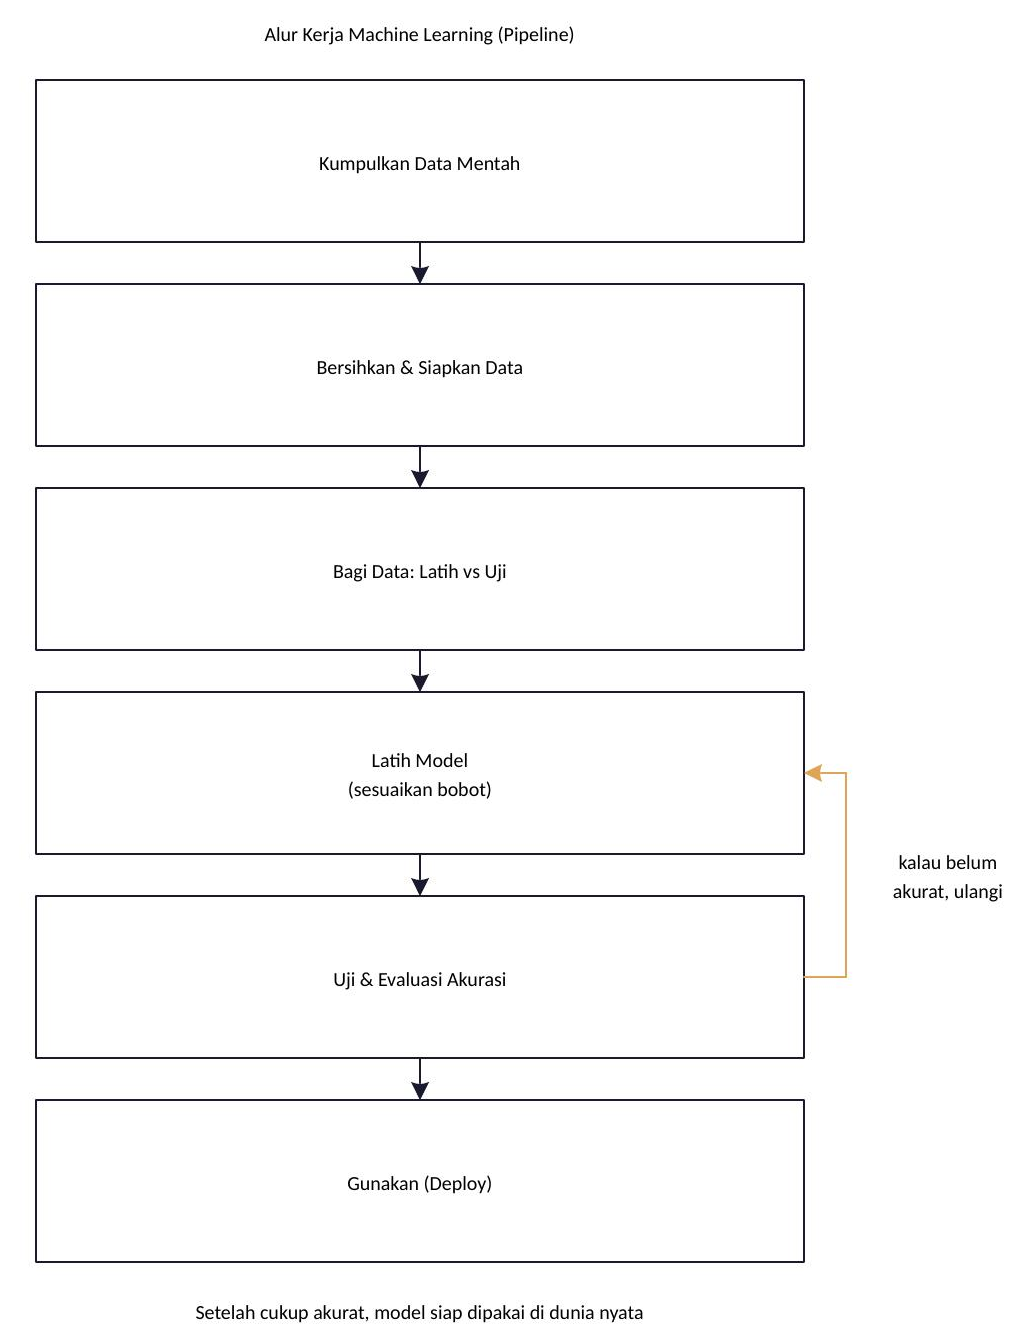
Ingat rumus di Bab 1: Skor = (0.7 × kata promosi) + (0.5 × tautan aneh). Bobot itu tidak ujug-ujug muncul — inilah gradient descent bekerja: sistem mulai dengan tebakan sembarangan (misal 0.1 dan 0.1), lalu mengecek 10.000 email latih satu per satu.
Setiap kali tebakannya salah (loss function mendeteksi kesalahan), sistem menyesuaikan sedikit bobotnya ke arah yang mengurangi kesalahan itu — diulang jutaan kali sampai bobotnya “settle” di angka paling akurat. Proses coba-perbaiki-coba lagi inilah training, dan ini juga persis proses yang melahirkan Claude — bedanya bukan cuma 2 bobot, tapi miliaran bobot yang disesuaikan lewat training raksasa.